1. 배열이 없으면 불편한 점
학생 100명의 점수를 저장한다고 하면, 배열 없이는 score1, score2, ... 처럼 변수를 100개 만들어야 합니다. "37번째 학생 점수"를 꺼내려면 이름을 직접 적어야 하고, 반복문으로 순회할 방법도 없습니다.
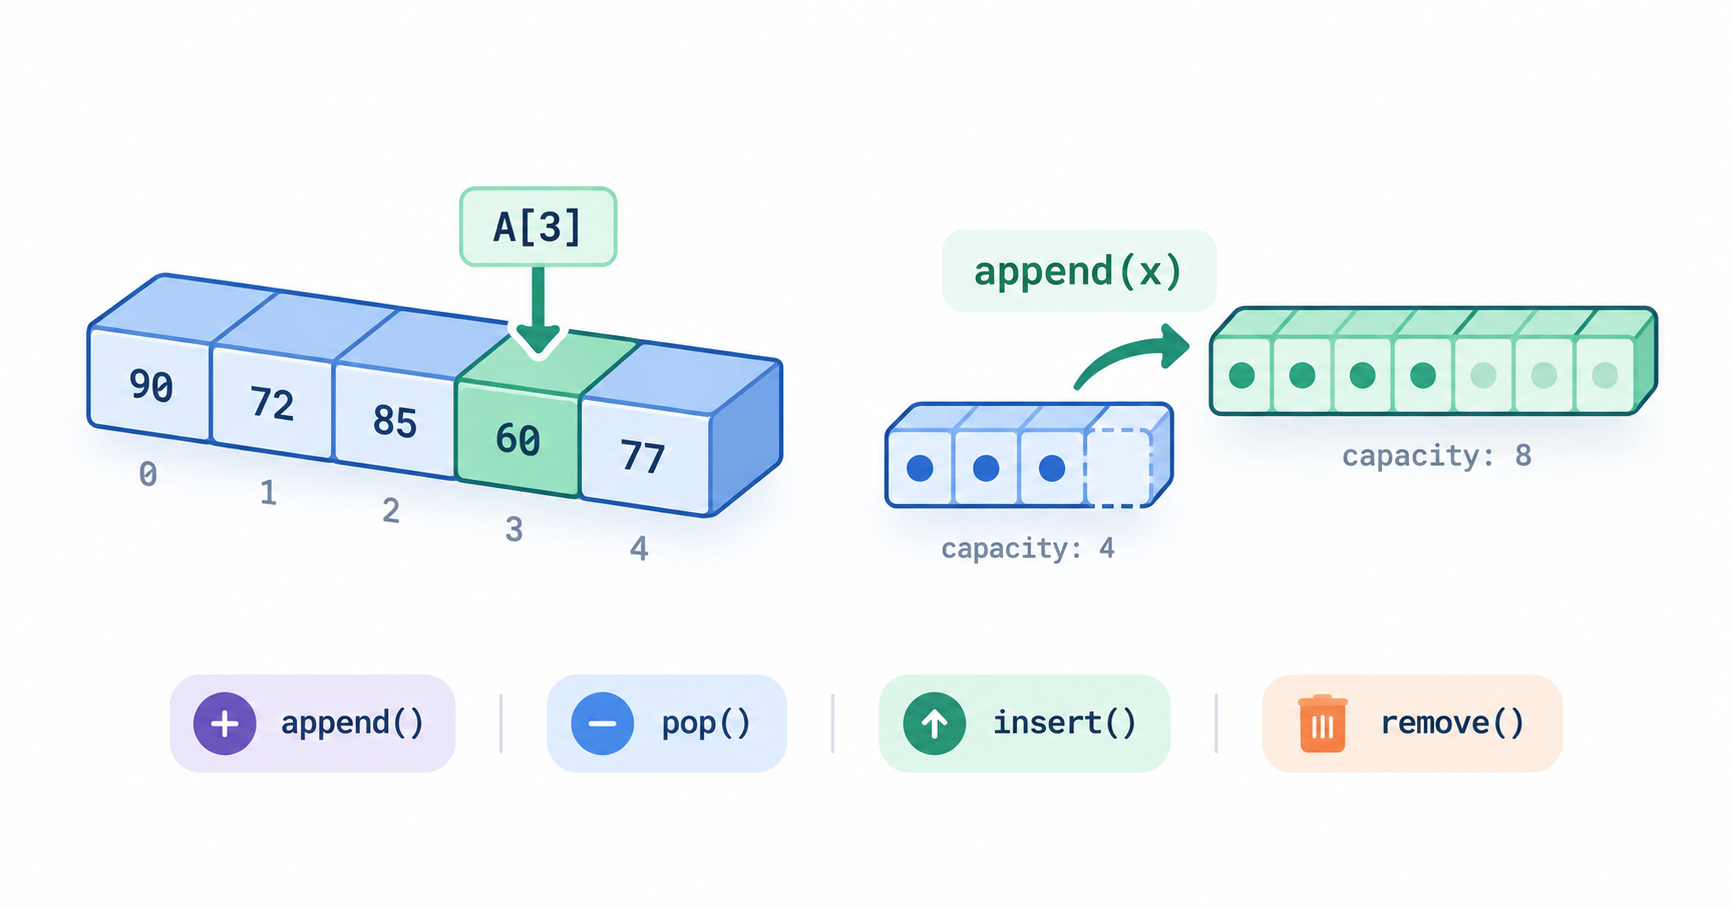
배열은 값을 연속된 공간에 나란히 두고 번호(인덱스)로 접근하게 해 줍니다. 인덱스만 알면 임의의 원소를 바로 읽고 쓸 수 있고, 이 읽기와 쓰기는 상수 시간에 끝납니다.
주소:   100   104   108   112   116
      +-----+-----+-----+-----+-----+
  A   | 90  | 72  | 85  | 60  | 77  |
      +-----+-----+-----+-----+-----+
인덱스:  0     1     2     3     4

A[3]의 위치 = 시작 주소 + 3 x 칸 크기 = 112
위치를 곱셈 한 번으로 계산하기 때문에 원소가 몇 개든 접근 비용이 같습니다.
2. 파이썬 list는 배열과 무엇이 같고 다른가
파이썬의 list는 배열과 유사한 자료구조입니다. 인덱스로 읽고 쓰는 것은 같지만, 칸에 값 자체가 아니라 객체를 가리키는 참조가 들어 있다는 점이 다릅니다.
그래서 A[1] = A[1] + 1을 실행하면 A[1]의 값이 그 자리에서 바뀌는 것이 아니라, A[1]이 새로운 값을 바라보게 됩니다.
before
  A   +-----+-----+-----+
      |  *  |  *  |  *  |
      +--|--+--|--+--|--+
         v     v     v
         3    10     5
after: A[1] = A[1] + 1
  A   +-----+-----+-----+
      |  *  |  *  |  *  |
      +--|--+--|--+--|--+
         v     |     v
         3     |     5
               v
       10     11      <- 새 객체 11을 가리킴
정수는 한번 만들어지면 바뀌지 않는(immutable) 객체라서, 덧셈 결과인 11이 새로 만들어지고 칸의 참조만 교체됩니다.
3. list의 주요 연산
| 연산 | 동작 |
|---|---|
append(x) | 맨 뒤에 추가 |
pop() | 맨 뒤 원소를 꺼내 반환 |
pop(i) | i번 원소를 꺼내 반환 |
insert(i, x) | i번 자리에 삽입 |
remove(x) | 값 x를 찾아서 제거 (처음 나온 하나) |
index(x) | x가 처음 등장하는 인덱스 반환 |
count(x) | x가 등장한 횟수 반환 |
비용이 갈리는 지점은 중간 삽입과 삭제입니다. 배열은 빈칸 없이 붙어 있어야 하므로, 중간에 끼워 넣으면 그 뒤 원소를 전부 한 칸씩 밀어야 합니다.
before: insert(1, 7)
  +----+----+----+----+----+
  | 3  | 10 | 5  | 8  |    |
  +----+----+----+----+----+
after
  +----+----+----+----+----+
  | 3  | 7  | 10 | 5  | 8  |
  +----+----+----+----+----+
          ^   └── 한 칸씩 밀림 ──┘
def insert(A, i, x):
A.size += 1
for k in range(A.size - 1, i, -1): # 뒤에서부터 한 칸씩 이동
A[k] = A[k - 1]
A[i] = xpop()은 맨 뒤를 떼어 내기만 하면 되지만, pop(0)은 뒤의 원소를 전부 앞으로 당겨야 합니다. 괄호에 값을 넣느냐 마느냐가 비용 차이로 이어집니다.
4. 용량을 알아서 늘리는 dynamic array
배열은 처음 잡은 칸 수가 정해져 있습니다. 반면 파이썬 list는 내부 규칙에 따라 용량을 자동으로 조절하는데, 이런 구조를 dynamic array라고 합니다.
def append(A, x):
    if A.size == A.capacity:           # 꽉 찼으면
        B = new_array(A.capacity * 2)  # 더 큰 공간을 새로 잡고
        copy(A, B)                     # 전부 옮긴 뒤 교체
        A = B
    A[A.size] = x
    A.size += 1
꽉 찼을 때만 복사 비용 O(n)이 들고, 나머지 append는 O(1)입니다. 용량을 일정 비율로 늘리면 복사가 점점 드물어져서 평균적으로는 O(1)이 됩니다. 이를 분할 상환(amortized) O(1)이라고 합니다. 설명은 2배로 단순화했고, CPython은 실제로 약 1.125배씩 여유를 더 잡습니다.
5. 시간복잡도
| 연산 | 평균 | 최악 |
|---|---|---|
A[i] 읽기/쓰기 | O(1) | O(1) |
append(x) | O(1) (amortized) | O(n) (용량 확장 시) |
pop() | O(1) | O(1) |
pop(i), insert(i, x) | O(n) | O(n) |
remove(x), index(x) | O(n) | O(n) |
count(x) | O(n) | O(n) |
6. 제한된 접근만 허용하는 자료구조들
배열과 리스트는 인덱스로 임의의 원소에 접근합니다. 반대로 삽입과 삭제 위치를 일부러 제한한 자료구조도 있습니다.
- 스택: 나중에 넣은 것을 먼저 꺼냄 (LIFO)
- 큐: 먼저 넣은 것을 먼저 꺼냄 (FIFO)
- 덱: 양쪽 끝 모두에서 넣고 뺌 (스택 + 큐)
또 원소를 연속된 공간이 아니라 떨어진 공간에 독립적으로 저장하고 서로 연결해 두는 연결 리스트도 있습니다.