🤔 이게 왜 문제인가
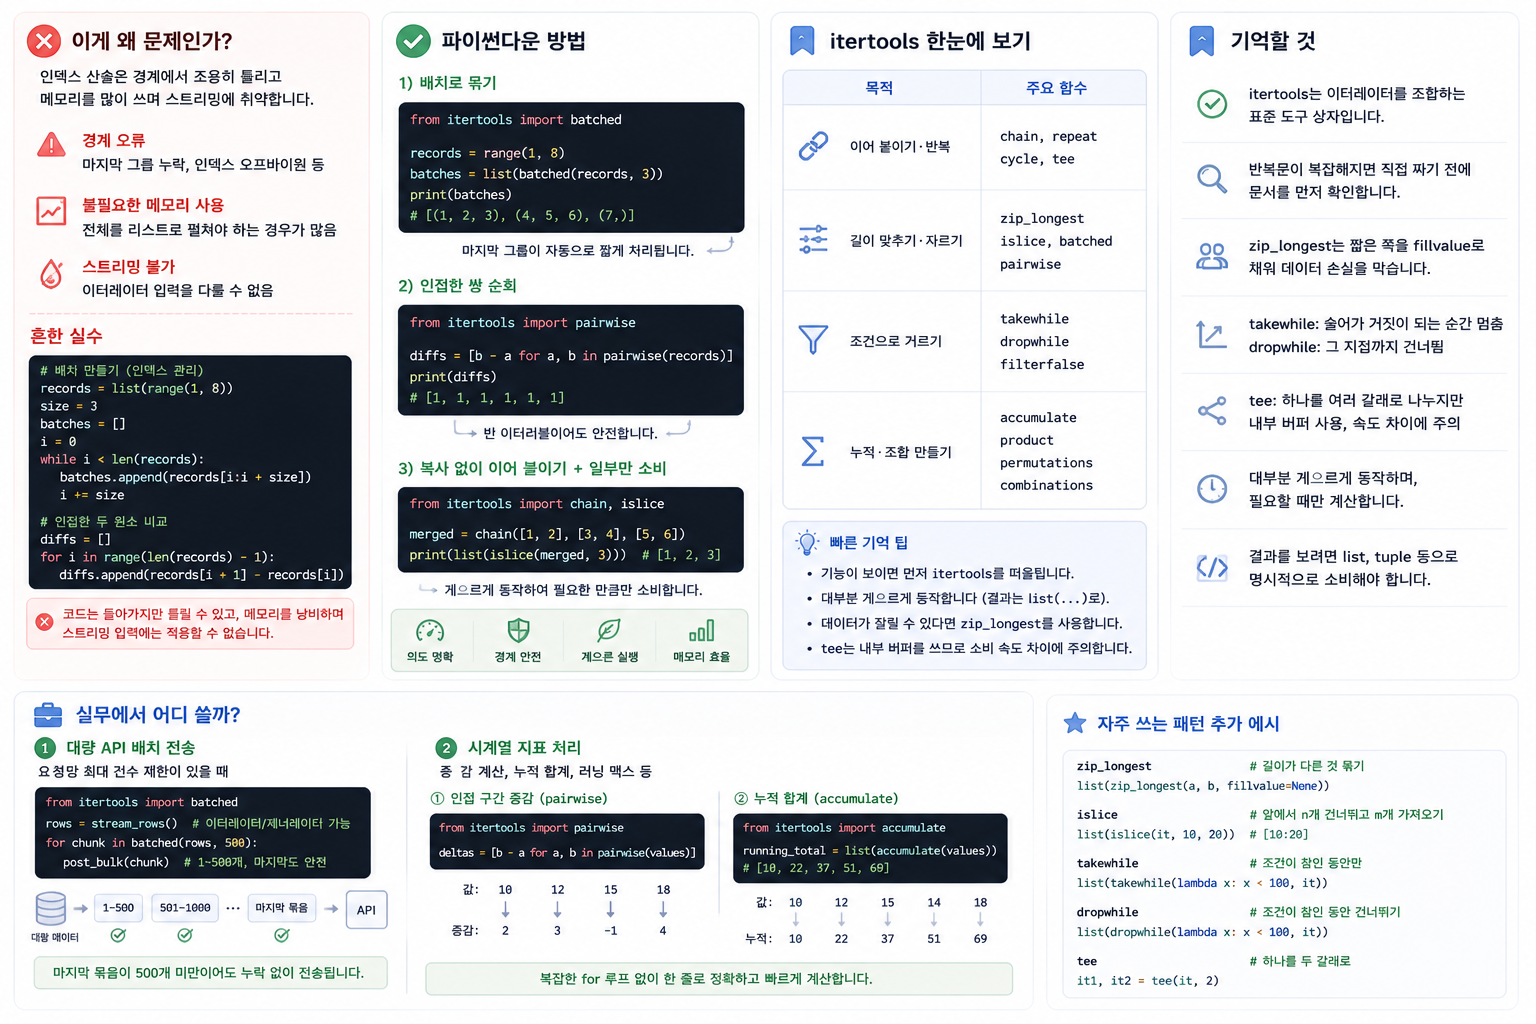
리스트 세 개를 순서대로 이어 붙이려고 이중 for 문을 쓰고, 인접한 두 원소를 비교하려고 range(len(items) - 1)을 꺼내고, 고정 크기로 잘라 배치 전송하려고 인덱스 계산을 손으로 하고 있는 경우가 있을 겁니다. 이런 코드는 대체로 짧지만 경계 조건에서 조용히 틀립니다. 마지막 그룹이 잘리거나, 인덱스가 하나 어긋나거나, 리스트로 전부 펼치는 바람에 메모리를 잡아먹는 식입니다.
이터레이터(iterator)를 조합하는 패턴은 놀라울 만큼 정형화되어 있습니다. itertools는 그 정형화된 패턴들을 이미 C 레벨로 구현해 둔 표준 모듈입니다. 이터레이션 코드가 복잡해진다고 느끼는 순간이 바로 이 모듈의 문서를 열어 볼 때입니다.
💣 흔한 실수
records = list(range(1, 8))
size = 3

batches = []
i = 0

while i < len(records):  # 인덱스 산술을 직접 관리하고 있습니다
    batches.append(records[i:i + size])
    i += size

diffs = []

for i in range(len(records) - 1):  # 빈 리스트에서 경계가 위태롭습니다
    diffs.append(records[i + 1] - records[i])
돌아가기는 하지만 입력을 전부 리스트로 물질화해야 하고, 인덱스 계산이 한 칸만 어긋나도 결과가 조용히 틀어집니다. 스트리밍 입력에는 아예 적용할 수 없습니다.
✅ 파이썬다운 방법
from itertools import batched, pairwise, chain, islice

records = range(1, 8)

batches = list(batched(records, 3))  # 마지막 그룹은 알아서 짧게 처리됩니다
print(batches)  # [(1, 2, 3), (4, 5, 6), (7,)]

diffs = [b - a for a, b in pairwise(records)]  # 인접 쌍을 안전하게 순회합니다
print(diffs)  # [1, 1, 1, 1, 1, 1]

merged = chain([1, 2], [3, 4])  # 복사 없이 이어 붙입니다
print(list(islice(merged, 3)))  # [1, 2, 3]
인덱스 산술이 사라지면서 의도가 함수 이름으로 드러나고, 경계 처리는 라이브러리가 책임집니다. 게으르게(lazy) 동작하므로 원본을 리스트로 펼치지 않아 메모리에도 유리합니다. 가독성과 성능을 한 번에 챙기는 개선입니다.
자주 쓰는 함수를 용도별로 묶으면 다음과 같습니다.
| 목적 | 함수 |
|---|---|
| 이어 붙이기·반복 | chain, repeat, cycle, tee |
| 길이 맞추기·자르기 | zip_longest, islice, batched, pairwise |
| 조건으로 거르기 | takewhile, dropwhile, filterfalse |
| 누적·조합 만들기 | accumulate, product, permutations, combinations |
📎 기억할 것
itertools에는 이터레이터를 조합하고 소비하는 검증된 함수들이 모여 있습니다.- 반복문이 복잡해진다고 느끼면 직접 짜기 전에 문서를 먼저 확인하는 것이 좋습니다.
zip_longest는 짧은 쪽을fillvalue로 채워 주므로 데이터가 잘려 나가지 않습니다.takewhile은 술어가 거짓이 되는 순간 멈추고,dropwhile은 그 지점까지 건너뜁니다.tee는 하나의 이터레이터를 여러 갈래로 나누지만 내부 버퍼를 쓰므로 소비 속도 차이에 주의해야 합니다.- 대부분의 함수가 게으르게 동작하므로 결과를 보려면
list로 감싸야 합니다.
🛠 실무에서 어디 쓸까
외부 API로 대량 데이터를 밀어 넣을 때 batched가 곧바로 쓰입니다. 대부분의 벌크 엔드포인트는 요청당 최대 건수를 제한하는데, for chunk in batched(rows, 500): 한 줄이면 나머지가 500개로 딱 떨어지지 않아도 마지막 묶음까지 안전하게 전송됩니다.
시계열 지표 처리에서는 pairwise와 accumulate가 유용합니다. 센서 값의 구간별 증감을 구할 때 pairwise로 인접 쌍을 만들고, 누적 합계나 러닝 맥스가 필요하면 accumulate에 함수를 넘겨 한 줄로 해결할 수 있습니다.