자료구조와 알고리즘
1. 저장만 해서는 아무것도 못 합니다
프로그램이 다루는 것은 결국 자료(data)입니다. 자료는 어딘가에 놓여야 하고, 그 자리가 메모리입니다. 그런데 값을 메모리에 올려두기만 하면 할 수 있는 일이 없습니다. 값을 꺼내 오고, 바꾸고, 중간에 끼워 넣고, 지우고, 찾을 수 있어야 비로소 쓸모가 생깁니다.
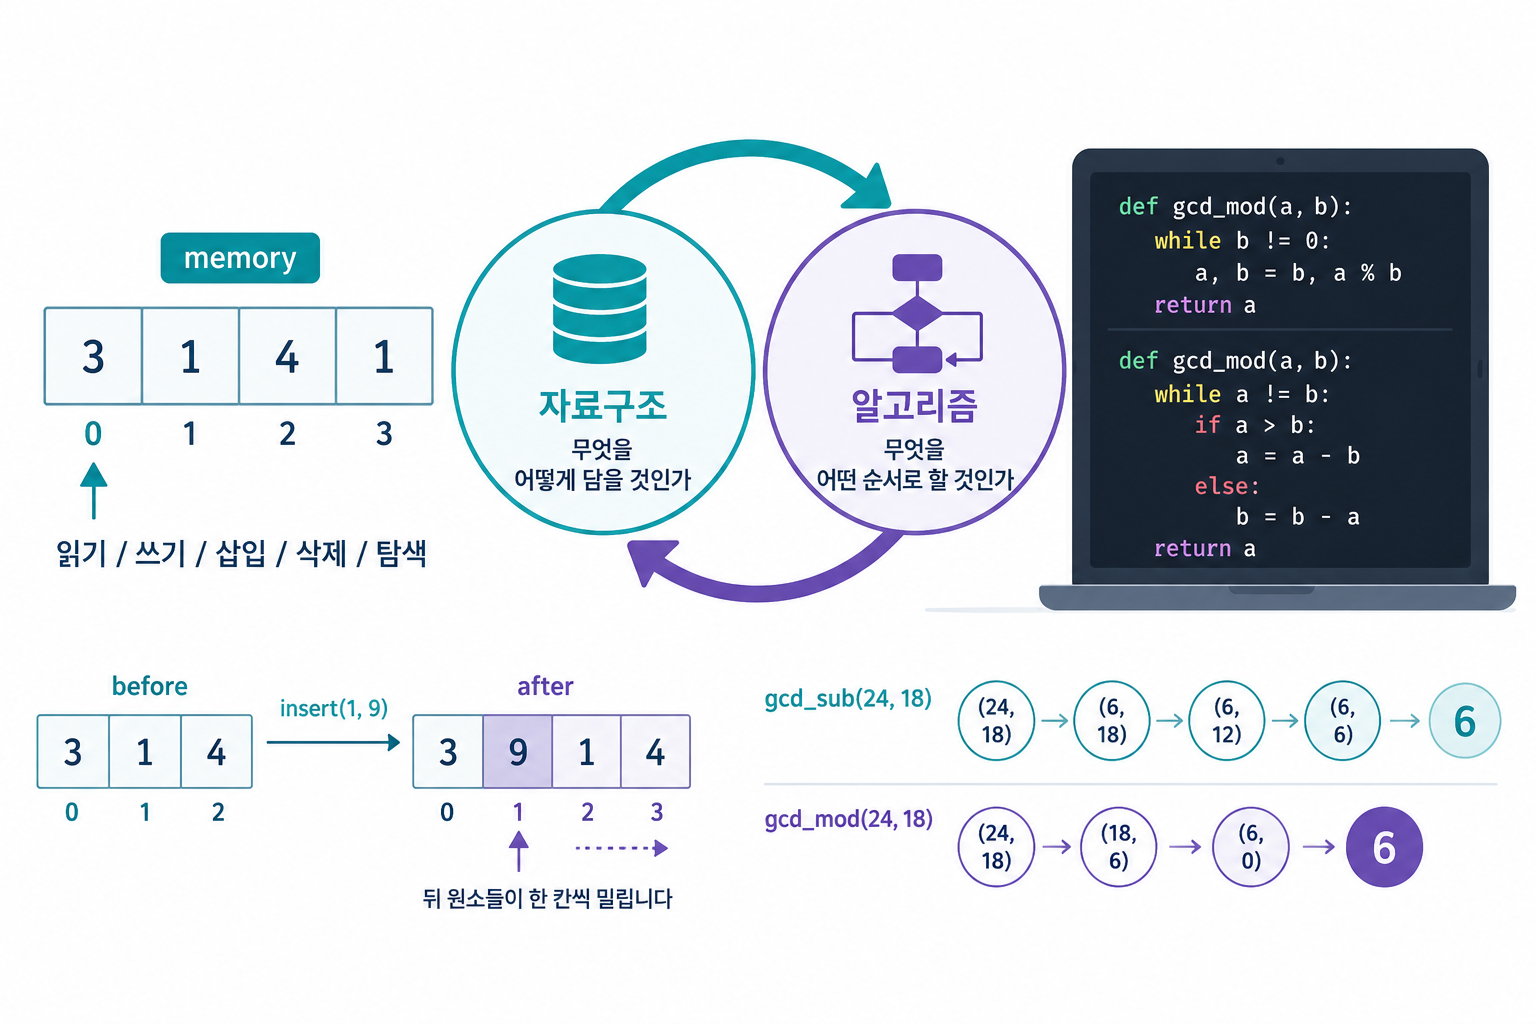
읽기, 쓰기, 삽입, 삭제, 탐색. 이 연산들을 어떤 규칙으로 지원할지 정해 둔 형태가 자료구조입니다. 저장 공간 자체가 자료구조인 것이 아니라, 저장 공간에 연산을 얹은 결과가 자료구조입니다.
memory
+-----+-----+-----+-----+
|  3  |  1  |  4  |  1  |
+-----+-----+-----+-----+
   0     1     2     3
   ^
   읽기 / 쓰기 / 삽입 / 삭제 / 탐색
2. 가장 단순한 예: 변수와 배열
변수는 값 하나를 담는 가장 작은 자료구조입니다. 배열은 값을 순서대로 여러 개 담습니다. 배열이 지원하는 연산은 append, insert, pop 같은 것들입니다.
이 중 insert처럼 상태를 바꾸는 연산은 전후를 같이 봐야 이해가 됩니다.
before   insert(1, 9)
+-----+-----+-----+
|  3  |  1  |  4  |
+-----+-----+-----+
   0     1     2

after
+-----+-----+-----+-----+
|  3  |  9  |  1  |  4  |
+-----+-----+-----+-----+
   0     1     2     3
         ^ 뒤 원소들이 한 칸씩 밀립니다
밀어내는 비용이 왜 생기는지, 파이썬 list가 이를 어떻게 처리하는지는 배열 편에서 다룹니다.
3. 알고리즘은 절차입니다
알고리즘은 입력 데이터를 받아 유한한 횟수의 연산을 반복해 정답을 출력하는 절차입니다. 여기서 중요한 단어는 유한입니다. 언젠가 반드시 끝나야 하고, 끝났을 때 답이 나와야 합니다.
자료구조가 "무엇을 어떻게 담을 것인가"라면, 알고리즘은 "그 위에서 무엇을 어떤 순서로 할 것인가"입니다.
4. 같은 문제를 푸는 두 알고리즘
최대공약수를 구하는 문제로 보겠습니다. 두 수에서 큰 수에서 작은 수를 계속 빼 나가다가 두 수가 같아지면 그 값이 최대공약수입니다. 유클리드가 남긴 방법이고, while문 하나로 바로 옮길 수 있습니다.
def gcd_sub(a, b):
    while a != b:
        if a > b:
            a = a - b
        else:
            b = b - a
    return a
동작을 따라가 보면 이렇습니다.
gcd_sub(24, 18)
(24, 18) -> (6, 18) -> (6, 12) -> (6, 6) -> 6
문제는 두 수의 차이가 클 때입니다. gcd_sub(1000000000, 1)이면 1을 십억 번 가까이 빼야 합니다. 뺄셈 자체는 빠르지만 반복 횟수가 너무 많습니다.
여기서 관찰 하나가 나옵니다. 같은 수를 계속 빼는 것은 결국 나눗셈이고, 남는 값은 나머지입니다. 뺄셈을 여러 번 반복할 자리에 나머지 연산 한 번을 넣으면 됩니다.
def gcd_mod(a, b):
    while b != 0:
        a, b = b, a % b
    return a
gcd_mod(24, 18)
(24, 18) -> (18, 6) -> (6, 0) -> 6같은 입력인데 반복이 세 번으로 줄었습니다.