1. 최댓값만 반복해서 필요한 상황
작업 스케줄러는 대기 중인 작업 중 우선순위가 가장 높은 것을 꺼내 실행하고, 그 사이에도 새 작업이 계속 들어옵니다. 필요한 연산은 "가장 큰 값 꺼내기"와 "새 값 넣기" 둘뿐입니다.
리스트로 처리하면 한쪽이 반드시 느립니다. 정렬해 두면 최댓값 꺼내기는 빠르지만 삽입할 자리를 만드느라 O(n)이 들고, 정렬하지 않으면 삽입은 O(1)이지만 최댓값을 찾느라 O(n)이 듭니다. 전체를 정렬할 필요는 없는데 전체 정렬 비용을 내고 있는 셈입니다.
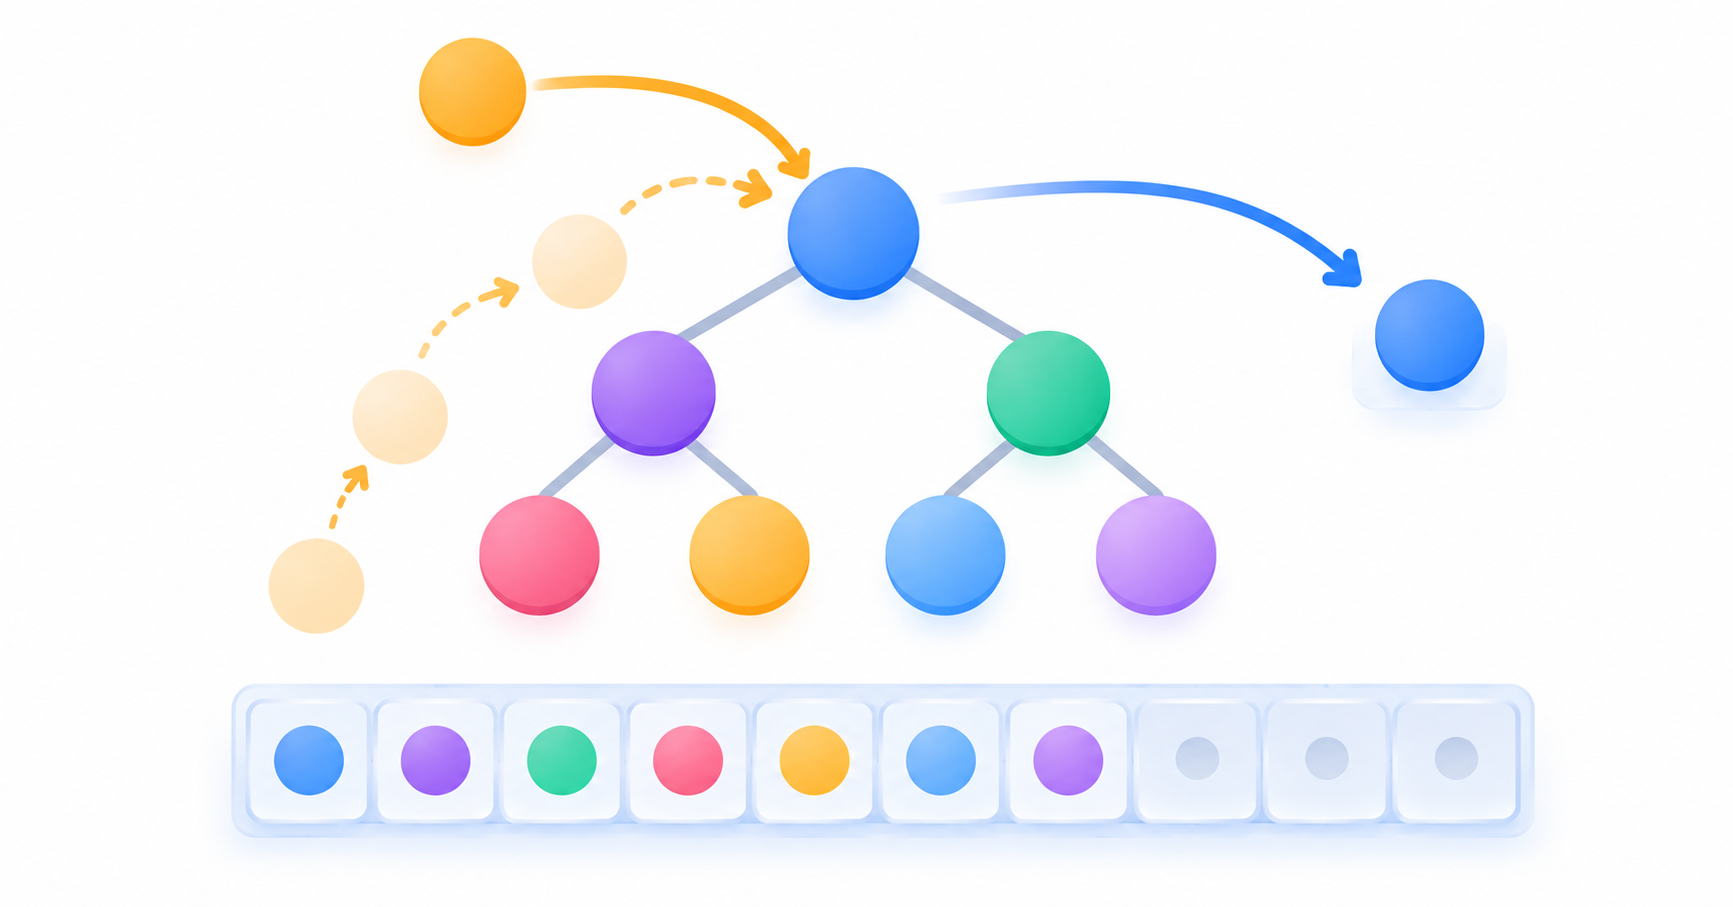
힙은 전체 순서를 포기하고 "루트가 가장 크다"만 보장합니다. 그 대가로 삽입과 삭제가 모두 O(log n)이 됩니다.
2. 두 가지 성질
힙은 다음 두 성질을 만족하는 이진 트리입니다.
힙 성질: 모든 부모 노드의 키는 자식 노드의 키보다 작지 않습니다. 이 성질이 위로 계속 적용되므로 루트에는 전체에서 가장 큰 값이 놓입니다.
모양 성질: 마지막 레벨을 제외한 모든 레벨이 꽉 차 있고, 마지막 레벨은 왼쪽부터 차 있습니다.
레벨 0                (9)
                     /   \
레벨 1            (7)     (6)
                 /   \    /
레벨 2        (3)   (5) (4)

index    0     1     2     3     4     5
       +-----+-----+-----+-----+-----+-----+
       |  9  |  7  |  6  |  3  |  5  |  4  |
       +-----+-----+-----+-----+-----+-----+
형제 사이에는 아무 규칙이 없습니다. 7과 6 중 무엇이 큰지는 힙이 신경 쓰지 않습니다.
3. 리스트로 구현한다
모양 성질 덕분에 리스트에 빈칸이 생기지 않습니다. 일반 이진 트리를 리스트로 표현하면 중간중간 비는 칸이 낭비였는데, 힙은 항상 앞에서부터 꽉 채워집니다. 그래서 힙은 노드 클래스가 아니라 리스트로 구현합니다.
   H[k]의 왼쪽 자식  = H[2k + 1]
   H[k]의 오른쪽 자식 = H[2k + 2]
   H[k]의 부모       = H[(k - 1) // 2]
셋 다 상수 시간에 계산됩니다. 링크를 저장하지 않고도 트리를 오르내릴 수 있습니다.
높이 h는 log₂n 이하입니다. 레벨마다 노드 수가 두 배씩 늘기 때문입니다. 앞으로 나오는 O(log n)은 전부 "높이만큼 오르내린다"는 뜻입니다.
4. heapify_down: 아래로 내려보내기
힙의 연산은 두 개의 보조 연산에서 나옵니다. 하나는 값을 아래로 내려보내는 heapify_down입니다.
k번 노드만 힙 성질을 어기고 그 아래 두 부트리는 이미 힙일 때, k의 값을 제자리로 내려보냅니다. 두 자식 중 큰 쪽과 비교해 자기가 작으면 교환하고, 더 이상 내려갈 곳이 없으면 멈춥니다.
def heapify_down(A, k, n):
    while 2*k + 1 < n:                  # 자식이 있는 동안
        L, R = 2*k + 1, 2*k + 2
        m = L
        if R < n and A[R] > A[L]:       # 더 큰 자식을 고른다
            m = R
        if A[k] >= A[m]:                # 이미 제자리
            break
        A[k], A[m] = A[m], A[k]
        k = m
한 번 돌 때마다 레벨이 하나씩 내려가므로 최악에 높이만큼, O(log n)입니다.
이 연산만으로 아무 리스트나 힙으로 만들 수 있습니다. 리프는 그 자체로 힙이므로, 리프 바로 위부터 거슬러 올라가며 heapify_down을 부르면 됩니다.
def make_heap(A):
    n = len(A)
    for k in range(n - 1, -1, -1):
        heapify_down(A, k, n)
5. heapify_up과 insert
삽입은 값을 넣는 것으로 끝나지 않습니다. 힙 성질을 만족시키려면 자리 조정이 필요합니다.
새 값은 모양 성질을 지키려고 리스트 맨 끝에 붙입니다. 그 자리에서 부모보다 크면 위로 올라갑니다. 이것이 heapify_up입니다.
before: insert(8) — 맨 끝에 붙인 직후
                (9)
               /   \
            (7)     (6)
            / \     / \
         (3) (5) (4)  [8]   <- 부모 6보다 크다
after: 6과 교환하고, 루트 9보다는 작으므로 멈춤
                (9)
               /   \
            (7)     (8)
            / \     / \
         (3) (5) (4)  (6)
def heapify_up(A, k):
while k > 0 and A[(k - 1) // 2] < A[k]:
A[k], A[(k - 1) // 2] = A[(k - 1) // 2], A[k]
k = (k - 1) // 2
def insert(A, key):
A.append(key)
heapify_up(A, len(A) - 1)올라가는 거리도 최악에 높이만큼이라 O(log n)입니다.
6. find_max와 delete_max
최댓값은 항상 루트에 있으므로 꺼내 보기만 하는 것은 상수 시간입니다.
def find_max(A):
    return A[0]
삭제는 조금 다릅니다. 루트를 그냥 지우면 구멍이 나서 모양 성질이 깨집니다. 그래서 마지막 원소를 루트로 옮긴 뒤, 그 값을 heapify_down으로 제자리까지 내려보냅니다.
before: 루트 9를 꺼내고 마지막 원소 6을 루트로 올린 직후
                (6)
               /   \
            (7)     (8)
            / \     /
         (3) (5) (4)
after: 더 큰 자식 8과 교환
                (8)
               /   \
            (7)     (6)
            / \     /
         (3) (5) (4)
def delete_max(A):
A[0], A[-1] = A[-1], A[0]
key = A.pop()
heapify_down(A, 0, len(A))
return key탐색만은 힙이 잘하지 못합니다. 특정 키를 찾으려면 어느 쪽 부트리로 내려갈지 정할 근거가 없어서 전부 훑어야 합니다. 힙은 최댓값 외의 값을 찾는 데는 쓰지 않습니다.
7. min-heap과 heapsort
부등호 방향만 뒤집으면 최솟값을 루트에 두는 min-heap이 됩니다. find_min과 delete_min도 그대로 대응합니다.
힙으로 정렬도 할 수 있습니다. 리스트를 힙으로 만든 뒤 delete_max를 반복하면 큰 값부터 나오므로, 꺼낸 값을 리스트 뒤쪽에 쌓으면 오름차순으로 정렬됩니다. make_heap이 O(n), 꺼내기가 n번 O(log n)이라 전체 O(n log n)이고, 추가 배열 없이 제자리에서 끝납니다.
8. 시간복잡도
| 연산 | 평균 | 최악 |
|---|---|---|
find_max | O(1) | O(1) |
insert | O(1) | O(log n) |
delete_max | O(log n) | O(log n) |
make_heap | O(n) | O(n) |
search | O(n) | O(n) |
| heapsort | O(n log n) | O(n log n) |
insert의 평균이 O(1)인 것은 새 값이 대개 몇 칸 못 올라가고 멈추기 때문입니다. 노드의 절반이 마지막 레벨에 있어서, 무작위 값은 위로 갈수록 통과하기 어렵습니다.