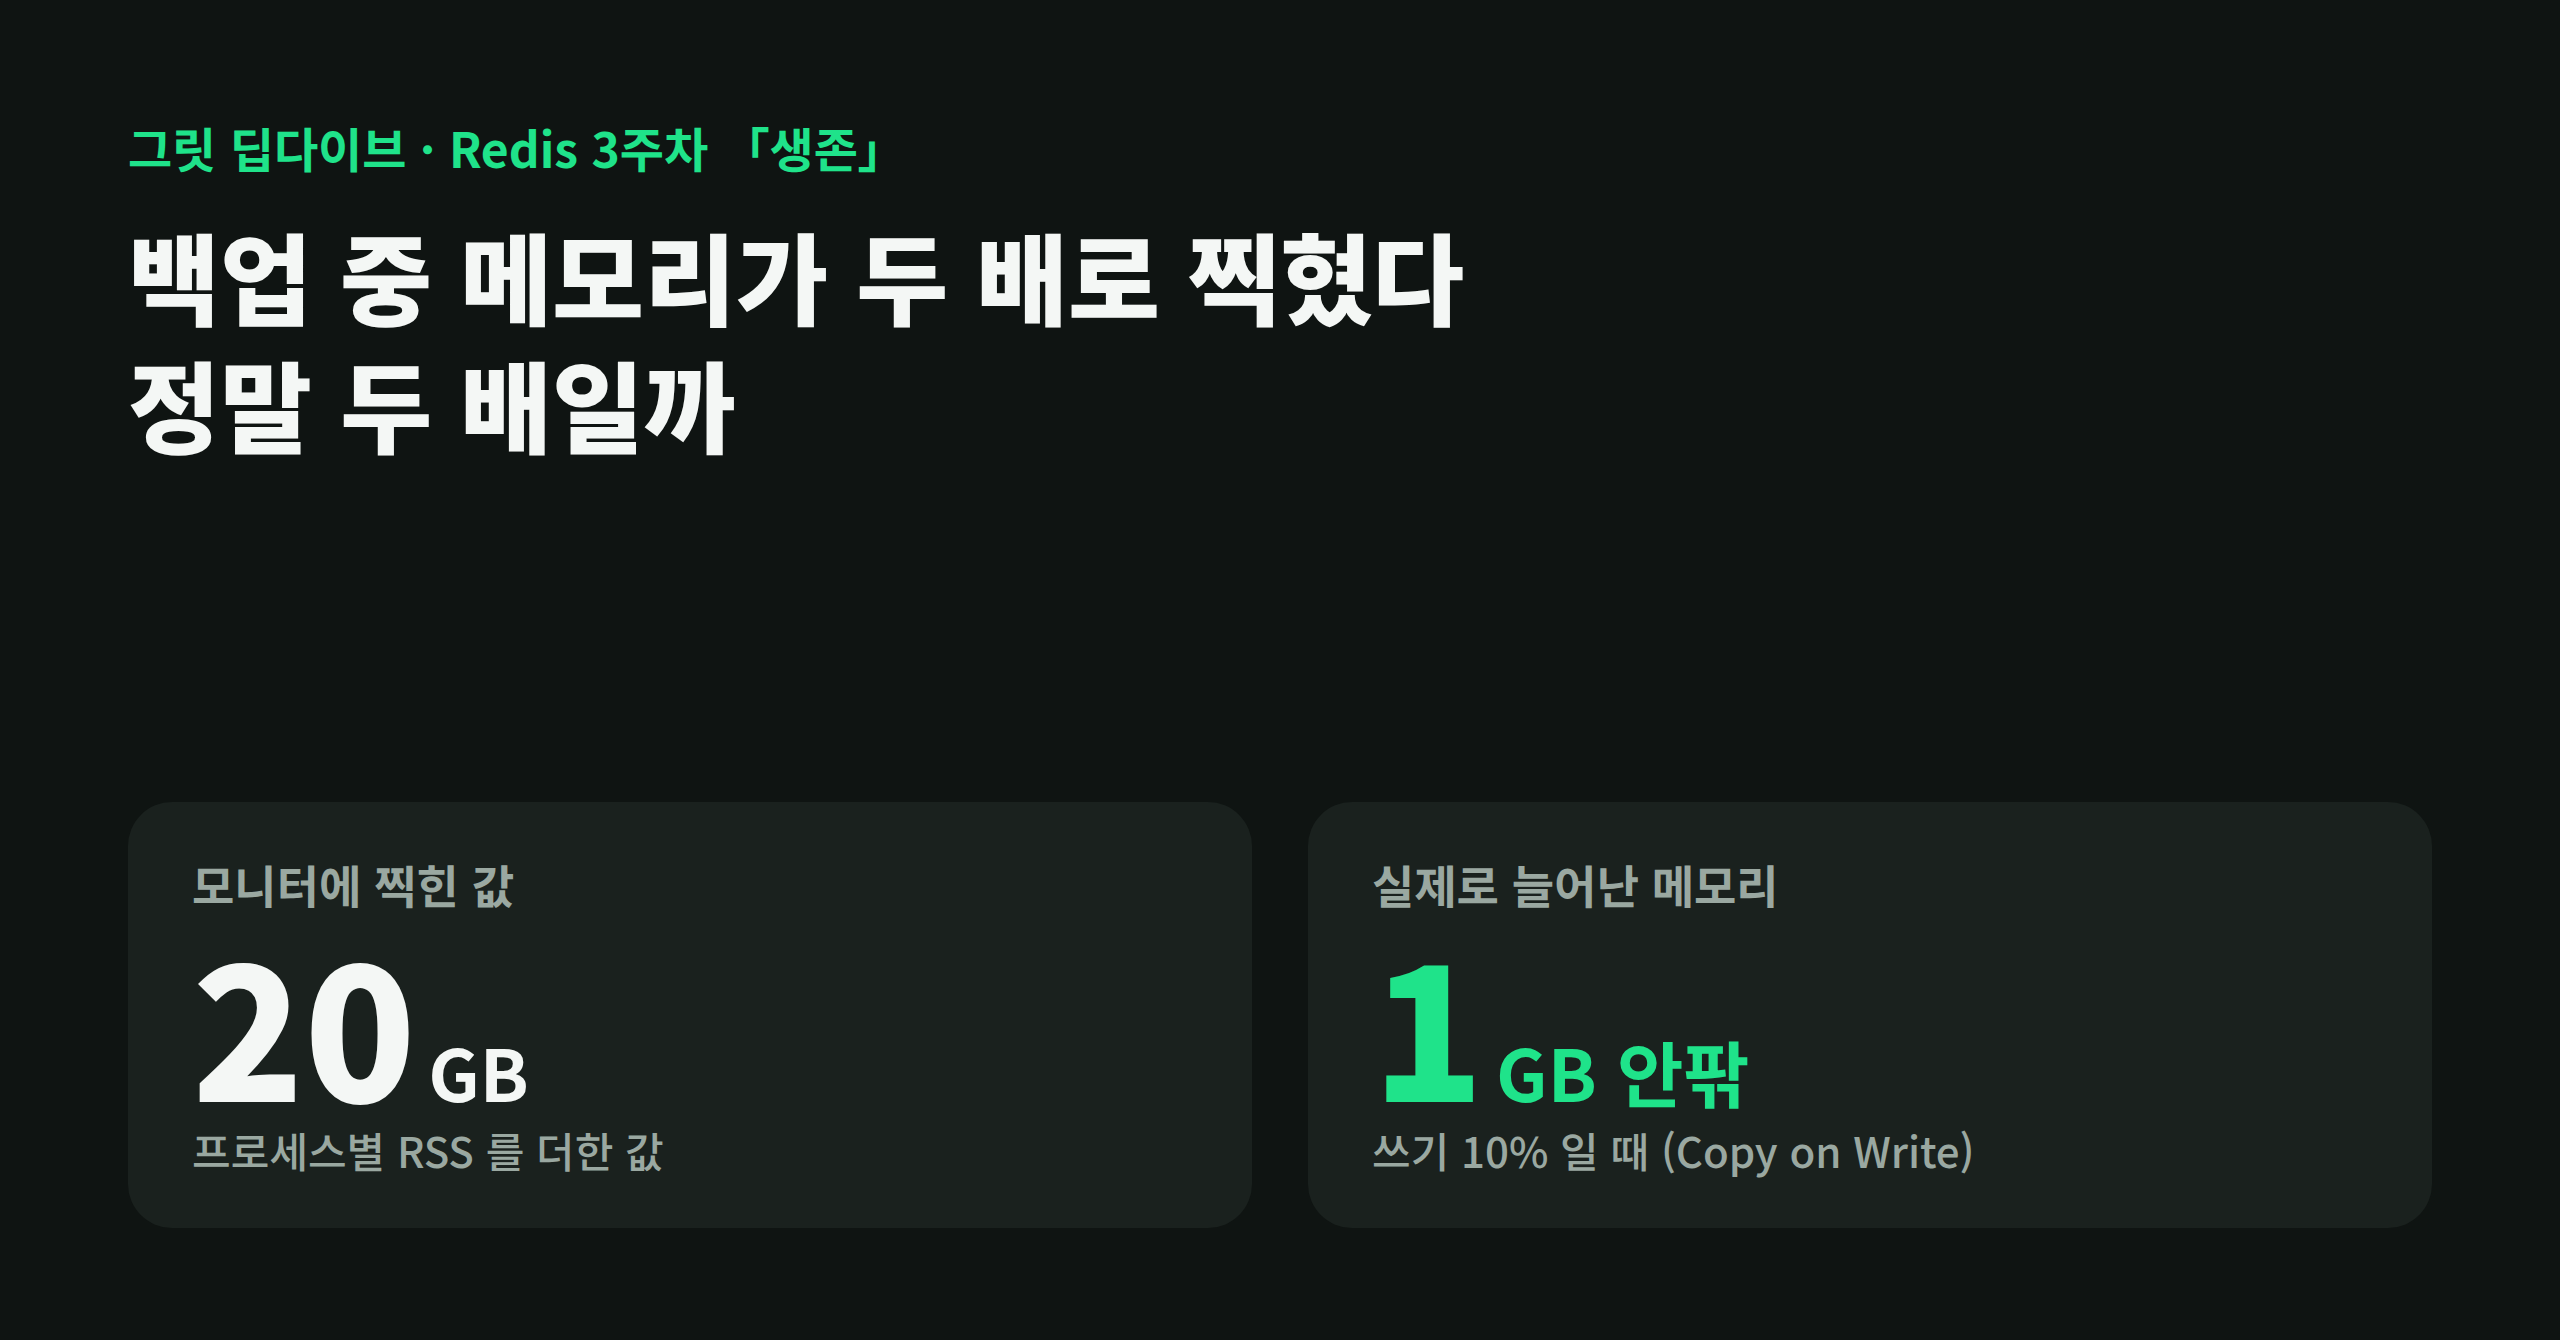
새벽 3시, 메모리 경보가 울립니다. Redis 프로세스가 10GB 에서 20GB 로 뛴 것처럼 보입니다. 마침 스냅샷 백업(BGSAVE)이 도는 시각입니다. 아침 회의에서 누군가 말합니다. 「백업할 때마다 두 배가 필요하니 서버를 두 배로 늘리죠.」
이 말은 맞을 때도 있고 틀릴 때도 있습니다. 어느 쪽인지는 세 가지를 보면 가를 수 있습니다. 경보가 어떤 지표였는지, 백업하는 동안 쓰기가 얼마나 몰렸는지, 그리고 fork 가 메모리를 얼마나 복사하게 되는 환경인지입니다. 이 글은 셋을 차례로 봅니다. 팀그릿 Redis 스터디 3주차에서 다룬 운영 사고 네 개 중 하나입니다.
백업하는 동안 Redis 는 멈추나요?
Redis 는 스냅샷을 뜰 때 fork 로 자기 자신을 복제합니다. 자식 프로세스가 메모리 내용을 디스크에 쓰는 동안 부모 프로세스는 평소처럼 요청을 받습니다.
fork 를 호출하는 순간에는 메인 스레드가 짧게 멈춥니다. 메모리가 클수록 길어지고, 얼마나 멈췄는지는 INFO stats 의 latest_fork_usec 에 남습니다. 그 뒤로는 부모가 계속 응답합니다.
첫째, 경보가 어떤 지표였나요?
fork 는 메모리를 통째로 복사하지 않습니다. 부모와 자식이 같은 메모리 페이지를 함께 가리키고, 어느 쪽이든 쓰기가 일어난 페이지만 그때 복사합니다. 이걸 Copy on Write(쓸 때 복사)라고 합니다.
그래서 어떤 지표로 봤는지가 중요합니다.
| 지표 | 백업 중 보이는 값 | 뜻 |
|---|---|---|
| 프로세스별 RSS 를 더한 값 (ps, top 목록 합산) | 약 20GB | 함께 쓰는 페이지를 부모와 자식에서 두 번 셈 |
PSS 합 (/proc/<pid>/smaps_rollup) | 10GB + 복사된 만큼 | 함께 쓰는 페이지를 나눠서 셈 |
| 호스트나 cgroup 메모리 | 10GB + 복사된 만큼 | 실제로 늘어난 물리 메모리 |
경보가 첫 줄 같은 합산 지표였다면 두 배는 대부분 착시입니다. 호스트나 cgroup 지표였다면 늘어난 만큼은 진짜입니다. 그 크기를 정하는 게 다음 두 가지입니다.
둘째, 백업하는 동안 쓰기가 얼마나 몰렸나요?
실제로 늘어나는 메모리는 백업하는 동안 쓰기가 일어난 페이지 수만큼입니다. 쓰기가 전체 페이지의 10% 에 흩어져 일어났다면 약 1GB 가 늘어납니다. 쓰기가 몰리는 시간대에 백업이 돌면 이 값이 커지고, 모든 페이지에 쓰기가 닿으면 정말 두 배가 됩니다.
그래서 먼저 할 일은 서버를 늘리는 게 아니라 백업 시각을 쓰기가 적은 시간대로 옮기는 것입니다. 쓰기가 늘 많은 서비스라면 정기 백업을 복제본에서 뜹니다. 다만 복제본이 처음 붙거나 전체 동기화를 받을 때, 그리고 AOF 를 다시 쓸 때는 원본도 fork 하므로 원본의 여유 메모리를 0 으로 잡으면 안 됩니다.
셋째, fork 가 얼마나 복사하게 되는 환경인가요?
Linux 의 THP(Transparent Huge Pages, 큰 페이지를 자동으로 쓰는 기능)가 켜져 있으면, 예전 커널에서는 Copy on Write 가 4KB 가 아니라 2MB 단위로 일어났습니다. 쓰기가 여러 2MB 페이지에 흩어지면 복사량이 빠르게 커집니다. 커널 5.8 부터는 큰 페이지도 쪼개서 필요한 부분만 복사하고, Redis 6.2 부터는 disable-thp 설정이 기본으로 켜져 있어 Redis 프로세스에서 THP 를 끕니다. 오래된 커널이나 Redis 를 쓰고 있다면 이 설정부터 확인합니다.
하나 더 있습니다. vm.overcommit_memory 가 0 이면 메모리가 넉넉하지 않은 서버에서 fork 자체가 실패할 수 있습니다. 이때 로그에는 백업 실패로 남고, 기본 설정에서는 쓰기 요청까지 거부됩니다. Redis 는 이 값을 1 로 두라고 권합니다.
ElastiCache 같은 관리형 서비스라면 THP 나 overcommit 을 직접 바꿀 수 없습니다. 대신 백업과 동기화에 쓸 여유 메모리를 따로 떼어 두는 설정(ElastiCache 는 reserved-memory-percent)을 봅니다.
면접에서 이 질문을 받는다면
「Redis 는 BGSAVE 할 때 메모리가 두 배 필요하지 않나요?」에는 이렇게 답할 수 있습니다.
최악의 경우 두 배입니다. fork 뒤에는 Copy on Write 라서 백업 중 쓰기가 일어난 페이지만 복사되고, 실제 증가량은 쓰기 비율에 달려 있습니다. 오래된 커널에서 THP 가 켜져 있으면 2MB 단위로 복사돼 증가량이 커지므로 끄고, fork 가 실패하지 않게 vm.overcommit_memory 를 1 로 둡니다. 쓰기가 많은 서비스라면 정기 백업은 복제본에서 뜨되, 전체 동기화 때는 원본도 fork 한다는 점을 여유 메모리에 반영합니다.
꼬리 질문이 THP 나 overcommit 으로 이어져도 같은 줄기로 답할 수 있습니다.
이런 꼬리 질문을 저녁마다 하나씩 익명으로 같이 푸는 방도 있습니다. 개발자: 데일리 익명 면접 챌린지 들어가 보기 →
같은 주에 다룬 사고 세 개
스터디 3주차에는 이 사고 말고도 세 개를 더 다뤘습니다. 하나는 여기서 바로 풀어 보겠습니다.
끊긴 30초에 전체 데이터가 다시 흐른 복제. 초당 5MB 를 쓰는 서버에서 복제본 연결이 30초 끊기면, 끊긴 동안 쌓인 쓰기는 5MB × 30 = 150MB 입니다. 원본의 복제 버퍼(repl-backlog-size)가 150MB 보다 작으면 복제본은 끊긴 부분만 이어 받지 못하고 전체 데이터를 처음부터 다시 받습니다. 기본값은 1MB 입니다. 버퍼 크기가 버틸 수 있는 단절 시간을 정합니다.
나머지 둘은 이런 사고입니다.
- 자정의 TTL 폭탄: 100만 키가 같은 시각에 만료되자 응답이 1ms 에서 20ms 로 튀었습니다. Redis 가 만료 키를 청소하는 두 방식과, 만료 시각을 흩는 처방을 다룹니다.
- 버렸던 디스크의 귀환: 메모리가 전부라던 Redis 가 왜 AOF 로 디스크에 다시 쓰게 됐는지, 그리고 AOF 를 매초 fsync 해도 정전에 잃을 수 있는 데이터가 왜 남는지 다룹니다.
이런 식으로 CS 질문 하나를 아침마다 짧게 같이 풀어 보는 오픈채팅방이 있습니다. 개발자: 데일리 CS 역량 강화 챌린지 들어가 보기 →
1기 스터디원이 3주차 끝에 합의한 표에서
3주차의 마지막 과제는 서비스의 데이터마다 얼마나 잃어도 되는지 숫자로 정하는 일이었습니다. 1기가 합의한 표의 한 줄입니다.
| 데이터 | 잃어도 되는 양 | 돌아와야 하는 시간 | 먼저 볼 선택 | 먼저 터질 지점 |
|---|---|---|---|---|
| 짧은 작업 큐 | 0~1초 | 1분 안팎 | AOF + 복제본 | 작업 유실과 중복 |
이 줄에는 잃는 경로가 둘 섞여 있습니다. 하나는 워커가 작업을 꺼내 간 뒤 죽는 경우입니다. 단순 LPOP 큐는 그 작업이 사라지므로, LMOVE 로 처리 중 목록을 따로 두거나 Streams 처럼 확인(ack) 전까지 보관하는 구조가 필요합니다. 다른 하나는 서버 장애입니다. AOF 를 매초 fsync 해도 복제는 비동기라서, 장애 전환 순간에는 1초보다 많이 잃을 수 있습니다. 그래서 한 건도 잃으면 안 되는 큐라면 Redis 안에서 버틸지 Kafka 로 넘길지를 먼저 갈라야 합니다.
이 글의 출처
이 글은 팀그릿 「그릿 딥다이브 Vol.1 · Redis」 3주차 「생존」에서 뽑았습니다. 나머지 두 사고의 풀이와 설정, 1기 생존 예산표 전체, Streams 와 Kafka 를 가르는 기준은 책에 있습니다.