저자: 라울-게이브리얼 우르마 , 마리오 푸스코 , 앨런 마이크로프트
도서명: 모던 자바 인 액션
출판사: 한빛미디어
병렬 스트림
컬렉션에 parallelStream을 호출하면 병렬 스트림이 생성된다.
병렬 스트림이란 각각의 스레드에서 처리할 수 있도록 스트림 요소를 여러 청크로 분할한 스트림이다.
병렬 스트림을 이용하면 모든 멀티코어 프로세서가 각각의 청크를 처리하도록 할당할 수 있다.
스트림 성능 측정
@Benchmark // 벤치마크 대상 메서드
public long numberSum() { // for문 사용
    long result = 0;
    for (long i = 1L; i <= N; i++) {
        result += i;
    }
    return result;
}

@Benchmark
public long streamNumberSum() { // Stream.iterate 사용
    return Stream.iterate(1L, i -> i + 1)
            .limit(N)
            .reduce(0L, Long::sum);
}

@Benchmark
public long streamParallelNumberSum() { // Stream.iterate 사용, 병렬처리
    return Stream.iterate(1L, i -> i + 1)
            .limit(N)
            .parallel()
            .reduce(0L, Long::sum);
}

@Benchmark
public long longStreamNumberSum() { // LongStream.rangeClosed 사용
    return LongStream.rangeClosed(1L, N)
            .reduce(0L, Long::sum);
}

@Benchmark
public long longStreamParallelNumberSum() { // LongStream.rangeClosed 사용, 병렬 처리
    return LongStream.rangeClosed(1L, N)
            .parallel()
            .reduce(0L, Long::sum);
}
Benchmark Mode Cnt Score Error Units
ParallelStreamBenchmark.longStreamNumberSum avgt 10 4.744 ± 0.414 ms/op
ParallelStreamBenchmark.longStreamParallelNumberSum avgt 10 2.365 ± 2.894 ms/op
ParallelStreamBenchmark.numberSum avgt 10 2.521 ± 0.070 ms/op
ParallelStreamBenchmark.streamNumberSum avgt 10 73.067 ± 3.583 ms/op
ParallelStreamBenchmark.streamParallelNumberSum avgt 10 90.832 ± 4.587 ms/op병렬 스트림 성능 하락 원인
- iterate는 박싱된 객체가 만들어지므로 더하기 연산 시 언박싱을 해야한다.
- iterate는 본질적으로 순차적이다. 이전 연산의 결과에 따라 다음 함수의 입력이 달라지기 때문에 iterate 연산을 청크로 분할하기가 어렵다.
참고
https://log-laboratory.tistory.com/203
https://mong9data.tistory.com/131
병렬 스트림의 올바른 사용법
공유된 상태를 바꾸는 알고리즘을 사용할 때 병렬 스트림을 사용하면 문제가 발생한다.
public long sideEffectParalleSum(long n) {
    Accumulator accumulator = new Accumulator();
    LongStream.rangeClosed(1, n).parallel().forEach(accumulator::add);
    return accumulator.total;
}

public class Accumulator {
    public long total = 0;
    public void add(long value) { total += value; }
}
병렬 스트림 효과적으로 사용하기
이펙티브 자바에서는 병렬 스트림을 아예 사용하는걸 지양하기를 권장한다.
그 이유는 위에 소개한바와 같다. 하지만 그래도 병렬 스트림을 이용해 성능 개선을 노려볼 생각이라면 다음의 내용이 약간의 힌트는 될 수 있다.
- 성능에 대한 확신이 없는 경우 자바 마이크로 벤치마크 하니스(JMH)를 통해 성능을 직접 측정할 수 있다.
- 박싱을 주의하자.
- 박싱은 성능을 크게 저하시킬 수 있는 요소이기 때문에 이를 방지하기 위해 기본형 특화 스트림(IntStream, LongStream, DoubleStream)을 제공한다.
- 순서 연산에 유의하자. 순서가 상관없는 findAny 같은 경우 병렬 처리가 빠르다.
- limit이나 findFirtst처럼 요소의 순서에 의존하는 연산의 경우 비싼 비용을 요구한다.
- 스트림에서 수행하는 전체 파이프라인 연산 비용을 고려하자.
- 처리할 요소 수를 N, 처리 비용을 Q라고하면 전체 비용은 N * Q 라고 할 수 있는데, Q가 높아진다면 병렬 스트림으로 성능 개선 가능성이 있음을 의미한다.
- 소량의 데이터에서는 병렬 처리가 도움이 되지 않는다.
- 자료구조가 적절한지 확인하자.
- LinkedList는 분할 하기 위해서 모든 요소를 탐색해야 하지만, ArrayList는 탐색하지 않아도 분해할 수 있다. 커스텀 Spliterator를 구현해 분해를 제어할 수 있다.
- 스트림의 특성과 파이프라인의 중간 연산에 따라 성능이 달라진다.
- SIZED 스트림의 경우 정확히 같은 크기로 분할이 가능하지만, filter 연산은 스트림의 길이를 예측할 수 없어 효과적이지 않다.
- 최종 연산의 병합 과정 비용을 살펴보자.
- 병합 과정의 비용이 비싸다면, 병렬 스트림으로 얻은 이익이 상쇄되고 만다.
자료구조에 따른 분해 성능
| 자료구조 | 분해 성능 |
|---|---|
| ArrayList | 매우 좋음 |
| LinkedList | 나쁨 |
| IntStream.range | 매우 좋음 |
| Stream.iterate | 나쁨 |
| HashSet | 좋음 |
| TreeSet | 좋음 |
포크/조인 프레임워크
병렬 스트림이 수행되는 내부 인프라구조는 자바7에서 추가된 포크/조인 프레임워크로 병렬 스트림이 처리된다.
- 포크/조인 프레임워크는 병렬화할 수 있는 작업을 재귀적으로 작은 작업으로 분할한 다음에 서브태스크 각각의 결과를 합쳐서 전체 결과를 만들도록 설계되었다.
- 포크/조인 프레임워크에서는 서브태스크를 스레드 풀(ForkJoinPool)의 작업자 스레드에 분산 할당하는 ExecutorService 인터페이스를 구현한다.
- RecursiveAction 또는 RecursiveTask 추상 클래스를 상속받아서 구현
- RecursiveAction: 반환값이 없을 때
- RecursiveTask: 반환값이 있을 때
RecursiveTask 활용
- 스레드 풀을 이용하려면 RecursiveTask의 서브클래스를 만들어야 한다.
- RecursiveTask를 정의하려면 추상 메서드 compute를 구현해야 한다.
protected abstract R compute();- compute 메서드는 태스크를 서브태스크로 분할하는 로직과 더 이상 분할할 수 없을 때 개별 서브태스크의 결과를 생산할 알고리즘을 정의한다.
작업 훔치기
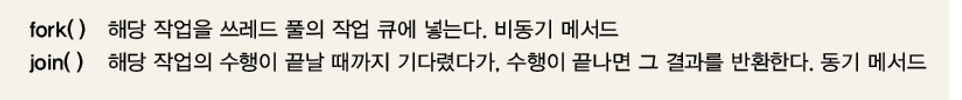
fork()가 호출되어 작업 큐에 추가된 작업 역시, compute()에 의해 더 이상 나눌 수 없을 때까지 반복해서 나뉘고, 자신의 작업 큐가 비어있는 쓰레드는 다른 쓰레드의 작업 큐에서 작업을 가져와서 수행한다.
이것을 작업 훔쳐오기라고 하며, 이 과정은 모두 쓰레드풀에 의해 자동적으로 이루어진다.
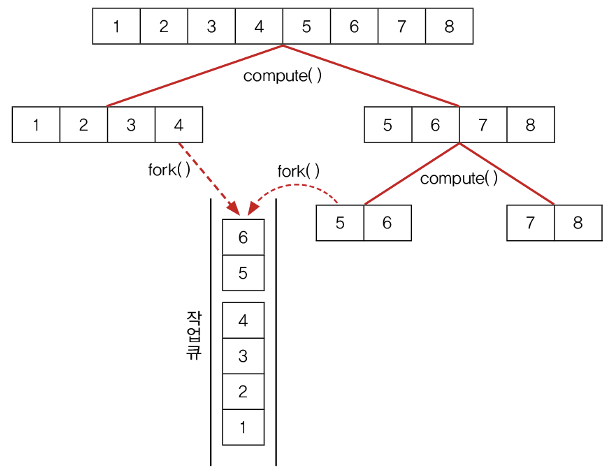
포크/조인 프레임워크를 제대로 사용하는 방법
- join 메서드를 태스크에 호출하면 태스크가 생산하는 결과가 준비될 때 까지 호출자를 블록시킨다. 따라서 두 서브태스크가 모두 시작된 다음에 join을 호출해야 한다. 그렇지 않으면 각각의 서브태스크가 다른 태스크가 끝나길 기다리게 되면서 순차 알고리즘보다 느리고 복잡한 프로그램이 될 수 있다.
- RecursiveTask 내에서는 ForkJoinPool의 invoke 메서드 대신 compute나 fork 메서드를 호출한다. 순차 코드에서 병렬 계산을 시작할 때만 invoke를 사용한다.
- 두 서브태스크에서 메서드를 호출할 때는 fork와 compute를 각각 호출하는 것이 효율적이다. 그러면 두 서브태스크의 한 태스크에는 같은 스레드를 재사용할 수 있으므로 풀에서 불필요한 태스크를 할당하는 오버헤드를 피할 수 있다.
즉 compute()는 새 스레드를 사용하지 않기 때문 - 포크/조인 프레임워크를 이용하는 병렬 계산은 디버깅이 어렵다.
- 멀티코어에서 포크/조인 프레임워크를 사용하는 것이 순차처리보다 무조건 빠른 것은 아니다. 병렬 처리로 성능을 개선하려면 태스크를 여러 독립적인 서브태스크로 분할할 수 있어야 한다.
그렇다면 스트림은 어떻게 분할 로직을 개발하지 않고도 자동으로 스트림을 분할할까??
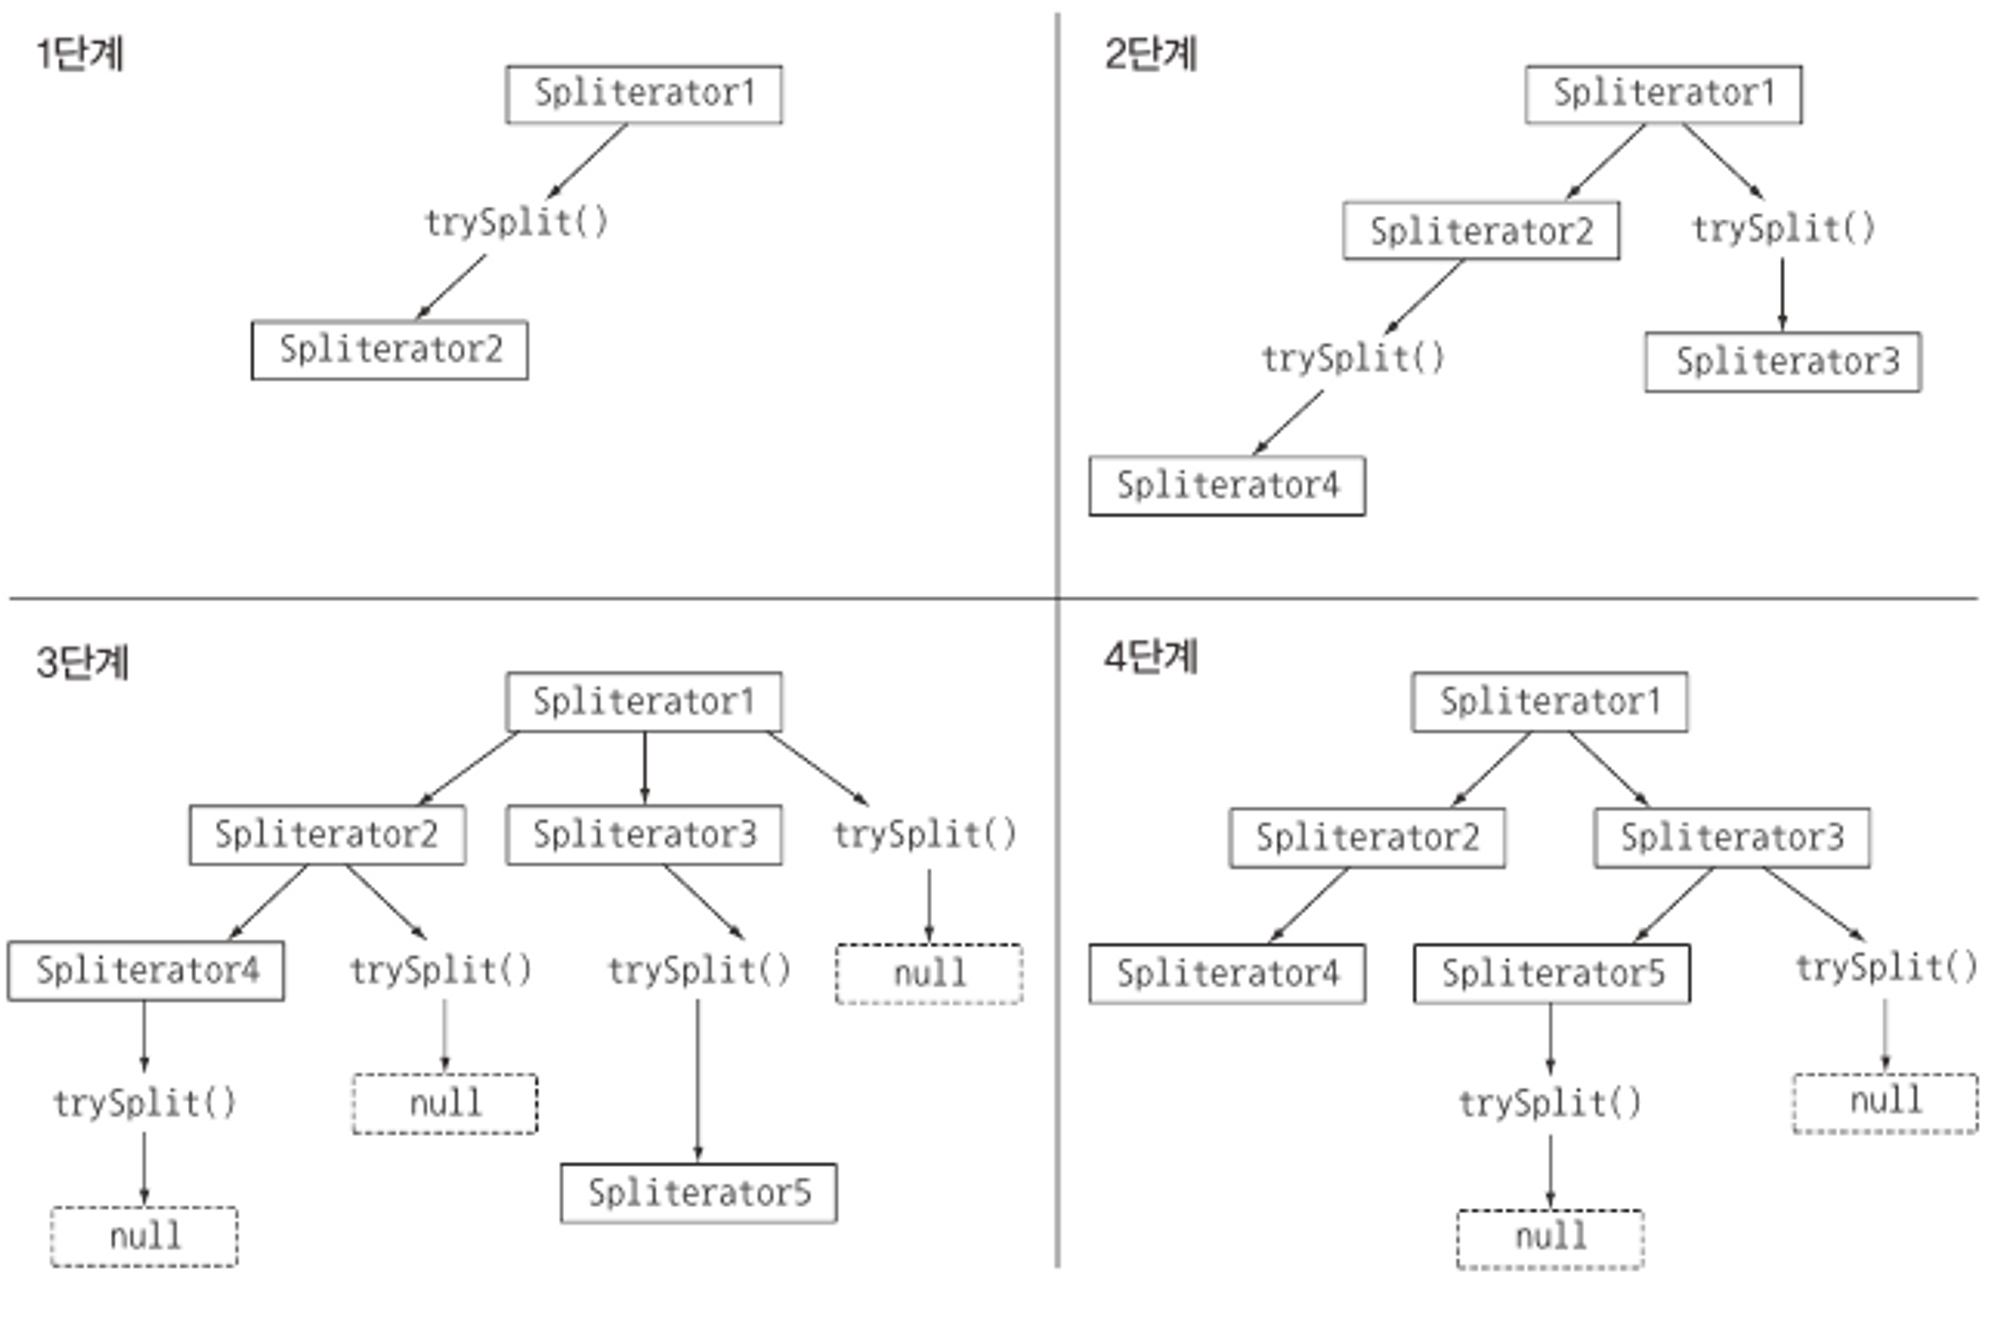
스트림을 자동으로 분할해주는 기능이 이미 존재하기 때문인데, 이 기능은 스트림을 분할하는 기법인 Spliterator을 이용하는 것이다.
Spliterator 인터페이스
public interface Spliterator<T> {
	boolean tryAdvanace(Consumer<? super T> action);
	Spliterator<T> trySplit();
	long estimateSize();
	int characteristics();
}