1. 트랜스포트 계층 서비스 및 개요
트랜스포트 계층 프로토콜은 각기 다른 호스트에서 동작하는 애플리케이션 프로세스 간의 논리적 통신(logical communication)을 제공한다.
TCP & UDP
Transmission Control Protocol, TCP
신뢰적이고 연결지향형 서비스를 제공한다. (reliable data transfer)
혼잡 제어(congestion control) : 혼잡한 네트워크 링크에서 각 TCP 연결이 링크의 대역폭을 공평하게 공유하여 통과하도록 해준다.
User Datagram Protocol, UDP
비신뢰적이고 비연결형인 서비스를 제공한다.
UDP 트랜스포트 프로토콜을 사용하는 애플리케이션은 허용이 되는 한, 그것이 만족하는 어떤 속도로든 전송할 수 있다.
2. 다중화와 역다중화
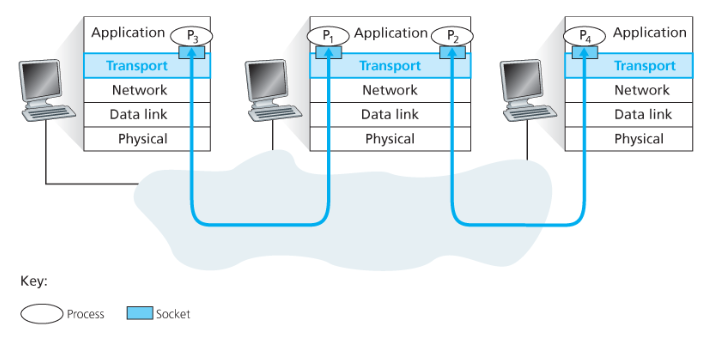
-
역다중화(demultiplexing)
트랜스포트 계층 세그먼트의 데이터를 올바른 소켓으로 전달하는 작업을 말한다. -
다중화(multiplexing)
출발지 호스트에서 소켓으로 부터 데이터를 모으고,
이에 대한 세그먼트를 생성하기 위해 각 데이터에 헤더 정보로 캡슐화(encapsulation) 한다.
그 세그먼트들을 네트워크 계층으로 전달한다.
역다중화 서비스의 순서
- 호스트의 각 소켓은 포트 번호를 할당받는다.
- 세그먼트가 호스트에 도착하면,
a. 트랜스포트 계층은 세그먼트 안의 목적지 포트 번호를 검사하고,
b. 그에 상응하는 소켓으로 세그먼트를 보낸다. - 세그먼트의 데이터는 소켓을 통해 해당되는 프로세스로 전달된다.
3. 비연결형 트랜스포트: UDP
특징
비연결형 (Connectionless) 프로토콜:
UDP는 데이터를 전송하기 전에 연결을 설정하지 않는다. 즉, 데이터를 보내기 위해 송신자와 수신자가 먼저 연결을 확립할 필요가 없다. 이로 인해 오버헤드가 적고 데이터 전송 속도가 빠르다.
신뢰성 보장 없음:
UDP는 데이터 전송 시 신뢰성을 보장하지 않는다. 데이터가 손실되거나 순서가 뒤바뀌거나 중복될 수 있다. 수신자가 데이터를 받지 못하더라도 송신자는 이를 확인하지 않으며, 재전송도 하지 않는다.
데이터그램 기반:
UDP는 데이터를 데이터그램이라는 단위로 전송한다. 각 데이터그램은 독립적으로 전송되며, 데이터그램 간의 순서를 유지하지 않는다. 즉, 여러 데이터그램이 전송될 때 순서가 보장되지 않습니다.
오버헤드가 적음:
UDP 헤더는 8바이트로 매우 간단하다. TCP의 20바이트 헤더에 비해 작기 때문에 오버헤드가 적어, 빠른 데이터 전송이 가능하다.
단점
UDP는 혼잡 제어(congestion control)를 하지 않는다.
(혼잡 제어는 네트워크가 꼭 필요한 작업을 할 수 없게 되는 폭주 상태에 빠지는 것을 막기 위해 반드시 필요하다.)
만약 모두가 혼잡 제어를 사용하지 않고 높은 비트의 비디오 스트리밍을 시작한다면,
1.라우터에 많은 패킷 오버플로가 발생할 것이다.
→ 소수의 UDP 패킷만이 출발지-목적지 간의 경로를 무사히 통과할 것이다.
2.제어되지 않은 UDP 송신자에 의해 발생한 높은 손실률은 그 손실률을 감소시키기 위해 TCP 송신자들이 속도를 줄이도록 할 것이다.
→ TCP 세션의 혼잡이 발생할 것이다.
UDP 헤더의 필드
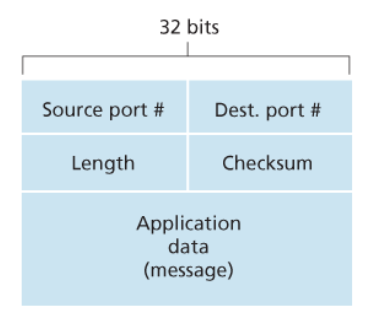
출발지 포트 번호 (Source Port)
목적지 포트 번호 (Destination Port)
길이 (Length)
체크섬 (Checksum)
체크섬
UDP 체크섬은 세그먼트가 출발지로부터 목적지로 이동했을 때,
UDP 세그먼트 안의 비트에 대한 변경사항이 있는지 검사하여 오류 검출을 하기 위한 것이다.
UDP는 왜 체크섬을 제공하는가?
출발지와 목적지 사이의 모든 링크가 오류 검사를 제공한다는 보장이 없기 때문이다.
따라서 세그먼트들이 정확하게 링크를 통해 전송되었을지라도, 세그먼트가 라우터의 메모리에 저장될 때 비트 오류가 발생할 수가 있다.
💡 UDP는 오류 검사를 제공하지만, 오류를 회복하기 위한 어떤 일도 하지 않는다.
손상된 세그먼트를 그냥 버리기도 하고, 경고와 함께 손상된 세그먼트를 애플리케이션에게 넘겨주기도 한다. (처리 방식은 구현에 따라서 다름)
주어진 링크 간의 신뢰성과 메모리의 오류 검사가 보장되지도 않고, 종단 간의 데이터 전송 서비스가 오류 검사를 제공해야 한다면 UDP는 종단 기반으로 트랜스포트 계층에서 오류 검사를 제공해야만 한다.
→ 이것은 종단과 종단의 원칙(end-end principle)의 한 예시이다.
종단과 종단의 원칙(end-end principle)
종단 간 원칙(end-to-end principle)은 컴퓨터 네트워킹에서 시스템 설계의 기본 원칙 중 하나입니다.
1. 종단 간 원칙의 기본 개념
종단 간 원칙은 네트워크의 핵심 기능들은 네트워크 중간 지점(라우터, 스위치 등)보다는 통신을 실제로 수행하는 양 끝단(통신을 주고받는 기기)에서 구현해야 한다는 개념입니다. 네트워크 중간에 있는 장치들은 단순히 데이터를 전달하는 역할만 하고, 실제 중요한 기능(데이터 무결성 확인, 오류 복구 등)은 송신자와 수신자에서 처리해야 한다는 것입니다.
2. 쉽게 설명하기 위한 예시
편지를 보내는 상황을 상상해 봅시다:
- 당신이 친구에게 편지를 보내는데, 이 편지는 우체국을 거쳐 친구에게 전달됩니다.
- 편지의 내용이 정확히 전달되었는지 확인하는 것은 누구의 역할일까요?
- 우체국에서 일일이 편지를 열어 내용을 확인하고 수정하는 것이 맞을까요?
- 아니면 당신과 친구가 서로 "편지가 제대로 도착했는지" 확인하는 것이 맞을까요?
종단 간 원칙에 따르면, 우체국(네트워크 중간 지점)은 단순히 편지를 전달만 하고, 편지의 내용이 정확한지 확인하는 책임은 당신과 친구에게 있습니다.
3. 네트워크에서의 적용
- 네트워크에서 데이터를 전송할 때, 데이터가 손상되지 않았는지, 손실되지 않았는지 등을 확인하는 것은 송신자와 수신자(즉, 통신의 양 끝단)의 책임입니다.
- 네트워크 중간의 라우터나 스위치들은 데이터를 전달하는 데 집중하고, 데이터의 정확성이나 신뢰성은 송신자와 수신자가 관리합니다.
4. 왜 이런 원칙이 중요할까?
- 네트워크의 중간 장치들이 모든 오류 검사를 한다면, 네트워크는 너무 복잡해지고 성능이 떨어질 수 있습니다.
- 반면, 오류 검사는 통신의 양 끝단에서만 이루어진다면 네트워크 중간은 단순해지고 효율적이 됩니다. 또한, 모든 네트워크 통신에서 동일한 오류 검사나 복구가 필요한 것은 아니므로, 각 애플리케이션이 필요한 만큼만 오류 관리를 할 수 있습니다.
5. 결론
종단 간 원칙은 중요한 기능은 데이터를 실제로 주고받는 양 끝단에서 처리하고, 중간 지점은 단순히 데이터 전달만 담당하라는 것입니다. 이를 통해 네트워크는 더 간단해지고 효율적이 됩니다.
4. 신뢰적인 데이터 전송의 원리
신뢰적인 데이터 전송의 원리
서비스 모델과 구현
서비스 모델: 신뢰적인 데이터 전송의 기본 개념은, 데이터가 손상되거나 순서가 바뀌지 않고 전송된 순서 그대로 전달되는 것이다. 예를 들어, TCP는 이런 신뢰성을 제공하는 프로토콜이다.
서비스 구현: 신뢰적인 데이터 전송 프로토콜은 이러한 신뢰성을 보장하는 기능을 구현한다.
프로토콜의 작동
신뢰적인 데이터 전송 프로토콜은 송신자와 수신자 측에서 다음과 같은 기능을 갖는다.
- 송신자: 데이터를 전송하고, 전송 완료 후 확인 응답을 기다린다.
- 수신자: 데이터를 수신하고, 정확히 수신된 경우 확인 응답(ACK)을 송신자에게 보낸다.
오류가 발생한 경우, 부정 확인 응답(NAK)을 보낸다.
신뢰적인 데이터 전송 프로토콜의 단계
-
rdt1.0: 가장 기본적인 형태로, 신뢰적인 채널에서 동작한다. 송신자는 데이터를 보내고, 수신자는 데이터를 정확히 수신하여 상위 계층으로 전달한다.
-
rdt2.0: 비트 오류를 처리하기 위해 오류 검출(체크섬), 수신자 피드백(ACK, NAK), 재전송 기능을 추가한다. 송신자는 패킷이 손상되면 재전송한다.
-
rdt2.1: rdt2.0의 확장 버전으로, 패킷에 순서 번호를 추가하여 패킷의 순서를 관리한다. 수신자는 중복된 ACK를 통해 재전송된 패킷을 구분한다.
-
rdt2.2: NAK 패킷 없이 ACK와 순서 번호를 포함하여 신뢰성을 높인다. 수신자는 정확한 패킷 번호를 포함한 ACK를 보낸다.
-
rdt3.0: 패킷 손실을 처리하기 위해 타이머를 사용하여 일정 시간 내에 ACK를 받지 못하면 패킷을 재전송한다. 패킷 손실과 ACK 손실을 구분하고 처리한다.
cf. rdt 3.0이 최상위 버전이라고해서 현대의 라우터들이 rdt 3.0을 사용하는 것이 아니다.
현대의 네트워크 프로토콜은 rdt 3.0과 같은 기본적인 신뢰성 전송 메커니즘을 포함하고 있지만, 더 복잡하고 발전된 방식으로 구현된다.
-> TCP: TCP는 rdt 3.0의 개념을 포함하며, 세그먼트의 순서 보장, 오류 검출, 흐름 제어, 혼잡 제어 등의 추가적인 기능을 제공한다.
파이프라이닝을 통한 성능 향상
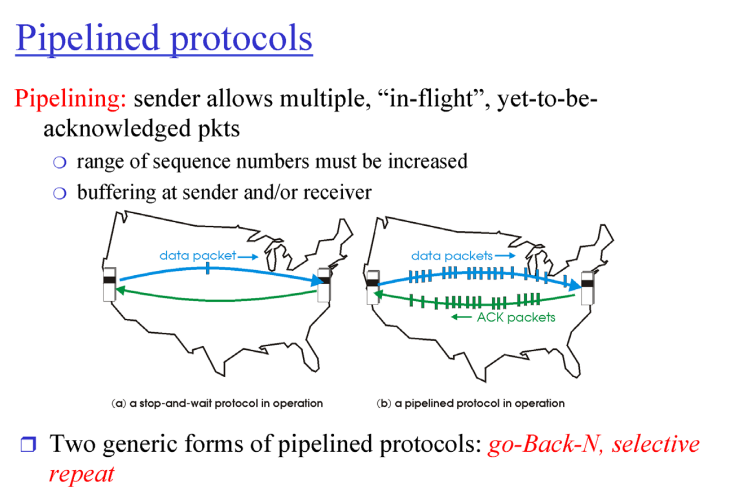
기존의 신뢰적인 데이터 전송 프로토콜에서는 stop-and-wait 방식을 사용하여 송신자가 패킷을 송신한 후 확인 응답(ACK)을 기다리는 구조다. 이 방식은 네트워크 성능에 다음과 같은 문제를 야기한다.
-
비효율성: 송신자가 매 패킷에 대해 확인 응답을 기다리는 동안, 채널은 대기 상태로 남게 된다. 이로 인해 네트워크의 대역폭을 충분히 활용하지 못하고, 전송 속도가 제한된다.
-
높은 지연: 패킷을 하나씩 전송하고 확인 응답을 기다리는 동안 지연이 누적되며, 전체 전송 속도가 느려진다.
파이프라이닝을 도입하면 이러한 비효율성을 크게 개선할 수 있다. 파이프라이닝을 사용하면 송신자가 ACK를 기다리지 않고 여러 패킷을 동시에 전송할 수 있다. 이 방식은 송신자가 데이터를 송신하고 수신자가 확인 응답을 병렬적으로 처리할 수 있어 네트워크의 효율성을 향상시킨다.
- 파이프라이닝: 송신자는 ACK를 기다리지 않고 여러 패킷을 전송하며, 윈도우 크기만큼 패킷을 동시에 전송할 수 있다.
파이프라이닝 프로토콜
-
GBN (Go-Back-N)
- 작동 방식: 송신자는 확인 응답을 기다리지 않고 여러 패킷을 연속적으로 전송할 수 있다.
송신자는 윈도우 크기만큼의 패킷을 전송한 후, 이전 패킷에 대한 확인 응답을 기다린다.
만약 특정 패킷이 손실되거나 오류가 발생하면, 그 패킷부터 윈도우 내의 모든 패킷이 재전송된다. - 장점: 송신자는 ACK를 기다리지 않기 때문에 전송 효율성이 높아진다.
- 단점: 패킷 손실이나 오류가 발생하면 손실된 패킷 이후의 모든 패킷이 재전송되므로, 재전송 오버헤드가 증가할 수 있다.
- 작동 방식: 송신자는 확인 응답을 기다리지 않고 여러 패킷을 연속적으로 전송할 수 있다.
-
SR (Selective Repeat)
- 작동 방식: 송신자는 윈도우 크기만큼의 패킷을 동시에 전송하며, 수신자는 각 패킷의 순서 번호를 통해 패킷을 식별한다. 손실된 패킷이나 오류가 발생한 패킷만을 재전송하며, 나머지 패킷은 그대로 유지된다. 수신자는 패킷을 수신하고, 제대로 수신한 패킷은 ACK를 전송한다.
- 장점: 손실된 패킷만 재전송되므로 재전송 오버헤드가 줄어들고, 전송 효율성이 개선된다.
- 단점: 수신자는 패킷의 순서를 재조립하는 과정이 복잡할 수 있으며, 송신자와 수신자 모두에서 관리해야 할 상태 정보가 많아질 수 있다.
cf. 고전 프로토콜 - Stop and wait
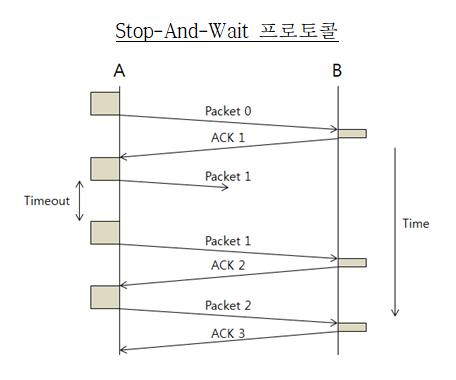
stop-and-wait 방식은 데이터 전송 프로토콜의 초창기에서 기본적인 오류 제어를 제공하기 위해 널리 사용되었다. 그러나 현대의 고속 네트워크 환경에서는 효율성이 떨어지기 때문에, 파이프라이닝 기법을 사용하는 GBN이나 SR과 같은 고급 프로토콜이 선호된다.
5. 연결지향형 트랜스포트: TCP
특징
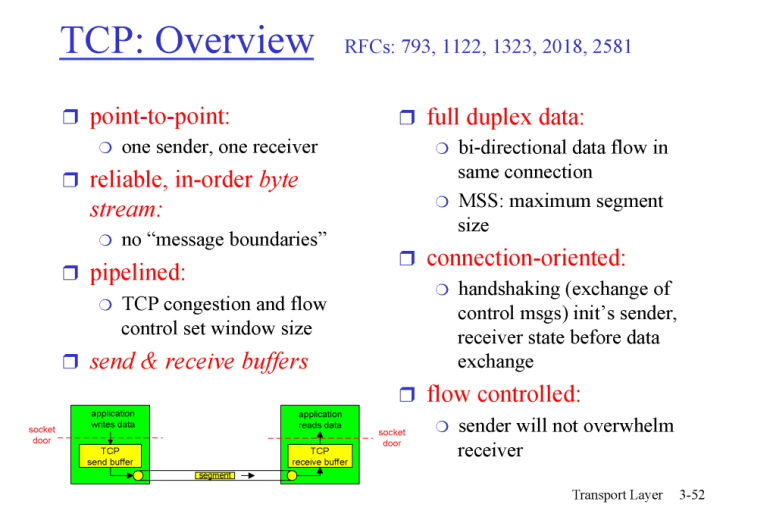
(1) point-to-point : 1대 1 대응 방식으로 연결이 맺어지면 맺어진 곳이랑만 통신을 한다.
(2) reliable, in-order byte steam : application message가 유실 없이 순서를 유지한 채로 보내지는 것
(3) pipelined : 메시지를 한 번에 많이 보낼 수 있는 것
(4) full duplex data : sender와 receiver가 고정된 것이 아닌, sender이자 receiver인 것
(5) connection-oriented : 초기에 handshake를 통해 연결을 맺는 것
(6) flow controlled : 상대방 머신의 성능에 맞게 보내는 것 애플리케이션에서 내려오는 속도는 애플리케이션이 결정된다.(소켓을 통해서 내려오는 속도는 프로세스 마음)
데이터와 세그먼트가 나가는 속도는 상대방 머신이 처리할 수 있는 속도에 맞게 tcp가 결정 후 보내주어야 한다.
(ref. https://esyeonge.tistory.com/62)
TCP 헤더
-
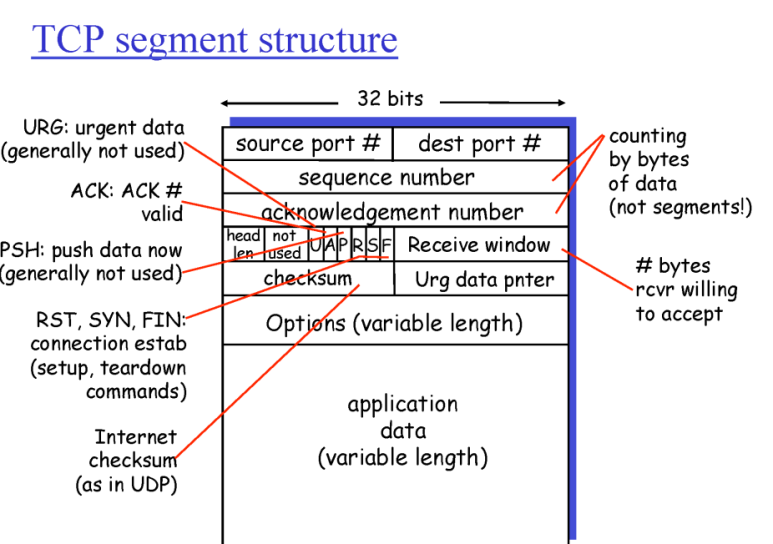
시퀀스 번호 (Sequence Number)
시퀀스 번호는 전송되는 각 TCP 세그먼트 내의 첫 번째 바이트의 순서 번호를 나타낸다.
이 번호를 통해 수신자는 세그먼트의 순서를 정확하게 파악하고, 어떤 데이터가 이미 수신되었는지, 어떤 데이터가 분실되었는지를 알 수 있다. -
승인 번호 (Acknowledgement Number)
승인 번호는 수신자가 다음에 기대하는 시퀀스 번호를 송신자에게 알려주는 역할을 한다.
즉, 이 번호는 수신자가 성공적으로 받은 데이터 바이트의 다음 번호를 나타낸다.
이를 통해 송신자는 어떤 데이터가 성공적으로 전송되었는지를 알 수 있다. -
수신 윈도우 (Receive Window)
수신 윈도우는 수신자가 한 번에 수신할 수 있는 데이터의 양(바이트 단위)을 나타낸다.
이는 네트워크의 혼잡 상태나 수신자의 처리 능력에 따라 조정될 수 있으며, 흐름 제어를 가능하게 한다.
예시)
TCP 시퀀스 번호와 데이터 전송
TCP는 데이터 전송의 신뢰성을 보장하기 위해 시퀀스 번호를 사용한다.
예를 들어, 'Hello'라는 문자열을 TCP를 통해 전송할 때, 시퀀스 번호가 42라고 가정해 보자. 이 경우, 시퀀스 번호 42는 'Hello' 문자열의 첫 번째 바이트('H')가 전송 스트림 내에서 42번째 위치에 있음을 의미한다.
시퀀스 번호 42: 'H'
시퀀스 번호 43: 'e'
시퀀스 번호 44: 'l'
시퀀스 번호 45: 'l'
시퀀스 번호 46: 'o'
각 바이트는 연속적인 시퀀스 번호를 가진다.
따라서 'H'는 시퀀스 번호 42를 가지며, 그 다음 바이트인 'e'는 시퀀스 번호 43을 갖는다.
이 방식으로 문자열의 나머지 바이트들도 시퀀스 번호를 통해 식별된다.
TCP의 시퀀스 번호 사용
-
초기 시퀀스 번호(ISN): TCP 연결이 시작될 때, 송신자는 임의의 초기 시퀀스 번호(ISN)를 선택한다. 이후 전송되는 각 바이트는 이 시퀀스 번호를 기반으로 할당된다.
-
데이터 순서 관리: TCP는 시퀀스 번호를 통해 데이터의 순서를 정확하게 관리한다. 만약 네트워크 중간에서 데이터가 유실되거나 순서가 바뀌면, 수신자는 시퀀스 번호를 사용하여 이를 감지할 수 있다. 이후 올바른 순서로 데이터를 재조립하거나 누락된 데이터를 재요청한다.
실제 사용 예
웹 브라우징 (HTTP): 웹 페이지를 요청할 때, 1~41번 시퀀스 번호 범위에는 HTTP 요청의 헤더나 다른 리소스 요청이 포함될 수 있다. 이는 요청에 따라 달라질 수 있다.
이메일 전송 (SMTP): 이메일을 전송할 때는 1~41번 시퀀스 번호 범위에 이메일의 헤더나 본문, 기타 메타데이터가 포함될 수 있다. 이 역시 전송 내용에 따라 달라진다.
TCP 전송방식
-
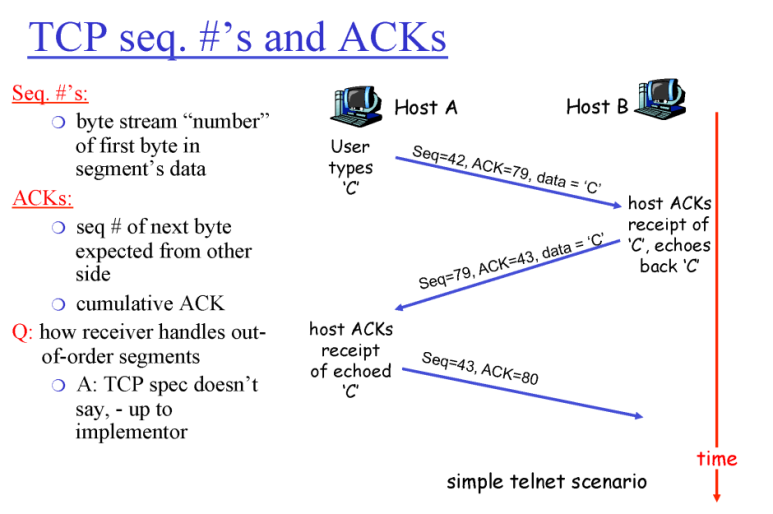
사용자가 'C'를 입력함
-
Seq=42: 호스트 A가 데이터를 전송할 때 사용하는 시퀀스 번호다. 이는 현재 전송되는 데이터 패킷의 시작 번호이다.
-
ACK=79: 호스트 A가 호스트 B로부터 받기를 기대하는 다음 데이터 패킷의 시퀀스 번호다. 이는 호스트 A가 지금까지 호스트 B로부터 정상적으로 수신한 데이터의 시퀀스 번호에 대한 확인 응답이다.
-
data='C': 현재 전송하는 데이터다.
-
-
호스트 B가 'C'를 수신하고 에코로 돌려보냄
-
Seq=79: 호스트 B가 에코 데이터를 전송할 때 사용하는 시퀀스 번호다. 이는 호스트 B가 현재 전송하는 데이터 패킷의 시작 번호를 의미한다.
-
ACK=43: 호스트 B가 호스트 A로부터 받기를 기대하는 다음 데이터 패킷의 시퀀스 번호이다. 이는 호스트 B가 지금까지 호스트 A로부터 정상적으로 수신한 데이터의 시퀀스 번호에 대한 확인 응답이다. 'C' 문자를 포함한 데이터가 정상적으로 수신되었으므로, 호스트 A의 다음 시퀀스 번호는 43이 된다.
-
data='C': 호스트 B가 호스트 A에게 다시 보내는 에코 데이터다. 호스트 B가 수신한 'C'를 다시 호스트 A로 전송하여 데이터가 정상적으로 수신되었음을 알린다.
-
-
호스트 A가 에코된 'C'의 수신을 확인함
-
Seq=43: 호스트 A가 다음에 데이터를 전송할 때 사용할 시퀀스 번호이다. 이는 호스트 A가 이번에 데이터를 전송하지 않았음에도 불구하고, 앞서 보낸 'C'에 대한 응답으로 ACK를 보내는 과정에서 사용된다.
-
ACK=80: 호스트 A가 호스트 B로부터 받기를 기대하는 다음 데이터 패킷의 시퀀스 번호다. 이는 호스트 A가 호스트 B로부터 에코된 'C'를 정상적으로 수신하였으며, 다음에 수신할 데이터의 시작 시퀀스 번호를 의미한다.
-
참고: TCP와 UDP의 ACK 차이
-
UDP의 ACK: ACK 10은 패킷 9까지를 잘 받았으니 패킷 10을 달라는 의미이다.
-
TCP의 ACK: ACK 10은 패킷 10까지를 잘 받았으니 패킷 11을 달라는 의미이다.
TCP는 Cumulative ACK를 사용하며, 이는 수신자가 마지막으로 제대로 받은 데이터까지의 시퀀스 번호를 확인 응답으로 보내는 방식입니다.
TCP 신뢰성 있는 데이터 전송
TCP 연결이 설정되면, 각 소켓에는 송신 버퍼(Send Buffer)와 수신 버퍼(Receive Buffer)가 생성됩니다. 즉, 총 4개의 버퍼가 생성된다.
송신 버퍼 (Send Buffer)
- 역할: 애플리케이션이 보내려는 데이터를 임시로 저장하는 공간이다. 애플리케이션이 데이터를 송신할 때, 데이터는 먼저 송신 버퍼에 저장된다. TCP 프로토콜은 이 버퍼에서 데이터를 꺼내어 네트워크를 통해 수신자에게 전송한다.
- 중요성: 송신 버퍼는 흐름 제어(flow control)와 혼잡 제어(congestion control)를 가능하게 한다.
수신 버퍼 (Receive Buffer)
- 역할: 네트워크를 통해 받은 데이터를 임시로 저장하는 공간이다. 수신된 데이터는 순서대로 수신 버퍼에 저장되며, 애플리케이션은 이 버퍼에서 데이터를 읽어 처리한다.
- 중요성: 수신 버퍼는 데이터의 순서 보장과 신뢰성 있는 전송을 지원한다. 데이터 패킷이 순서대로 도착하지 않거나 중간에 손실된 경우, TCP는 수신 버퍼를 사용하여 데이터의 순서를 재조정하거나 손실된 데이터의 재전송을 요청할 수 있다. 또한, 수신 버퍼는 흐름 제어의 일환으로 사용되어 수신 애플리케이션이 처리할 수 있는 속도를 넘어서 데이터가 전송되는 것을 방지한다.
요약
- 송신 버퍼: 애플리케이션이 보내려는 데이터를 임시 저장하며, 흐름 제어와 혼잡 제어를 위해 사용
- 수신 버퍼: 네트워크를 통해 받은 데이터를 임시 저장하며, 순서 보장, 신뢰성 있는 데이터 전송 및 흐름 제어를 위해 사용
TCP 전송 예제
1. 정상적인 데이터 전송
상황 설명: 송신 측과 수신 측 간에 데이터가 정상적으로 전송되는 상황을 가정한다.
-
송신 측 (Host A):
- 송신 버퍼에는 데이터 #0, #200, #400, #600, #800이 저장되어 있다.
- 송신 측은 데이터 #0을 전송합니다. 타이머를 시작한다.
-
수신 측 (Host B):
- 수신 측은 데이터 #0을 잘 받고, ACK #200을 송신 측에 전송한다.
-
송신 측:
- 송신 측은 ACK #200을 받으면
send base값을 0에서 200으로 업데이트한다. - 타이머를
send base에 맞춰 재설정한다. - 이제 송신 측은 다음 데이터 패킷(#200) 전송을 준비한다.
- 송신 측은 ACK #200을 받으면
-
수신 측:
- 수신 측은 데이터 #0을 애플리케이션 계층으로 전달한다.
- 수신 측은 다음 데이터 패킷(#200)을 기다린다.
요약: 데이터 #0이 정상적으로 전송되고, ACK가 수신되어 송신 측의 send base가 업데이트된다.
2. 데이터 유실 발생
상황 설명: 중간에 데이터 패킷이 유실되는 상황을 가정한다.
-
송신 측 (Host A):
- 송신 버퍼에는 데이터 #200, #400, #600, #800, #1000이 저장되어 있다.
- 송신 측은 모든 데이터 패킷을 전송하고 삭제합니다. 이 중 #400이 유실되었다.
-
수신 측 (Host B):
- 수신 측은 #200을 잘 받고, ACK #400을 송신 측에 전송한다.
- 수신 측은 #400이 유실되었으므로, 이후 패킷(#600, #800, #1000)을 무시하고 계속해서 ACK #400을 송신한다.
-
송신 측:
- 송신 측은 ACK #400을 받으면
send base를 400으로 업데이트한다. - #400 패킷이 유실되었으므로, 송신 측은 계속해서 #400을 재전송한다.
- 송신 측은 ACK #400을 받으면
-
수신 측:
- #400을 수신하면,
send base를 400으로 업데이트하고 애플리케이션 계층으로 전달한다. - 수신 측은 다음 데이터 패킷(#600)을 기다린다.
- #400을 수신하면,
요약: 데이터 #400이 유실되었고, 송신 측은 #400을 재전송하여 수신 측이 올바르게 수신할 수 있도록 한다.
3. 타이머 초과
상황 설명: 데이터 전송 중 타이머가 초과되는 상황을 가정한다.
-
송신 측 (Host A):
- 송신 버퍼에는 데이터 #0, #200, #400, #600, #800이 저장되어 있다.
- 송신 측은 데이터 #0을 전송하고 타이머를 시작한다.
-
수신 측 (Host B):
- 수신 측은 데이터 #0을 잘 받고, ACK #200을 송신 측에 전송한다.
-
송신 측:
- 타이머가 초과되기 전에 ACK #200이 도착하지 않으면, 송신 측은 타임아웃이 발생했다고 판단하고 #0을 다시 전송한다. 타이머를 재시작한다.
-
수신 측:
- 수신 측은 이미 #0을 애플리케이션 계층으로 전달하였으므로, 새로운 #0을 받았을 때 이를 무시하고, ACK #200을 다시 전송한다.
-
송신 측:
- 이번에는 ACK #200이 도착하고, 송신 측은
send base값을 0에서 200으로 업데이트한다. 타이머도 재설정된다.
- 이번에는 ACK #200이 도착하고, 송신 측은
-
수신 측:
- 수신 측은 데이터 #0을 무시하고 다음 데이터 패킷(#200)을 기다린다.
요약: 타이머가 초과되면 송신 측은 데이터를 재전송하고, 수신 측은 이미 처리한 데이터 패킷을 무시하며 정상적인 데이터 전송을 계속한다.
TCP의 핵심은 모든 패킷이 순서대로 올바르게 수신 측에 전달될 때까지 전송을 시도한다는 것이다!
무한 반복 방지
그런데 만약 항상 ack(2초)가 타이머 시간(1초)보다 느리면 무한반복되는거 아닐까?
실제 통신 환경에서는 여러 가지 메커니즘이 무한반복 상황을 방지하기 위해 도입되어 있다.
-
적응적 재전송 타임아웃(Adaptive Retransmission Timeout):
TCP는 RTT(Round-Trip Time)를 측정하여 타임아웃 간격을 동적으로 조정한다 네트워크 상태에 따라 RTT가 변하므로, TCP는 이를 기반으로 타임아웃 시간을 조정한다. -
빠른 재전송(Fast Retransmit):
송신 측이 같은 ACK를 여러 번(보통 3번) 받으면, 해당 ACK가 가리키는 패킷을 재전송한다. -
흐름 제어 및 혼잡 제어:
TCP는 흐름 제어와 혼잡 제어를 통해 네트워크의 혼잡 상태를 감지하고 데이터 전송 속도를 조절한다. 네트워크가 혼잡하다고 판단되면, TCP는 데이터 전송 속도를 줄여 네트워크의 부담을 줄이고 패킷 손실을 방지한다.
