4.1 순환신경망(Recurrent Neural Network, RNN)
ANN(Artificial Neural Network) : 사람의 신경망 원리와 구조를 모방하여 만든 기걔학습 알고리즘
-> 학습과정에서 파라미터 최적값 찾기 어렵다(출력값을 결정하는 활성함수의 사용은 기울기 값에 의해 Weight가 결정되는데 이런 gradient 값이 뒤로 갈 수록 0에 수렴하는 오류를 낳기도 하고 부분적인 에러를 최저 에러로 인식해 학습을 하지 않는 경우도 있음. 그리고 Overfitting 문제, 학습시간이 느리다는 문제도 있다. (은닉층이 많은면 정확도는 올라가지만 연산량은 기하급수적으로 늘어남)
DNN(Deep Neural Network) : 은닉층을 많이 늘려서 학습의 결과를 향상시키는 방법 (은닉층이 2개 이상을 지닌 학습 방법)
-> DNN을 이용해 만든 알고리즘이 CNN, RNN, LSTM, GRU emddl dlTek.
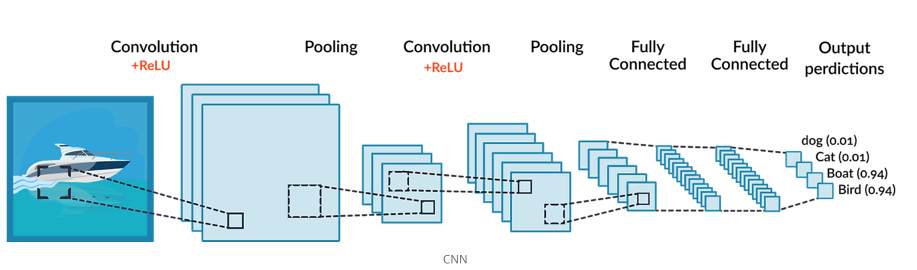
CNN(Convolution Neural Network) : 합성곱 신경망으로 기존의 방식은 데이터에서 지식을 추출했다면 CNN은 데이터의 특징을 추출해 직접 패턴을 파악하는 구조
-> Convolution 과정과 Pooling rhkwjddmf xhdgo wlsgod
1. 순환 신경망 (Recurrent Neural Network, RNN)
RNN이란 ?
반복적이고 순차적인 데이터 학습에 특화된 인공신경망의 한 종류로써 내부의 순환구조가 들어있다. 순환구조를 통해 과거의 학습을 Weight를 통해 현재 학습에 반영.
-> 기존의 지속적이고 반복적인 순차 데이터 학습의 한계를 해결한 알고리즘.
- 현재의 학습과 과거의 학습이 연결 가능하며 시간에 종속된다는 특징
- 음성 웨이브폼 파악 또는 텍스트의 앞 뒤 성분을 파악할 때 사용
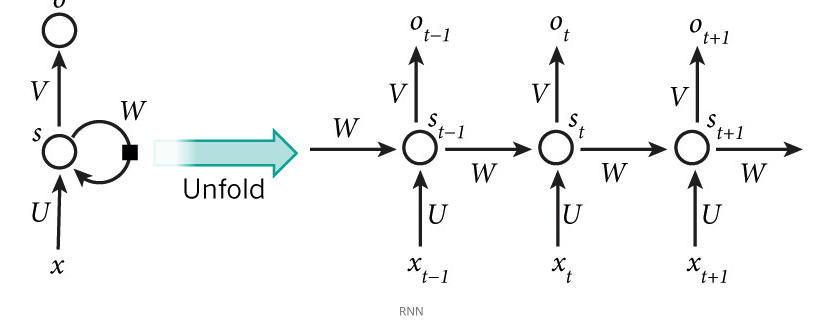
위 그림은 시점별 노드에 대해서 Weight 를 부여해 은닉층 노드에서 활성화 함수를 통해 나온 결과값을 출력층 방향으로 보내며, 다시 은닉층 노드의 다음 계산의 입력으로 보냄.
-> 이게 무슨 말이냐면 입력과 출력에 대한 vector 가 존재할 때 활성화 함수를 통해 변환된 값에 대해서 weight를 적용해 출력층으로 보내며 이때 다음 단계의 은닉층 노드에서도 값이 연속되는 것을 의미한다.(출력의 연속성이라고 생각하면 될 듯)
여기서 중요한 것은 "재귀적"이라는 단어이다. 입력과 출력에서 사용되는 데이터는 직전 시점에서 사용된 데이터로서 입력으로 들어와 출력으로 변환되며 다음 입력값으로 재사용된다.
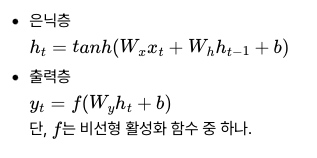
현재 t 시점에서 은닉층과 출력층의 함수적 표현
d와 D_h 모두 4라고 값을 가정하였다면 연산그림은 다음과 같다.
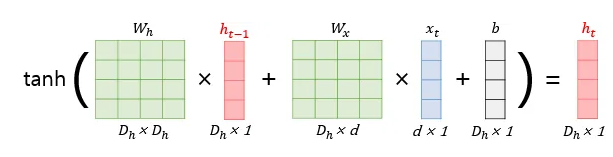
각각의 가중치 값들이 모두 시점에서 값을 공유한다. (은닉층이 2개라면 서로 다른 가중치를 가짐)
2. 파이썬으로 RNN 구현
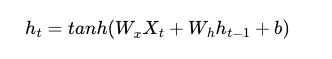
import numpy as np # numpy 텐서 환경에서 벡터 행렬 연산 가능하도록 지원하는 모듈

timesteps = 10 # 시점의 수. NLP에서는 보통 문장의 길이가 된다.
input_size = 4 # 입력의 차원. NLP에서는 보통 단어 벡터의 차원이 된다.
hidden_size = 8 # 은닉 상태의 크기. 메모리 셀의 용량이다.

inputs = np.random.random((timesteps, input_size)) # 입력에 해당되는 2D 텐서
# np.random.randm : 0 이상 1 미만의 균등분포에서 무작위 실수 생성ㅇ

hidden_state_t = np.zeros((hidden_size,)) # 초기 은닉 상태는 0(벡터)로 초기화
# 은닉 상태의 크기 hidden_size로 은닉 상태를 만듬.
초기 상태 차원의 크기가 1X8 크기의 0값으로 채워진 은닉층
print(hidden_state_t) # 8의 크기를 가지는 은닉 상태. 현재는 초기 은닉 상태로 모든 차원이 0의 값을 가짐.은닉상태 8로 정의 하였을 대 8의 차원을 가지는 0의 값으로 구성된 벡터 출력 되며, 가중치와 편향에 대한 정의 이다.
Wx = np.random.random((hidden_size, input_size))  # (8, 4)크기의 2D 텐서 생성. 입력에 대한 가중치.
Wh = np.random.random((hidden_size, hidden_size)) # (8, 8)크기의 2D 텐서 생성. 은닉 상태에 대한 가중치.
b = np.random.random((hidden_size,)) # (8,)크기의 1D 텐서 생성. 이 값은 편향(bias).
출력값
print(np.shape(Wx)) #  가중치의 크기는 차원이 8 X 4 크기인 벡터
print(np.shape(Wh))
print(np.shape(b)) # 편향의 경우 상수 값므로 8개의 원소값으로만 이뤄져 있음. 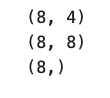
RRN 층 동작(모든 은닉상태를 출력한다고 가정)
total_hidden_states = [] # 전체 은닉층 결과값을 넣어줄 리스트 생성

# 메모리 셀 동작
for input_t in inputs: # 각 시점에 따라서 입력값이 입력됨. (입력값 만큼 반복 시행)
  output_t = np.tanh(np.dot(Wx,input_t) + np.dot(Wh,hidden_state_t) + b) # Wx * Xt + Wh * Ht-1 + b(bias)  # RNN의 새로운 은닉상태를 업데이트하는 방정식
  # np.tanh은 입력갑의 쌍곡 탄젠트값을 원소별로 계산해주는 numpy함수
  # np.dot : 두 배열의 벡터 내적 또는 행렬곲을 계산할 때 사용하는 numpy 기본 함수
  # 출력값은 항상 -1 ~ 1 사이의 범위 를 가진다.

  total_hidden_states.append(list(output_t)) # 각 시점의 은닉 상태의 값을 계속해서 축적
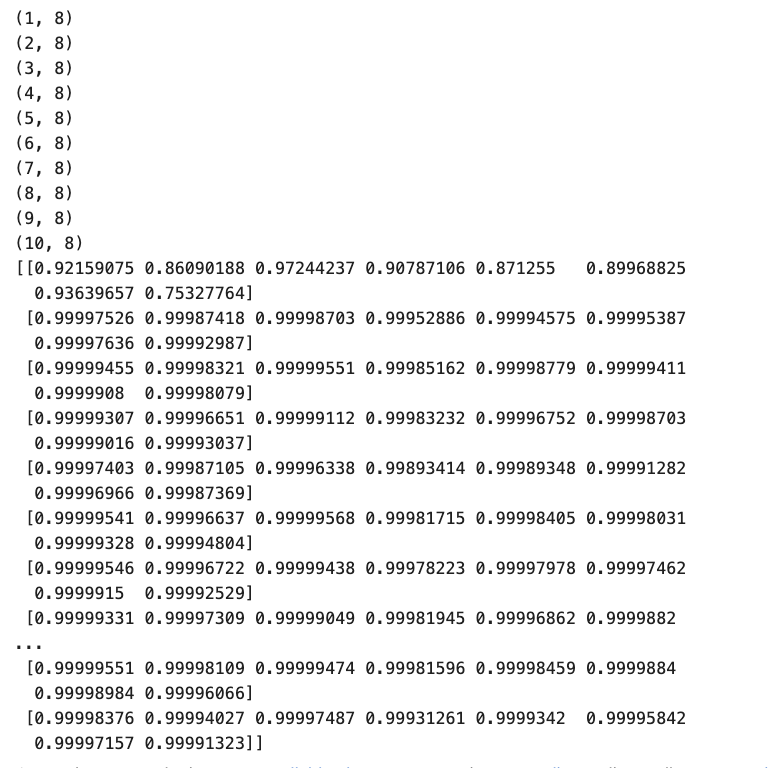
  print(np.shape(total_hidden_states)) # 각 시점 t별 메모리 셀의 출력의 크기는 (timestep, output_dim)
  hidden_state_t = output_t

total_hidden_states = np.stack(total_hidden_states, axis = 0)
# np.stack 은 기존 배열을 결합하여 새로운 축(axis)을 추가하는 numpy 함수
# 출력 시 값을 깔끔하게 해준다.

print(total_hidden_states) # (timesteps, output_dim)의 크기. 이 경우 (10, 8)의 크기를 가지는 메모리 셀의 2D 텐서를 출력.
3. 파이토치 nn.RNN()
import torch # 파이토치 rlqhs 라이브러리 불러오기
import torch.nn as nn # 파이토치 상에서 사용할 수 있는 시녁ㅇ망 레이어, 활성화 함수, 손실함수 등을 제공하는 모듈 불러오기
입력과 은닉상태의 크기 정의 단계
input_size = 5 # 입력의 크기
hidden_size = 8 # 은닉 상태의 크기
입력 벡터의 초기 설정(한번에 수행할 데이터 수
# 입력 데이터 시간/시퀀ㅅ 길이, 각 시점마다 들어가는 벡터의 차원수
# (batch_size, time_steps, input_size)
inputs = torch.Tensor(1, 10, 5)
초기 은닉상태 정의 단계
# 초기 상태 차원의 크기가 1X8 크기의 0값으로 채워진 은닉층
print(hidden_state_t) # 8의 크기를 가지는 은닉 상태. 현재는 초기 은닉 상태로 모든 차원이 0의 값을 가짐.
nn 모듈에서 RNN 순환신경망 함수를 사용하여 cell이라고 정의하는 단계
cell = nn.RNN(input_size, hidden_size, batch_first=True) # 입력값, 은닉 상태 크기, batch_first = True를 통해 입력 텐서의 첫 번째 차원이 배치 크기임을 알려줌

# 만약 batch_first = True를 안해주면 에러가 발생하거나 모델이 잘못 학습하는 문제가 발생
# dataloader에서 나오느 일반적인 배치 데이터는  (batch_size, sequence_length, input_size)로서
# 한번에 처리할 수 있는 데이터 수, 입력 데이터의 시퀀스/시간 길이(문장 당 10개 단어), 각 시점마다 들어가는 벡ㅌ의 차원 수
# sequenc_length, batch_size, input_size 순서대로 입렫 되면서 내부 행렬 연산 수행에 있어 에러를 발생 시킨다.
outputs, _status = cell(inputs)
print(outputs.shape) # 모든 time-step의 hidden_state
# 첫번째 값은 모든 시점의 은닉상태, 두번째 값은 마지막 시점의 은닉 상태
# 10번 시점동안 8차원의 은닉상태가 출력 됐다라는 것을 의미
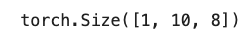
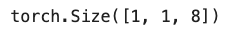
print(_status.shape) # 최종 time-step의 hidden_state
# 마지막 시점에서는 1번의 출력이 시행되고 그때 은닉은 8차원이 출력 됐다라는 것을 의미
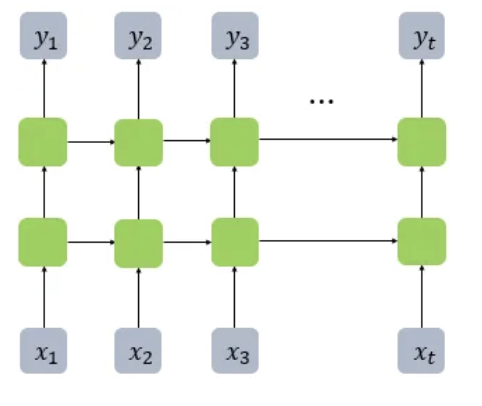
4. 깊은 순환 신경망 (Deep Recurrent Neural Network)
- 은닉층이 2개가 되는 순환 신경망
# (batch_size, time_steps, input_size) 입력 텐서
inputs = torch.Tensor(1, 10, 5)


# RNN 신경망 함수 정의 하는 단계
cell = nn.RNN(input_size = 5, hidden_size = 8, num_layers = 2, batch_first=True)
outputs, _status = cell(inputs)

# 시점별 은닉층 출력
print(outputs.shape) # 모든 time-step의 hidden_state
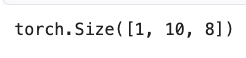
# 마지막 출력층에 대한 은닉층 상태
print(_status.shape) # (층의 개수, 배치 크기, 은닉 상태의 크기)
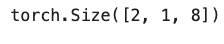
5. 양방향 순환 신경망 (Bidirectional Recurrent Neural Network)
양방향 순환 신경망은 t 시점에서의 출력값을 예측할 때 이전 신점과 이후 시점 둘 다 가지고 예측기 가능하다는 아이디어
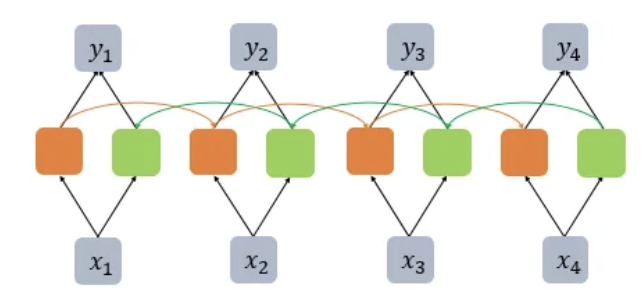
결국 이전 시점의 은닉 상태(forward states)를 전달받아 현재의 은닉 상태를 계산하며 이후의 상태를 입력 받아 현재 은닉 상태를 예측합니다. 그렇게 되면 모두 두개의 은닉 상태값을 예측하게 되고(현재시점에 해당한는) 이를 통해 출력값을 예측하게 됩니다.
# 입력값 정의
#  (batch_size, time_steps, input_size)
inputs = torch.Tensor(1, 10, 5)

# RNN 함수 정의
cell = nn.RNN(input_size = 5, hidden_size = 8, num_layers = 2, batch_first=True, bidirectional = True)

# 현재 시점의 입력을 처리하고 나온 출력값, cell의 내부 상태
outputs, _status = cell(inputs)

# 첫번째 리턴값 : 은닉층 상태 크기 출력
print(outputs.shape) # (배치 크기, 시퀀스 길이, 은닉 상태의 크기 x 2)
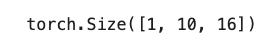
출력시 배치크기는 1이고, 시퀀스 단위는 10이며 16개의 은닉층의 상태가 마지막 출력 된다.
(첫번째 리턴값)양방향 은닉 상태 값들이 연결
print(_status.shape) # (층의 개수 x 2, 배치 크기, 은닉 상태의 크기)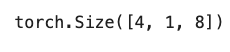
두번째 리턴값의 크기는 층의개수가 2배가 된 크기이며, 정방향 기준으로 마지막 시점에 해당되는 결과 값이다.