1️⃣ ViT (Vision Transformer)
1. Transformer
- Transformer는 입력 전체를 한 번에 처리하며, self-attention 메커니즘을 통해 문맥을 효과적으로 이해하는 모델입니다.
- RNN처럼 순차적으로 처리하지 않고 병렬 처리가 가능해 학습 속도와 성능이 뛰어납니다.
- 대표 구조는 인코더-디코더이며, 번역, 요약, 질문 응답 등 다양한 자연어 처리 작업에 활용됩니다.
2. Vision Transformer
- **ViT(Vision Transformer)**는 이미지를 작은 패치로 나눈 뒤 Transformer에 입력해 전체 이미지를 global하게 처리하는 모델입니다.
- CNN과 달리 self-attention을 사용해 멀리 떨어진 이미지 영역 간의 관계까지 파악할 수 있습니다.
- 큰 데이터셋에서는 CNN보다 뛰어난 성능을 보이며, 다양한 비전 작업으로 확장되고 있습니다.
3. Self-Attention
- Self-attention은 입력 안의 각 요소가 서로를 참고하며 중요도를 계산하는 메커니즘입니다.
- 이를 통해 문장이나 이미지 내에서 멀리 떨어진 정보 간 관계도 효과적으로 파악할 수 있습니다.
- Transformer의 핵심 구성 요소로, 병렬처리와 문맥 이해를 모두 가능하게 합니다.
⭐ 정리하자면:
Transformer의 핵심이 self attention이지? 그래서 Vision Transformer에서도 CNN과 달리 self-attn을 사용해 멀리 떨어진 이미지 영역 간의 관계까지 파악할 수 있는 거고. => 🙆🏼맞아요🙆🏼👏
- Transformer의 핵심은 self-attention이고, 이 구조 덕분에 입력의 각 요소(단어, 패치 등)가 서로를 참고하며 전역적인 문맥을 이해할 수 있어요.
- 그래서 **Vision Transformer(ViT)**는 CNN처럼 지역적인 필터를 쓰지 않고, 이미지 패치 간의 전역 관계를 self-attention으로 파악할 수 있는 거예요.
- 이 덕분에 ViT는 이미지의 전체 구조나 먼 거리 패턴을 한눈에 보듯 학습할 수 있는 강점을 갖고 있죠.
2️⃣ CNN
CNN의 주요 단계
-
Convolution(합성곱)
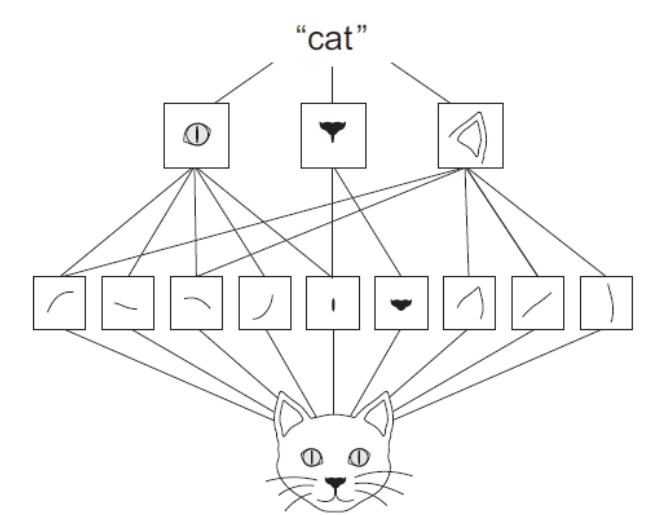
- 이미지에 필터(커널)를 적용해 특징(엣지, 패턴 등)을 추출하는 단계예요.
- 여러 개의 필터가 다양한 특징을 학습하게 돼요.
-
ReLU (활성화 함수)
- 비선형성을 부여해서 모델이 복잡한 패턴을 학습할 수 있도록 도와줘요.
- 보통
ReLU(x) = max(0, x)형태로 쓰여요.
-
Pooling (풀링)
- 이미지 크기를 줄이고 계산량을 줄이면서 중요한 특징만 남겨요.
- 대표적으로 Max Pooling이 자주 쓰여요.
-
Fully Connected Layer (완전 연결층)
- 추출된 특징을 바탕으로 최종 분류를 수행하는 단계예요.
- Flatten 후 일반적인 MLP 구조로 이어져요.
요약하면:
합성곱 → 비선형 변환(ReLU) → 풀링 → 분류(FC Layer) 흐름으로, 점점 추상적인(=고수준의) 특징을 추출하며 분류까지 이어지는 구조예요. (저수준 -> 고수준)