LLM training 기본기
일반적으로 LLM의 훈련은 두 단계를 거친다.
pre-training -> post-training
- pre-training
- pretraining 이란 대량의 텍스트 데이터를 통해서 next-token prediction 를 하는 것이다. 이 단계는 LLM 모델에게 일반적인 지식들을 주기 위해서 이루어진다.
- 이 과정에서 단순히 다음 단어 예측만 시켰는데, few-shot 만으로 여러 과제를 파라미터 업데이트 없이 수행할 수 있게 된다. (ICL)
- 이때 방법은 SSL (self-supervised learning)이다 (별도의 라벨링이 필요 없으므로)
- post-training
- 단순히 pre-trianing만 한다면 llm이 사용자의 지시를 일관되게 따르게 하기 어렵다. 따라서 특수한 목적에 맞게 수행하기 위해 하는 것이 post-training이다.
- 학습은 sft, rl 등 다양하게 한다.
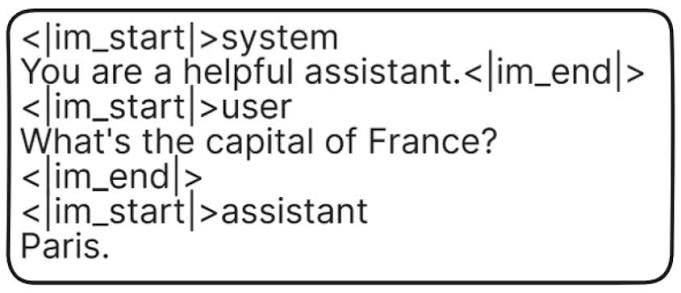
- 예를 들어, 대화 능력을 가르치고 싶다고 하자. 그 중 한 가지 방법으로 대화 형식 데이터를 활용해서 sft를 할 수 있다. 모델마다 형식이 다른데 아래는 ChatML 형식이다.
Attention
- 비슷한 단어들에 가중치를 두어 계산, softmax scaling (분산 1에 맞춤)
Transformer
- 추론 시 인코딩 캐시
- attention을 거칠수록 다른 의미의 동음이의어가 의미 벡터가 정해짐 (orange 예시)
강화학습
GRPO
- 답변 하나하나를 같은 총가중치로 취급
- 토큰 평균을 낸 후 답변 평균
DAPO
- 생성 토큰 하나하나를 같은 집계 가중치로 취급. 따라서 긴 답변의 전체 비중은 커짐.
- loss 계산 시 토큰 총 수로 평균
