1. 자료구조의 개념 + 알고리즘과의 연관성
1️⃣ 자료구조란?
자료구조(Data Structure)는 데이터를 효율적으로 저장, 관리, 검색하기 위한 방법.
데이터를 단순히 모아두는 것이 아니라, 문제 해결에 적합한 방식으로 조직화하는 과정이다.
왜 자료구조가 중요한가?
- 데이터가 많아질수록 단순한 구조로는 한계가 생긴다.
- 예를 들어 100개의 데이터를 찾는 것과 1억 개 중에서 찾는 것은 효율성 차이가 극명하다.
- 자료구조를 잘 선택해야 메모리 낭비를 줄이고, 연산 속도를 최적화할 수 있다.
2️⃣ 알고리즘(Algorithm)과의 관계
- 알고리즘: 문제 해결을 위한 단계적 절차.
- 자료구조: 알고리즘이 데이터를 다루는 무대.
같은 알고리즘이라도 어떤 자료구조 위에서 동작하는가에 따라 성능이 달라진다.
예시) 탐색 문제
- 배열에서 선형 탐색 →
O(n) - 정렬된 배열에서 이진 탐색 →
O(log n) - 해시테이블 탐색 → 평균
O(1)
3️⃣ 시간 복잡도 (Time Complexity)
시간 복잡도는 알고리즘 실행 시간이 입력 크기 n에 따라 어떻게 변하는지를 나타냄.
- 빅오(Big-O) 표기법으로 분석한다.
✅ 주요 시간 복잡도
- O(1) : 상수 시간 (해시테이블 접근)
- O(log n) : 로그 시간 (이진 탐색, 균형 트리 탐색)
- O(n) : 선형 시간 (배열 전체 탐색)
- O(n log n) : 효율적 정렬 (퀵/병합/힙 정렬)
- O(n²) : 단순 정렬 (버블, 삽입, 선택)
// 예: 선형 탐색 (O(n))
public int linearSearch(int[] arr, int target) {
    for (int i = 0; i < arr.length; i++) {
        if (arr[i] == target) {
            return i;
        }
    }
    return -1; // 찾지 못함
}

// 예: 이진 탐색 (O(log n)) -> 배열이 정렬되어 있어야 함
public int binarySearch(int[] arr, int target) {
    int left = 0, right = arr.length - 1;
    while (left <= right) {
        int mid = (left + right) / 2;
        if (arr[mid] == target) return mid;
        else if (arr[mid] < target) left = mid + 1;
        else right = mid - 1;
    }
    return -1;
}
2. 자료형에 따른 분류

자료구조는 크게
기본 자료구조(Primitive Data Structure)
비기본 자료구조(Non-Primitive Data Structure)
로 나눌 수 있다.
🔹 Primitive Data Structure (기본 자료구조)
프로그래밍 언어에서 제공하는 가장 기본적인 단위 자료형으로, 더 이상 쪼갤 수 없는 기본 블록이다.
-
Integer (정수형)
- 수학에서의 정수에 해당하지만, 컴퓨터에서는 메모리 크기에 따라 표현할 수 있는 범위가 제한된다.
- 예:
int,long
-
Float (실수형)
- 수학에서의 실수 개념과 유사하나, 컴퓨터는 유한한 비트 수로 소수를 표현하기 때문에 근사값만 저장할 수 있다.
- 예:
float,double
-
Character (문자형)
- 하나의 문자 또는 기호를 저장. 공백 문자(띄어쓰기, tab, enter 등)도 포함된다.
- 예:
'a','Z',' '
-
Pointer (포인터)
- 실제 데이터 값 대신 메모리 주소를 저장하는 특수한 자료형.
- 포인터를 이용해 메모리에 접근하거나 동적 메모리 관리가 가능하다.
👀 꿀팁 For 코테
| 자료형 | 크기 | 최소값 | 최대값 | 비고 |
|---|---|---|---|---|
| byte | 8 bit | -128 | 127 | (2⁸, 부호 있는 정수) |
| short | 16 bit | -32,768 | 32,767 | (2¹⁶) |
| int | 32 bit | -2,147,483,648 (-2³¹) | 2,147,483,647 (2³¹-1) | 알고리즘 기본 정수형 |
| long | 64 bit | -9,223,372,036,854,775,808 (-2⁶³) | 9,223,372,036,854,775,807 (2⁶³-1) | 큰 수 계산 시 사용 |
| float | 32 bit | 약 ±3.4 × 10³⁸ | 소수 7자리 정확도 | 부동소수점 (단정밀도) |
| double | 64 bit | 약 ±1.8 × 10³⁰⁸ | 소수 15~16자리 정확도 | 부동소수점 (배정밀도) |
| char | 16 bit | 0 | 65,535 | 유니코드 문자 표현 |
| boolean | 1 bit (표준 미정, JVM 구현 의존) | true / false | - | 메모리 크기는 명확히 정의X |
- short는 32 다음 쉼표( , ) 1개
- int는 2 다음 쉼표( , ) 3개
- long은 9 다음 쉼표( , ) 6개
- float / double은 각각 소수 7 / 15 자리
🔹 Non-Primitive Data Structure (비기본 자료구조)
기본 자료구조를 응용하여 만든 복합 자료구조. 데이터의 크기와 구조를 유연하게 다룰 수 있다.
-
Arrays (배열)
-
Lists (리스트)
-
Files (파일)
-
Linear (선형 구조)
- 데이터가 일렬로 나열되는 구조.
- 예: 스택(Stack), 큐(Queue), 배열(Array), 연결 리스트(Linked List)
-
Non-Linear (비선형 구조)
- 데이터가 계층적, 망 형태로 연결되는 구조.
- 예: 트리(Tree), 그래프(Graph)
3. 비기본 자료구조 7개 ⭐️⭐️⭐️
☝🏻 선형 자료구조
데이터가 일렬로 나열되는 구조.
1️⃣ 배열(Array)
- 메모리에 연속적으로 저장.
- 인덱스를 통해 임의 접근 가능 →
O(1). - 삽입/삭제는 전체 이동 필요 →
O(n).
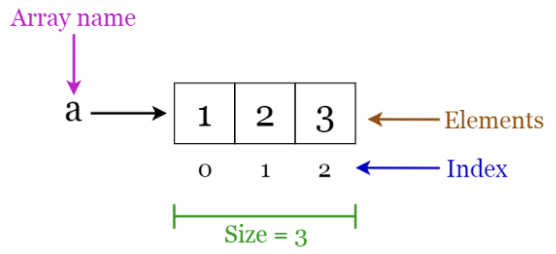
int[] arr = {10, 20, 30};
System.out.println(arr[1]); // O(1) 접근
→ 배열 목록, 힙, 해시 테이블, 벡터 및 행렬과 같은 기타 데이터 구조를 구축하기 위한 빌딩 블록으로 사용
→ 삽입 정렬, 빠른 정렬, 버블 정렬 및 병합 정렬과 같은 다양한 정렬 알고리즘에 사용
2️⃣ 연결 리스트(Linked List)
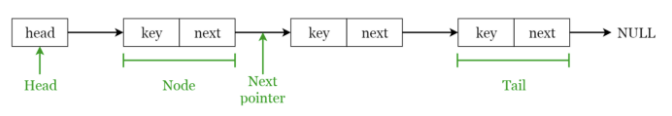
- 노드(Node) 단위로 데이터와 포인터(다음 노드 주소)를 저장. "순차적"
- 동적인 데이터 삽입/삭제 빠름 →
O(1)(포인터만 수정). - 임의 접근 불가 →
O(n).
class Node {
    int data;
    Node next;
    Node(int data) { this.data = data; }
}

public class Main {
    public static void main(String[] args) {
        Node n1 = new Node(10);
        Node n2 = new Node(20);
        Node n3 = new Node(30);

        n1.next = n2;
        n2.next = n3;

        System.out.println(n1.data);       // 10
        System.out.println(n1.next.data);  // 20
        System.out.println(n2.next.data);  // 30
    }
}- 각 요소는 Node
- 각 Node에는 key와 다음 노드를 가리키는 포인터인 next가 포함
- 첫 번째 요소는 Head
- 마지막 요소는 Tail
종류:
- 단일 연결 리스트(Singly Linked List)
- 이중 연결 리스트(Doubly Linked List)
- 원형 연결 리스트(Circular Linked List) ...
🧐 배열과 연결 리스트는 아래의 자료 구조들을 구현하는 데 사용되는 기본 자료 구조 ⬇️⬇️⬇️
3️⃣ 스택(Stack)
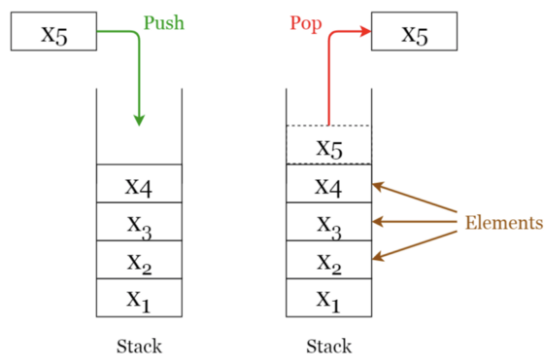
- LIFO (후입선출) (Last In First Out).
- 연산:
push(),pop(). - 활용: 함수 호출 스택(재귀 프로그래밍), 실행취소(Undo), 괄호 검사.
Stack<Integer> stack = new Stack<>();
stack.push(10);
stack.push(20);
System.out.println(stack.pop()); // 20
4️⃣ 큐(Queue)
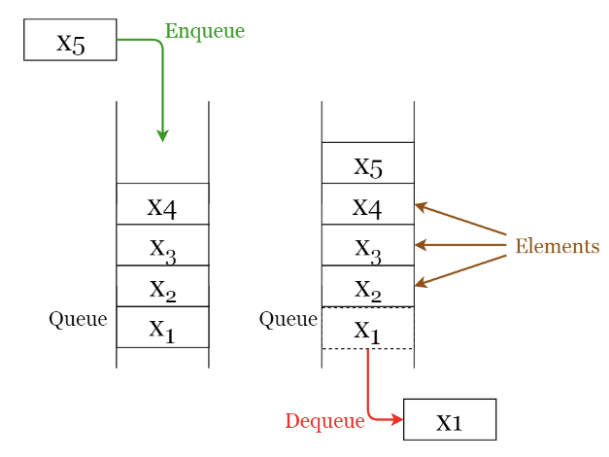
- FIFO (선입선출) (First In First Out).
- 활용: 작업 대기열 시스템, 운영체제 스케줄링, 멀티스레딩 스레드관리.
- 변형: 원형 큐, Deque(양방향 큐), 우선순위 큐.
Queue<Integer> queue = new LinkedList<>();
queue.add(1);
queue.add(2);
System.out.println(queue.poll()); // 1
✌🏻 비선형 자료구조
데이터가 계층적 또는 네트워크 구조를 이루는 형태.
5️⃣ 트리(Tree)
-
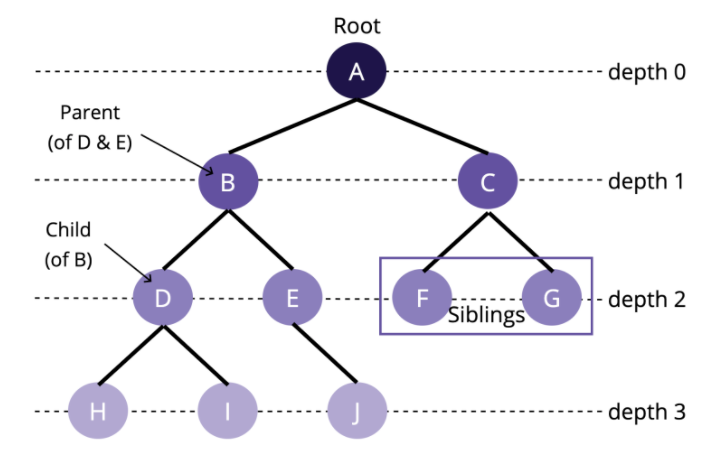
루트(root)에서 시작해 자식(child) 노드로 확장되는 구조.
- 최상위 노드(루트)를 가지고 있음
- 상위 노드를 부모(parent) 노드, 하위 노드를 자식(child) 노드라 한다.
-
계층적 관계를 표현.
→ Binary Trees(이진트리)
→ Binary Search Tree(이진 검색 트리)
→ Heap(힙) ...
6️⃣ 그래프(Graph)
- 정점(Vertex)과 간선(Edge)으로 구성.
- nodes/vertices(노드/정점) 사이에 edge(엣지)가 있는 collection
- 네트워크, SNS 친구 관계, GPS 최단 경로 탐색 등에 활용.
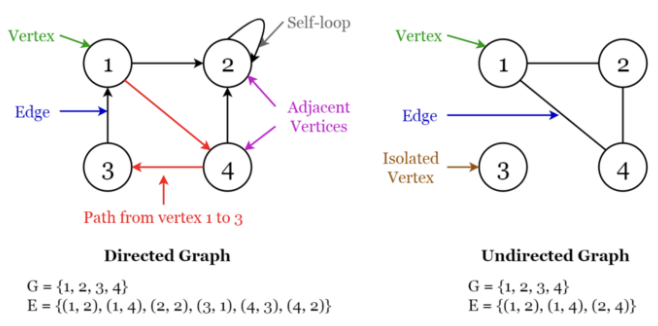
- directed(방향) 그래프는 일방통행
- undirected(무방향) 그래프는 양방향
🤞🏻 탐색(Search) 자료구조
지금까지는 ,,
-
선형 자료구조 (Linear)
데이터가 일렬로 저장 → 배열, 연결리스트, 스택, 큐 -
비선형 자료구조 (Non-linear)
데이터가 계층적/망 형태 → 트리, 그래프
해시테이블 : 해시 함수로 인덱스를 계산해 저장하는 자료구조
→ 데이터가 배열처럼 일렬로 저장되긴 하지만, 내부적으로 해시 함수를 통한 매핑에 의존
→ 충돌 처리 시 연결리스트나 트리 같은 다른 자료구조를 함께 사용.
전통적인 Linear / Non-linear 분류에는 딱 들어가지 않음.
해시테이블은 배열과 유사하게 연속적인 메모리 공간을 기반으로 하지만, 해시 함수와 충돌 처리 방식(체이닝, 개방 주소법 등)을 사용하기 때문에 전통적인 선형/비선형 자료구조 분류에는 속하지 않는다.
대신 탐색(Search) 자료구조 또는 매핑(Map) 자료구조로 따로 분류하는 것이 일반적이다.
7️⃣ Hash table(해시 테이블)
-
해시함수를 사용하여 변환한 값을 색인(index)으로 삼기
→ 키(key)와 데이터(value)를 저장 -
데이터의 크기에 관계없이 삽입 및 검색에 매우 효율적
→ 데이터베이스 인덱스 구현
→ 사용자 로그인 인증
→ "set" 데이터 구조 구현
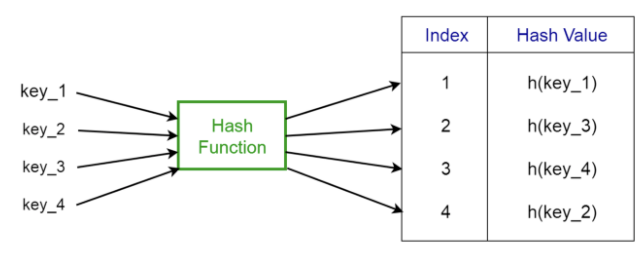
보통 테이블 내에 더 작은 서브그룹인 버킷(bucket)에 키/값(key/value) 쌍(pair)을 저장
❗️❗️ 해시값 충돌이 자주 일어날 수 있음
→ 해시 충돌 개선 :
다양한 방법으로 해시 함수를 개선 Or 해시 테이블의 구조 개선(chaining, open addressing 등)의 방법이 사용.
3. 해시테이블, 해시 충돌
✏️ 개념
1. 해싱
-
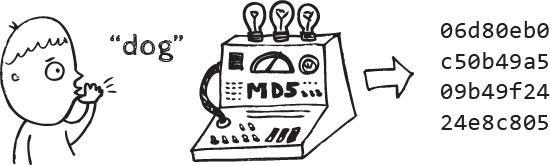
임의의 길이의 값을 해시함수(Hash Function)를 사용하여 고정된 크기의 값으로 변환하는 작업
-
암호화에 쓰이는 해시 알고리즘 사용하여 변환 (ex. MD5)
-
여기서는 암호화에 쓰인 방식이 아닌, 자료구조로 사용하고자 하는 해시 테이블을 다루기 때문에 정수값으로 변환되는 해시 알고리즘 사용
2. 해시 테이블
- 해싱을 사용하여 데이터를 저장하는 자료구조 : 해시 테이블
- 해시함수를 사용하여 변환한 값을 색인(index)으로 삼아 키(key)와 데이터(value)를 저장하는 자료구조
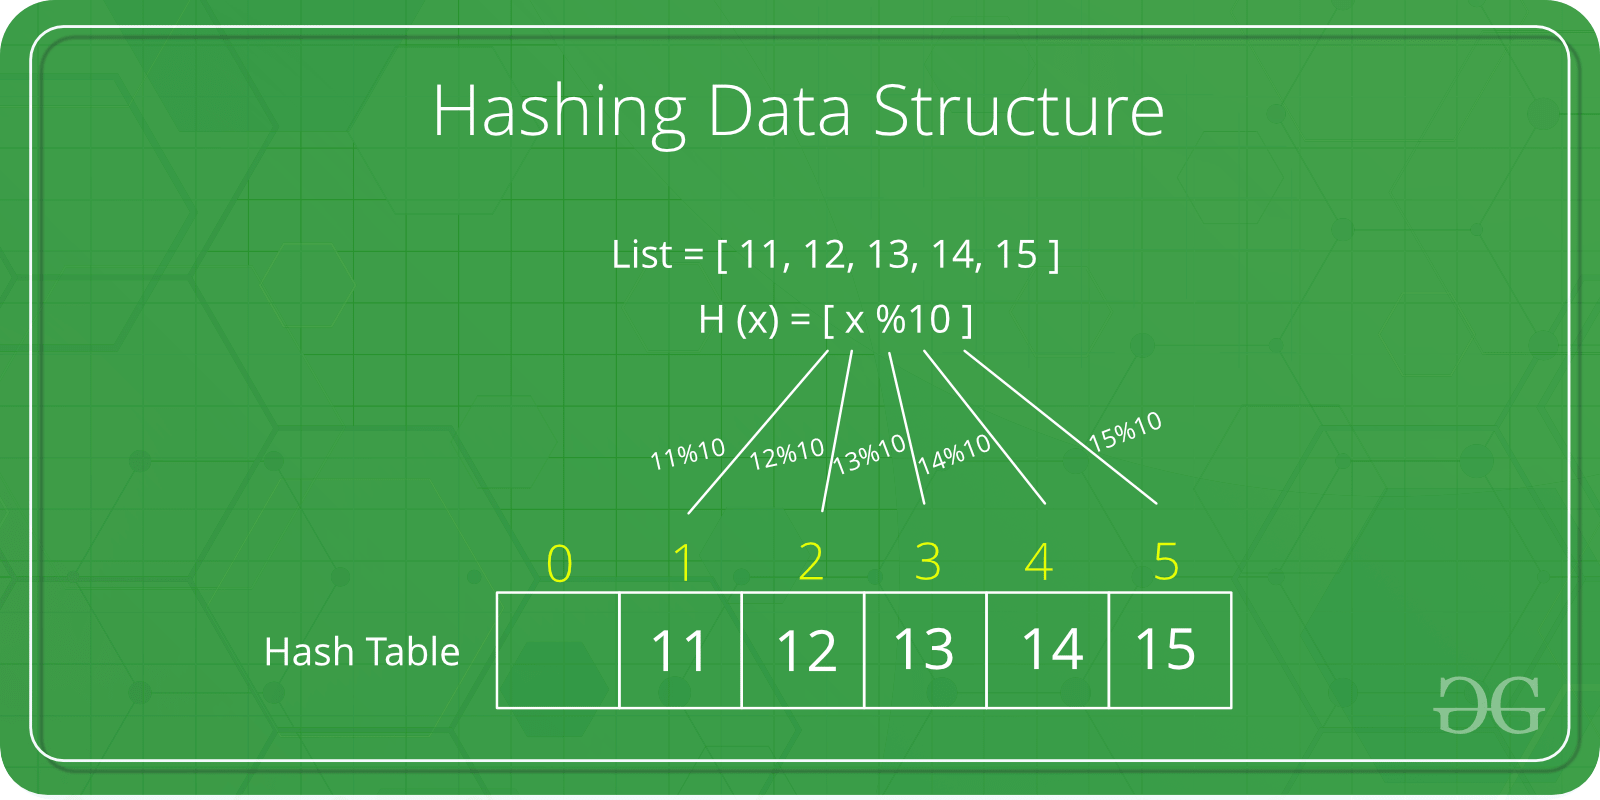
-
Key → 해시 함수 → 인덱스 → Value 저장
-
기본연산 : 탐색(Search), 삽입(Insert), 삭제(Delete)
-
평균 탐색/삽입/삭제 시간:
O(1)- 기존 자료구조인 이진탐색트리나 배열에 비해서 굉장히 빠른 속도
💥 해시 충돌 (Collision)
서로 다른 키가 동일한 해시 값을 가질 때 발생.
❓ 왜 일어나는가 ?
-
적재율(Load Factor) 의 이해
적재율이란 해시 테이블의 크기 대비, 키의 개수를 말함.
즉, 키의 개수를 K, 해시 테이블의 크기를 N 이라고 했을 때 적재율은 K / N.
Direct Address Table은 키 값을 인덱스로 사용하는 구조이기 때문에 적재율이 1 이하이며 적재율이 1 초과인 해시 테이블의 경우는 반드시 충돌이 발생하게 됨. -
충돌이 발생할 경우와, 그렇지 않을 경우
만약, 충돌이 발생하지 않다고 할 경우 해시 테이블의 탐색, 삽입, 삭제 연산은 모두 O(1) 에 수행.
but, 충돌이 발생할 경우 탐색과 삭제 연산이 최악의 O(K) 만큼 걸리게 됨.
이는 같은 인덱스에 모든 키 값과 데이터가 저장된 경우로 충돌이 전부 발생했음을 말함.
따라서, 충돌을 최대한으로 줄여서 연산속도를 빠르게 하는 것이 해시 테이블의 핵심
→ 이에 중요하게 작용하는 것이 바로 해시함수를 구현하는 해시 알고리즘.
해시 알고리즘이 견고하지 못하게 되면 해시함수로 도출된 값들이 같은 경우가 빈번하게 발생하게 되므로 잦은 충돌로 이어지게 됨.
💪🏻 충돌 해결 기법
1️⃣ 테이블 구조 개선
-
체이닝(Chaining) : 테이블 구조 개선
- 각 인덱스에 연결 리스트를 두어 충돌 데이터를 저장.
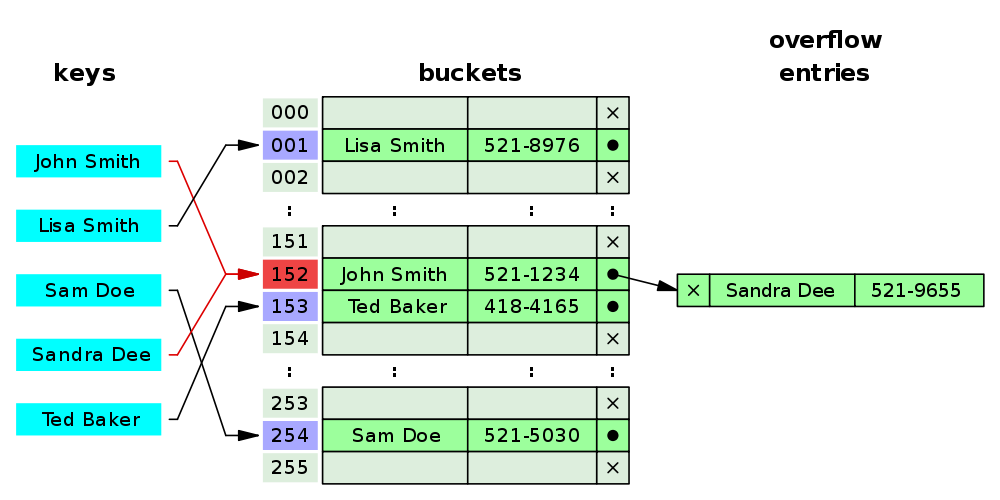
-
개방 주소법(Open Addressing) : 테이블 구조 개선
- 빈 슬롯을 탐사하며 저장.
- 원래라면 해시함수로 얻은 해시값에 따라서 데이터와 키값을 저장하지만 동일한 주소에 다른 데이터가 있을 경우 다른 주소도 이용할 수 있게 하는 기법
- 선형 탐사
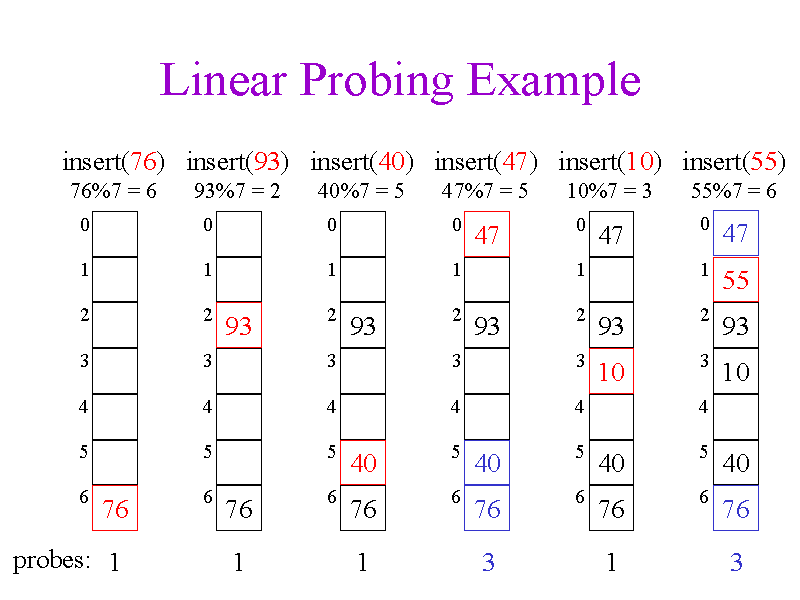
- 제곱 탐사
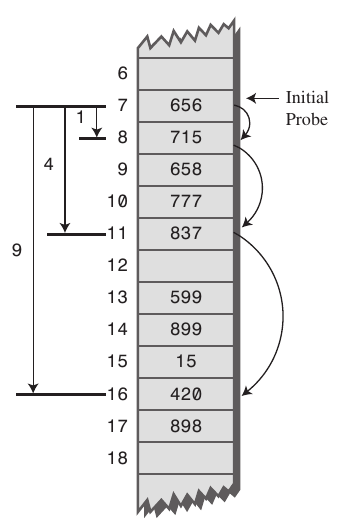
- 이중 해싱
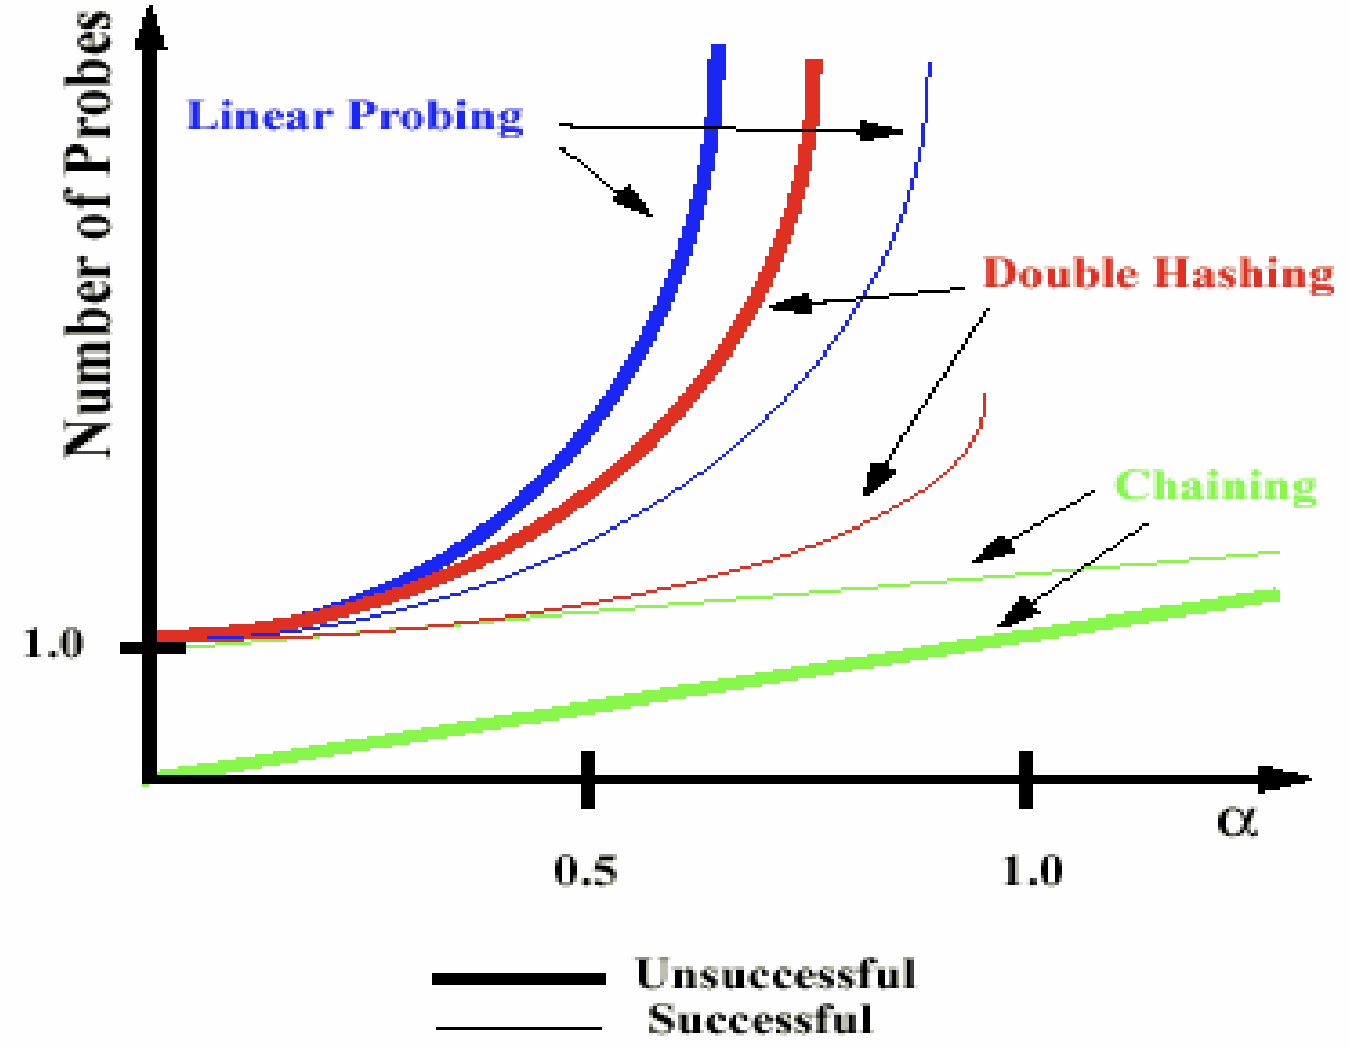
- 빈 슬롯을 탐사하며 저장.
-
재해싱(Rehashing)
- 테이블 크기를 늘려 다시 해싱.
Map<String, String> map = new HashMap<>();
map.put("apple", "사과");
map.put("banana", "바나나");
System.out.println(map.get("apple")); // 사과
2️⃣ 해시 함수 개선
- 나눗셈법(Division Method)
- 아주 간단하게 해시값을 구하는 방법으로 미리 해시 테이블의 크기인 N 을 아는 경우에 사용
해시함수를 적용하고자 하는 값을 N 으로 나눈 나머지를 해시값으로 사용하는 방법
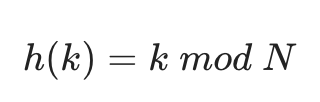
- 곱셈법(Multiplication Method)
- kA mod 1 의 의미는 kA 의 소수점 이하 부분을 말하며 이를 N 에 곱하므로 0부터 N 사이의 값이 됨
이 방법의 장점은 N 이 어떤 값이더라도 잘 동작한다는 것이며 A 를 잘 잡는 것이 중요
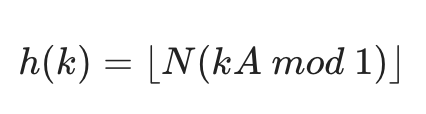
4. 트리 (Tree) 응용
📌 기본 개념
- 그래프의 특수한 형태(사이클 없는 연결 구조).
- 용어: 루트(root), 리프(leaf), 깊이(depth), 높이(height) 로 표현
📌 주요 트리 종류
-
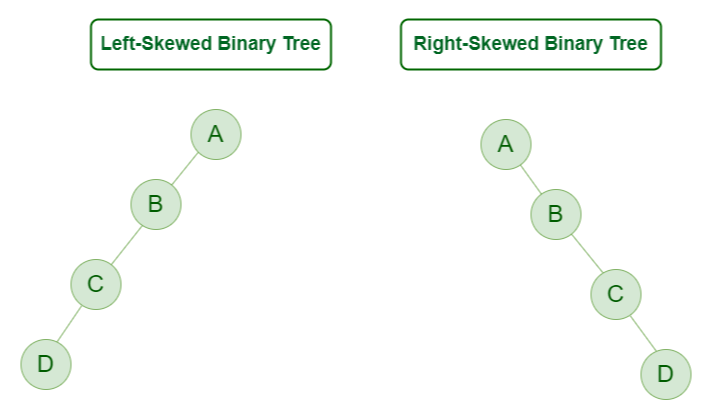
편향 트리 (Skew Tree)
- 트리가 각 레벨에 대해 최소 개수의 노드를 가지면서, 하나의 자식 노드만을 가지는 트리
-
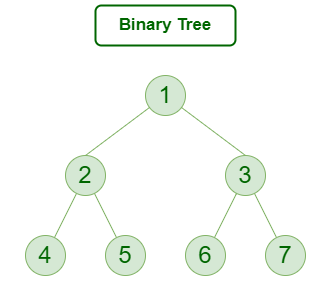
이진 트리(Binary Tree) ⭐️⭐️⭐️
-
모든 노드의 자식 ≤ 2.
- 각 노드가 자식 노드를 최대 2개까지 가질 수 있는 트리
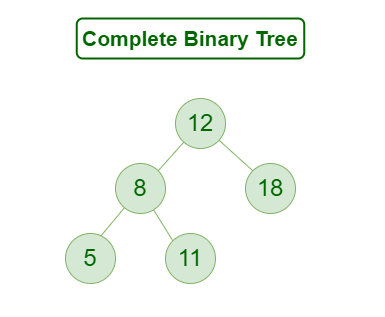
2-1. 완전 이진 트리 (Complete Binary Tree)
-
각 레벨의 왼쪽에서 오른쪽으로 빈 공간 없이 노드가 채워진 이진 트리
(마지막 레벨을 제외하고 모든 레벨의 노드가 채워져 있다.)
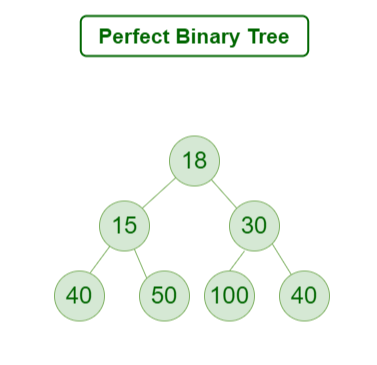
2-2. 포화 이진 트리 (Perfect Binary Tree)
-
모든 레벨의 노드가 포화 상태로 차있는 이진 트리
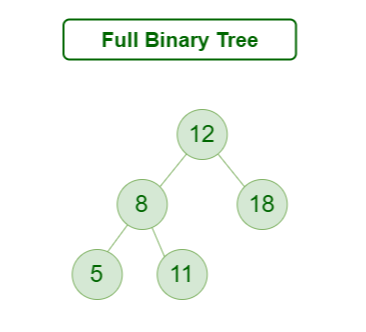
2-3. 전 이진 트리 (Full Binary Tree)
- 모든 노드가 0개 또는 2개의 자식 노드를 갖는 이진 트리
- 이진 탐색 트리(BST) ⭐️⭐️⭐️
- 효율적인 탐색을 위해 각 노드의 왼쪽 서브 트리에는 노드보다 작은 값만, 오른쪽 서브 트리에는 노드보다 큰 값만 포함되도록 구성하는 이진 트리
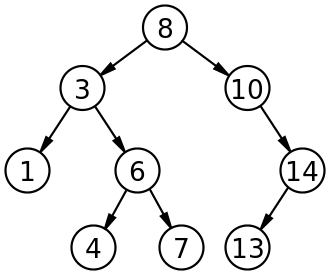
- 중복된 노드를 포함하지 않는다.
- 트리 순회 시 중위 순회 방식 : 왼쪽 < 부모 < 오른쪽 규칙
- 평균 O(log n), 최악 O(n)
-
AVL 트리 / Red-Black 트리
- 균형을 유지하는 트리.
-
힙(Heap) ⭐️⭐️⭐️
- 완전 이진 트리 기반
- 우선순위 큐 구현, 힙 정렬 알고리즘 에 사용.
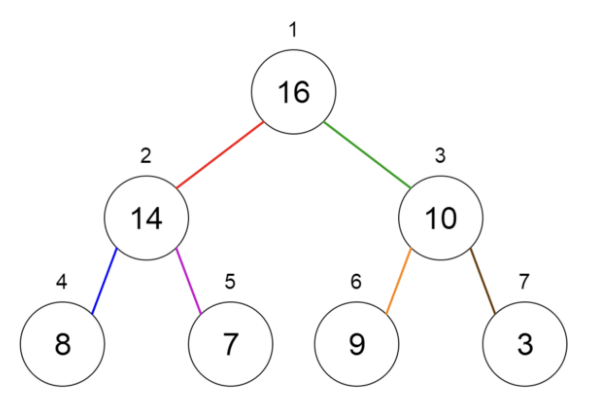
- 최소 힙 : 부모의 키 값이 자식의 키 값보다 작거나 같다.
루트 노드의 키 값이 트리의 최솟값 - 최대 힙: 부모의 키 값이 자식의 키 값보다 크거나 같다.
루트 노드의 키 값이 트리의 최댓값
-
트라이(Trie)
- 문자열 검색 최적화.
- 검색 알고리즘
-
B-트리 / B+트리
- 데이터베이스 인덱스 구조.
- 파일 시스템
📌 트리 응용
- 검색 및 정렬: BST, AVL, Red-Black Tree
- 우선순위 관리: 힙 → 우선순위 큐
- 문자열 검색: Trie (자동완성, 사전)
- DB 인덱스: B-트리, B+트리
- 컴파일러 파싱: 구문 트리
- 네트워크 라우팅: 트리 기반 경로 탐색
// 간단한 이진 탐색 트리 삽입
class Node {
    int key;
    Node left, right;
    Node(int key) { this.key = key; }
}

class BST {
    Node root;

    void insert(int key) {
        root = insertRec(root, key);
    }

    Node insertRec(Node root, int key) {
        if (root == null) return new Node(key);
        if (key < root.key) root.left = insertRec(root.left, key);
        else if (key > root.key) root.right = insertRec(root.right, key);
        return root;
    }
}
정리표 ...
| 자료구조 | 구조적 특징 | 장점 | 단점 | 대표적인 활용 |
|---|---|---|---|---|
| 배열(Array) | 메모리 연속 저장, 인덱스로 접근 | 접근 속도 빠름(O(1)) | 삽입/삭제 느림(O(n)), 크기 고정 | 인덱스 기반 탐색, 정렬 |
| 연결 리스트(Linked List) | 노드 + 포인터로 연결 | 삽입/삭제 빠름 | 임의 접근 불가(O(n)) | 동적 메모리, 큐/스택 구현 |
| 스택(Stack) | LIFO (후입선출) | 구현 간단, 함수 호출 관리 | 중간 요소 접근 불가 | 함수 호출 스택, Undo 기능 |
| 큐(Queue) | FIFO (선입선출) | 처리 순서 보장 | 중간 요소 접근 불가 | 작업 대기열, 스케줄링 |
| 해시 테이블(Hash Table) | Key → 해시 함수 → Index | 평균 O(1) 탐색 | 해시 충돌, 메모리 낭비 가능 | DB 인덱스, 캐시 |
| 트리(Tree) | 계층적 구조 | 빠른 탐색/정렬, 구조적 표현 | 불균형 시 성능 저하 | 파일 시스템, DB 인덱스 |
| 그래프(Graph) | 정점과 간선 | 복잡한 관계 표현 | 구현/탐색 복잡 | SNS 관계망, 최단 경로 |
| 연산 / 자료구조 | 배열(Array) | 연결 리스트(Linked List) | 스택/큐(Stack/Queue) | 해시 테이블(Hash Table) | 이진 탐색 트리(BST) | 균형 트리(AVL, Red-Black) |
|---|---|---|---|---|---|---|
| 접근(Access) | O(1) | O(n) | O(n) (탐색 시) | 평균 O(1) / 최악 O(n) | O(log n) ~ O(n) | O(log n) |
| 탐색(Search) | O(n) | O(n) | O(n) | 평균 O(1) / 최악 O(n) | O(log n) ~ O(n) | O(log n) |
| 삽입(Insert) | O(n) | O(1) | O(1) | 평균 O(1) / 최악 O(n) | O(log n) ~ O(n) | O(log n) |
| 삭제(Delete) | O(n) | O(1) | O(1) | 평균 O(1) / 최악 O(n) | O(log n) ~ O(n) | O(log n) |
