이 게시물은 2025-2026 성공회대학교 GDGoC Backend 스터디 세션을 위해 작성되었습니다.
배열과 같이 여러 데이터(자료)를 구조화해서 다루는 것을 자료구조라 한다.
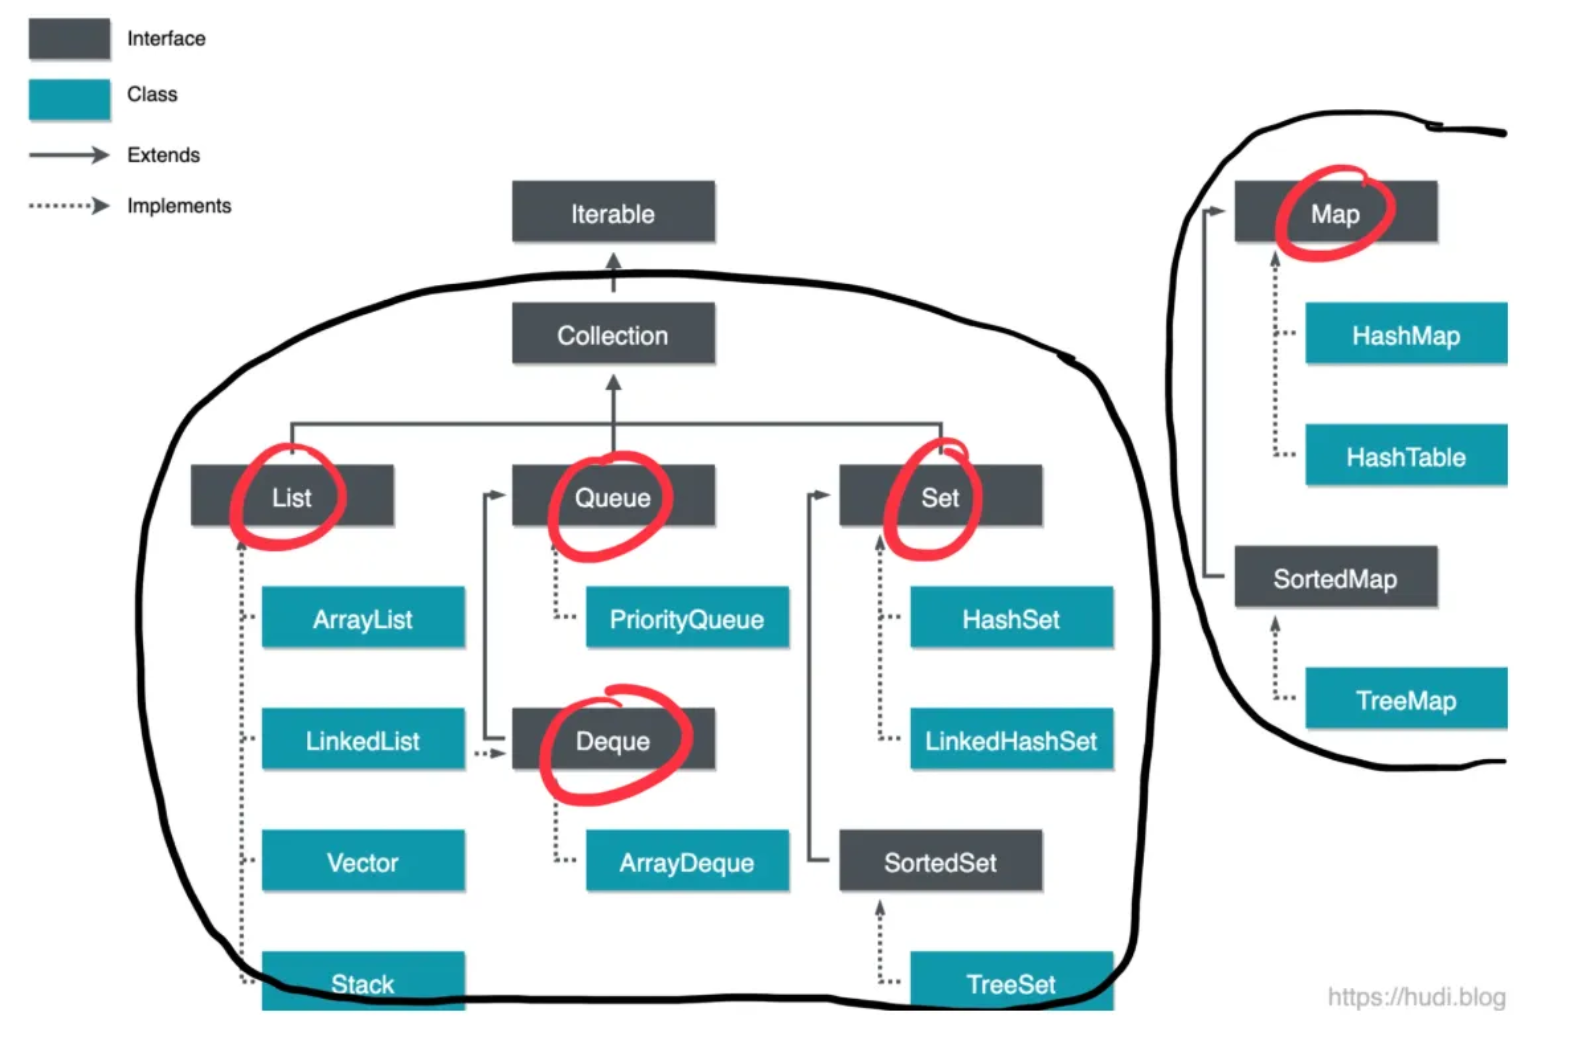
자바는 배열 뿐만 아니라, 컬렉션 프레임워크라는 이름으로 다양한 자료구조를 제공한다.
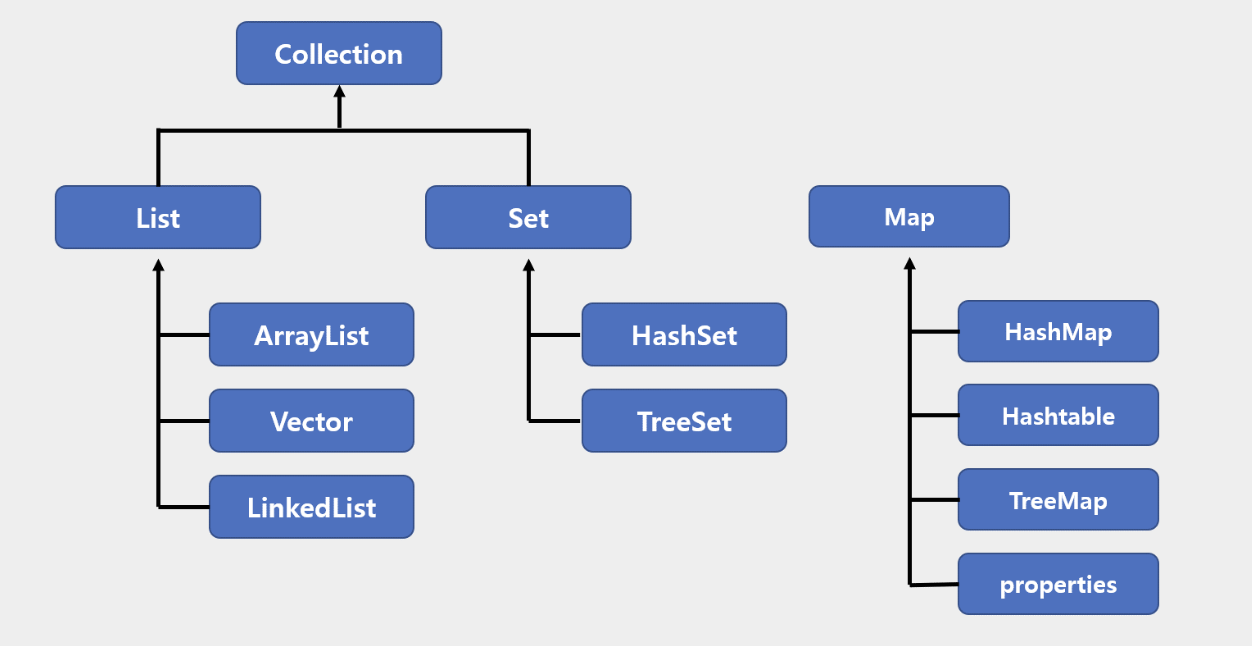
컬렉션 프레임워크는 크게 3개로 나눌 수 있다. 하나씩 살펴보자.
List 자료구조
순서가 있고, 중복을 허용하고, 크기가 가변적인 자료구조
리스트는 배열과 매우 유사하다.
아주 예전엔 리스트가 없었고 배열을 사용했으나 불편한 점이 많았다.
배열 자료구조
배열
순서가 있고, 중복을 허용하고, 크기가 고정된 자료구조
배열은 같은 종류의 데이터를 여러 개 저장하기 위해 도입된 자료구조이다.
배열의 한계
배열은 아주 오래된 기본 자료구조라서 여러가지 문제가 있다.
- 배열은 크기가 고정되어 있다.
int[] arr = new int[3];
arr[0] = 10;
arr[1] = 20;
arr[2] = 30;
arr[3] = 40; // ArrayIndexOutOfBoundsException 발생- 배열은 데이터의 삽입과 삭제가 불편하다.
삽입시 내가 넣으려는 인덱스가 이미 요소가 있기 때문에 요소를 한칸씩 뒤로 밀고, 그렇게 만든 빈 자리에 새 요소를 삽입해야 한다.
int[] arr = {10, 0, 30};
arr[2] = arr[1]; // 20을 삽입하기 위해 원소를 뒤로 민다 -> [10, 0, 0]
arr[1] = 20; // 중간에 삽입 -> [10, 20, 0]삭제시 내가 삭제할 인덱스 뒤의 요소들을 모두 앞으로 한 칸씩 당겨야 한다.
int[] arr = {10, 20, 30};

arr[1] = arr[2]; // 20을 지우기 위해 원소를 당긴다 -> [10, 30, 30]
List
- 크기가 가변적이다.
ArrayList<Integer> list = new ArrayList<>();

// 데이터 추가 -> [10, 20, 30]
list.add(10);
list.add(20);
list.add(30);
list.add(40);
list.add(50);- 데이터의 삽입과 삭제가 편리하다.
// 0번 인덱스의 10 삭제 -> [20, 30]
list.remove(0);

// 중간인 1번 인덱스에 50 삽입 -> [20, 50, 30]
list.add(1,50);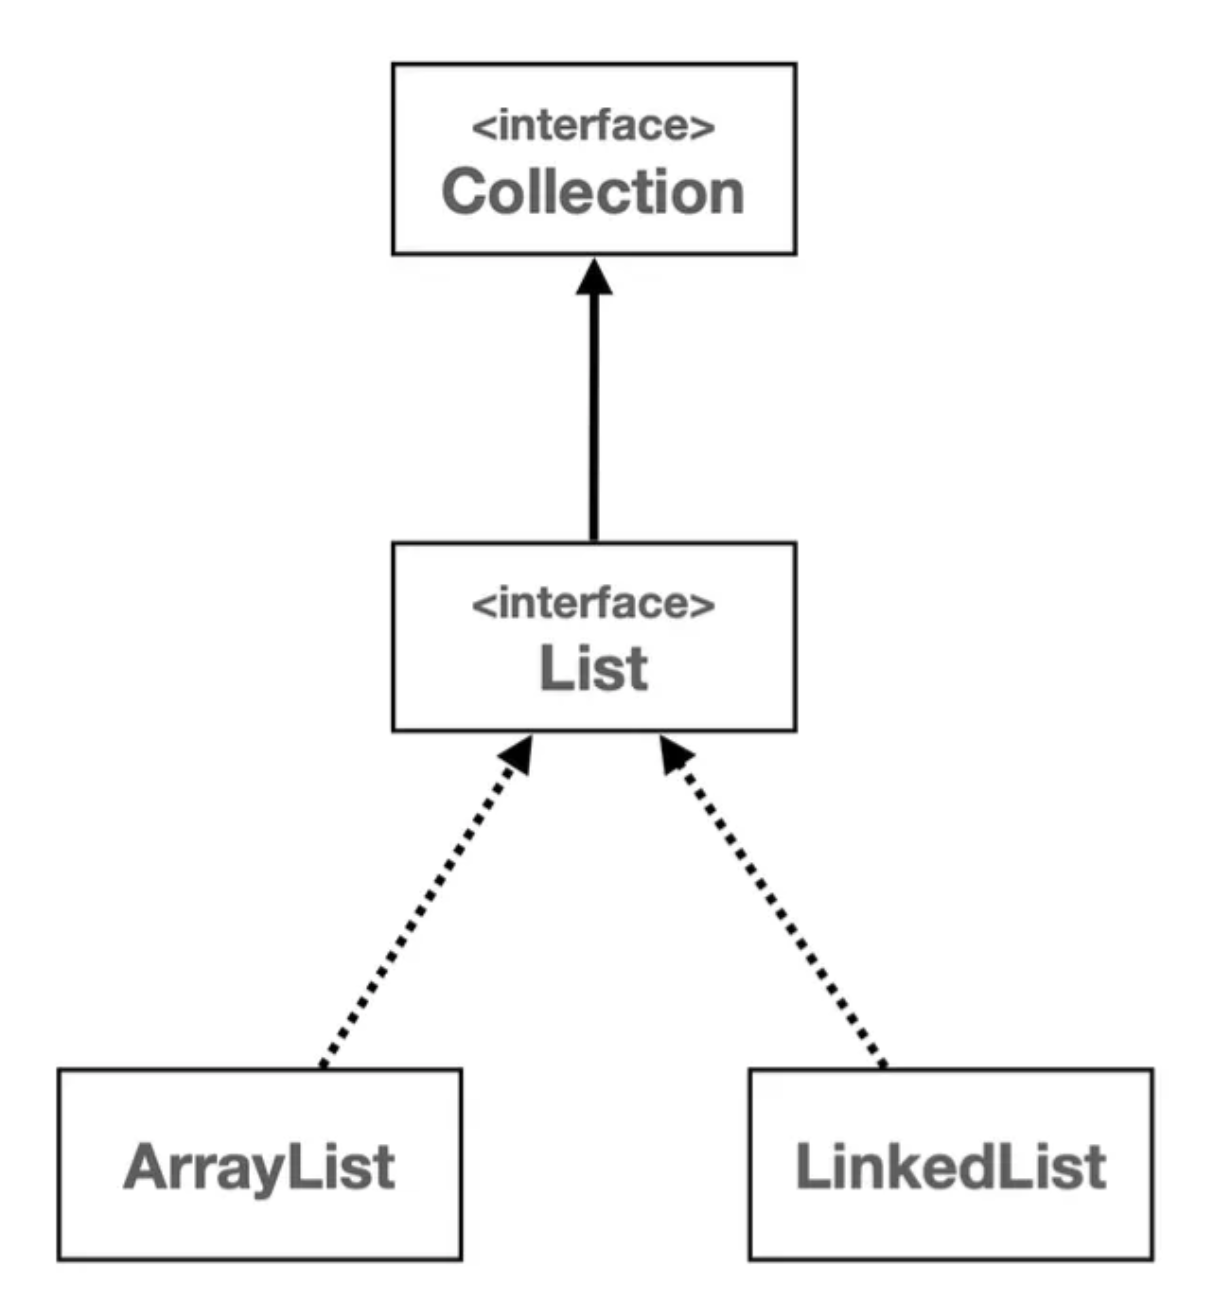
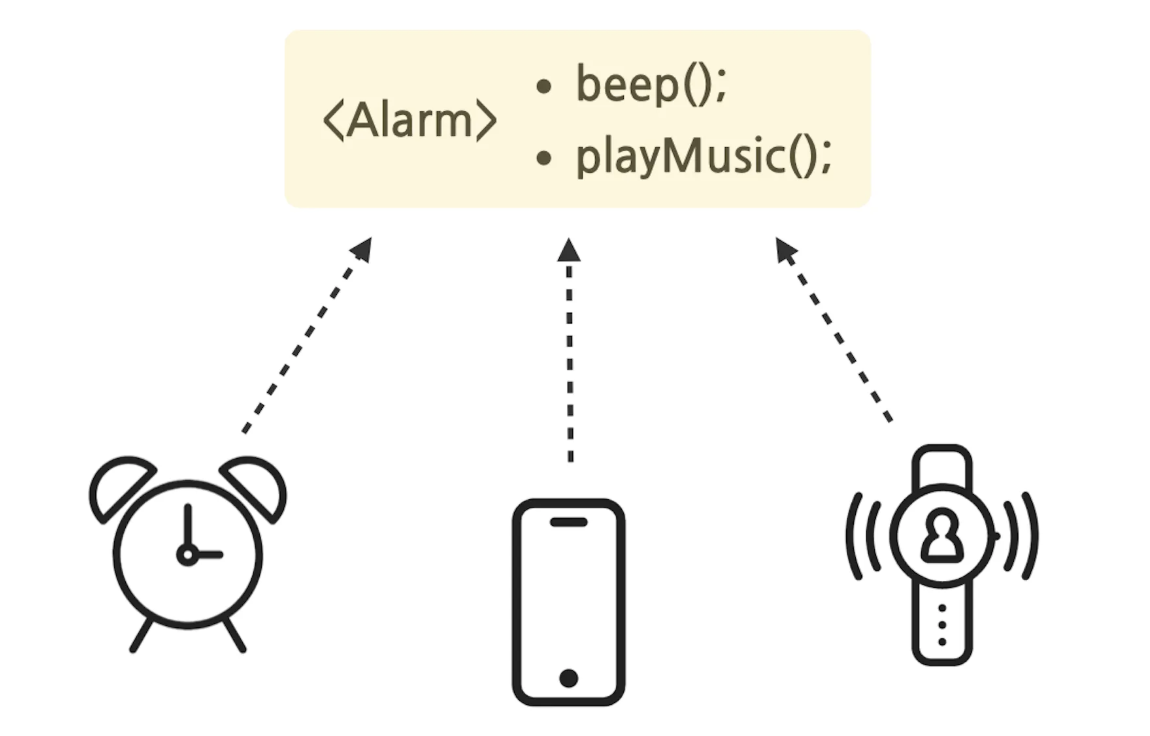
List는 인터페이스이다. List 인터페이스의 대표적인 구현체로 ArrayList 와 LinkedList가 있다.
- 인터페이스 : 클래스가 반드시 구현해야 하는 것들을 정해놓은 규칙. 즉, 클래스의 설계도
- 구현체 : 인터페이스가 정의한 규칙을 실제 코드로 작성한 클래스
ArrayList
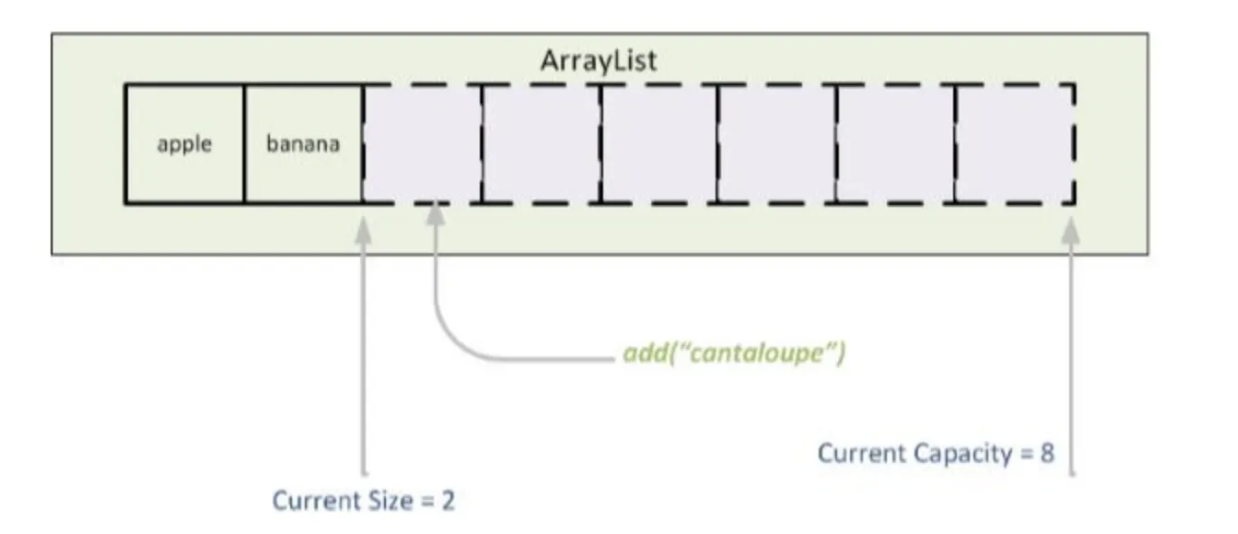
내부적으로 배열 기반이라 인덱스로 바로 접근할 수 있어 조회 속도가 빠르다.
중간에 요소를 넣거나 빼면 배열과 같이 뒤에 있는 요소들을 모두 이동시켜야 해서 삽입/삭제는 느리다.
단, 맨 뒤에 추가/삭제는 빠르다.
따라서 조회가 많을 때, 맨 뒤에 요소를 추가하는 경우가 많을 때 사용한다. ex) 게시판 글목록
프로그램에서 데이터를 다룰 땐 보통 자료를 불러오거나 맨 뒤에 새로 붙이는 경우가 많다. 따라서 ArrayList는 실무 대부분의 상황에서 사용된다.
LinkedList
내부적으로 이중 연결 리스트로 구현되어 있어 앞부터 순차 탐색해야 하므로 조회가 느리다.
배열과 달리 요소 삭제시 데이터 이동이 필요없어 중간에 요소를 삽입/삭제할 때 빠르다.
따라서 중간에서 삽입/삭제가 자주 일어나는 경우 사용한다. ex) 음악 재생 목록
List 구현체 정리표
| 구분 | ArrayList | LinkedList |
|---|---|---|
| 내부 구조 | 배열 기반 | 이중 연결 리스트 |
| 조회 속도 | 빠름 | 느림 |
| 삽입/삭제 속도 | 중간에 삽입/삭제시 느림, 맨 뒤는 빠름 | 중간에 삽입/삭제시 빠름, 위치 탐색은 느림 |
| 정렬 | X | X |
| 중복 여부 | 허용 | 허용 |
| 적합한 경우 | 조회 많고, 맨뒤에 요소 추가하는 경우 | 중간에 삽입/삭제가 잦은 경우 |
| 예시 | 게시판 글 목록 | 음악 재생 목록 |
List 인터페이스의 주요 메서드
외울 필요 없다. 한번씩 읽어 보고, 나중에 List를 사용할 때 검색해서 사용하자.
- 추가
| 메서드 | 설명 |
|---|---|
add(E e) | 리스트의 끝에 지정된 요소를 추가한다. |
add(int index, E element) | 리스트의 지정된 위치에 요소를 삽입한다. |
addAll(Collection<? extends E> c) | 지정된 컬렉션의 모든 요소를 리스트의 끝에 추가한다. |
addAll(int index, Collection<? extends E> c) | 지정된 컬렉션의 모든 요소를 리스트의 지정된 위치에 추가한다. |
- 조회
| 메서드 | 설명 |
|---|---|
get(int index) | 리스트에서 지정된 위치의 요소를 반환한다. |
size() | 리스트의 요소 수를 반환한다. |
isEmpty() | 리스트가 비어있는지 여부를 반환한다. |
iterator() | 리스트의 요소에 대한 반복자를 반환한다. |
toArray() | 리스트의 모든 요소를 배열로 반환한다. |
toArray(T[] a) | 리스트의 모든 요소를 지정된 배열로 반환한다. |
- 수정
| 메서드 | 설명 |
|---|---|
set(int index, E element) | 지정한 위치의 요소를 변경하고, 이전 요소를 반환한다. |
- 삭제
| 메서드 | 설명 |
|---|---|
remove(int index) | 리스트에서 지정된 위치의 요소를 제거하고 그 요소를 반환한다. |
remove(Object o) | 리스트에서 지정된 첫 번째 요소를 제거한다. |
clear() | 리스트에서 모든 요소를 제거한다. |
- 검색
| 메서드 | 설명 |
|---|---|
indexOf(Object o) | 리스트에서 지정된 요소의 첫 번째 인덱스를 반환한다. |
lastIndexOf(Object o) | 리스트에서 지정된 요소의 마지막 인덱스를 반환한다. |
contains(Object o) | 리스트가 지정된 요소를 포함하고 있는지 여부를 반환한다. |
- 기타
| 메서드 | 설명 |
|---|---|
sort(Comparator<? super E> c) | 리스트의 요소를 지정된 비교자에 따라 정렬한다. |
subList(int fromIndex, int toIndex) | 리스트의 일부분 뷰를 반환한다. |
Set 자료구조
순서가 없고, 중복을 허용하지 않고, 크기가 가변적인 자료구조
배열, List의 한계
- 순서를 보장하고 중복을 허용하기 때문에 “고유한 값들의 집합”을 만들기 불편하다.
int[] arr = {10, 20, 20, 30}; // 배열에 중복된 값을 가진 원소를 넣을 수 있다.ArrayList<Integer> list = new ArrayList<>(); // List에 중복된 값을 가진 원소를 넣을 수 있다.
list.add(10);
list.add(20);
list.add(20);
list.add(30);Set
set을 통해 각자 고유한 값을 가진 데이터 집합을 만들 수 있게 되었다.
Set<Integer> set = new HashSet<>();

// 데이터 추가 -> [10, 20, 30]
set.add(10);
set.add(20);
set.add(30);
set.add(20); // 중복되는 값은 무시하고 저장되지 않는다.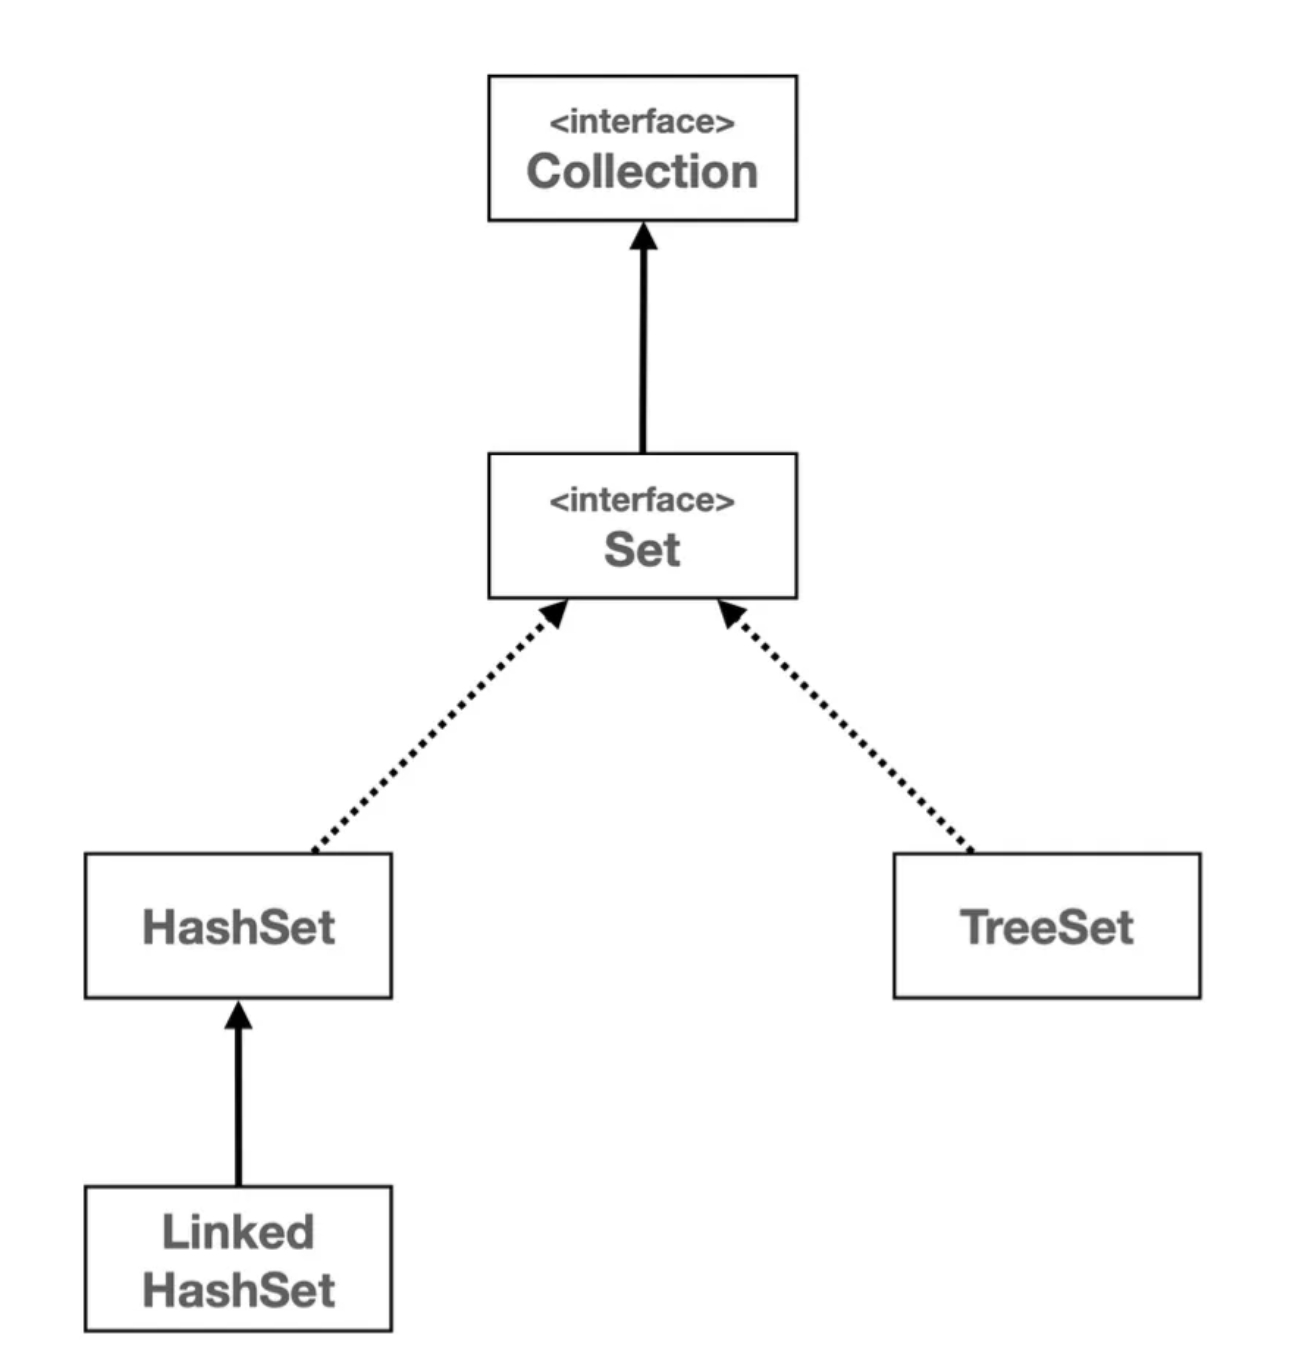
Set 또한 인터페이스이다. Set 인터페이스의 대표적인 구현체로 HashSet, LinkedHashSet, TreeSet이 있다.
선행 지식 : Hash
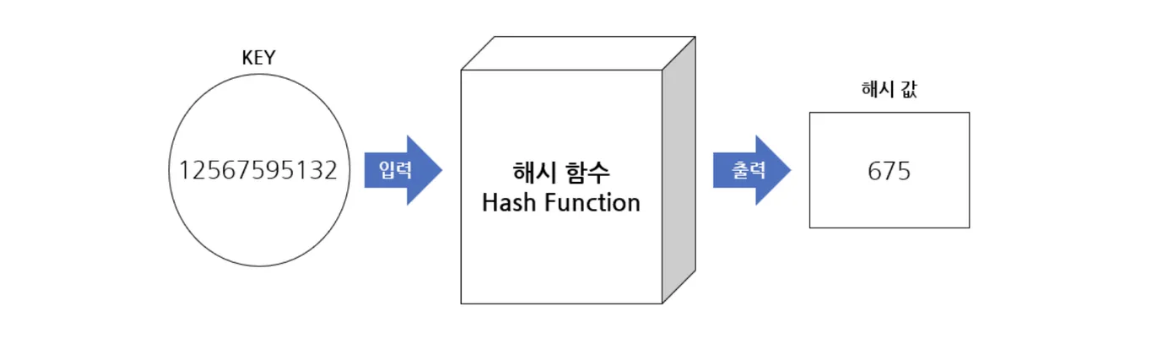
Hash는 데이터를 빠르게 찾기 위한 번호표이다. Hash 함수를 이용해 만든다.
“apple” → 123, “banana” → 456 이와 같이 데이터를 해시 함수에 넣으면 특정 규칙에 따라 고정된 길이의 값으로 바뀌고, 그 값을 이용해 원소를 매우 빠르게 찾을 수 있다.
HashSet
내부적으로 해시 테이블 기반이라 검색/삽입/삭제 속도가 빠르다.
중복을 허용하지 않고, 순서를 보장하지 않는다.
따라서 중복 없는 데이터 집합이 필요하고, 순서가 중요하지 않을 때, 검색/삽입/삭제가 자주 일어날 때 사용한다. ex) 회원 ID, 학번 등
LinkedHashSet
내부적으로 해시 테이블 + 연결 리스트 구조라서 검색/삽입/삭제 속도가 빠르다.
중복을 허용하지 않고, 입력한 순서를 보존한다.
따라서 중복 없는 데이터 집합이 필요하고, 순서가 중요할때 사용한다. ex) 최근 본 상품 목록, 방문 페이지 기록
선행 지식 : 레드-블랙 트리
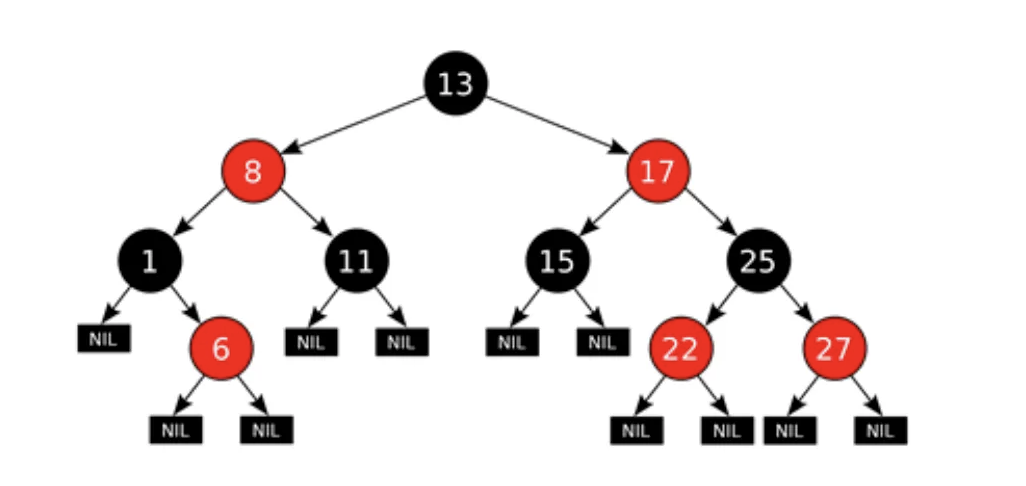
규칙을 정해 각 원소(노드)를 레드 혹은 블랙으로 설정하고, 삽입/삭제시 색을 바꾸거나 트리를 살짝 돌리는 방법으로 균형을 유지한다.
이로 인해 검색/삽입/삭제가 빠르진 않지만 항상 일정한 속도를 내며, 정렬되어 있어 범위 조회가 쉽다.
TreeSet
내부적으로 레드-블랙 트리 기반이라 데이터가 정렬된 상태로 저장된다. 검색/삽입/삭제 속도는 HashSet보다 느리지만, 범위 검색/정렬에 유리하다.
중복을 허용하지 않고, 순서를 보장한다.
따라서 중복 없이 정렬된 데이터 집합이 필요하고 순서가 중요할때 사용한다. ex) 점수 순위표, 특정 범위 사용자 검색(20~30대 등)
Set 구현체 정리표
| 구분 | HashSet | LinkedHashSet | TreeSet |
|---|---|---|---|
| 내부 구조 | 해시 테이블 | 해시 테이블 + 이중 연결 리스트 | 레드-블랙 트리(이진 탐색 트리) |
| 조회 속도 | 빠름 | 빠름 | 보통 |
| 삽입/삭제 속도 | 빠름 | 빠름 | 보통 |
| 정렬 | X | X (입력한 순서는 보존) | 자동 정렬 |
| 중복 여부 | 불가 | 불가 | 불가 |
| 적합한 경우 | 중복 없는 데이터 빠른 저장, 검색 | 중복 없는 데이터 순서 보존하며 빠른 저장, 검색 | 데이터 자동 정렬 필요시, 범위 검색 필요시 |
| 예시 | 회원 ID 목록 | 최근 본 상품 목록 | 점수 순위표 |
Set 인터페이스의 주요 메서드
외울 필요 없다. Set 사용시 검색해서 사용하자.
- 추가
| 메서드 | 설명 |
|---|---|
add(E e) | 집합에 지정된 요소를 추가한다. (이미 존재하면 false 반환) |
addAll(Collection<? extends E> c) | 지정된 컬렉션의 모든 요소를 집합에 추가한다. (중복은 무시됨) |
- 조회
| 메서드 | 설명 |
|---|---|
size() | 집합의 요소 수를 반환한다. |
isEmpty() | 집합이 비어있는지 여부를 반환한다. |
iterator() | 집합의 요소에 대한 반복자를 반환한다. |
toArray() | 집합의 모든 요소를 배열로 반환한다. |
toArray(T[] a) | 집합의 모든 요소를 지정된 배열로 반환한다. |
- 삭제
| 메서드 | 설명 |
|---|---|
remove(Object o) | 집합에서 지정된 요소를 제거한다. |
clear() | 집합에서 모든 요소를 제거한다. |
- 검색
| 메서드 | 설명 |
|---|---|
remove(Object o) | 집합에서 지정된 요소를 제거한다. |
clear() | 집합에서 모든 요소를 제거한다. |
Map 자료구조
키(Key)와 값(Value)를 하나의 쌍으로 저장하는 자료구조. 크기도 가변적이다.
- Key : 중복을 허용하지 않는다.
- Value : 중복을 허용한다.
특정 Key를 이용해 값을 빠르게 검색하고 싶을 때 유용하다.
배열, List, Set의 한계
앞서 사용한 배열, List, Set은 단순한 값을 저장하기 때문에 “이름 : 점수” 같은 매핑 관계를 표현하기 어렵다.
- 매핑 관계 : 어떤 대상을 다른 대상에 연결해 놓은 관계
String[] names = {"김보민","박대경"} // 학생 이름과 점수를 따로따로 저장해야 한다
int[] scores = {90, 95};
Map
Map을 통해 Key-Value 쌍을 한 번에 저장할 수 있다.
Key를 이용해 빠르게 검색할 수도 있다.
Map<String, Integer> map = new HashMap<>();
map.put("김보민", 90);
map.put("박대경", 95);

System.out.println(map.get("박대경")); // 95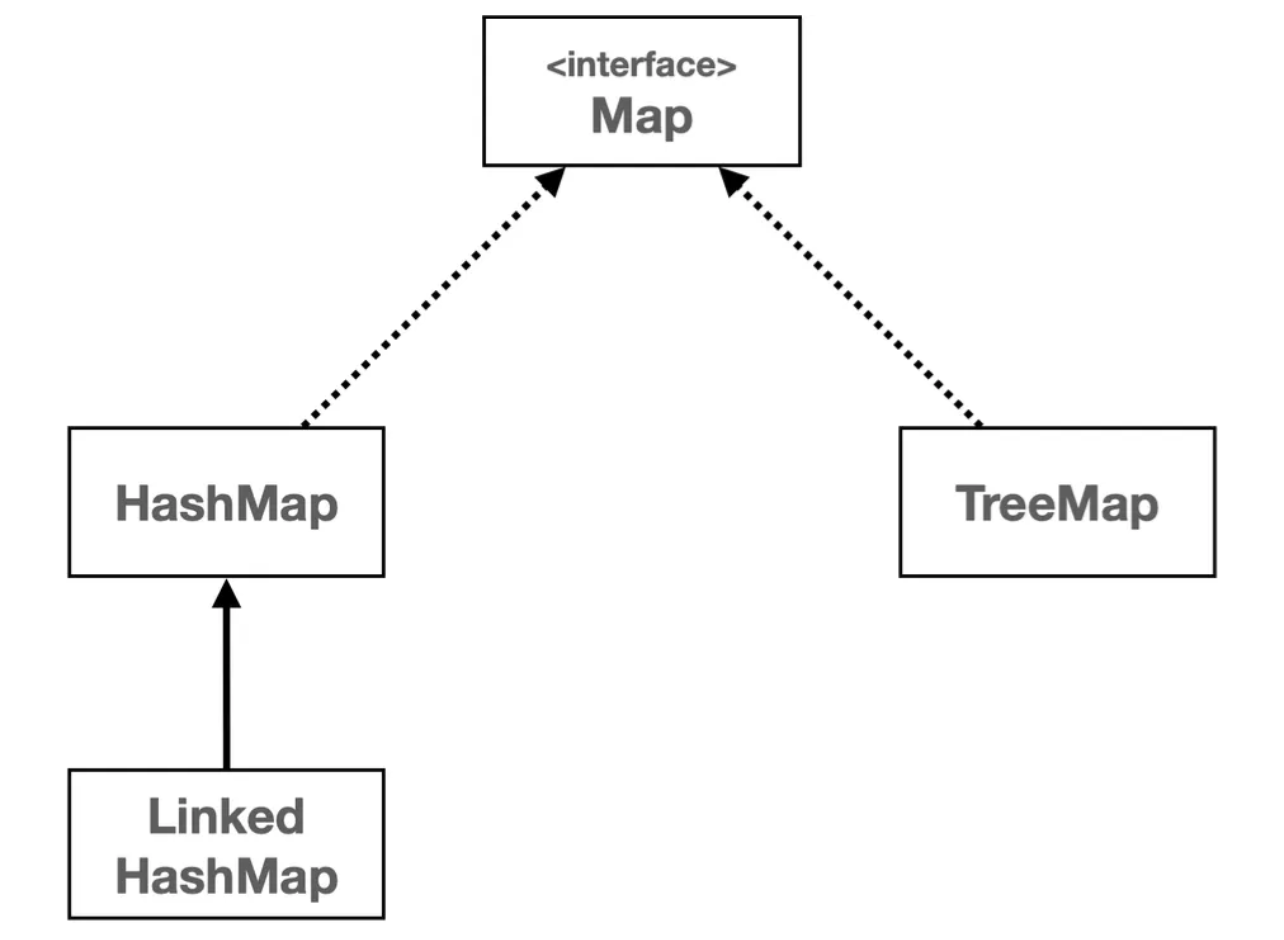
Map 또한 인터페이스이다. Map 인터페이스의 대표적인 구현체로 HashMap, LinkedHashMap, TreeMap이 있다.
HashMap
내부적으로 해시 테이블 기반이라 검색/삽입/삭제 속도가 빠르다.
Key의 순서를 보장하지 않는다.
따라서 순서 상관없이 Key-Value 값을 빠르게 저장/검색할 때 사용한다. ex) 회원<ID, 회원 정보>
LinkedHashMap
내부적으로 해시테이블 + 연결 리스트 구조라서 검색/삽입/삭제 속도가 빠르다.
Key를 입력한 순서를 보존한다.
따라서 순서를 유지하면서 Key-Value 값을 관리할 때 사용한다. ex) 최근 검색 목록<검색어, 검색 시간>
TreeMap
내부적으로 레드-블랙 트리 기반이라 Key가 정렬된 상태로 저장된다. 검색/삽입/삭제 속도는 HashMap보다 느리지만, 범위 검색/정렬에 유리하다.
Key의 순서를 보장한다.
따라서 정렬된 순서로 Key-Value 값을 관리할 때 사용한다 ex) 가나다순 정렬된 백과사전<단어, 뜻>
Map 구현체 정리표
| HashMap | LinkedHashMap | TreeMap | |
|---|---|---|---|
| 내부 구조 | 해시 테이블 기반 | 해시 테이블 + 이중 연결 리스트 | 레드-블랙 트리(이진 탐색 트리) |
| 조회 속도 | 빠름 | 빠름 | 보통 |
| 삽입/삭제 속도 | 빠름 | 빠름 | 보통 |
| 정렬 | X | X (입력한 순서는 보존) | 키 기준 정렬된 구조로 저장 |
| 중복 여부 | Key: 불가, Value: 허용 | Key: 불가, Value: 허용 | Key: 불가, Value: 허용 |
| 적합한 경우 | 빠른 검색 & 저장 | 순서 유지 + 빠른 검색 & 저장 | 데이터 자동 정렬 필요시, 범위 검색 필요시 |
| 예시 | 회원 <ID, 회원정보> | 최근 검색 기록 | 사전 <단어, 뜻> |
Map 인터페이스의 주요 메서드
외울 필요 없다. Map 사용시 검색해서 사용하자.
- 추가, 수정
| 메서드 | 설명 |
|---|---|
put(K key, V value) | 지정된 키와 값을 매핑하여 추가한다. (이미 존재하면 값을 덮어씀) |
putAll(Map<? extends K, ? extends V> m) | 지정된 맵의 모든 매핑을 현재 맵에 복사한다. |
- 조회
| 메서드 | 설명 |
|---|---|
size() | 맵에 저장된 매핑(키-값 쌍)의 수를 반환한다. |
isEmpty() | 맵이 비어있는지 여부를 반환한다. |
get(Object key) | 지정된 키에 매핑된 값을 반환한다. (없으면 null) |
keySet() | 맵에 포함된 모든 키를 Set 형태로 반환한다. |
values() | 맵에 포함된 모든 값을 Collection 형태로 반환한다. |
entrySet() | 맵에 포함된 모든 매핑(Entry)을 Set 형태로 반환한다. |
- 삭제
| 메서드 | 설명 |
|---|---|
remove(Object key) | 지정된 키에 매핑된 값을 제거한다. |
clear() | 맵의 모든 매핑을 제거한다. |
- 검색
| 메서드 | 설명 |
|---|---|
containsKey(Object key) | 맵이 지정된 키를 포함하고 있는지 여부를 반환한다. |
containsValue(Object value) | 맵이 지정된 값을 포함하고 있는지 여부를 반환한다. |
Stack & Queue -> Deque
Stack
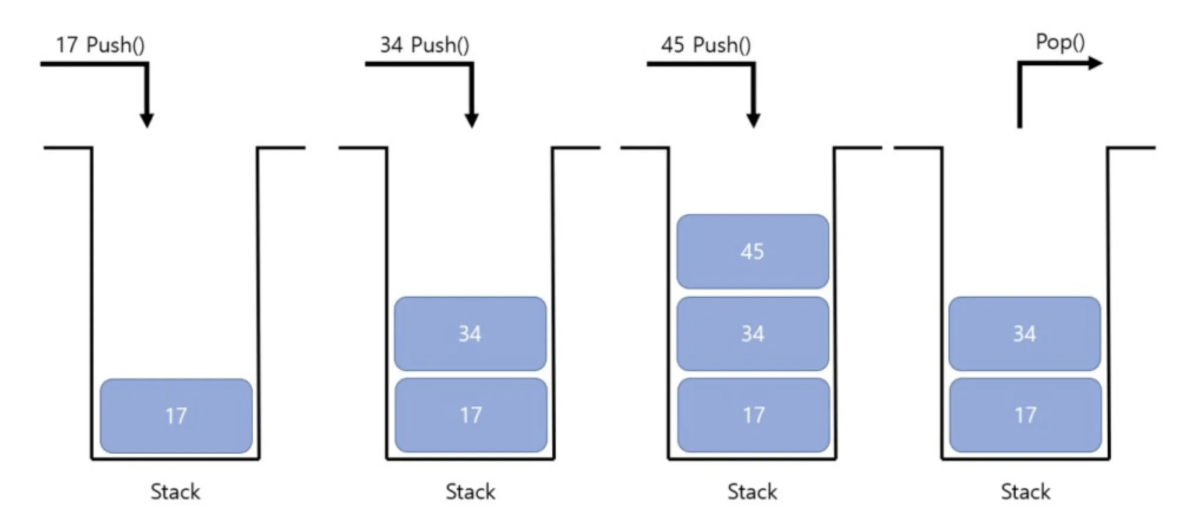
마지막에 넣은 데이터를 먼저 꺼내는 후입선출(Last In First Out, LIFO) 자료구조
책을 쌓거나 접시를 쌓는 것과 같이, 마지막에 올린 책이나 접시를 먼저 꺼낼 수 있다.
Stack이 필요한 경우
배열이나 리스트는 어떤 위치의 데이터는 꺼낼 수 있는 자유가 있다.
하지만 어떤 상황은 이렇게 자유롭지 않고, 마지막에 넣은 것부터 꺼내야만 하는 규칙이 필요하다. 이때 Stack을 사용한다.
예를 들자면, 브라우저의 뒤로가기 기능이 있다.
[네이버] → [구글] → [유튜브] 순으로 방문했다면, 뒤로 가기 버튼을 누를 땐 [유튜브] → [구글] → [네이버] 순서로 돌아가야 한다.
Stack 예시 코드
Deque<String> stack = new ArrayDeque<>();

stack.push("네이버");
stack.push("구글");
stack.push("유튜브"); // 현재 스택 (Top -> bottom) [유튜브, 구글, 네이버]

System.out.println("peek: " + stack.peek()); // 맨 위 데이터 확인, 유튜브

System.out.println("pop: " + stack.pop()); // 유튜브
System.out.println("pop: " + stack.pop()); // 구글
System.out.println("pop: " + stack.pop()); // 네이버
Queue 예시 코드
Deque<String> queue = new ArrayDeque<>();

queue.offer("김보민");
queue.offer("권지후");
queue.offer("박대경"); // 현재 큐 (Rear -> Front) : [박대경, 권지후, 김보민]

System.out.println("peek: " + queue.peek()); // 맨 앞 데이터 확인, 김보민

System.out.println("poll: " + queue.poll()); // 김보민
System.out.println("poll: " + queue.poll()); // 권지후
System.out.println("poll: " + queue.poll()); // 박대경
Deque
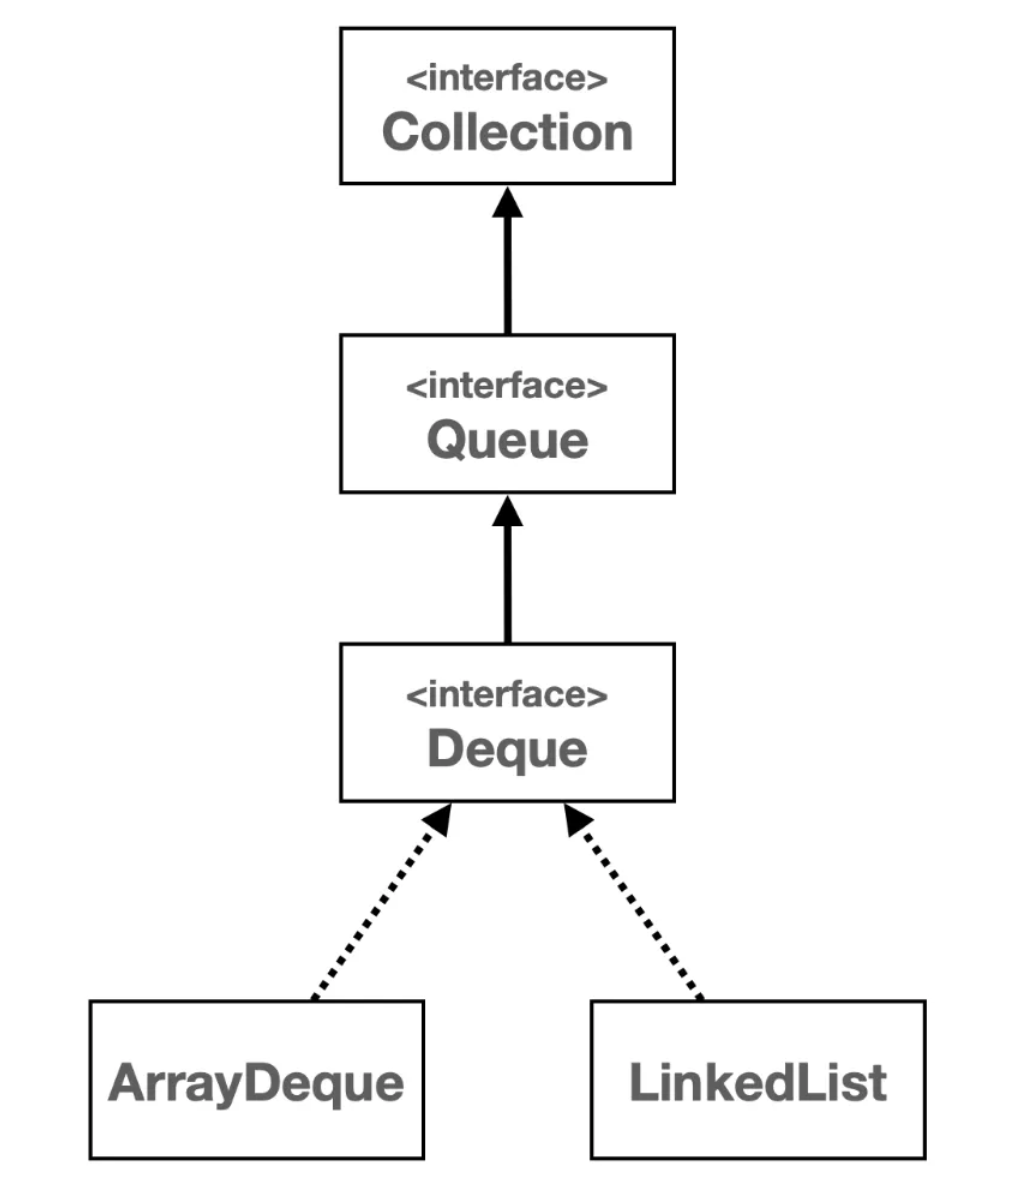
Deque 또한 인터페이스이다.
대표적인 구현체는 ArrayDeque, LinkedList가 있다.
ArrayDeque가 거의 모든 면에서 더 빠르기 때문에 주로 이것만 사용한다.
Stack과 Queue의 기능을 모두 지원하기 때문에 Deque의 구현체를 Stack, Queue 구현시 사용한다.
상단의 Stack과 Queue의 예시 코드는 모두 ArrayDeque 구현체를 사용했다.
(참고) 예전에는 Stack 클래스를 사용해 구현했으나 이제는 무겁고 클래스 구조도 깔끔하지 않아 사용하지 않는다.
Deque 인터페이스의 주요 메서드
- 추가
| 메서드 | 설명 |
|---|---|
addFirst(E e) | 맨 앞에 요소를 추가한다. |
addLast(E e) | 맨 뒤에 요소를 추가한다. |
offerFirst(E e) | 맨 앞에 요소를 추가한다. (실패 시 false 반환) |
offerLast(E e) | 맨 뒤에 요소를 추가한다. (실패 시 false 반환) |
- 조회
| 메서드 | 설명 |
|---|---|
getFirst() | 맨 앞의 요소를 반환한다. (비어있으면 예외 발생) |
getLast() | 맨 뒤의 요소를 반환한다. (비어있으면 예외 발생) |
peekFirst() | 맨 앞의 요소를 반환한다. (비어있으면 null) |
peekLast() | 맨 뒤의 요소를 반환한다. (비어있으면 null) |
| --- | --- |
removeFirst() | 맨 앞의 요소를 제거하고 반환한다. (비어있으면 예외 발생) |
removeLast() | 맨 뒤의 요소를 제거하고 반환한다. (비어있으면 예외 발생) |
pollFirst() | 맨 앞의 요소를 제거하고 반환한다. (비어있으면 null) |
pollLast() | 맨 뒤의 요소를 제거하고 반환한다. (비어있으면 null) |
- 삭제
| 메서드 | 설명 |
|---|---|
removeFirst() | 맨 앞의 요소를 제거하고 반환한다. (비어있으면 예외 발생) |
removeLast() | 맨 뒤의 요소를 제거하고 반환한다. (비어있으면 예외 발생) |
pollFirst() | 맨 앞의 요소를 제거하고 반환한다. (비어있으면 null) |
pollLast() | 맨 뒤의 요소를 제거하고 반환한다. (비어있으면 null) |
- 기타
| 메서드 | 설명 |
|---|---|
push(E e) | 맨 앞에 요소를 추가한다. |
pop() | 맨 앞의 요소를 제거하고 반환한다. |
peek() | 맨 앞의 요소를 반환한다. (비어있으면 null) |
size() | 요소의 개수를 반환한다. |
isEmpty() | 비어있는지 여부를 반환한다. |
iterator() | 앞에서 뒤 방향으로 요소를 순차 접근할 수 있는 반복자를 반환한다. |
descendingIterator() | 뒤에서 앞 방향으로 요소를 순차 접근할 수 있는 반복자를 반환한다 |
자료구조 총정리표
| 구분 | 내부 구조 | 조회 속도 | 삽입/삭제 속도 | 특징/적합한 경우 | 예시 |
|---|---|---|---|---|---|
| ArrayList | 배열 기반 | 빠름 | 중간에 삽입/삭제 느림, 맨뒤 빠름 | 조회 많고, 맨뒤에 요소 추가 자주 할때 | 게시판 글 목록 |
| LinkedList | 이중 연결 리스트 | 느림 | 중간에 삽입/삭제 빠름, 위치 탐색 느림 | 중간 삽입/삭제 잦은 경우 | 음악 재생 목록 |
| HashSet | 해시 테이블 | 빠름 | 빠름 | 중복 X, 순서 X / 빠른 저장, 검색 | 회원 아이디 집합 |
| LinkedHashSet | 해시 테이블 + 연결 리스트 | 빠름 | 빠름 | 중복 X, 입력한 순서만 보존 | 최근 본 상품 목록 |
| TreeSet | 레드-블랙 트리 | 보통 | 보통 | 중복 X, 자동 정렬, 범위 검색 | 점수 순위표 |
| HashMap | 해시 테이블 | 빠름 | 빠름 | Key 중복 X, 순서 X / 단순조회, 삽입 | 회원 <ID, 회원정보> |
| LinkedHashMap | 해시 테이블 + 연결 리스트 | 빠름 | 빠름 | Key 중복 X, 입력한 순서만 보존 | 최근 검색 기록 |
| TreeMap | 레드-블랙 트리 | 보통 | 보통 | Key 중복 X, 자동 정렬, 범위 검색 | 사전 <단어, 뜻> |
| Stack | ArrayDeque (구현) | 한쪽 끝 (Top)에서만 삽입/삭제 | LIFO (후입선출) | 브라우저 뒤로가기 | |
| Queue | ArrayDeque (구현) | 뒤쪽(Rear) 삽입, 앞쪽(Front) 삭제 | FIFO (선입선출) | 수강신청 대기열 | |
| Deque | ArrayDeque, LinkedList | 양쪽 끝에서 삽입/삭제 | 양쪽 삽입/삭제, Stack+Queue 구현 | n개만 유지하는 최근기록 |
더 알아보면 좋은 키워드
복습 or 추가학습
- Object 클래스
- Object 클래스가 모든 클래스의 최상위 부모인 이유는 무엇일까요?
- 다형성
- ‘다형적 참조’ 란 무엇일까요?
- 인터페이스
- 추상 클래스와 인터페이스의 차이가 무엇일까요?
- Java의 메모리 영역
- Java의 메모리 영역은 어떻게 구성되어 있을까요?
- 시간 복잡도
- 빅오 표기법이 뭘까요?
- 트리
- 트리 자료구조는 어떤 자료구조일까요?
- 다른 좋은 자료구조도 많은데, 트리 자료구조는 왜 만들었을까요?
- 해시
- 해시값은 왜 숫자로 구성되어 있을까요?
- SOLID 원칙 (중요하지만 당장은 아님)
예습
- 추상 클래스, 인터페이스
- 추상 클래스와 인터페이스의 차이가 무엇일까요?
- 불변 객체(Immutable object)
- 익명 클래스(Anonymous Class)
- 메서드 체이닝
- null