기본적인 데이터 처리 방식에서는 "파일 저장 → 읽기"
데이터 전송 속도 증가와 빅데이터 처리 기술의 고도화로 "파일저장&(동시에)&읽기" ⇒ 이러한 기술을 스트리밍 서비스 라고 부름
→ 스트리밍 서비스에서 실시간으로 데이터를 처리하는 곳에서 사용하는 기술 중 하나가 카프카Kafka
⇒ 스트리밍 서비스에서 실시간으로 데이터를 처리하는 사이트 ex) 유튜브
카프카
카프카는 대규모 실시간 데이터 스트리밍을 처리하는데 사용되는 분산 이벤트 스트리밍 플랫폼이다.
"분산 이벤트"라는 말은 여러 대의 서버(노드)에 분산되어 저장된 이벤트(데이터)를 말한다. "이벤트 스트리밍"은 대량의 이벤트(데이터)를 실시간으로 처리하는 방식을 의미한다.
즉, "분산 이벤트 스트리밍 플랫폼"은 분산되어 있는 이벤트(데이터)들을 실시간으로 처리하는 플랫폼이라는 뜻이 됩니다.
카프카 개발 배경
카프카 개발 전 링크드인의 데이터 처리 시스템
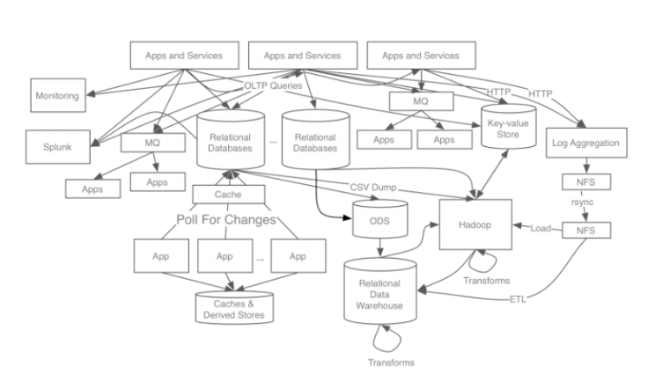
각 애플리케이션과 DB가 도착지점까지 모든 시스템을 거치는 End - To - End 로 연결(=각 파이프라인의 파편화)되어 있어 있어 다음과 같은 문제가 발생한다.
1. 시스템 복잡도 증가 (Complexity)
- 통합된 전송 영역이 없어 데이터 흐름을 파악하기 어렵고, 시스템 관리가 어려움
- 연결 되어있는 애플리케이션들을 모두 확인해야 하기 때문에 특정 부분에서 장애 발생 시 조치 시간 증가
- 연결된 애플리케이션에 side effect 가 없는지 확인해야 하기 때문에 HW 교체 / SW 업그레이드 시 관리포인트가 늘어나고, 작업시간 증가
2. 데이터 파이프라인 관리의 어려움
- 각 애플리케이션과 데이터 시스템 간의 별도의 파이프라인 존재하고, 파이프라인 마다 데이터 포맷과 처리 방식이 다름
- 새로운 파이프라인 확장이 어려워지면서, 확장성 및 유연성이 떨어짐
또한 데이터 불일치 가능성이 있어 신뢰도 감소
⇒ 해결책
- 모든 시스템으로 데이터를 전송할 수 있고,
- 실시간 처리도 가능하며,
- 급속도로 성장하는 서비스를 위해 확장이 용이한
시스템을 만들자 ⇒ 카프카
카프카
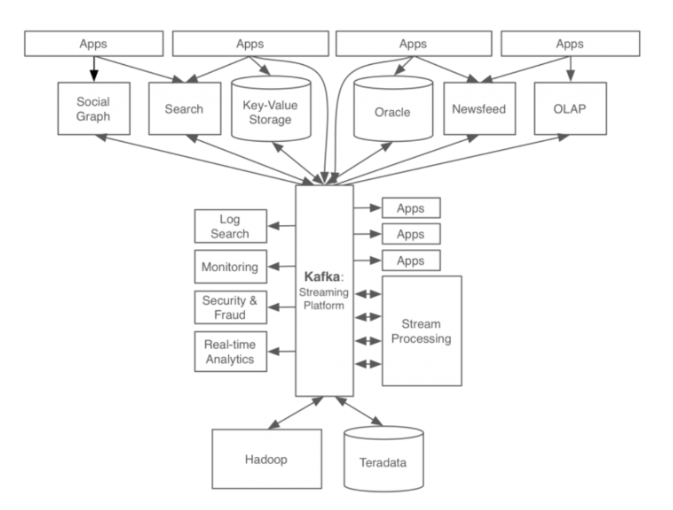
모든 이벤트와 데이터의 흐름을 중앙에서 관리하는 카프카가 개발된다.
카프카를 적용한 후 링크드인의 데이터 처리 시스템이다.
카프카의 동작 방식
카프카는 Pub-Sub 모델의 메세지 큐 형태로 동작한다.
카프카를 이해하기 위해서는 메세지/이벤트 브로커와 메세지 큐에 대해 알아야한다.
메세지 큐 Message Queue, MQ
메세지 큐는 메시지 지향 미들웨어 (MOM: 서로 다른 시스템, 애플리케이션, 서비스 간에 메시지를 교환하는 방식)"를 구현한 시스템으로 프로그램(프로세스 )간의 데이터를 교환할 때 사용하는 기술
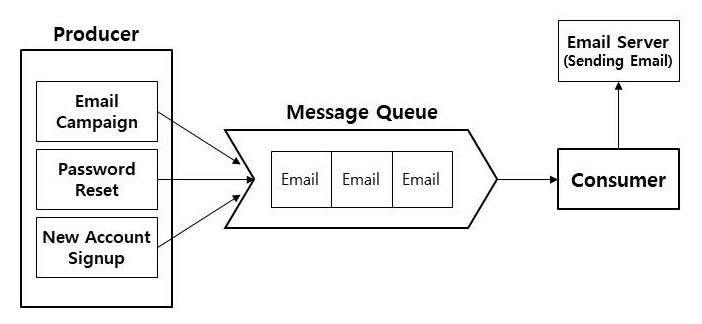
- producer: 정보를 제공하는 자
- consumer: 정보를 제공받아서 사용하려는 자
- Queue: producer의 데이터를 임시 저장 및 consumer에 제공하는 곳
MQ에서 메세지는 Endpoint 간에 직접적으로 통신하지 않고, 중간데 Queue를 통해 중개된다.
Point to Point 와 Pub / Sub
메세지 큐는 크게 Point to Point(P2P)와 Publish/Subscribe (Pub / Sub) 모델로 구분된다.
-
Point to Point(P2P) : 한 명의 발행자의 메세지는 한 명의 컨슈머에 의해 소비되는 방식으로, 즉 1:1 메시지 전송 방식
-
Publish/Subscribe(Pub/Sub) : Pub/Sub 모델은 비동기 메세징 전송 방식으로, 발신자의 메세지에는 수신자가 정해져 있지 않은 상태로 publish 함. 그리고 이를 Subscribe(구독)을 한 수신자만 정해진 메세지(topic)을 받을 수 있다. 이처럼 수신자는 발신자 정보가 없어도 원하는 메세지만 수신할 수 있으며, 이런 구조 덕분에 높은 확장성을 확보
Pub/Sub 모델의 구체적인 발행/구독 방식은 각 서비스 마다 다르다.
구성요소 및 동작원리
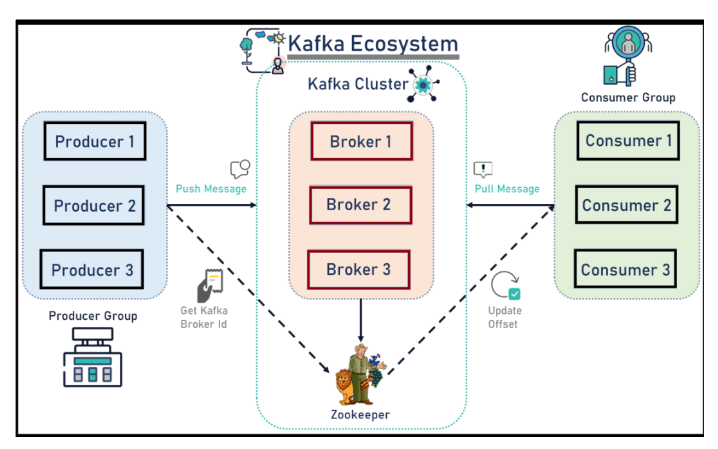
- 카프카 클러스터 Kafka Cluster
브로커들의 모임으로 확장성과 고가용성을 위해 Broker들이 클러스터로 구성되어 있다. - 브로커 Broker
각각의 Kafka 서버를 말한다. 프로듀서로부터 메세지를 전달받아 토픽에 저장하고 컨슈머에 전달한다. (하나의 브로커는 여러 개의 토픽을 가질 수 있다.) - 주키퍼 Zookeeper
Kafka 클러스터 상태와 정보 등을 관리하는 역할을 한다. (Kafka를 실행시키기 위해선 Zookeeper도 같이 실행해야 한다.)
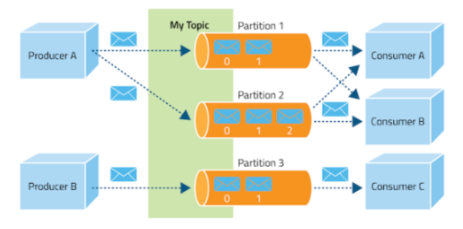
- 이벤트 Event
kafka에서 producer 와 consumer가 데이터를 주고받는 단위. 메세지 - 프로듀서 Producer
kafka에 메시지(이벤트)를 발행하는 주체이다. 메시지 발행 시 특정 토픽을 정하여 발행한다. - 컨슈머 Consumer
메시지(이벤트)를 소비, 수신하는 주체다. 특정 토픽을 구독하여 메시지(이벤트)를 전달받는다(Sub). - 토픽 Topic
메세지(이벤트)가 모이는 곳. 메시지(이벤트)를 구분하는 단위로 프로듀서가 전송한 데이터는 토픽 이름으로 구분된다.
프로듀서는 토픽에 이벤트를 게시하고, 컨슈머는 토픽을 구독해 이로부터 이벤트를 가져와 처리한다. (게시판 같은 개념) - 파티션 Partition
토픽은 여러 브로커에 분산되어 저장되며 이렇게 분산된 토픽을 파티션이라고 한다. 토픽은 하나 이상의 파티션으로 나뉜다. 즉, 동일한 토픽이 여러 파티션에 나누어 저장된다.
