지난 글에서는 RAG가 무엇인지, 왜 필요한지 전체적인 흐름을 살펴봤다.
RAG의 핵심은 사용자의 질문과 관련된 정보를 찾아서 LLM에게 전달하는 것이다.
그런데 여기서 궁금한 점이 생긴다.
수많은 문서 중에서 사용자의 질문과 관련된 내용을 어떻게 찾아낼까?
이를 이해하려면 RAG에서 자주 등장하는 Chunking, Embedding, Vector DB를 알아야 한다.
전체 흐름 먼저 보기
문서를 RAG에서 활용하려면 보통 다음과 같은 과정을 거친다.
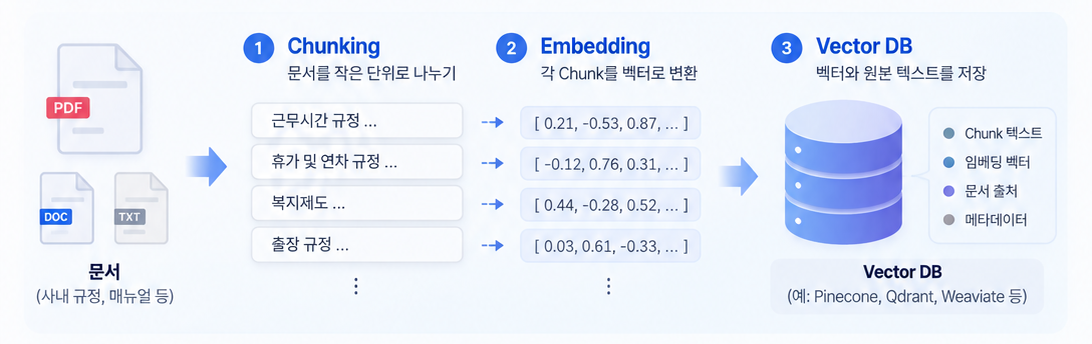
문서
 ↓
Chunking
 ↓
Embedding
 ↓
Vector DB 저장
예를 들어 회사의 여러 규정이 담긴 문서가 있다고 해보자.
문서 전체를 그대로 저장하고 검색하는 것이 아니라,
문서를 작은 단위로 나누고 → 각 내용을 숫자로 변환하고 → 검색할 수 있도록 저장한다.
하나씩 살펴보자 .. !
Chunking이란?
Chunking(청킹)은 긴 문서를 작은 단위(Chunk)로 나누는 과정이다.
예를 들어 하나의 사내 규정 문서에 다음과 같은 내용이 있다고 해보자.
사내 규정.pdf

- 근무시간 규정
- 휴가 및 연차 규정
- 복지제도
- 출장 규정
- 경비 처리 규정
...
이 문서를 하나의 거대한 데이터로 사용하는 것이 아니라 일정한 크기의 조각으로 나눈다.
Chunk 1 → 근무시간 관련 내용

Chunk 2 → 휴가 및 연차 관련 내용

Chunk 3 → 복지제도 관련 내용

Chunk 4 → 출장 관련 내용
왜 굳이 나눌까?
사용자가
"남은 연차를 내년으로 넘길 수 있어?"
라고 질문했는데 수십, 수백 페이지의 문서 전체를 가져올 필요는 없다.
질문과 관련 있는 연차 규정 부분만 찾아오면 된다.
즉, Chunking은 문서를 검색하고 활용하기 좋은 크기로 나누는 과정이라고 볼 수 있다.
Embedding이란?
문서를 나눴다면 이제 각각의 Chunk를 검색할 수 있는 형태로 만들어야 한다.
이때 등장하는 것이 Embedding(임베딩)이다.
Embedding은 텍스트의 의미를 컴퓨터가 비교할 수 있도록 숫자로 이루어진 벡터(Vector)로 변환하는 과정이다.
예를 들어 실제 값은 아니지만,
"미사용 연차 이월 규정"

↓

Embedding

↓

[0.21, -0.53, 0.87, 0.14, ...]
와 같은 형태로 변환된다.
그런데 굳이 왜 이렇게 숫자로 바꾸는 걸까?
우리가 검색하고 싶은 것은 단순히 같은 단어가 들어간 문장이 아니라 의미가 비슷한 문장이기 때문이다.
예를 들어,
"남은 연차를 내년에 사용할 수 있나요?"
와
"미사용 연차 이월 규정"
은 사용된 단어가 완전히 같지는 않다.
하지만 사람이 읽으면 두 문장이 비슷한 내용을 의미한다는 것을 쉽게 알 수 있다.
Embedding을 사용하면 이러한 텍스트의 의미적 유사성을 벡터를 통해 비교할 수 있다.
Vector DB란?
Embedding을 통해 만들어진 벡터는 어딘가에 저장해야 한다.
이때 사용하는 것이 Vector Database(Vector DB)다.
전체 과정을 다시 보면,
문서
 ↓
Chunking
 ↓
각 Chunk를 Embedding
 ↓
Vector DB에 저장
Vector DB에는 문서의 Chunk와 해당 Chunk를 표현하는 벡터가 저장된다.
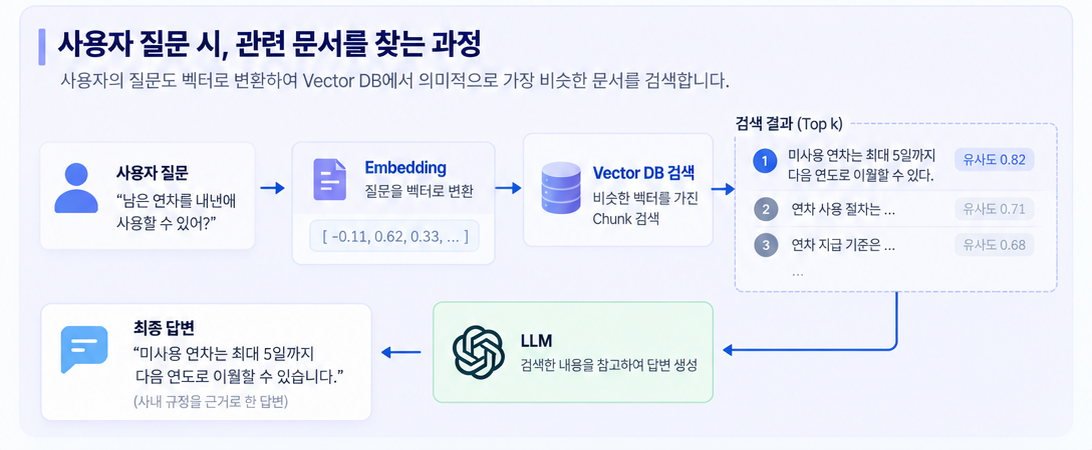
그리고 사용자의 질문이 들어오면 질문 역시 Embedding을 통해 벡터로 변환한다.
"남은 연차를 내년에 사용할 수 있어?"

↓

Embedding

↓

질문의 Vector
그다음 Vector DB에서 질문의 벡터와 가까운 벡터를 가진 문서 Chunk를 찾는다.
쉽게 말하면,
"이 질문과 의미가 가장 비슷한 내용이 어디 있지?"
를 찾는 것이다.
어떻게 관련 문서를 찾는 걸까?
전체 과정을 연결해보면 조금 더 이해하기 쉽다.
[미리 준비]

사내 규정 문서
      ↓
   Chunking
      ↓
   Embedding
      ↓
   Vector DB


[사용자 질문]

"남은 연차를 내년에 사용할 수 있어?"
      ↓
   Embedding
      ↓
질문과 비슷한 Vector 검색
      ↓
"미사용 연차 이월 규정" 발견
이렇게 질문과 의미가 비슷한 문서를 찾는 것을 유사도 검색(Similarity Search)이라고 한다.
결국 RAG는 이 과정을 통해 사용자의 질문과 관련된 정보를 찾아낸다.
찾아낸 정보는 이후 LLM에게 질문과 함께 전달되고, LLM은 해당 내용을 참고하여 최종 답변을 생성한다.
정리
지금까지의 내용을 간단하게 정리하면 다음과 같다.
Chunking
긴 문서를 검색하기 좋은 작은 단위로 나누는 과정
Embedding
텍스트의 의미를 숫자로 이루어진 Vector로 변환하는 과정
Vector DB
만들어진 Vector를 저장하고, 비슷한 Vector를 검색할 수 있는 데이터베이스
그리고 이 과정을 연결하면,
문서를 나누고 → 의미를 숫자로 바꾸고 → 저장하고 → 비슷한 내용을 찾는다.
라는 흐름이 된다.
여기까지 이해하면 RAG에서 관련 문서를 어떻게 찾아오는지에 대한 기본적인 구조를 이해할 수 있다.
다음 글에서는 이렇게 찾아온 정보를 실제로 어떻게 LLM에게 전달하는지, Retrieval부터 최종 답변 생성까지의 RAG 동작 과정을 조금 더 자세히 살펴보려고 한다.