[JPA] ORM, JPA, Hibernate 개념 정리: 영속성 컨텍스트까지
save()한 줄에 쿼리가 나가는 이유가 궁금해서, JPA의 핵심 개념만 입문자 눈높이부터 정리했습니다.
1. ORM이란?
객체지향 언어와 관계형 DB는 데이터를 다루는 방식이 다릅니다.
| 구분 | 객체 | 관계형 DB |
|---|---|---|
| 관계 표현 | 참조 (order.getMember()) | 외래 키 (member_id) |
| 상속 | 있음 | 없음 |
| 식별 | ==, equals() | PK |
| 탐색 | 객체 그래프 탐색 | JOIN |
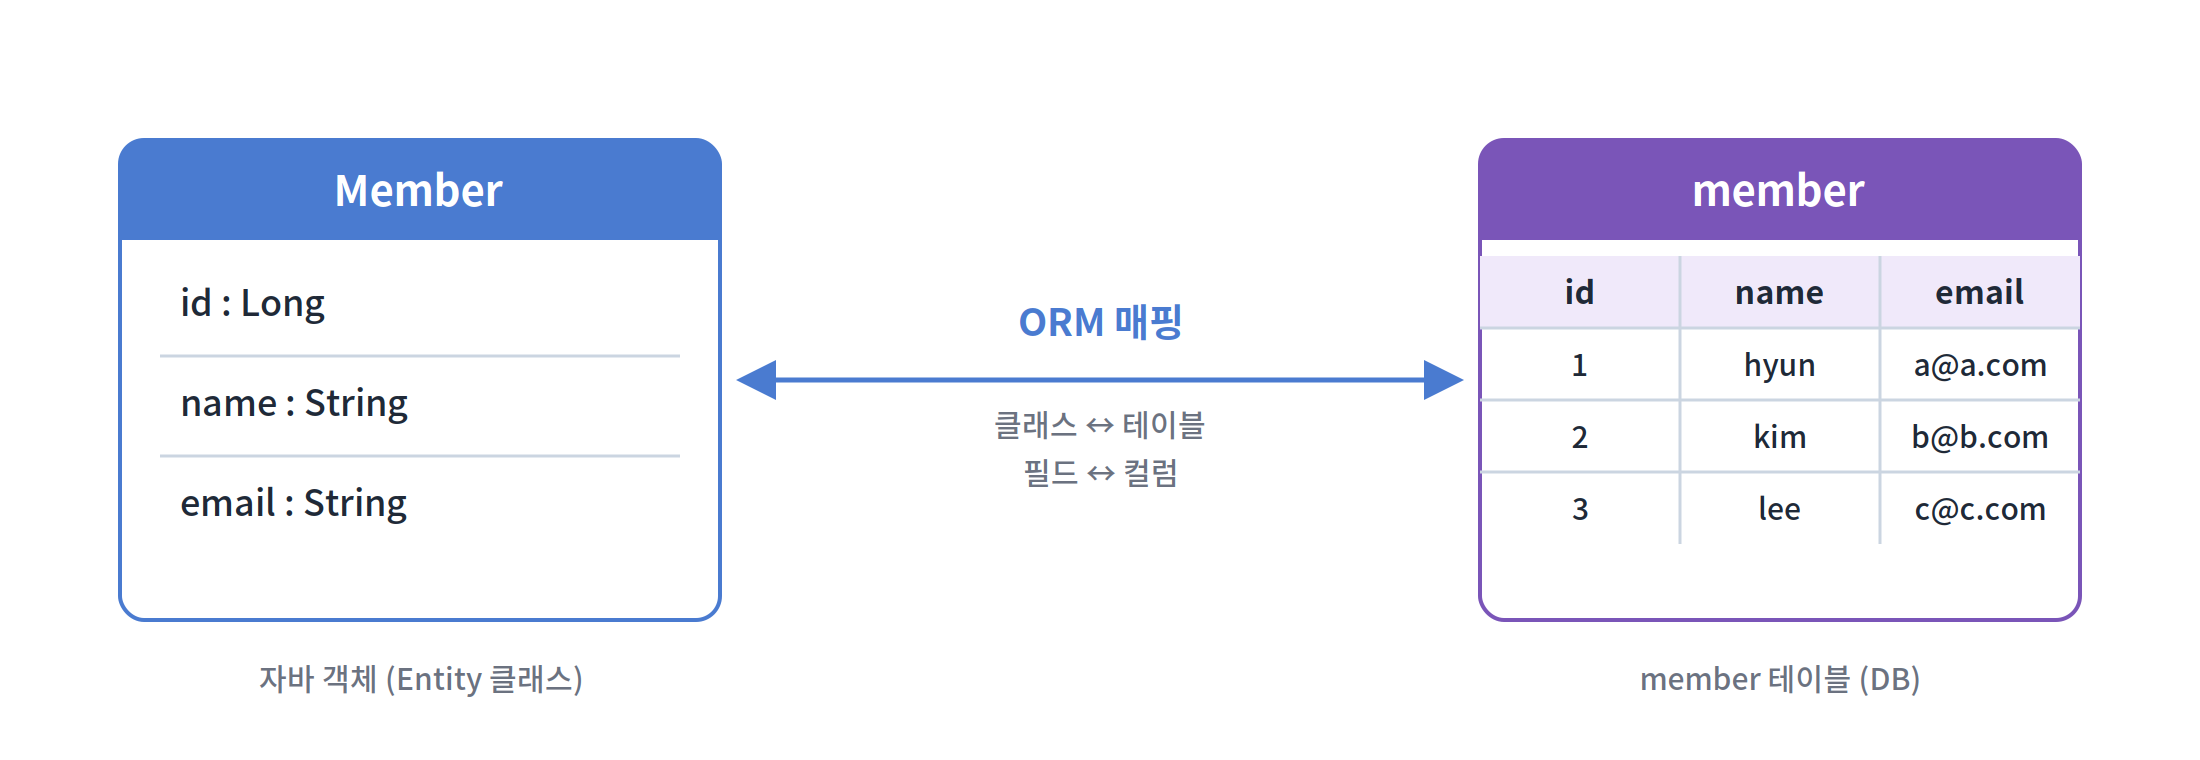
ORM(Object-Relational Mapping) 은 이 간극을 메워주는 기술입니다. 객체와 테이블을 매핑해서 SQL 대신 객체 중심으로 DB를 다루게 해줍니다.
2. JPA vs Hibernate vs Spring Data JPA
처음에 가장 헷갈리는 부분입니다. 한 줄씩 정리하면 이렇습니다.
| 용어 | 정체 |
|---|---|
| ORM | 객체와 테이블을 매핑하는 개념/기술 |
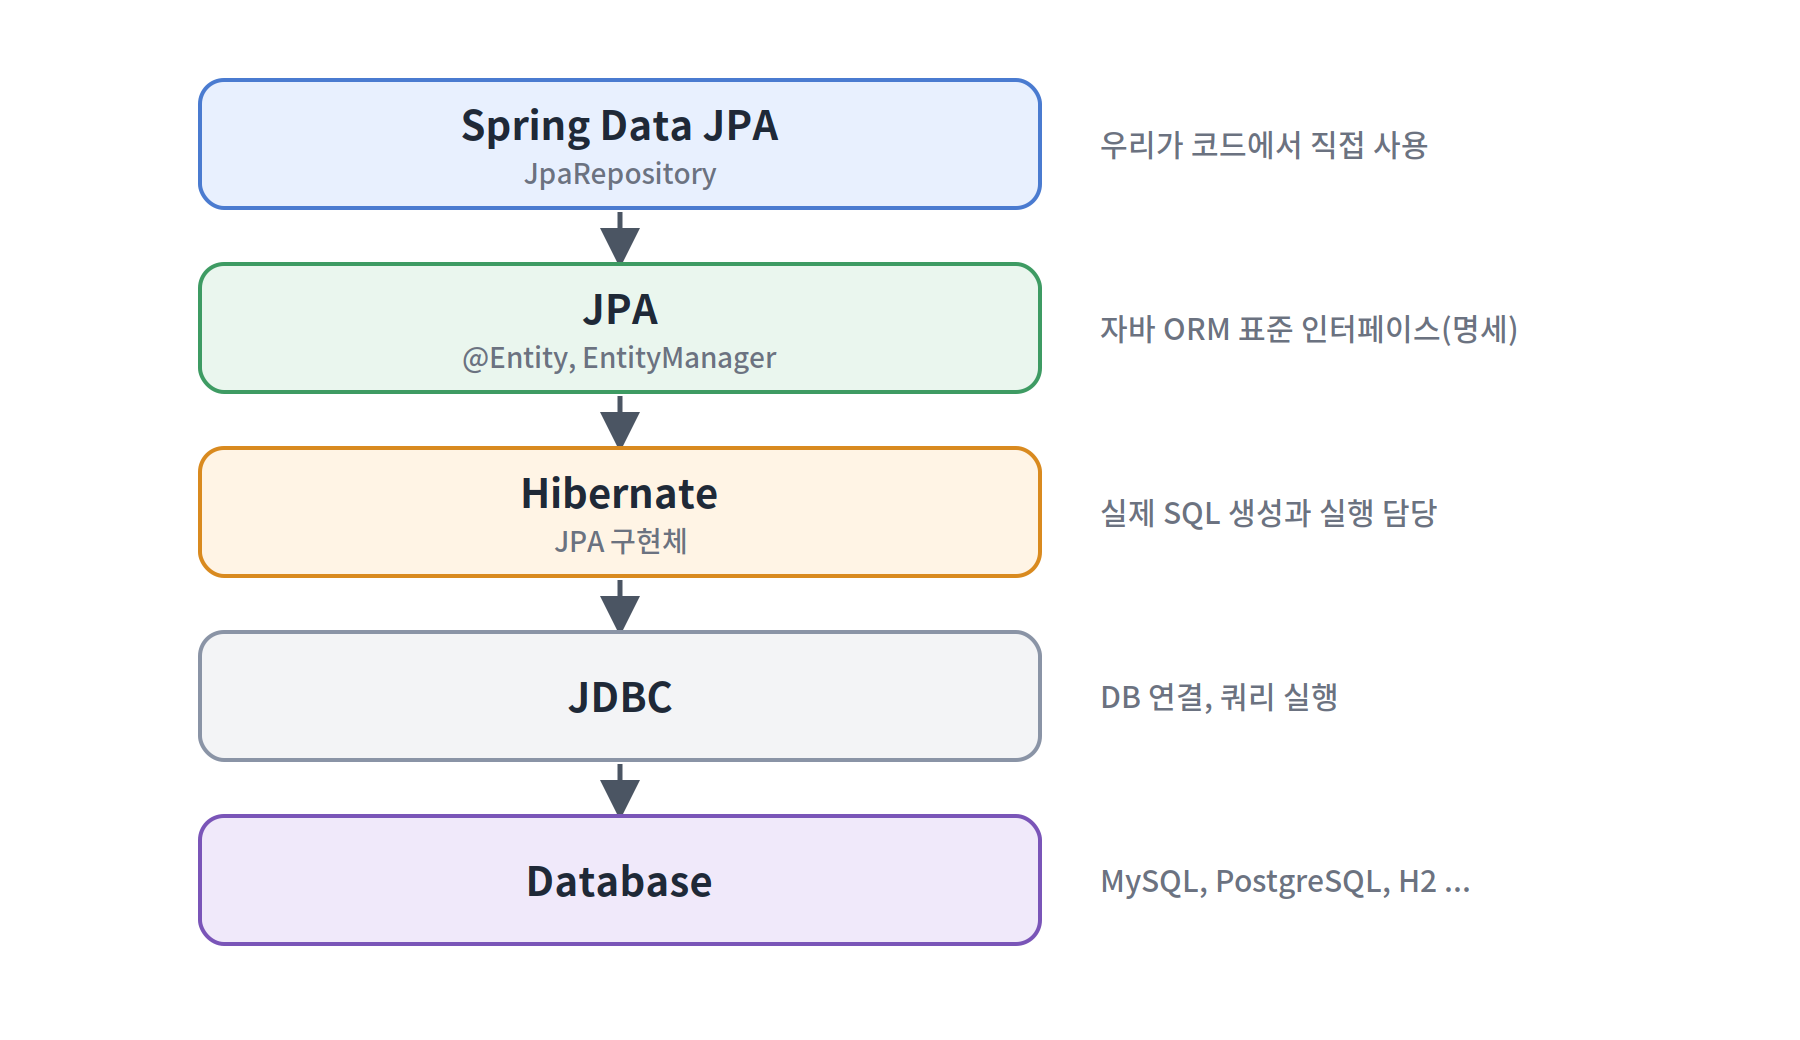
| JPA | 자바 ORM의 표준 명세(인터페이스 모음) |
| Hibernate | JPA 명세의 구현체, 사실상 표준 |
| Spring Data JPA | JPA를 더 쉽게 쓰게 해주는 Spring 모듈 (JpaRepository) |
List(인터페이스)와 ArrayList(구현체)의 관계를 떠올리면 JPA와 Hibernate의 관계가 쉽게 이해됩니다. @Entity, EntityManager는 JPA 것이고, 실제 SQL 생성은 Hibernate가 합니다.
3. 영속성 컨텍스트 (Persistence Context)
JPA를 한 문장으로 요약하면 "엔티티를 영속성 컨텍스트라는 공간에서 관리해주는 기술" 입니다. 이 개념만 이해하면 JPA의 동작 대부분이 설명됩니다.
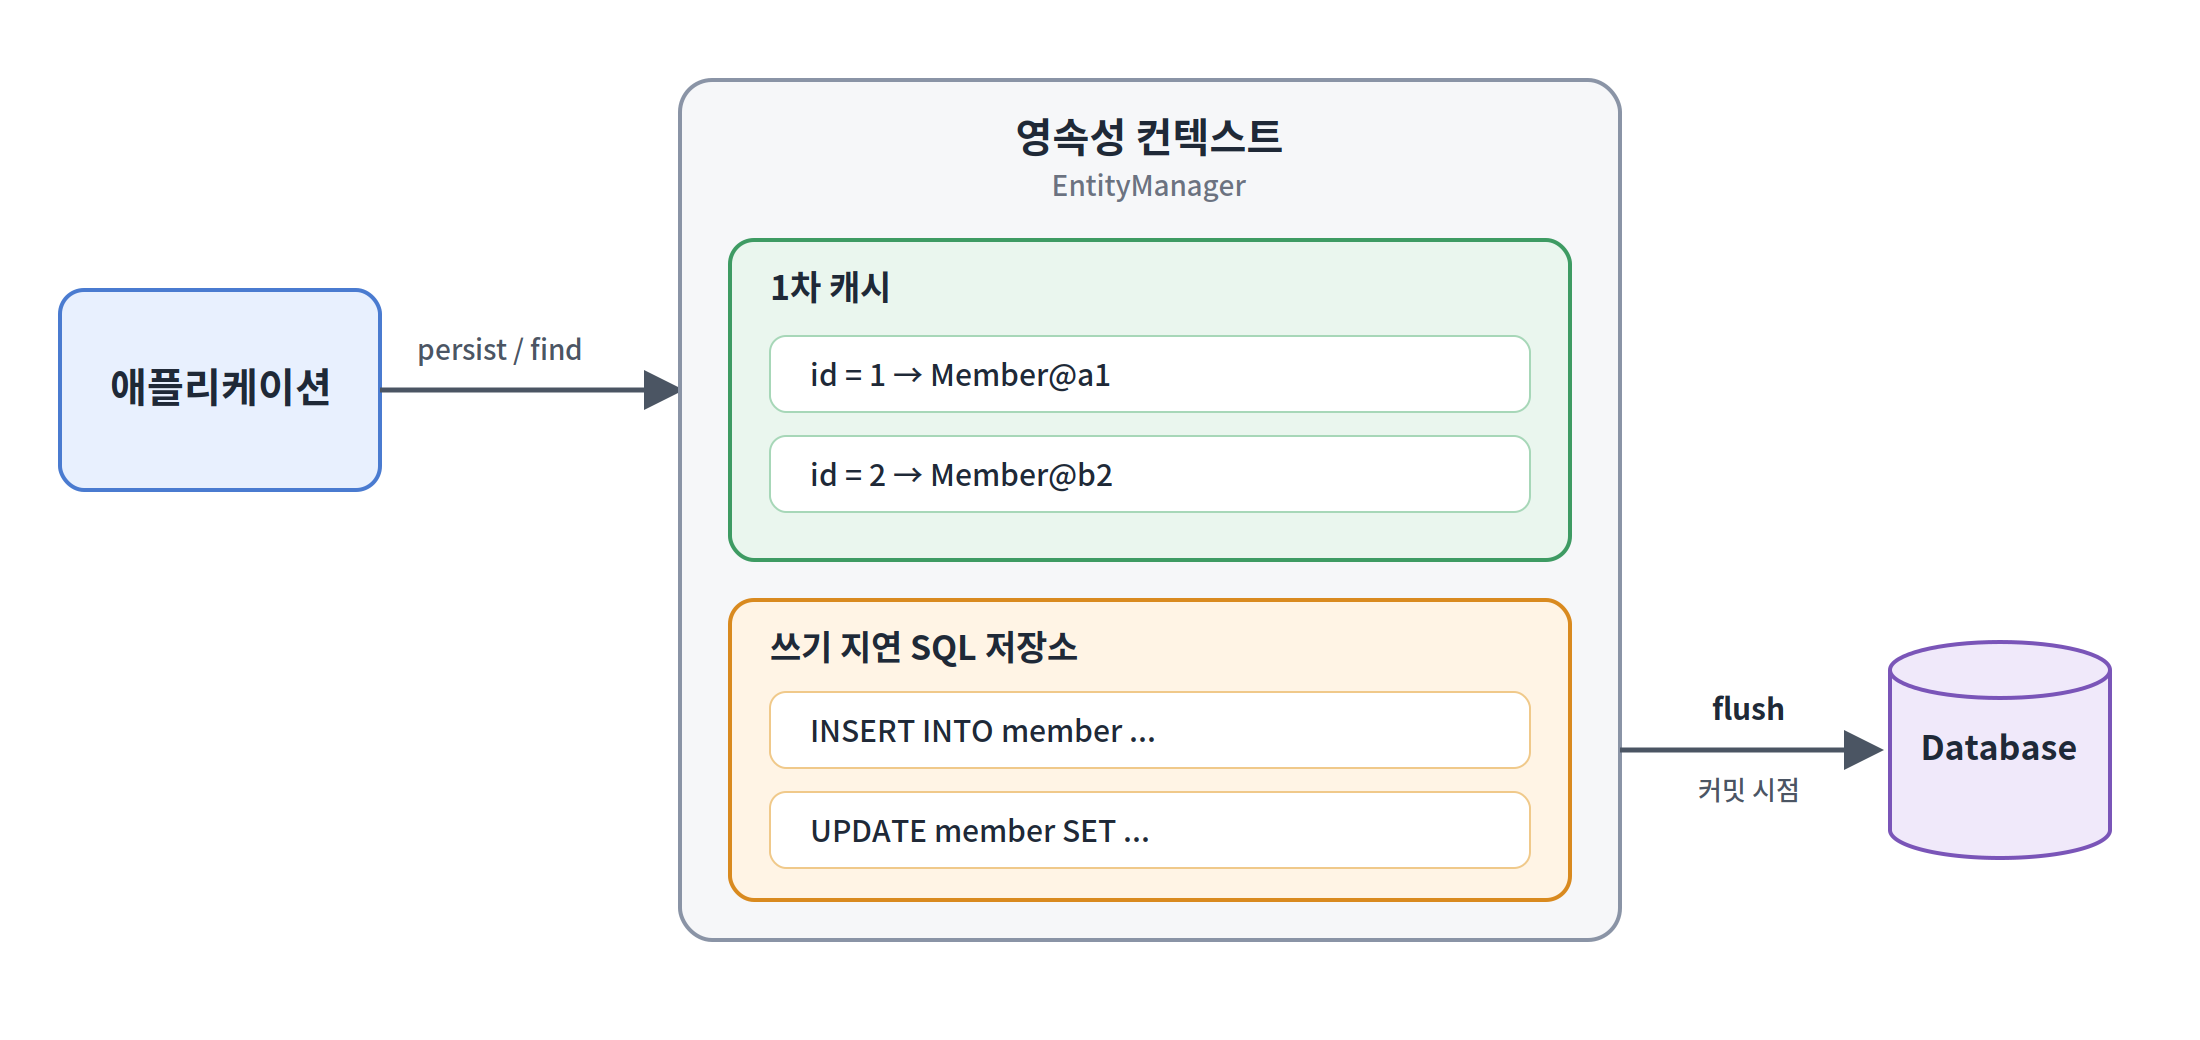
Spring에서는 보통 @Transactional 하나가 영속성 컨텍스트 하나와 대응합니다. 트랜잭션이 시작되면 생기고, 끝나면 사라집니다.
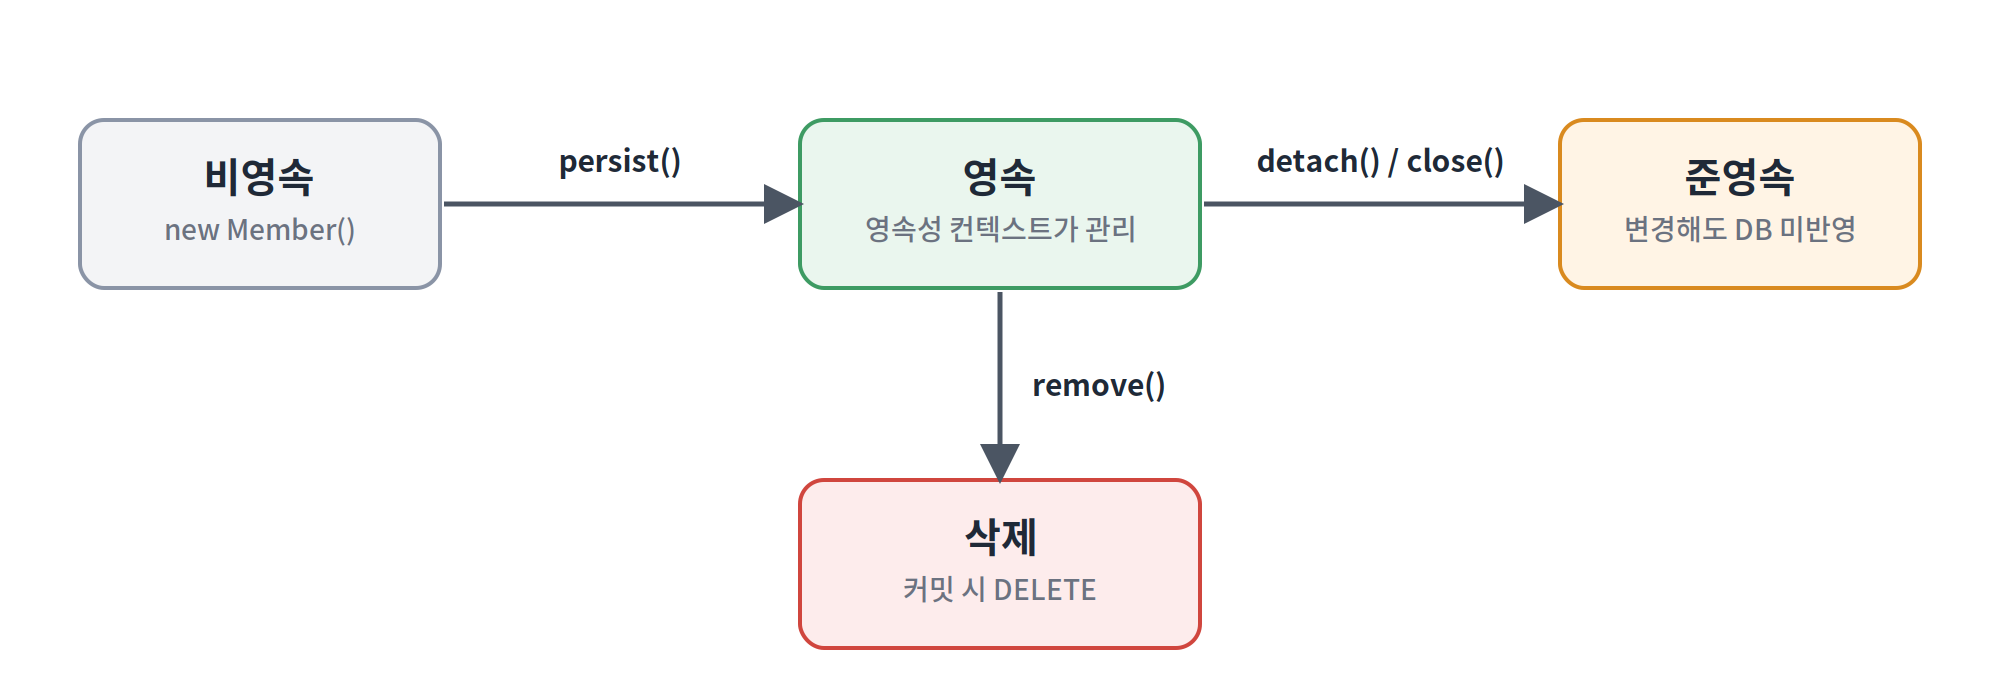
3-1. 엔티티의 생명주기
| 상태 | 설명 |
|---|---|
| 비영속 (new) | 객체를 생성만 했고 JPA와 무관한 상태 |
| 영속 (managed) | 영속성 컨텍스트가 관리 중인 상태 |
| 준영속 (detached) | 영속이었다가 분리된 상태. 값을 바꿔도 DB에 반영되지 않음 |
| 삭제 (removed) | 삭제가 예약된 상태 |
3-2. 영속성 컨텍스트가 주는 이점
① 1차 캐시와 동일성 보장
같은 트랜잭션에서 같은 id를 조회하면 DB를 다시 가지 않고 같은 인스턴스를 반환합니다.
Member a = em.find(Member.class, 1L);  // SELECT 실행
Member b = em.find(Member.class, 1L);  // 1차 캐시에서 반환 (쿼리 없음)
a == b;                                // true
② 변경 감지 (Dirty Checking) ⭐
Member member = em.find(Member.class, 1L);
member.changeName("new");   // save() 호출 없이도 UPDATE 실행
조회 시점의 스냅샷을 보관했다가, flush 시점에 현재 상태와 비교해서 달라졌으면 UPDATE를 자동으로 만들어 실행합니다. 그래서 영속 상태의 엔티티는 save()가 필요 없습니다.
③ 쓰기 지연
SQL을 바로 보내지 않고 저장소에 모아뒀다가 커밋 시점에 한 번에 전송합니다. 덕분에 batch 같은 최적화가 가능합니다.
IDENTITY전략은 INSERT를 해야 PK를 알 수 있어서persist()즉시 INSERT가 나갑니다. 이 경우 쓰기 지연의 이점이 줄어듭니다.
3-3. flush란?
영속성 컨텍스트의 변경 내용을 DB에 동기화하는 작업이고, 커밋과는 다릅니다.
- 발생 시점:
em.flush()직접 호출 / 트랜잭션 커밋 직전 / JPQL 실행 직전 - flush 후에도 커밋 전이면 롤백이 가능하고, 1차 캐시도 유지됩니다.
4. 연관관계 매핑
4-1. 연관관계의 주인
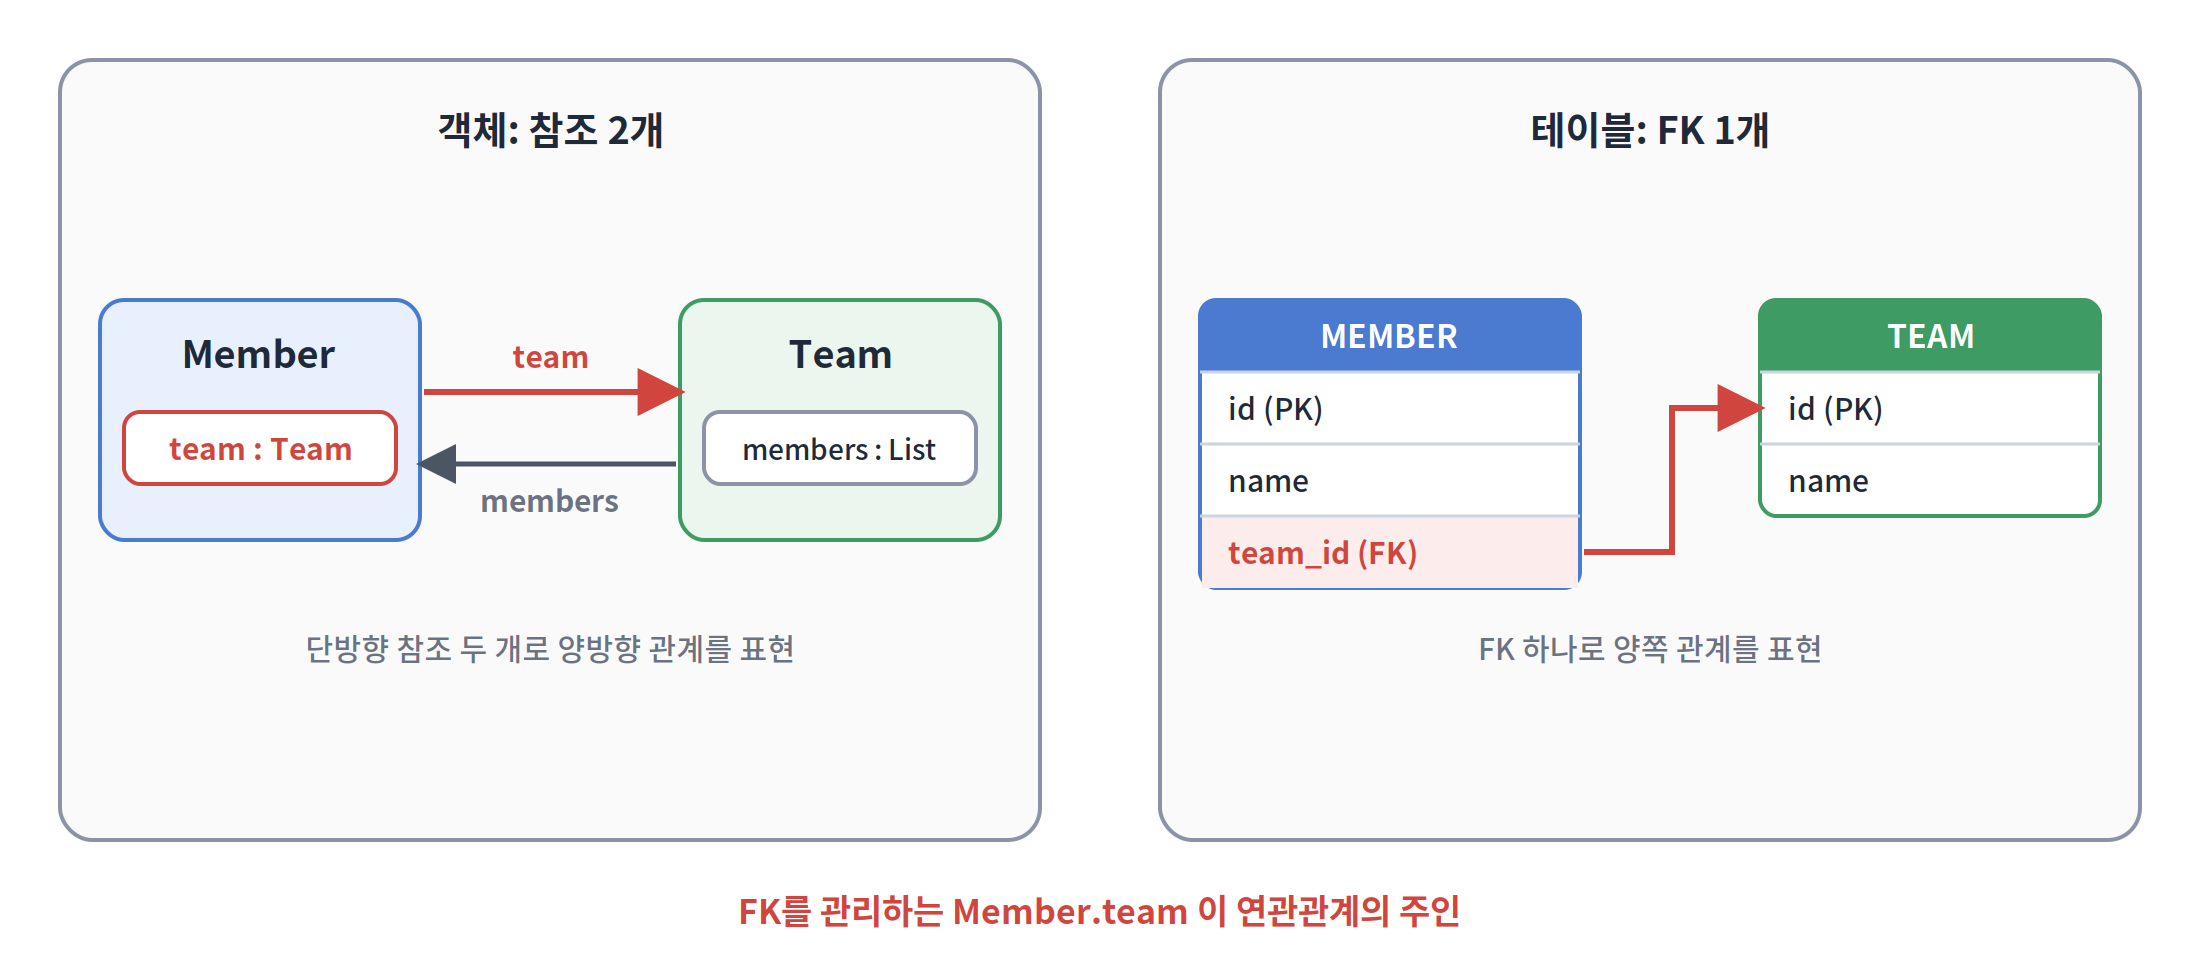
객체는 단방향 참조 두 개로 양방향 관계를 표현하지만, DB는 외래 키 하나로 양쪽을 표현합니다. 그래서 둘 중 FK를 관리할 쪽(주인) 을 정해야 합니다.
// Member(N) : Team(1)
@ManyToOne(fetch = FetchType.LAZY)
@JoinColumn(name = "team_id")        // FK를 가진 쪽 → 연관관계의 주인
private Team team;

@OneToMany(mappedBy = "team")        // 주인이 아님 → 읽기 전용
private List<Member> members = new ArrayList<>();- 주인:
@JoinColumn이 있는 쪽. 값을 바꾸면 DB에 반영됩니다. - mappedBy 쪽: 조회 전용. 값을 바꿔도 DB에 반영되지 않습니다.
- 기준: N:1 관계에서는 N(FK가 있는 쪽)이 주인입니다.
4-2. 지연 로딩과 즉시 로딩
| 방식 | 동작 |
|---|---|
| LAZY (지연 로딩) | 연관 엔티티를 실제로 사용할 때 조회 (프록시 객체로 대기) |
| EAGER (즉시 로딩) | 엔티티를 조회할 때 연관 엔티티도 함께 조회 |
@ManyToOne, @OneToOne은 기본값이 EAGER라서, 실무에서는 모든 연관관계를 LAZY로 지정하고 필요할 때만 함께 조회하는 방식을 권장합니다. EAGER는 예상하지 못한 쿼리를 만들어내기 쉽기 때문입니다.
4-3. N+1 문제
JPA를 쓰다 보면 가장 먼저 만나는 성능 문제입니다.
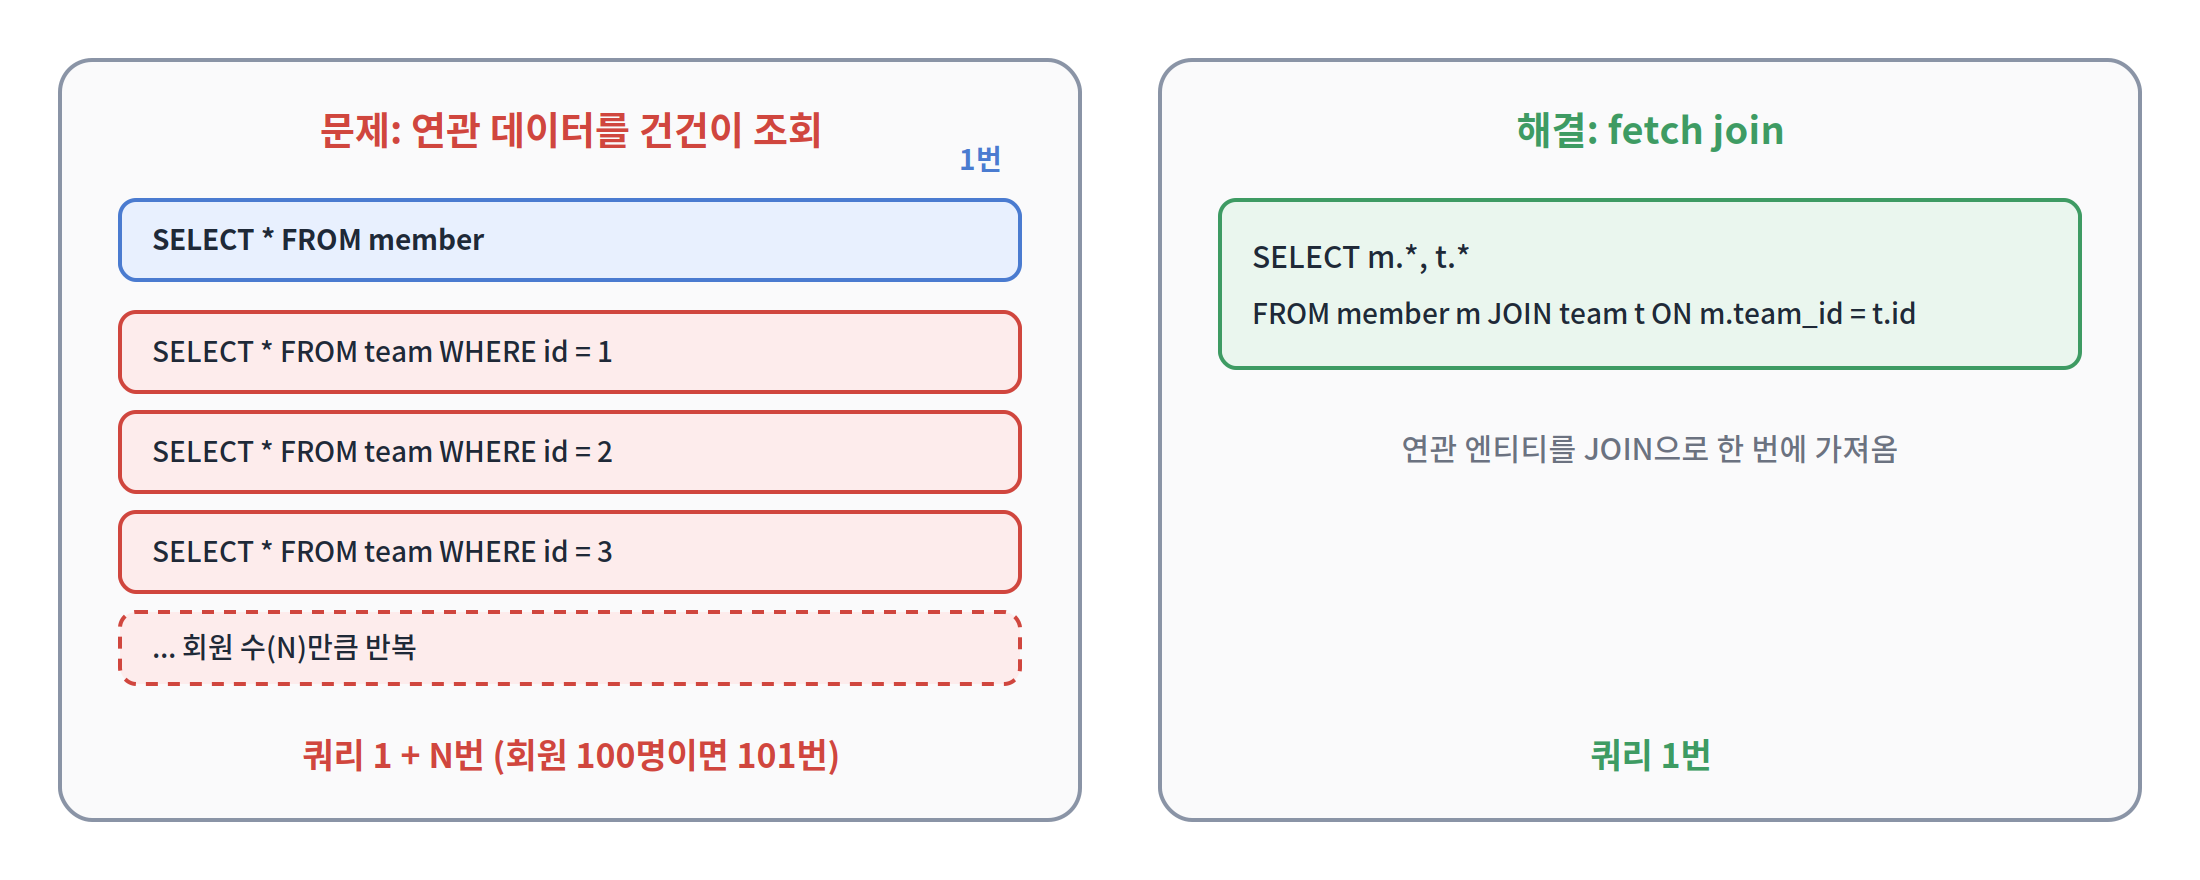
List<Member> members = memberRepository.findAll();   // 쿼리 1번 (회원 N명 조회)

for (Member m : members) {
    m.getTeam().getName();                            // 회원마다 Team 조회 쿼리 추가 → N번
}
회원 100명이면 쿼리가 1 + 100번 나갑니다. LAZY든 EAGER든 연관 데이터를 한 번에 가져오지 않으면 발생합니다.
해결 방법
| 방법 | 설명 |
|---|---|
| fetch join | JPQL에서 join fetch로 연관 엔티티를 한 번의 쿼리로 함께 조회 |
| @EntityGraph | 메서드에 붙여서 fetch join과 같은 효과 |
| batch size | default_batch_fetch_size 설정으로 N번을 IN 쿼리 몇 번으로 줄임 |
5. 정리
| 개념 | 한 줄 요약 |
|---|---|
| ORM | 객체와 테이블의 간극을 메워주는 기술 |
| JPA / Hibernate | 자바 ORM의 표준 명세 / 그 구현체 |
| 영속성 컨텍스트 | 엔티티를 관리하는 공간. 1차 캐시, 변경 감지, 쓰기 지연을 제공 |
| 연관관계의 주인 | FK를 관리하는 쪽. N:1에서는 N쪽 |
| N+1 문제 | 연관 데이터를 건건이 조회하는 문제. fetch join 등으로 해결 |
다음 글에서는 직접 엔티티와 Repository를 만들어보면서 사용법을 정리해보겠습니다.