[Python] 웹크롤링 - BeautifulSoup 활용
BeautifulSoup
-
BeautifulSoup 이란?
: HTML, XML 코드 전체를 대상으로 데이터를 읽어오는 라이브러리
: 라이브러리 사용을 위해서는 cmd 혹은 jupyter notebook 상에서 라이브러리 설치 필요예) cmd => pip list; pip install bs4
jupyter notebook => !pip list; !pip install bs4 -
HTML Parsing
: BeautifulSoup 객체를 생성하는 과정에서 페이지가 파싱(구문분석)된 데이터가 반환됨
: 파싱 후에는 원하는 태그 정보, 속성으로 검색이 가능예) html = browser.page_source => #html 전체 소스 문자로 저장
soup = BeautifulSoup(html, 'html.parser') => #객체 생성 -
BeautifulSoup 활용 웹 데이터 추출
1) find()
: html 코드 안에서 조건을 만족하는 태그 하나를 추출
: 조건을 만족하지 않으면 아무것도 추출되지 않고, 조건을 만족하는 태그가 여러 개 존재할 경우 첫번째 태그 1개만 추출
: 인자로 태그명을 전달하거나 태그명과 속성을 함께 전달할 수 있음예) soup.find('li')
soup.find('li', class_='quickResultLstCon')
soup.find('p', align = 'left')2) find_all()
: html 코드 안에 해당 조건을 만족하는 태그가 여러 개 있을 경우, 한번에 모두 가져옴
: 결과는 리스트로 반환
: 여러 개 태그를 한번에 찾고자 할때 태그를 리스트에 넣어 인자 전달예) soup.find_all('p')
soup.find_all(['p', 'a'])3) select()
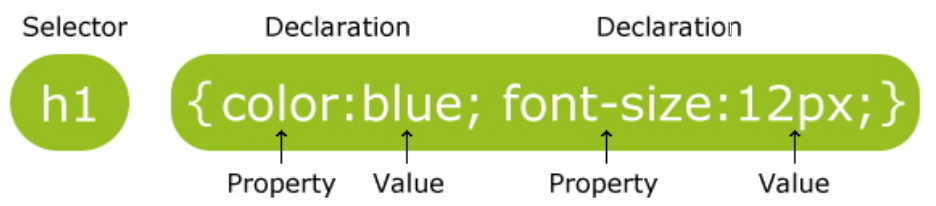
: css_selector는 html 등의 마크업 언어로 작성된 문서의 특정 요소를 찾을 수 있으며 태그명, #아이디, .클래스로 찾는 세가지 방법이 있음
: 상위태그부터 하위태그로 내려오면서 찾고자 하는 태그를 구체화할 수 있음
: 태그명[속성 = 속성값] 으로 찾고자 하는 태그를 구체화할 수 있음- css_selector를 이용하여 찾는 경우
soup.select('p')
soup.select('#name')
soup.select('.quickResultLstCon')
soup.select('li.quickResultLstCon') - 태그명과 속성값을 특정하여 찾는 경우
soup.select('a[href]') => href 속성을 가진 a 태그 - 상위태그 > 중위태그 > 하위 태그 (공백 주의할 것)
soup.select('div > p > span')
soup.select('ul.quickSearchResultBoxSidoGugun > li.quickResultLstCon')
soup.select('#fruits > span.store')
- css_selector를 이용하여 찾는 경우
📌 위의 세가지 방법을 통해 태그정보를 추출하면 태그의 속성값과 텍스트값이 모두 저장됨
4) 태그의 텍스트 데이터 추출
: 태그 정보를 추출한 뒤 태그 사이의 텍스트를 추출할 수 있음
- .string
- .text
- .get_text()
