선정 이유
SVG generation LLM 연구 세미나에서 VLM 점수를 보상으로 사용하신 것을 보고 VLM이 이미지를 어떻게 이해하는지(이 보상함수로 디테일에 대한 점수를 주는 것이 가능한 것인지) 모델 내부 구조가 아닌 실제 사례로 이해해보고 싶었다.
Background
-
최근 GPT-4o, Gemini-1.5 Pro와 같은 최첨단 VLM들은 다양한 Vision-Language 벤치마크에서 뛰어난 성능을 보이며 이미지-텍스트 처리 능력에서 좋은 성과를 이룸. 이 모델들은 객체 식별, 복잡한 추론 기반 작업, 심지어 특이한 이미지 활동 설명까지 가능함.
-
BUT, 저자들은 기존 VLM 벤치마크들이 대부분 고수준의 시각/비시각적 능력을 평가하며, 상당수의 문제에서 이미지가 없이 텍스트 질문만으로 답을 유추하거나 인터넷 학습 데이터를 암기하여 답하는 'data leakage' 문제에 취약하다고 지적함.
→ VLM의 진정한 시각 능력을 독립적으로 측정하는 벤치마크의 부재
-
저자들은 VLM이 인간에게는 매우 쉬운 Geometric primitives (선, 원, 사각형 등)와 관련된 low-level vision tasks에서 정확한 spatial information을 요구할 때 어려움을 겪을 것이라는 가설을 세움.
-
특히, 도형들이 서로 겹치거나(overlapping) 매우 가깝게 위치할 때 VLM의 성능이 저하될 것이라고 주장.
→ VLM의 "late fusion" 메커니즘 때문일 수 있음. 즉, Vision Encoder가 시각적 특징을 추출한 후 이를 Language Model에 전달하는 과정에서, 자연어로 정확히 묘사하기 어려운 미세한 시각 정보가 제대로 디코딩되지 못해 정확한 언어적 출력을 생성하지 못한다는 것.
-
Purpose
이 논문의 궁극적인 목표는 1) VLM의 저수준에서의 시각 능력 한계를 정확하게 규명하고, 2) 새로운 벤치마크를 제시하며 3) 실패 원인을 밝히는 것
Method
- VLM의 저수준 시각 능력을 평가하기 위해 BlindTest라는 새로운 벤치마크를 설계함.
[평가 대상 VLM]
- 상용 VLM: GPT-4o, Gemini-1.5 Pro, Claude-3 Sonnet, Claude-3.5 Sonnet
- 오픈소스 VLM: LLaVA OneVision-qwen2, Phi-3.5-vision-instruct, InternVL-2, Qwen2-VL
- Slow-thinking VLM: Gemini 2.0 Flash-Thinking, QVQ-Preview (일반 VLM과의 비교를 위해 사용).
[BlindTest 벤치마크 설계]
- 목표: 기존 VLM 벤치마크의 'data leakage' 문제를 피하고, 지식이나 추론 없이 순수하게 VLM의 저수준 시각 인지 능력(특히 Geometric primitives에 대한 이해)을 평가.
- 인간의 시력 테스트에서 영감을 받아 단순하지만 정밀한 시각 과제들을 고안.
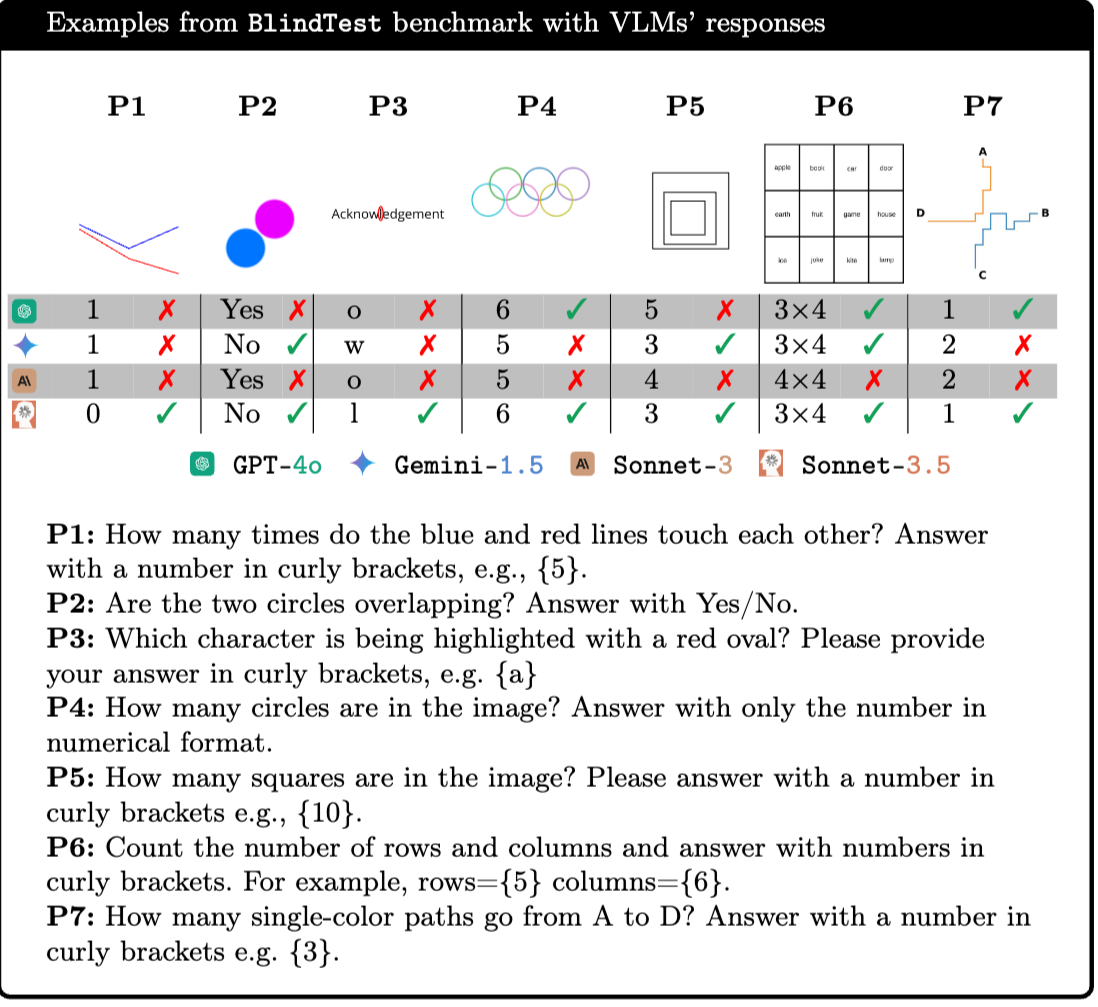
- Task 구성: 총 7가지의 독립적인 시각 Task로 구성됨.
- Task 1: Counting line intersections - 두 개의 2D piece-wise linear functions (꺾은선 그래프)의 교차점 개수 세기 (0, 1, 2개).
- 이미지 생성: 1,800개 이미지 (CxC, C in {384, 768, 1152}px).
- 선 두께 및 두 그래프 간의 평균 거리 변화.
- Task 2: Two circles: 두 개의 동일한 크기 원이 겹치거나 접촉하는지 여부 판단 (Yes/No).
- 이미지 생성: 768개 이미지 (CxC, C in {384, 769, 1155}px).
- 원 직경, 원 간의 경계-경계 거리 변화 (겹침, 접촉, 분리). 네 가지 방향 배열.
- Task 3: The circled letter: 단어 내에서 빨간색 원으로 둘러싸인 문자가 무엇인지 식별.
- 이미지 생성: 약 1,248개 이미지.
- 세 가지 다른 단어(Acknowledgment, Subdermatoglyphic, tHyUiKaRbNqWeOpXcZvM).
- 원의 선 두께, 폰트 종류, 이미지 패딩 변화.
- Task 4: Counting overlapping shapes: 올림픽 로고처럼 겹쳐진 원 또는 오각형의 개수 세기 (5, 6, 7, 8, 9개).
- 이미지 생성: 480개 이미지 (CxC, C in {384, 769, 1155}px).
- 도형 직경/변 길이, 선 두께, 색상, 수직 뒤집기 변화.
- Task 5: Counting the nested squares: 중첩된 사각형의 개수 세기 (2, 3, 4, 5개).
- 이미지 생성: 120개 이미지 (1000x1000px).
- 선 두께, 사각형 위치 변화.
- Task 6: Counting the rows and columns of a grid: 그리드의 행과 열 개수 세기
- 이미지 생성: 264개 이미지 (CxC, C in {500, 1250, 2000}px)
- 선 두께, 빈 그리드 또는 텍스트 포함 그리드.
- Task 7: Following single-colored paths: 단순화된 지하철 노선도에서 두 특정 역 (A, B, C, D) 사이의 단색 경로 개수 세기.
- 이미지 생성: 180개 지도 이미지 (CxC, C in {512, 1024}px)
- 각 역에서 나가는 경로의 개수 변화 (1, 2, 3개).
→ 각 Task별로 두 가지의 의미론적으로 동등한 질문(Prompt)을 사용하여 VLM에 질의하고 평균 정확도를 측정.
[평가 및 분석 방법]
- 각 VLM의 응답에서 최종 답을 추출하여 Ground Truth와 비교하고, 평균 Accuracy를 주요 지표로 사용.
- 이미지 해상도, 선 두께, 도형 간의 거리, 색상 등 다양한 이미지 생성 하이퍼파라미터가 VLM 정확도에 미치는 영향을 분석.
[추가 제어 실험]
- Task 단순화
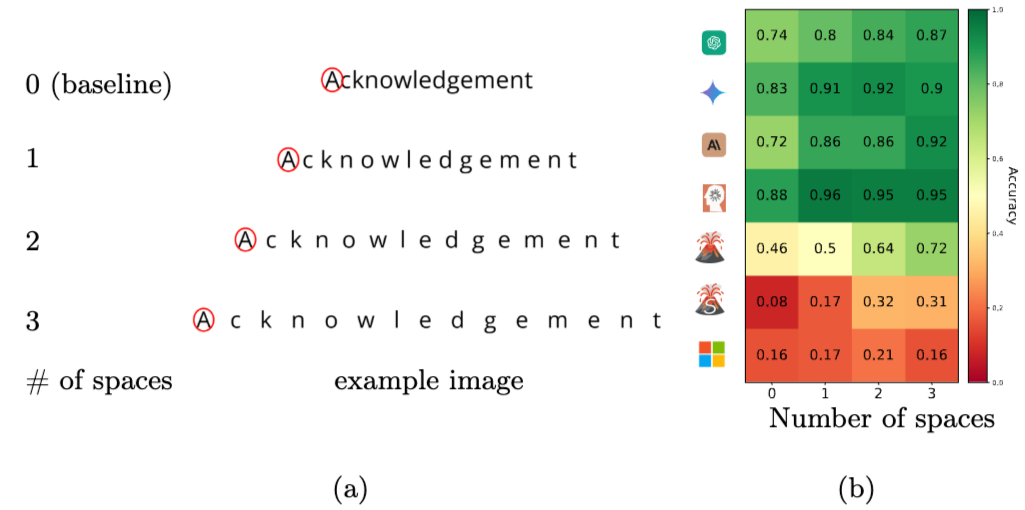
- Circled letter Task: 인접한 문자 사이에 ASCII Space를 추가하여 간격을 넓힘.
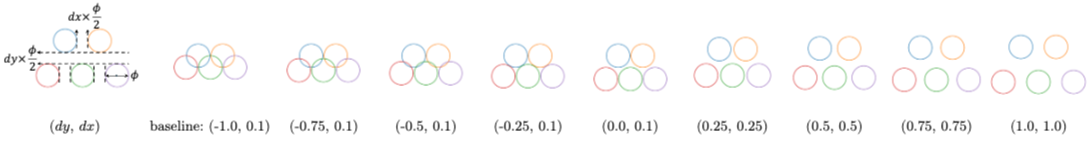
- Overlapping shapes Task: 도형 간의 겹치는 영역을 줄이고(X, Y축 방향으로 간격 증가) 도형을 서로 더 멀리 떨어뜨림.
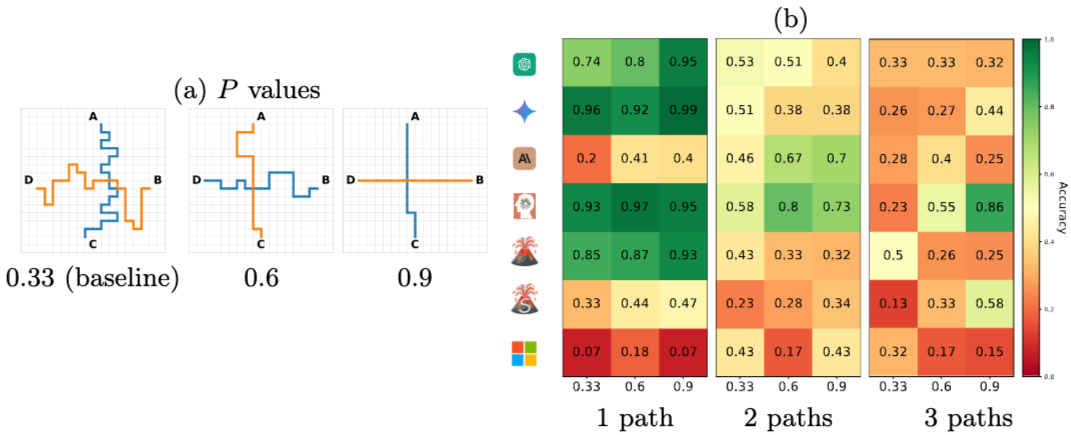
- Path tracing Task: 경로의 꺾이는 횟수를 줄여 더 직선적인 경로를 생성 (Straight 방향 선택 확률 P 증가).
→ 도형/문자가 서로 가깝거나 겹칠 때 발생하는 'blurry'한 시각이 문제의 원인인지 확인.
- Vision Encoder 정보 포함 여부 분석(Linear probing):
- 가장 작은 오픈소스 VLM인 LLaVA-OneV-S (Vision Encoder: SigLIP) 및 Phi-3.5 (Vision Encoder: CLIP) 사용.
- "Two circles" 및 "Counting line intersections" Task에 대해 수행 (각각 11,100개, 6,300개의 대규모 데이터셋 생성).
- Vision Encoder의 Projection 레이어 이전과 이후의 이미지 패치 피처를 Average Pooling.
- 고정된 특징 위에 Logistic Regression Linear Classifier를 학습 (1,000 epoch, L2 regularization).
- Linear Classifier의 정확도를 측정하여 Vision Encoder와 Projection Layer에 Task 해결에 필요한 정보가 충분히 포함되어 있는지 확인.
→ Vision Encoder가 필요한 시각 정보를 실제로 추출하는지, 아니면 정보 손실이 발생하는지 파악.
Experiment
[BlindTest 벤치마크 전반적인 성능]
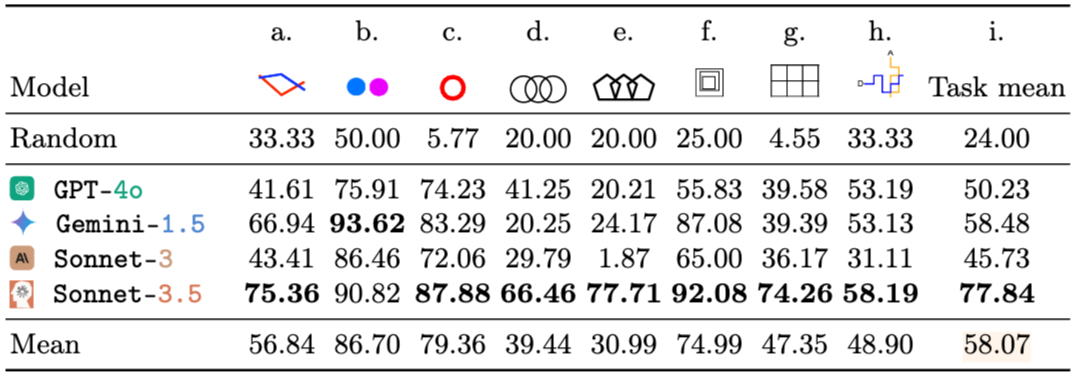
- 4가지 최첨단 상용 VLM (GPT-4o, Gemini-1.5 Pro, Claude-3 Sonnet, Claude-3.5 Sonnet)은 7가지 BlindTest Task에서 평균 58.07%의 정확도에 그침. 이는 기대보다 매우 낮은 수치.
- Sonnet-3.5가 77.84%로 가장 좋은 성능을 보였음.
- VLM이 ChartQA나 DocVQA 같은 기존 고수준 벤치마크에서 90% 이상의 높은 정확도를 보이는 것과 극명한 대조를 이룸.
[BlindTest 개별 Task별 VLM 성능]
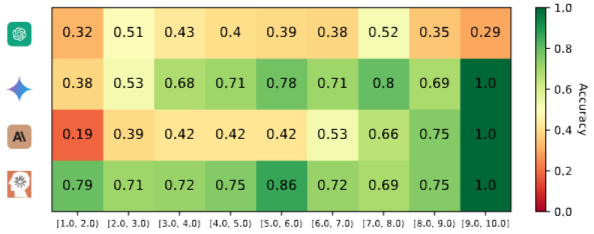
- Task 1: Counting line intersections (두 선 교차점 세기)
-
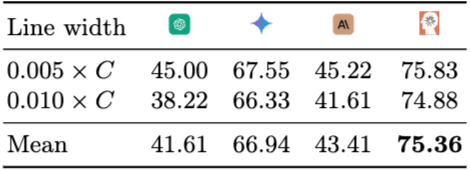
평균 acc: 56.84%. Sonnet-3.5가 75.36%로 가장 높았음.
-
두 선이 가까워질수록 VLM의 성능이 저하되는 경향을 보였음.
→ VLM이 전체적인 추세는 인식하지만 세부적인 교차점 식별에는 어려움을 겪음.
- Task 2: Two circles (두 원 겹침/접촉 여부)
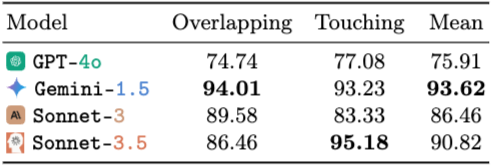
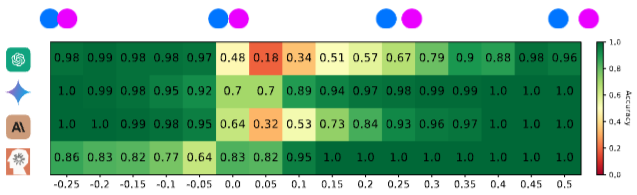
- 평균 acc: 86.70%. Gemini-1.5가 93.62%로 가장 높았으나, 완벽하지는 않음.
- 주요 관찰: 두 원이 접촉하거나(tangent) 매우 가까이 있을 때 (d=0.0 또는 d=0.05, 0.1) VLM의 성능이 특히 저조했음.
→ 작은 간격이나 겹침을 정확히 감지하지 못함.
- Task 3: The circled letter (원에 둘러싸인 문자 식별)
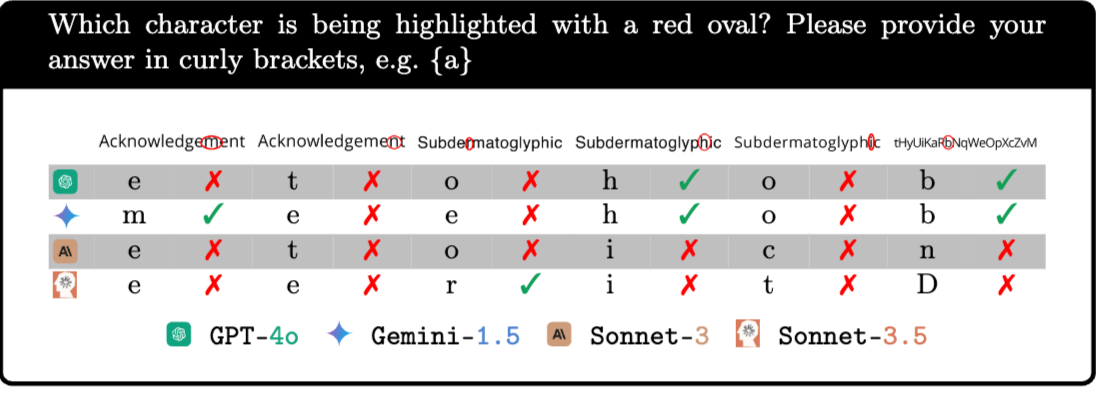
- 평균 acc: 79.7%. Sonnet-3.5 (87.88%)와 Gemini-1.5 (83.29%)가 상위권을 차지.
- VLM은 단어 자체는 완벽하게 읽을 수 있었지만, 원 안에 있는 문자를 식별하는 데 어려움을 겪었음.
- 오답 시 인접한 문자를 예측하는 경향이 있었고, 때로는 존재하지 않는 문자를 환각(hallucinate)하기도...
- 익숙한 단어 -> 약간의 정확도 향상
- Task 4 & 5: Counting overlapping/nested shapes (겹치거나 중첩된 도형 세기)
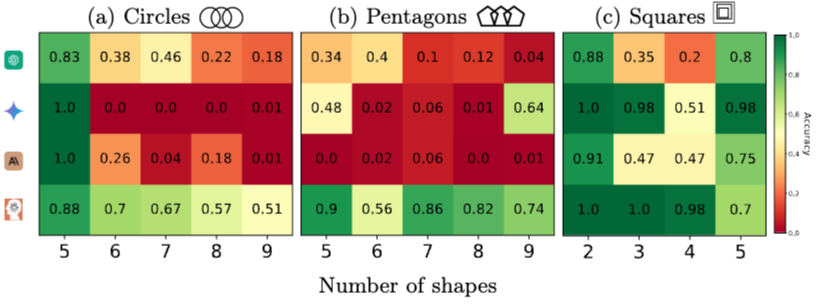
- 평균 acc: 겹쳐진 원 39.44%, 겹쳐진 오각형 30.99%, 중첩된 사각형 74.99%.
- 5개 이상의 도형을 셀 때 정확도가 급격히 떨어지는 경향을 보임.
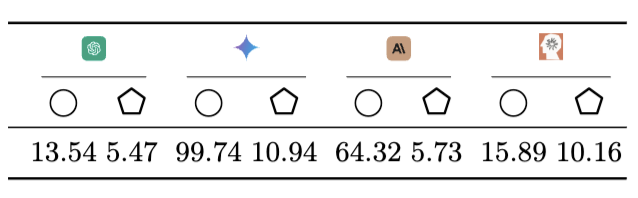
- 특히 겹쳐진 원의 경우, Gemini-1.5는 실제 개수와 상관없이 "5"를 예측하는 강한 올림픽 로고 편향(bias)을 보임.
-
n = 6, 7, 8, 9에서 5로 예측한 빈도
+) 이러한 '데이터에 의한 편향' 연구는 저자들의 다음 논문에 나와있음(Vision Language Models are Biased)
-
중첩된 사각형도 2~3개라는 적은 개수에서도 GPT-4o와 Sonnet-3은 100% 정확도를 달성하지 못함.
- Task 6: Counting the rows and columns of a grid (그리드의 행/열 세기)
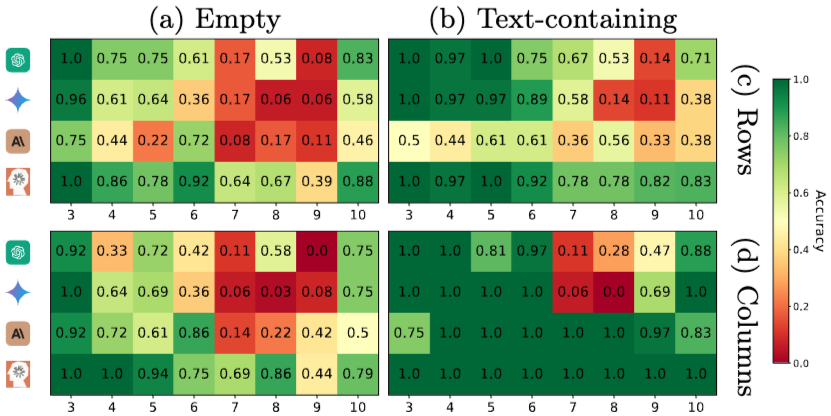
- 빈 그리드에서 평균 정확도: 34.37%.
- 빈 그리드에서는 VLM이 행과 열을 세는 데 매우 서툴렀음.
- 각 셀에 텍스트가 포함되면 정확도가 거의 두 배로 향상됨.
→ 이는 VLM이 테이블의 '내용'을 통해 추론하는 능력이 강함을 시사. 또한, 행(60.83%)보다 열(70.53%)을 세는 데 더 정확했음.
- Task 7: Following single-colored paths (단색 경로 추적)
- 평균 정확도: 48.90%.
- 경로의 꺾이는 횟수가 증가할수록 정확도가 크게 감소. VLM은 1~3개의 경로를 정확히 세는 데 어려움을 겪었으며, 예측 오차가 1~3개에 달하는 경우가 많았음.
- Slow-thinking VLM의 경우?
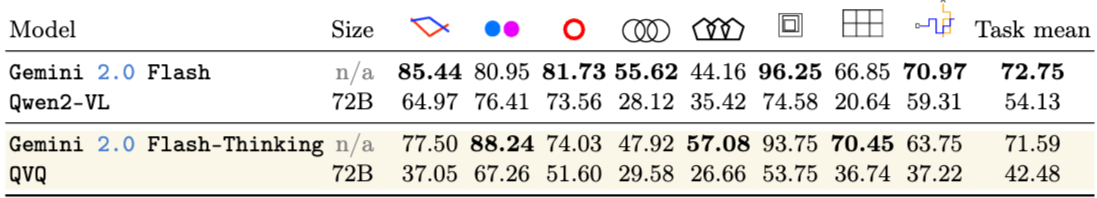
- Gemini 2.0 Flash-Thinking과 QVQ-Preview 같은 "slow-thinking" 모델은 일반 VLM보다 성능이 유사하거나 오히려 저조했음 (Gemini 2.0 Flash-Thinking은 71.59% vs. Gemini 2.0 Flash 72.75%).
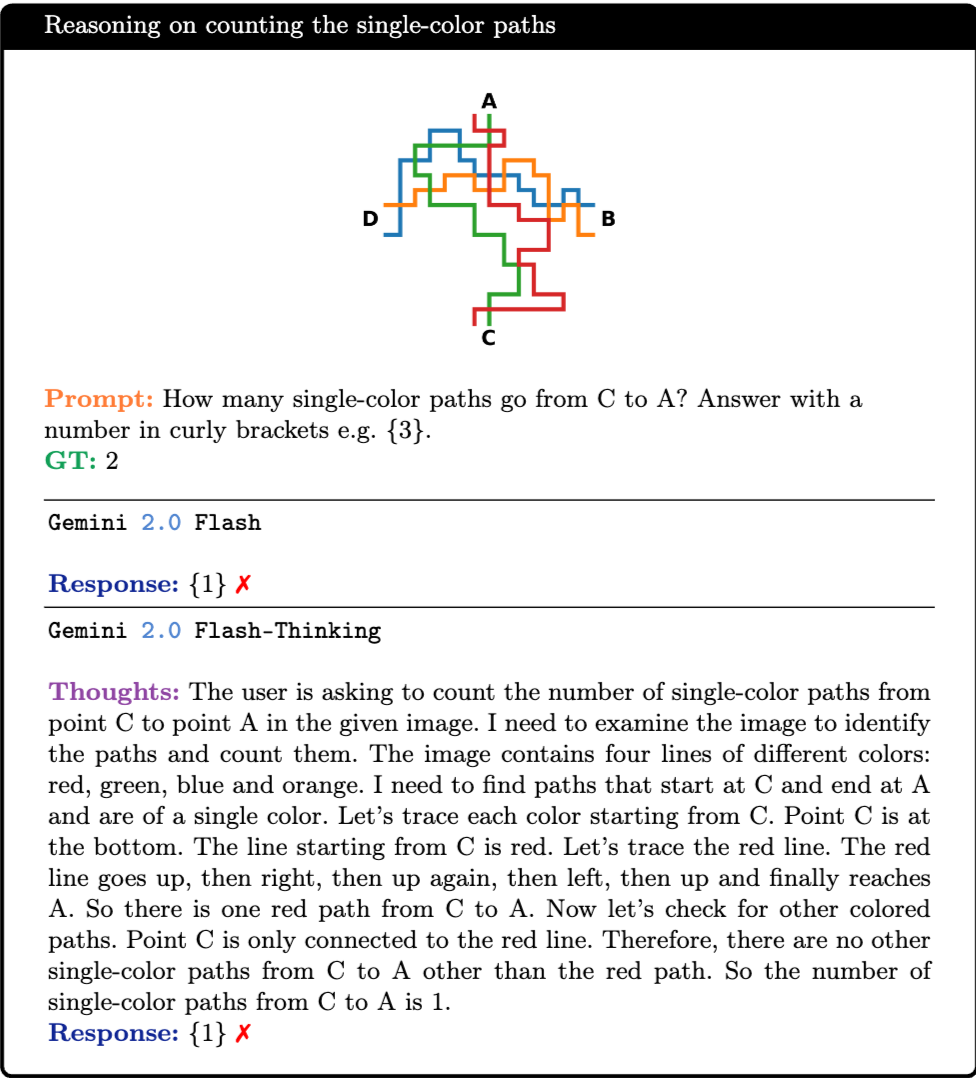
→ 심층적 추론이 BlindTest와 같은 저수준 시각 Task에는 도움이 되지 않으며, VLM의 '시각' 자체의 문제임!
[Task 단순화 실험 결과]
- 도형, 문자, 경로 사이에 더 많은 공간을 추가하거나 시각적 복잡도를 줄이자 VLM의 정확도가 크게 향상.
- VLM의 '맹점'이 시각적 요소의 근접성 또는 중첩성에서 비롯됨
- Circled letter: 문자 사이에 공간을 추가하자 모든 VLM의 정확도가 향상되었고, Sonnet-3.5는 95%까지 도달.
- Overlapping shapes: 도형 간의 겹침 영역을 줄이고 간격을 늘리자 Sonnet-3.5는 원과 오각형 세기 Task에서 100%에 가까운 정확도를 달성.
- Single-colored paths: 경로의 꺾이는 횟수를 줄이자 (더 직선적인 경로) VLM의 정확도가 크게 향상되었고, 일부 모델은 1개의 직선 경로에서는 거의 100%에 가까운 정확도를 보였음.
[Vision Encoder Linear Probing 결과]
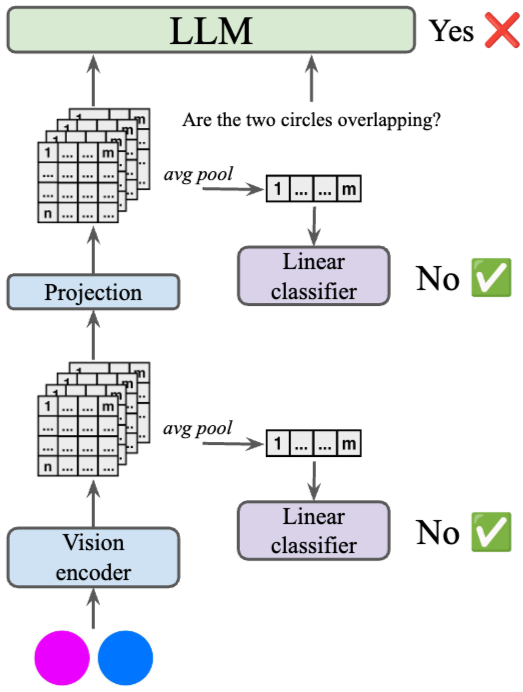
- 오픈소스 VLM (LLaVA-OneV-S의 SigLIP, Phi-3.5의 CLIP)의 Vision Encoder에서 추출된 특징은 "Two circles" 및 "Counting line intersections" Task를 해결하는 데 필요한 충분한 정보를 이미 포함하고 있었음.
- Linear Classifier를 이 특징 위에 학습시켰을 때, 투영 레이어 이전과 이후 모두에서 99.47% 이상의 정확도를 달성.
→ VLM의 Vision Encoder가 시각 정보를 성공적으로 포착하지만, Language Model이 이 정보를 정확한 언어 출력으로 디코딩하는 데 실패.
→ 즉, VLM은 "시각" 자체의 문제가 아니라 "시각 정보를 언어로 번역하는" 과정에서의 bottleneck 현상을 겪고 있음.
Key point
- 최첨단 VLM이 기존의 복잡한 벤치마크에서는 뛰어난 성능을 보이지만, 인간에게는 매우 쉬운 저수준 시각 Task에서 정밀한 시각 정보를 처리하는 데 심각한 맹점을 보임.
- 논문이 제안한 "BlindTest" 벤치마크에서 VLM의 평균 정확도는 58.07%에 불과하며, "slow-thinking" 모델조차 실패함.
- 가장 결정적인 발견은 VLM의 Vision Encoder가 이러한 저수준 시각 Task를 해결하는 데 필요한 충분한 정보를 이미 가지고 있다는 것.
- BUT, 문제는 Language Model이 Vision Encoder가 추출한 정밀한 시각 정보를 올바른 언어 출력으로 디코딩하는 데 실패했다는 것.
- 이미지 내 시각적 요소들 사이에 공간을 더 추가하거나 시각적 복잡성을 줄이자 VLM의 정확도가 향상됨.
- VLM의 맹점이 시각적 요소들이 너무 가깝거나 겹칠 때 발생하는 '블러리'한 인지에서 비롯됨
- 이러한 저수준 시각 '맹점'때문에 지도 읽기, 차트 해석 등 정밀하고 미세한 시각 정보를 요구하는 실제 과제에서 어려움을 겪을 수 있음
- VLM 연구가 Vision Encoder가 포착한 상세하고 정밀한 저수준 시각 정보를 Language Model이 언어로 정확하게 번역하고 디코딩하는 능력에 초점을 맞춰야 할 필요성을 강조.
Limitations and Suggestions
- 저자들은 일반적인 프롬프트 엔지니어링 기법(CoT 등)을 시도했지만 더 나은 정확도를 얻지 못했다고 언급했지만 다른 프롬프팅 전략이 잠재적으로 VLM 성능에 영향을 미칠 수 있다는 가능성이 있음.
- Linear probing 실험은 Vision Encoder가 충분한 시각 정보를 포함하는지 확인하기 위해 LLaVA-OneV-S 및 Phi-3.5와 같은 오픈소스 VLM에 대해서만 수행됨. 이러한 결과가 더 큰 상용 VLM에도 동일하게 적용될 것이라고 가정했을 뿐...
- 논문은 BlindTest 벤치마크가 현실의 3D 객체, 자연 이미지 등에 대한 인식의 기초가 된다고 주장했지만 실제로 단순한 2D Geometric primitives에 대한 VLM의 시각 능력과 실제 사진 등의 처리 능력이 연관되어있는지는 아직 모름.
Personal Insight
- VLM이 복잡한 시나리오에서는 훌륭한 설명을 내놓지만, 두 원이 겹치는지, 선이 몇 번 교차하는지, 또는 원 안에 어떤 글자가 있는지와 같은 극도로 단순하지만 정밀한 시각 Task에서는 심각하게 실패한다는 점이 인상적.
- VLM의 "시각적 이해"를 너무 고수준의 개념에만 초점을 맞춰 평가해왔을 수 있음.
- Vision Encoder는 잘 보는데, Language Model이 말을 못한다는 논문의 Linear Probing 실험 결과는 정말 결정적임. 이후 VLM 연구의 초점을 Vision Encoder 자체의 개선보다는, 정밀한 시각-언어 Decoding과 Alignment 에 맞춰야 하지 않나.
- 도형이나 문자 사이에 공간이 조금만 생겨도 VLM의 정확도가 올라간다는 점은, VLM이 연속적인 시각 정보를 이산적인 언어적 개념으로 전환할 때 정밀성을 잃어버리는 본질적인 문제가 있음을 보여줍니다.
- 사람은 당연하게 여기는 겹침, 개수와 같은 공간 및 수량 개념이 VLM에게는 여전히 어려운 추상화 과정일 수 있다는 점.
- Task 6: Counting the rows and columns of a grid 에서 내용이 없는 그리드의 행과 열을 세지 못한다는 점이 와닿았음. 얼마 전에 크로스워드 퍼즐을 GPT-4o와 o3에게 맡겨봤을 때 글자수(칸수)를 세지 못하는 모습을 보여서... 이런 문제가 있었구나 싶은 깨달음!