통계학이란?
- 불확실한 상황에서 현명한 의사결정을 하기 위한 이론/방법의 체계(자료 수집-분류-분석-해석)
- 기본 용어
- 모집단(population) : 관심의 대상이 되는 모든 개체의 집합
- 모수(parameter) : 모집단의 특성을 수치로 나타낸 것
- 표본(sample) : 모집단에서 조사 대상으로 채택된 일부
- 통계량(statistics) : 표본의 특성을 수치로 나타낸 것
- 통계학의 종류
- 기술통계학(descriptive statistics) : 측정이나 실험에서 수집한 자료(data)의 정리, 요약, 해석, 표현 등을 통해 자료의 특성을 규명하는 통계학
- 추론통계학(inferential statistics) : 통계량을 분석하여 모집단의 특성(모수)을 규명하는 통계학
- 모수통계학(parametric statistics) : 모집단의 분포에 대한 가정이 필요하며, 분포에 대한 가정이 틀리지 않다면 비모수통계학보다 신뢰할 만한 결과를 제공한다.
- 비모수통계학(nonparametric statistics) : 모집단의 분포 모양에 대한 가정을 할 수 없거나, 표본의 크기가 작은 경우에 사용 가능하다.
변수와 자료
-
양적 변수(quantitative variable) : 수치로 나타낼 수 있는 변수로 산술적 계산이 가능하다.
- 이산형 변수(discrete variable) : 자식의 수, 책 판매 매수와 같이 정수로만 표현이 가능한 변수
- 연속형 변수(continuous variable) : 온도, 키와 같이 실수값으로 표현 될 수 있는 변수
-
질적 변수(qualitative variable) : 성별, 지역과 같이 수치로 나타낼 수 없는 변수로 산술적 계산이 불가능하다.
-
변수의 수준 (level of variable)
-
명목변수 (nominal variable) : 특성을 분류하기 위한 단순한 구분기호로, 범주 간의 순서나 크기의 차이가 없다
- ex) 성별, 색깔, 혈액형
-
서열(순위)변수 (ordinal variable) : 명목변수보다 한 단계 높은 수준으로, 범주 간의 순서가 있지만 그 차이가 일정하지 않다. 순서만 비교 가능하고, 사칙연산이 포함되는 분석은 불가능하다
- ex) 학점, 메달, 만족도
-
등간(구간)변수 (interval variable) : 서열변수보다 한 단계 높은 수준으로, 순서가 있고 범주 간의 차이가 일정하다. 덧셈과 뺄셈이 가능하지만 기준이 상대적이기 때문에 비율은 큰 의미가 없다.
- ex) 온도, IQ, 물가지수
-
비율변수 (Ratio Variable) : 가장 높은 수준의 정보를 가지고 있는 변수로, 등간변수의 특성에 더해 절대적인 기준(즉, 절대 0점)이 존재하여 모든 사칙연산과 비율 계산이 가능하다.
- ex) 키, 몸무게, 나이
-
-
변수의 수준은 분석 목적에 따라 변환하여 설정할 수 있다. 이때, 높은 수준에서 낮은 수준으로의 변화는 가능하지만, 반대는 불가능하다
-
변수의 수준에 따라 분석하는 방법이 다르다.
※ ML에서의 (Numeric variable, Categorical Variable)과의 차이
- 머신러닝에서의 numeric/categorical 구분은 컴퓨터가 인식하고 처리할 수 있는 방식에 맞춘 것이고, 통계학에서의 양적/질적 구분은 데이터의 본질적인 특성과 분석적 요구에 맞춘 것이다.
- 예시로, Categorical Variable의 경우는 인코딩을 통해 결국 Numeric variable로 변환되고, 인코딩 방식에 따라 이산형(one-hot encoding,...)/연속형(target encoding,...) 변수의 형식을 가지게 된다
- 이렇게 인코딩을 진행한다고 해서 변수의 수준(level)이나 종류(qualitative->quantitative)가 바뀌는 것은 아니다. 인코딩은 ML에서 요구하는 표현을 맞춰주는 과정이며 변수의 종류/수준은 그대로 유지된다.
도수분포표
- 도수분포표 (frequency distribution table) : 수집한 자료를 적절한 등급/범주로 분류하고 각 등급/범주에 해당되는 빈도수 등을 정리한 표
질적 자료의 정리
-
빈도수 (frequency) : 하나의 등급/범주의 분포상태
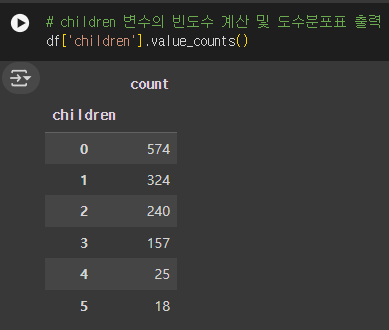
-
상대적 빈도 (relative frequency) : 전체 자료 중 각 범주의 빈도가 차지하는 비율. 한 집단에서 각 범주의 빈도를 비교하는 경우도 사용 가능하지만, 서로 다른 집단을 비교할 때 더욱 유용하다.
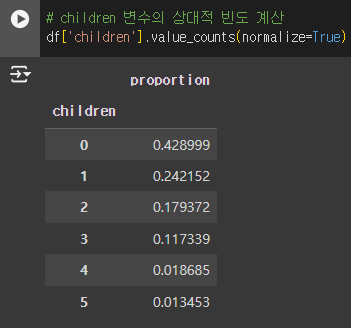
-
질적 자료의 경우 일반적으로 막대그래프(bar graph)로 시각화를 한다
양적 자료의 정리
-
frequency와 relative frequency는 기본적으로 사용 가능하다
-
이산형 자료
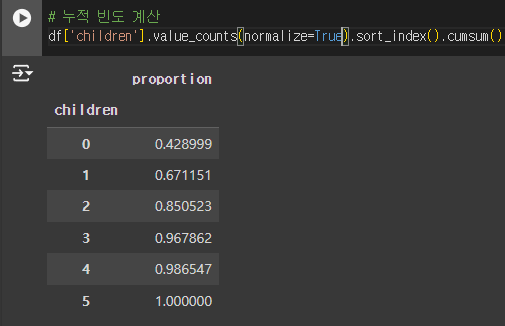
- 누적빈도 (cummulative frequency) : 어떤 등급에 해당되는 빈도를 포함해서 그 이하/이상의 모든 빈도를 합한 것.
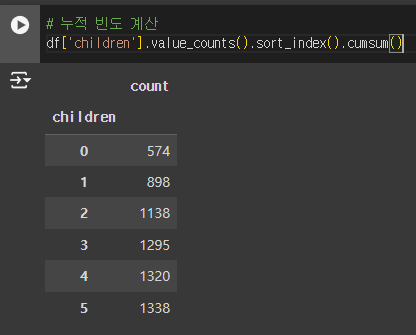
- 상대적 누적빈도 (relative cummulative frequency) : 어떤 등급에 해당되는 누적빈도가전체 관찰대상 중 얼마 만큼의 비율을 차지하고 있는지 확인 가능.
-
연속형 자료
- 연속형 변수의 경우, 도수분포표의 형태로 보기 위해서는 적당한 크기의 등급으로 자료를 묶어 줘야 한다.
- 유의사항
- 이상치도 ~이상 / ~이하로 표시하여 도수분포표에 포함시켜야 한다
- 이상치를 포함하는 양 끝의 등급을 제외한 나머지 등급의 구간은 같아야한다
- 등급은 서로 중복되지 않아야 한다
- 등급은 연속적으로 표현되어야 한다
- 유의사항
- 연속형 변수의 경우, 도수분포표의 형태로 보기 위해서는 적당한 크기의 등급으로 자료를 묶어 줘야 한다.
-
histogram, 꺾은선 그래프(polygon)를 사용하여 [빈도수, 상대적 빈도, 누적 빈도수]를 시각화 가능하며 상대적 누적빈도의 경우 누적백분율곡선(ogive)을 사용하여 시각화가 가능하다