nginx로 운영 중인 snack 서비스의 막연한 로그들을 측정가능한 지표(SLI)로 만들고, 장애 발생 시 Discord로 즉각적인 알림을 받는 모니터링 및 알림 시스템을 구축했다.
주의-람다를 사용할 땐, 람다가 혹시 사설 VPC에 붙어있진 않은 지 확인해야 한다... 왜냐고?...Cost Explore를 확인해보자
내가 2025년 1학기 umc 8기에서 참여한 snack 서비스는 개발단에서만 총 11명이 함께한 프로젝트이다.

네이버 뉴스 기사를 크롤링하여 요약본, 어려운 용어 해설, 퀴즈, 스크랩, 맞춤형 기사 피드를 제공하는 뉴스 리딩 보조 서비스
백 단에서 spring boot와 fastapi 두 서버간 소통도 있는 서비스다 보니.. 서버 운영 중 적지 않은 오류들이 있었다.
Nginx를 사용했지만 nginx의 텍스트 로그는 쌓이기만 할 뿐, 실시간으로 서비스 상태(에러율, 지연율)을 확인하기 어렵기에, 서비스의 SLO를 측정할 수 있는 지표(SLI)를 정의하고, 장애 발생시 수동 확인이 아닌 자동화된 알림을 받는 시스템을 구축하고자 했다.
1단계 : Nginx 로그를 AWS가 이해할 수 있는 지표로 만들자
1. Nginx 로그 포맷을 JSON으로 변경하기
log_format json_combined escape=json
'{"time_local":"$time_local",
"status":$status,
"request_time":$request_time,
"request":"$request",
"host":"$host",
"upstream_status":"$upstream_status",
"upstream_response_time":"$upstream_response_time"}';
※ Nginx DNS 캐시 문제
초기 설정(proxy_pass http://spring:8080)대로 운영 할 때, spring 컨테이너만 재시작하면 Nginx가 502 Bad Gateway를 반환하는 문제가 있었다.
이는 Nginx가 '시작 시점의 spring 컨테이너 IP'를 캐시(Cache)하고, 재시작으로 IP가 변경되어도 과거 IP로 요청하기 때문이였다..
따라서
1) resolver 127.0.0.11; 즉, Docker 내부 DNS를 Nginx 설정에 추가하고,
2) proxy_pass가 호스트 이름이 아닌 $ 변수 (예: proxy_pass $spring_backend;)를 바라보게 수정하여,
Nginx가 호스트 이름의 IP를 캐시하지 않고 resolver에게 매번 물어보도록 강제했다!
2. Docker Compose에서 CloudWatch Logs로 로그 전송
docker-compose.yml의 logging 드라이버를 'awslogs'로 설정하여 Nginx 컨테이너의 로그가 실시간으로 CloudWatch Log Group (/nginx/access)으로 전송되도록 했다!
# 파일 로그 안 쓰고 stdout만 사용(awslogs로 CloudWatch 전송)
access_log /dev/stdout json_combined;
error_log  /dev/stderr warn;
3. CloudWatch Metric Filter로 핵심 SLI 3가지 추출
CloudWatch Logs에 쌓인 JSON 로그를 파싱하여 3개의 핵심 지표(Metric)를 정해보았다!
①총 요청 수
②5xx 에러 수
③1.5초 이상 지연된 요청 갯수
그리구 아래는 Metric Filter 설정이다.
LG=/nginx/access
# 전체 요청 수
aws logs put-metric-filter \
  --log-group-name "$LG" \
  --filter-name "nginx-requests" \
  --filter-pattern '{ $.status = * }' \
  --metric-transformations \
    metricName=Requests,metricNamespace=App/HTTP,metricValue=1

# 5xx 개수
aws logs put-metric-filter \
  --log-group-name "$LG" \
  --filter-name "nginx-5xx" \
  --filter-pattern '{ $.status >= 500 }' \
  --metric-transformations \
    metricName=HTTP5xx,metricNamespace=App/HTTP,metricValue=1

# 1.5초 이상 느린 요청 개수(“슬로우”)
aws logs put-metric-filter \
  --log-group-name "$LG" \
  --filter-name "nginx-slow-gt-1_5s" \
  --filter-pattern '{ $.request_time >= 1.5 }' \
  --metric-transformations \
    metricName=SlowOver1_5s,metricNamespace=App/HTTP,metricValue=1
2단계 : 장애 정의하기 - CloudWatch Alrams
1. 노이즈 제거를 위한 '가드(Guard) 알람'
snack이 실제 출시를 위해 나온 서비스가 아니다 보니, 트래픽이 적다고도 가정하기도 했고..
분당 요청이 1~2건뿐이면 그건 그냥 노이즈일 수 있으니 무시한다.
2. '횟수'가 아닌 '비율' 알람 생성 (Metric Math)
- 5xx 비율 알람: 100*five/req >= 5% (3분 중 2회)
- 지연율 알람: 100*slow/req >= 5% (3분 중 2회)
# 가드: 분당 요청 ≥ 5
aws cloudwatch put-metric-alarm \
  --alarm-name "HTTP-Req-ge-5pm" \
  --metric-name Requests --namespace App/HTTP \
  --statistic Sum --period 60 --evaluation-periods 1 --datapoints-to-alarm 1 \
  --threshold 5 --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching

# 5xx 비율 ≥ 5% (3분 중 2분)
aws cloudwatch put-metric-alarm \
  --alarm-name "HTTP-5xx-Rate-gt-5pct" \
  --comparison-operator GreaterThanOrEqualToThreshold --threshold 5 \
  --evaluation-periods 3 --datapoints-to-alarm 2 --treat-missing-data notBreaching \
  --metrics '[
    {"Id":"rate","Expression":"100*five/req","Label":"5xx%","ReturnData":true},
    {"Id":"five","MetricStat":{"Metric":{"Namespace":"App/HTTP","MetricName":"HTTP5xx"},"Period":60,"Stat":"Sum"},"ReturnData":false},
    {"Id":"req","MetricStat":{"Metric":{"Namespace":"App/HTTP","MetricName":"Requests"},"Period":60,"Stat":"Sum"},"ReturnData":false}
  ]'

# 슬로우율(>1.5s) ≥ 5% (3분 중 2분)
aws cloudwatch put-metric-alarm \
  --alarm-name "HTTP-SlowRate-gt-5pct(>1.5s)" \
  --comparison-operator GreaterThanOrEqualToThreshold --threshold 5 \
  --evaluation-periods 3 --datapoints-to-alarm 2 --treat-missing-data notBreaching \
  --metrics '[
    {"Id":"rate","Expression":"100*slow/req","Label":"slow%","ReturnData":true},
    {"Id":"slow","MetricStat":{"Metric":{"Namespace":"App/HTTP","MetricName":"SlowOver1_5s"},"Period":60,"Stat":"Sum"},"ReturnData":false},
    {"Id":"req","MetricStat":{"Metric":{"Namespace":"App/HTTP","MetricName":"Requests"},"Period":60,"Stat":"Sum"},"ReturnData":false}
  ]'
3. Composite Alarm으로 장애 즉, "인시던트(Incident)" 최종 정의
INCIDENT-WEB라는 이름의 Composite Alarm을 생성하여, MTTR 측정의 기준점으로 삼았다!!
- Incident 규칙 :
(5xx 비율 > 5% OR 지연율 > 5%) AND (분당 요청 > 5회)
aws cloudwatch put-composite-alarm \
  --alarm-name "INCIDENT-WEB" \
  --alarm-rule '(ALARM("HTTP-5xx-Rate-gt-5pct") OR ALARM("HTTP-SlowRate-gt-5pct(>1.5s)")) AND ALARM("HTTP-Req-ge-5pm")'
5xx나 지연율이 5%를 넘겼다고 해도, 만약 분당 요청이 1~2건뿐이면 그건 그냥 노이즈일 수 있으니 무시하도록 했다. 하지만 분당 5회 이상의 트래픽이 있는 경우는 실제 서비스 상황이라고 간주하고 문제 발생 시 그건 장애로 판단한다!
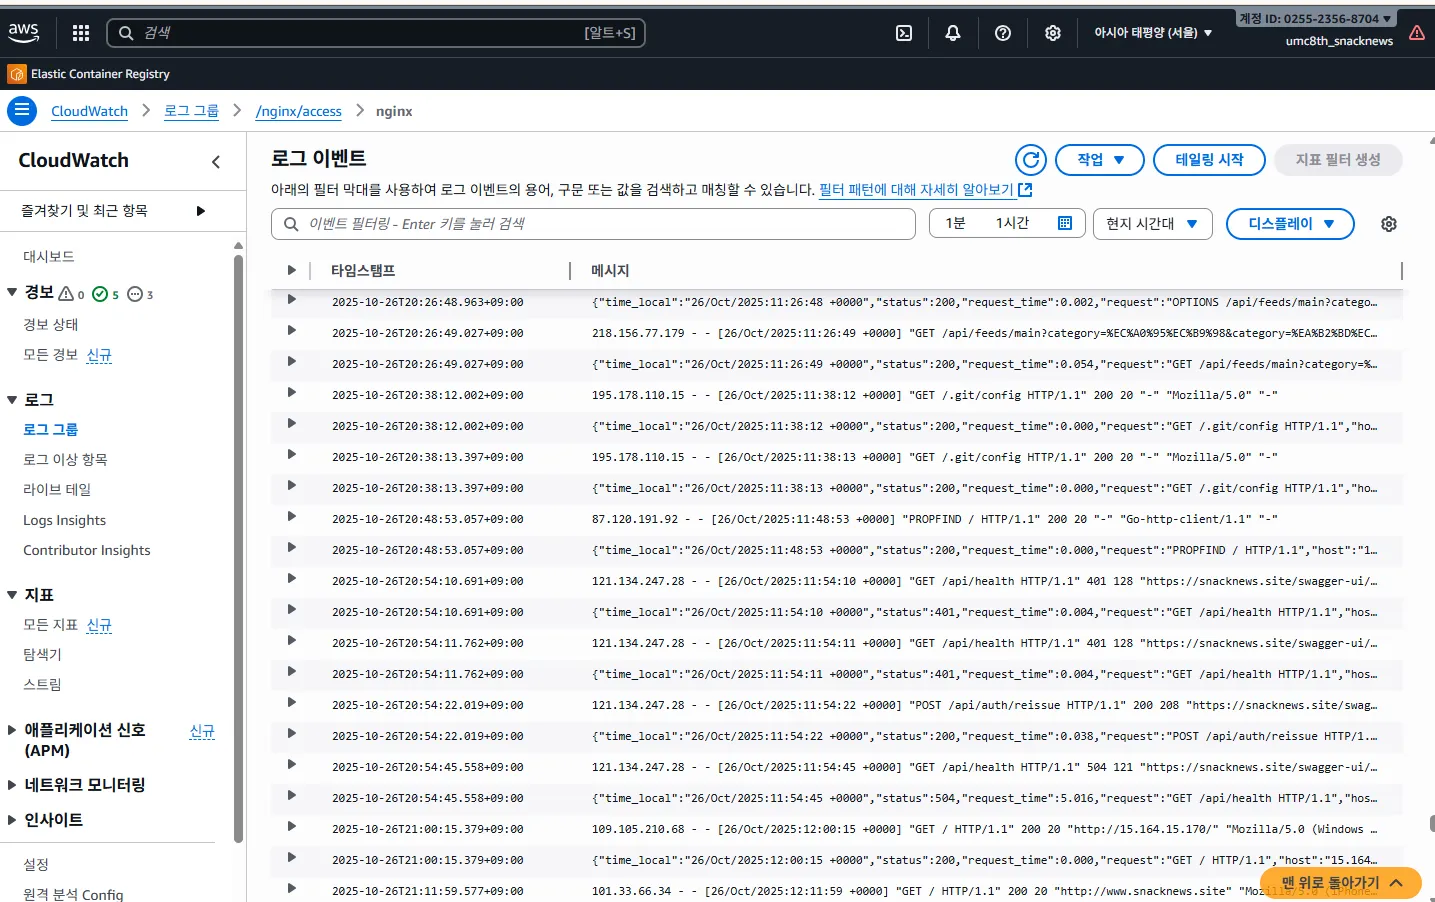
아래는 로그들이 저장되는 모습이다..!
2-1 단계 : 그라파나로 세 가지 지표 시각화
Grafana에 CloudWatch 데이터소스를 연결하면, 시각화된 그래프를 볼 수 있는 것 뿐만 아니라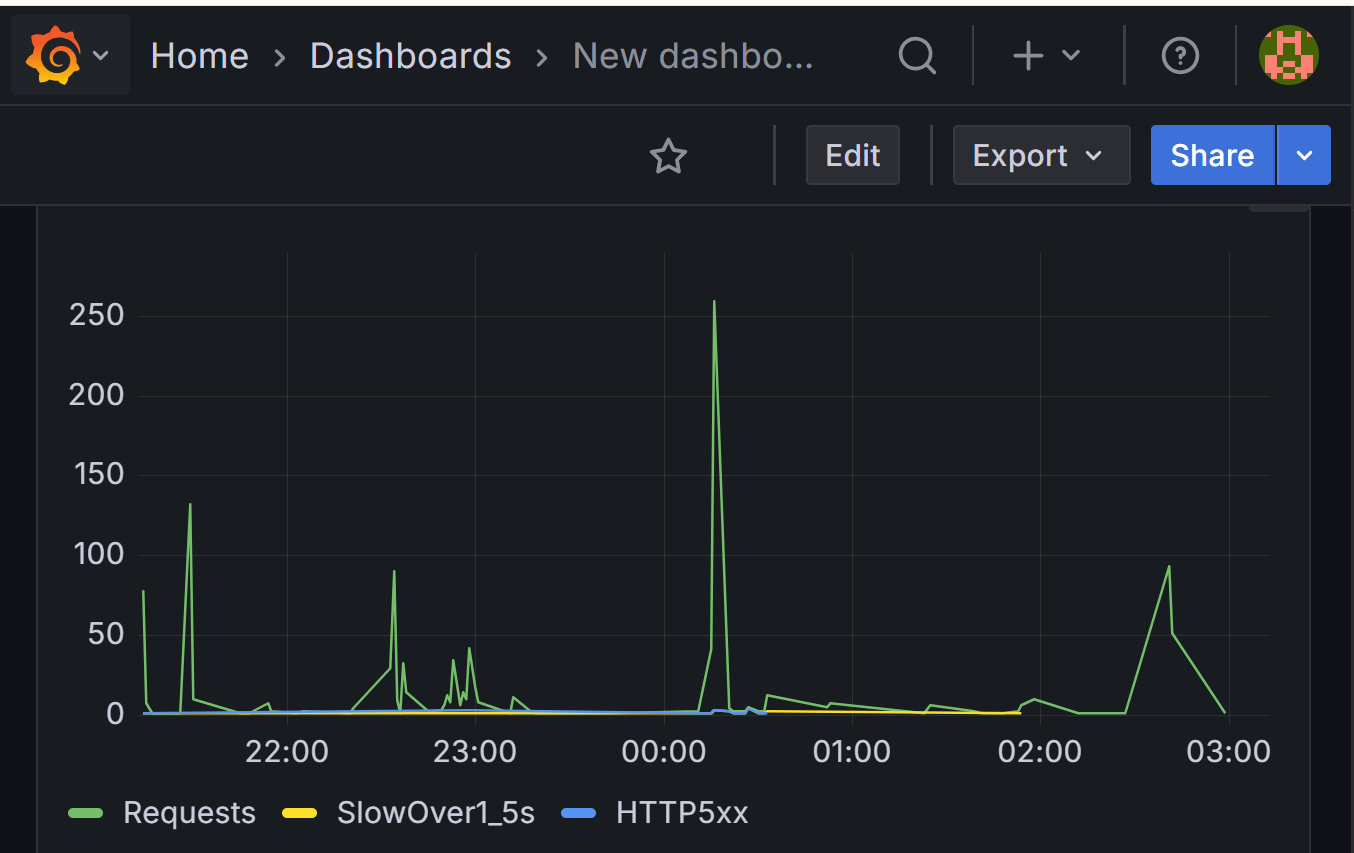
또, Grafana의 Transform 기능으로 5xx 비율 계산을 할 수도 있다!! 보니까 엄청 다양한 기능들이 많은 것 같은데 언제 한번 그라파나도 파보고 싶다..
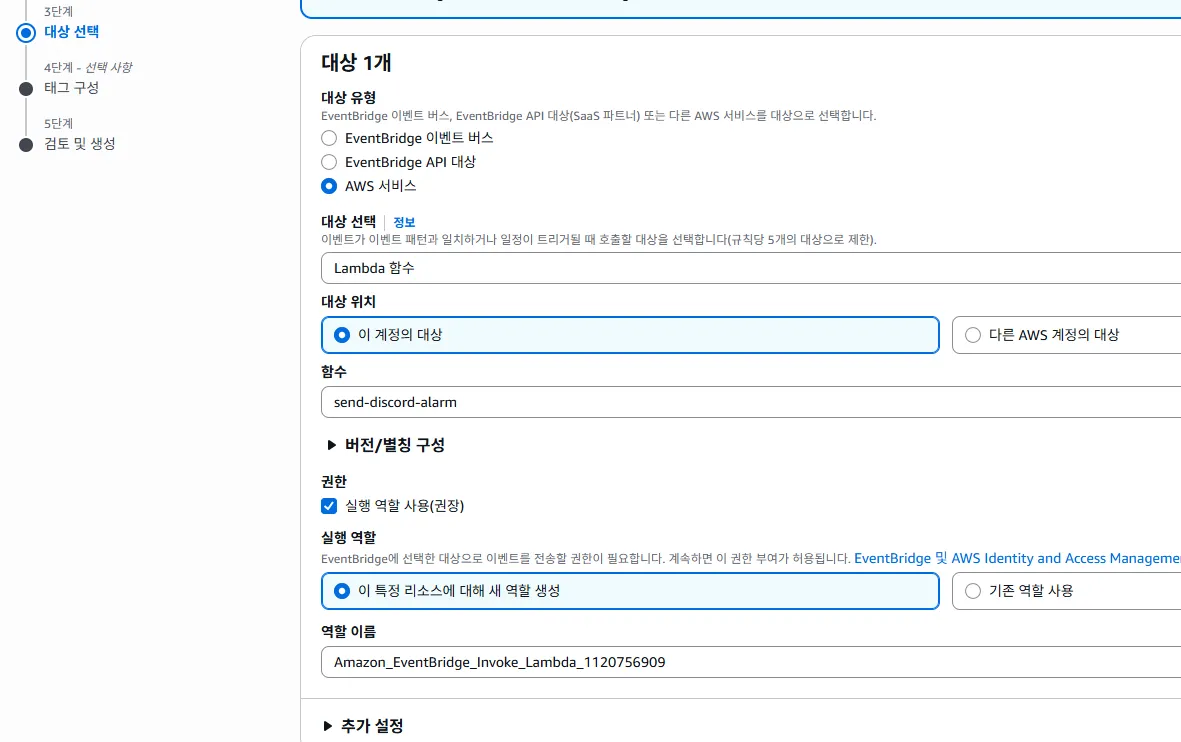
3단계 : "즉시 알림" 파이프라인 구축 (EventBridge → Lambda → Discord)
1. EventBridge 규칙 생성
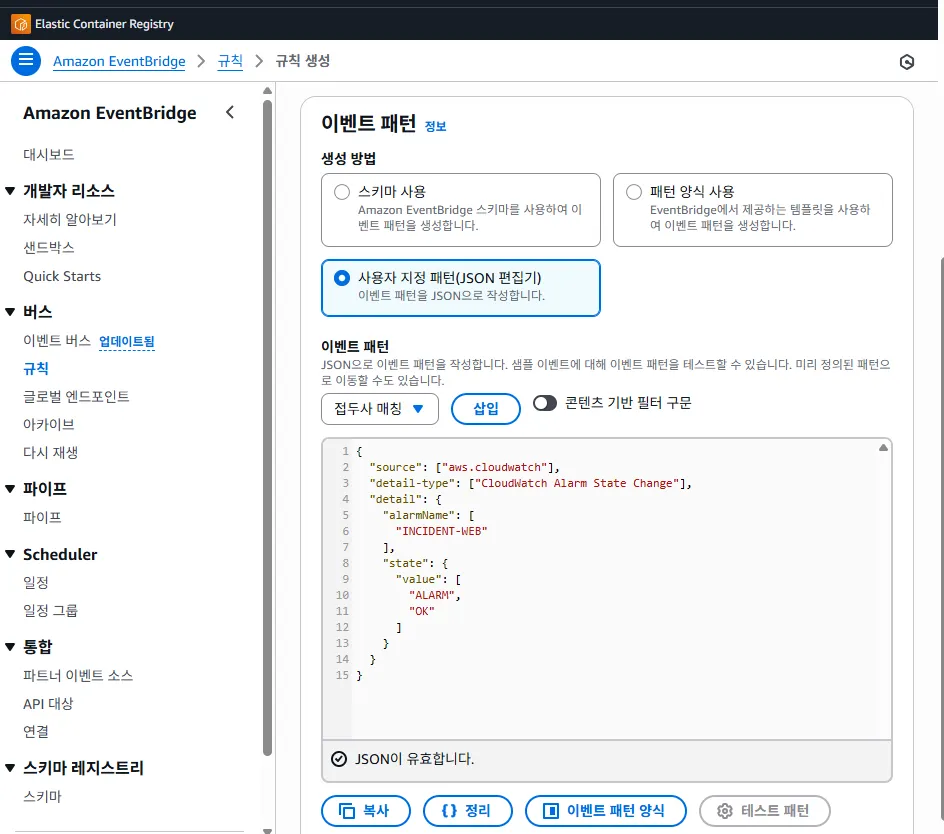
어떤 조건일 때 Lambda 함수를 호출하도록 할까?
INCIDENT-WEB 알람의 상태가 ALARM 또는 OK로 변경될 때만 Lambda 함수를 트리거하도록 EventBridge 규칙을 설정했다.
2. Lambda 함수 작성
디스코드 웹훅 URL을 Lamda 환경 변수로 설정하고, EventBridge가 보낸 JSON 이벤트를 파싱하게 했다.
import json, os, urllib.request, datetime

# 환경 변수에서 웹훅 URL을 직접 가져옵니다.
WEBHOOK_URL = os.environ.get("DISCORD_WEBHOOK_URL")

COLORS = {
    "ALARM": 0xE74C3C,           # red
    "OK": 0x2ECC71,               # green
    "INSUFFICIENT_DATA": 0xF1C40F, # yellow
}

def get_custom_description(alarm_name, new_state, original_reason):
    """
    알람 상태와 원본 reason을 바탕으로 가독성 좋은 메시지를 생성합니다.
    """
    # 1. OK 상태일 때는 무조건 '정상 복구'
    if new_state == "OK":
        return "✅ 서비스가 정상 복구되었습니다."

    # 2. ALARM 상태일 때, 알람 이름에 따라 분기
    if alarm_name == "INCIDENT-WEB":
        # 원본 reason 문자열을 분석하여 구체적인 장애 원인을 파악
        if "HTTP-5xx-Rate" in original_reason:
            return "🚨 **5xx 에러 비율**이 5%를 초과했습니다. (5xx > 5%)"
        if "HTTP-SlowRate" in original_reason:
            return "🐢 **요청 지연율(>1.5s)**이 5%를 초과했습니다. (Slow Rate > 5%)"

        # 위 두개가 아닌데 ALARM이 떴다면 (예: set-alarm-state 테스트)
        # 원본 reason을 그대로 보여주되, 장애 아이콘 추가
        return f"🔥 서비스 장애 발생! 원인: {original_reason}"

    # 3. (선택적) 다른 개별 알람에 대한 처리
    # (INCIDENT-WEB의 자식 알람도 EventBridge로 직접 알림을 보낸다면)
    if alarm_name == "HTTP-5xx-Rate-gt-5pct":
        return "🚨 5xx 에러 비율이 5%를 초과했습니다."
    if alarm_name == "HTTP-SlowRate-gt-5pct(>1.5s)":
        return "🐢 요청 지연율(>1.5s)이 5%를 초과했습니다."
    if alarm_name == "HTTP-Req-ge-5pm":
        return "ℹ️ 분당 요청 수가 5회를 넘었습니다. (가드 조건 충족)"

    # 4. 위 모든 경우에 해당하지 않으면 원본 reason 반환
    return original_reason


def build_message(e):
    detail = e.get("detail", {})
    state  = detail.get("state", {})
    account = e.get("account")
    region  = e.get("region")

    alarm_name = detail.get("alarmName") or detail.get("configuration", {}).get("alarmName") or "unknown"
    new_state  = state.get("value", "UNKNOWN")
    reason     = state.get("reason", "") # CloudWatch가 보낸 원본 Reason
    at         = state.get("timestamp") or e.get("time")

    ts = int(datetime.datetime.fromisoformat(at.replace("Z", "+00:00")).timestamp())

    link = f"https://{region}.console.aws.amazon.com/cloudwatch/home?region={region}#alarmsV2:alarm/{alarm_name}"

    # 원본 reason 대신 커스텀 description을 생성하는 함수 호출
    custom_description = get_custom_description(alarm_name, new_state, reason)

    embed = {
        "title": f"[{new_state}] {alarm_name}",
        "color": COLORS.get(new_state, 0x95A5A6),
        "description": custom_description, # 'reason' 변수 대신 'custom_description' 사용
        "timestamp": datetime.datetime.utcfromtimestamp(ts).isoformat() + "Z",
        "fields": [
            {"name": "Account", "value": account, "inline": True},
            {"name": "Region", "value": region, "inline": True},
            {"name": "Link", "value": link, "inline": False},
        ]
    }
    return {"embeds": [embed]}

def post_discord(payload, webhook):
    if not webhook:
        print("오류: DISCORD_WEBHOOK_URL 환경 변수가 설정되지 않았습니다.")
        return 500

    data = json.dumps(payload).encode("utf-8")

    # Discord가 403을 반환하지 않도록 User-Agent 헤더를 명시적으로 추가
	(이거 안하면 디스코드가 안 받더라..)
    headers = {
        "Content-Type": "application/json",
        "User-Agent": "AWS-Lambda-Alarm-Bot (Python-urllib)"
    }

    req  = urllib.request.Request(webhook, data=data, headers=headers)

    with urllib.request.urlopen(req, timeout=5) as resp:
        return resp.status

def lambda_handler(event, context):
    try:
        if event.get("detail-type") != "CloudWatch Alarm State Change":
            print(f"무시된 이벤트 유형: {event.get('detail-type')}")
            return {"ok": True, "ignored": True}

        payload = build_message(event)
        code = post_discord(payload, WEBHOOK_URL)

        is_ok = (code == 204 or code == 200)
        if not is_ok:
            print(f"Discord 전송 실패. 응답 코드: {code}")

        return {"ok": is_ok, "code": code}

    except Exception as ex:
        print(f"심각한 오류 발생: {ex}")
return {"ok": False, "err": str(ex)}- get_custom_description 함수:
ALARM일 때는 원인을 분석해서 '🚨 5xx 에러 비율 초과'등으로, OK일 때는 '✅ 서비스가 정상 복구되었습니다.' 처럼 사람이 읽기 쉬운 메시지로 번역하도록 구현했다.
※ Discord API는 User-Agent 헤더가 없는 요청을 거부함
처음에 403 Forbidden 오류가 발생해서, CloudWatch Logs를 확인했다. 그 후 post_discord 함수에 User-Agent 헤더를 명시적으로 추가해줬다.....!
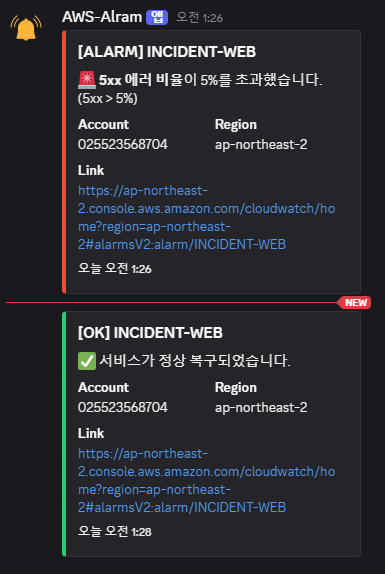
SRE가 이런 것을 하는 직무이려나?..
이번 작업에서는
- 관측 가능성(observability)을 확보하고, 노이즈 및 장애 기준을 분리했다.
- 장애 인지를 자동화하여 - EventBridge가 인시던트 발생(ALARM)과 해결(OK)을 감지하고, Lambda가 이를 즉시 Discord로 전송하는 엔드투엔드 파이프라인을 구축했다!
- 디스코드 알람은 명확한 상황을 번역하여 전달하므로, 장애 식별 시간도 최소화할 수 있다.
- MTTR 측정 기반을 마련했다. INCIDENT-WEB이라는 '인시던트' 알람을 정의함으로써 , 이 알람이 ALARM에서 OK로 돌아오는 시간(TTR)을 측정할 수 있게 되었다 - 해당 데이터를 축적하여 평균 장애 복구 시간(MTTR)을 계산하고 장애 복구 시간의 감소를 수치로 확인할 수 있게 되었다!
