"글로벌 시장으로 진출합니다!"
기획팀의 야심 찬 선언과 함께 제 자리엔 '다국어 지원(i18n)'이라는 묵직한 과제가 떨어졌습니다. 새로 만드는 프로젝트라면 참 좋았겠지만, 현실은 이미 수많은 유저들이 매일 사용하고 있는 '라이브 서비스'였습니다.
개발자들 사이에서 가장 악명 높은 작업 중 하나인 "달리는 기차의 바퀴 바꾸기"가 시작된 순간이었죠.
기차를 멈추지 않고(무중단), 승객들이 멀미를 느끼지 않게(SEO 및 기존 URL 유지), 그러면서도 바퀴를 튼튼한 다국어용으로 교체해야 했습니다. 이 험난했던 여정, 그리고 라이브러리의 밑바닥을 파헤치며 깨달았던 사투의 기록을 공유합니다.
🚨 1번 선로: 절대로 멈출 수 없는 두 가지 조건 (SEO & Legacy URL)
새 바퀴를 갈아 끼우기 전에 절대로 건드려선 안 될 성역이 있었습니다.
- SEO (검색 엔진 최적화): 현재 서비스는 구글과 네이버 검색을 통해 유입되는 유저가 많습니다. 다국어를 도입한다고 한국어 페이지의 점수가 깎이거나 검색 결과에서 사라지면 절대 안 됩니다.
- 기존 URL 체계 유지: 수많은 유저들이 이미 특정 링크를 즐겨찾기 해두거나 공유해 두었습니다. 다국어 도입한다고 이 링크들이 404로 바뀌면 대참사입니다.
처음엔 간단하게 ?lang=en 같은 쿼리 파라미터 방식을 생각했습니다. 기존 URL을 건드리지 않으니까요. 하지만 검색 엔진은 URL 경로(/en/...) 형태를 훨씬 선호하며, 그래야 각 언어별 페이지로 명확히 인지하기 때문입니다.
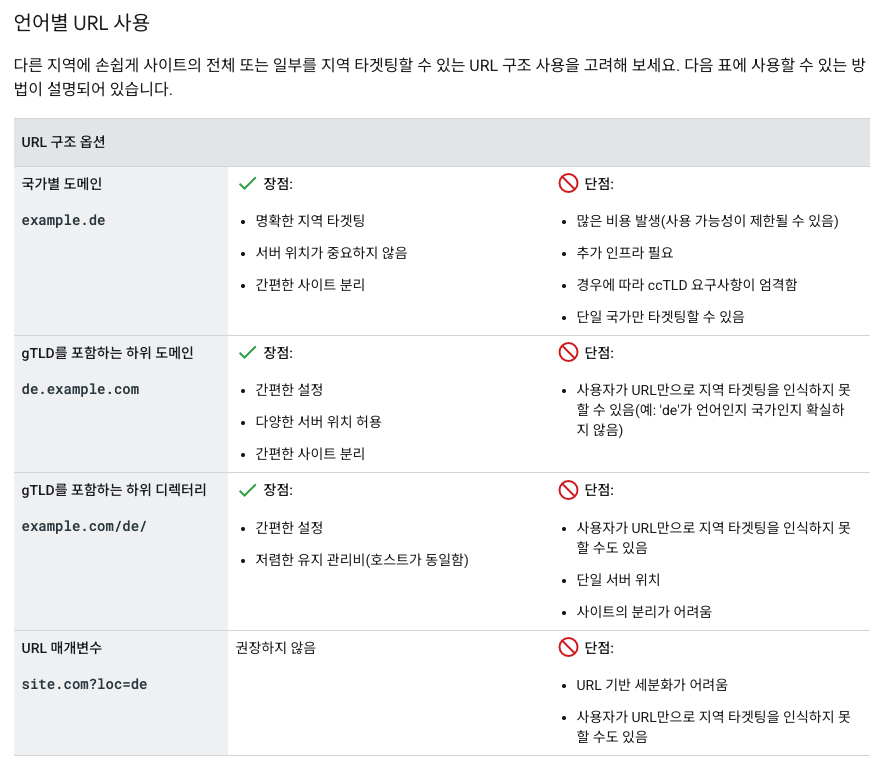
구글의 공식 문서를 기반하여 결국 Sub-path 방식(/[locale]/...)을 택했습니다. 달리는 기차 아래로 기어들어 갈 준비를 마쳤습니다.
🧠 2번 선로: 전역 상태(Context)의 함정과 '쿠키'라는 구원자
경로 구조를 잡고 나니 프론트엔드 개발자로서 근본적인 의문이 들었습니다.
"엥? 결국 JSON 파일에서 다국어 텍스트를 가져와서 전체 화면에 뿌려주려면, Zustand나 React Context 같은 전역 상태(Global State)로 현재 언어(
lang)를 관리해야 하는 거 아닌가?"
기존 React (SPA) 방식에 익숙했던 저의 오판이었습니다. 만약 최상단에서 Context Provider로 언어 상태를 관리하게 되면, 앱 전체가 클라이언트 사이드 렌더링(CSR)으로 동작하게 되어 기껏 지키려 했던 SEO와 초기 로딩 속도(TTFB)가 다 박살 나버리기 때문입니다.
이 딜레마를 안고 next-intl 라이브러리의 동작 원리를 파헤치기 시작했고, 이 녀석이 전역 상태 대신 '쿠키(Cookie)'와 '미들웨어(Middleware)'를 기가 막히게 활용한다는 사실을 깨달았습니다.
실제 next-intl의 미들웨어 내부 로직(resolveLocale 함수)을 보면 그 철학이 명확히 드러납니다.
// /middleware/resolveLocale.tsx (내부 로직 발췌)

function resolveLocale(request, routing) {
  let locale;

  // Prio 1: URL 경로 확인 (Use route prefix)
  // 예: /en/dashboard 로 접속했는가?
  if (pathname) {
    locale = getPathnameMatch(pathname, routing.locales, routing.localePrefix)?.locale;
  }

  // Prio 2: 기존 쿠키 확인 (Use existing cookie)
  // URL에 없으면, 유저 브라우저에 구워둔 NEXT_LOCALE 쿠키가 있는가?
  if (!locale && routing.localeDetection) {
    locale = getLocaleFromCookie(routing, requestCookies);
  }

  // Prio 3: 브라우저 기본 언어 확인 (Use the `accept-language` header)
  // 쿠키도 없으면, 유저 브라우저의 기본 세팅 언어(Accept-Language 헤더)가 무엇인가?
  if (!locale && routing.localeDetection) {
    locale = getAcceptLanguageLocale(requestHeaders, routing.locales, routing.defaultLocale);
  }

  // Prio 4: 위 3개가 다 없으면, 서버에 설정한 기본 언어(ko)로 폴백 (Use default locale)
  if (!locale) {
    locale = routing.defaultLocale;
  }

  return locale;
}
이 코드를 본 순간 깨달음을 얻었습니다. "아, 전역 상태(Zustand, Context)는 전혀 필요 없구나!"
미들웨어가 가장 먼저 진입점에 서서 1순위(URL) ➡️ 2순위(쿠키) ➡️ 3순위(브라우저 헤더) ➡️ 4순위(기본값) 순서로 언어를 우아하게 추론해 냅니다. 그리고 서버가 렌더링을 시작하기도 전에, 어떤 언어로 페이지를 그려야 할지 완벽하게 결정(Resolve)하여 하위 컴포넌트들에게 내려주는 방식이었습니다.
전역 상태 관리 라이브러리 없이도 URL과 쿠키만으로 서버(SSR)와 클라이언트(CSR)가 완벽하게 언어 정보를 공유하게 된 것이죠.
- 미들웨어의 가로채기: 사용자가 기존 링크인
/test으로 접속합니다. - 쿠키와 헤더 스캔: 미들웨어가 가장 먼저
NEXT_LOCALE쿠키를 확인합니다. 쿠키가 없다면 브라우저의Accept-Language헤더를 읽어 유저의 언어를 파악합니다. - URL Rewrite (우회): 한국어 유저라면 내부적으로
/ko/test으로 연결(Rewrite)해 줍니다.
결과적으로 유저의 주소창은 /test 그대로 유지되면서도, Next.js 서버는 이 요청이 '한국어'라는 것을 렌더링 시작도 전에 알아챕니다. 전역 상태 관리 라이브러리 없이도 URL과 쿠키만으로 서버와 클라이언트가 완벽하게 언어 정보를 공유하게 된 것이죠. (게다가 한국어는 as-needed 설정으로 URL에 /ko를 숨겨 미관까지 챙겼습니다!)
🚀 3번 선로: 서버(SSR)와 클라이언트(CSR)의 완벽한 분업
서버가 현재 언어를 알게 되었으니, 이제 JSON 데이터를 컴포넌트에 뿌려줄 차례입니다. App Router의 강력함을 살리기 위해 우리는 철저하게 SSR과 CSR을 분리했습니다.
1. SSR (서버 컴포넌트): 비동기
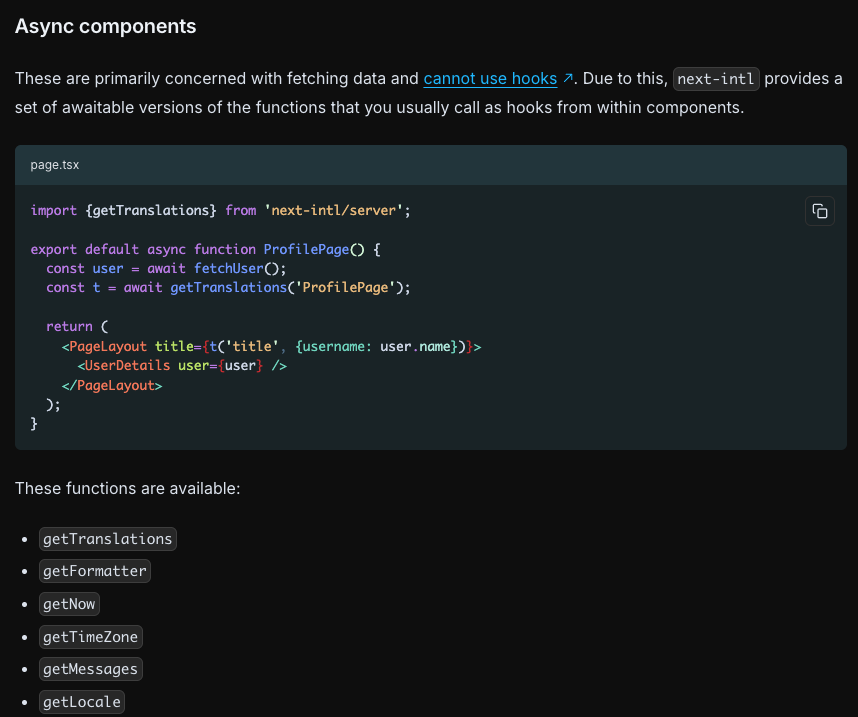
SEO가 중요한 랜딩 페이지나 텍스트 위주의 컨테이너는 모두 서버 컴포넌트로 유지했습니다. 여기서는 getTranslations라는 비동기 함수를 사용합니다.
// 서버 컴포넌트: SEO 완벽 대응, 클라이언트 JS 번들 0바이트!
import { getTranslations } from 'next-intl/server';

const LandingPage = async () => {
  const t = await getTranslations('landing.titleSection');
  return <h1>{t('heading')}</h1>;
};
서버에서 JSON을 읽어 HTML을 완성한 뒤 내려주기 때문에 검색 엔진 봇이 완벽하게 텍스트를 긁어갈 수 있습니다.
2. CSR (클라이언트 컴포넌트): 하이드레이션의 조화
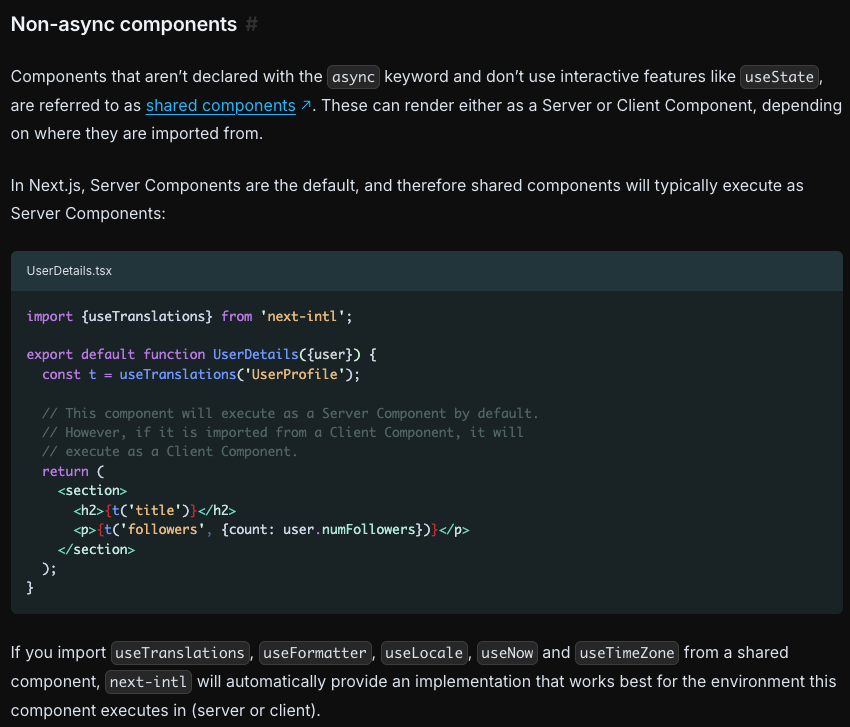
버튼 클릭 이벤트(onClick)가 필요한 UI 요소들은 불가피하게 'use client'를 써야 합니다. 여기선 Hook 방식인 useTranslations를 사용합니다.
'use client';
import { useTranslations } from 'next-intl';

const ActionButton = () => {
  const t = useTranslations('common');
  return <button onClick={...}>{t('button')}</button>;
};
여기서 또 놀라운 점은, 클라이언트 컴포넌트가 JSON 전체를 다운로드해서 무거워지는 것을 막기 위해, 상위 레이아웃에서 NextIntlClientProvider가 현재 페이지에서 필요한 번역 데이터(messages)만 쏙 빼서 넘겨준다는 것입니다.
🤖 4번 선로: 인간은 실수한다, 시트 데이터를 자동화하라!
프론트엔드 아키텍처를 아무리 기가 막히게 짜놨어도, 결국 화면을 채우는 건 '데이터'입니다. 저희 팀은 수백, 수천 개에 이르는 텍스트를 자동으로 번역하고, 데이터 API로 로컬에 받아오기 위해 Google Sheets를 사용하기로 했습니다.
1. GCP(Google Cloud Platform) 인증
가장 먼저 Google Cloud Console에 접속해 새 프로젝트를 파고 Google Sheets API를 활성화했습니다.
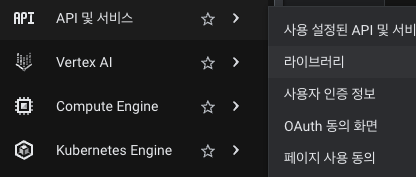
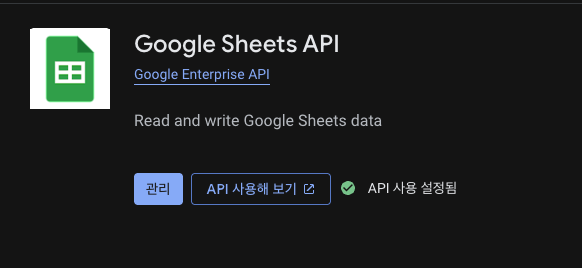
그 후 스크립트가 시트에 접근할 수 있도록 서비스 계정(Service Account)을 생성하고, 보안 키(google-key.json)를 발급받아 프로젝트 깊숙한 곳에 안전하게 숨겼습니다.
관련 내용은 이 블로그 내용을 참조했습니다.
2. 2차원 시트를 3차원 JSON 트리로 깎아내기
https://www.npmjs.com/package/@googleapis/sheets
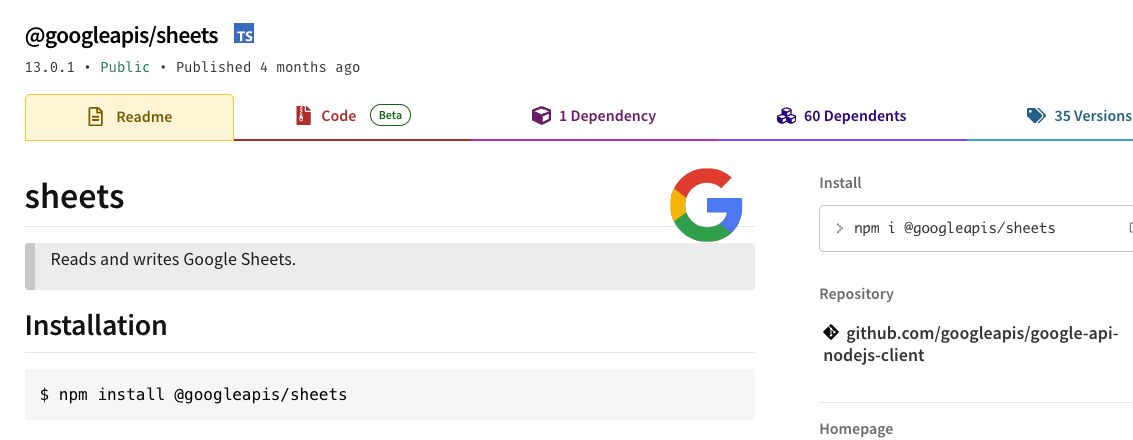
이후, 이를 API로 활용하기 위해 @googleapis/sheets 를 라이브러리로 가져오고, 활용합니다. (googleapis 전체 라이브러리는 200MB에 달하니, 무작정 가져오면 사이트가 무거워질지도 모릅니다.)
async function buildSheetData() {
  try {
    // 1. Google API 인증 설정
    const googleAuth = new auth.GoogleAuth({
      keyFile: path.resolve('[json 키가 있는 경로로 지정]'),
      scopes: ['https://www.googleapis.com/auth/spreadsheets.readonly'],
    });

    // 2. Sheets API 클라이언트 초기화
    const sheetsClient = sheets({ version: 'v4', auth: googleAuth });

    const spreadsheetId = '[스프레드 시트 ID]';
    const range = '[범위 설정]';

    // 3. 스프레드시트 데이터 요청
    const response = await sheetsClient.spreadsheets.values.get({
      spreadsheetId,
      range,
    });

    const rows = response.data.values;

    if (!rows || rows.length === 0) {
      console.log('⚠️ 시트에서 데이터를 찾을 수 없습니다.');
      return;
    }
이후에는 구글 시트의 평면적인 데이터(행과 열)를 next-intl이 인식할 수 있는 깊은 중첩 객체(Nested Object) 형태로 예쁘게 조립해야 합니다.
시트에 landing | useCases | title 라고 적혀있다면, 이를 아래와 같은 트리 구조로 변환하는 setNestedValue라는 재귀 유틸리티 함수를 구성합니다.
// 시트의 평면 데이터를 깊은 트리 구조로 변환하는 핵심 로직
function setNestedValue(obj, keys, value) {
  let current = obj;
  for (let i = 0; i < keys.length - 1; i++) {
    const key = keys[i];
    if (!current[key]) current[key] = {};
    current = current[key]; // 객체를 파고 들어갑니다
  }
  current[keys[keys.length - 1]] = value; // 마지막 depth에 값 할당
}
이후에는 해당 구조를 바탕으로 각 언어 locale명에 맞는 json 파일을 구축해주면 됩니다.
...
// 4. 파일 저장
    const outputDir = path.resolve('./src/locales');

    if (!fs.existsSync(outputDir)) {
      fs.mkdirSync(outputDir, { recursive: true });
    }

    fs.writeFileSync(path.join(outputDir, 'ko.json'), JSON.stringify(locales.ko, null, 2), 'utf-8');
    fs.writeFileSync(path.join(outputDir, 'en.json'), JSON.stringify(locales.en, null, 2), 'utf-8');
    fs.writeFileSync(path.join(outputDir, 'ja.json'), JSON.stringify(locales.ja, null, 2), 'utf-8');

    console.log('✅ 다국어 파일 생성 완료 (ko.json, en.json, ja.json)');
  } catch (error) {
    console.error('❌ 시트 데이터를 처리하는 데 실패했습니다:', error);
    process.exit(1);
  }
결과물: 터미널 명령어 한 줄
이제 구글 시트에서 디자인과 텍스트 연동 작업을 마치면, 저는 터미널에 딱 한 줄만 입력합니다.
$npm run build:i18n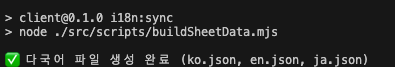
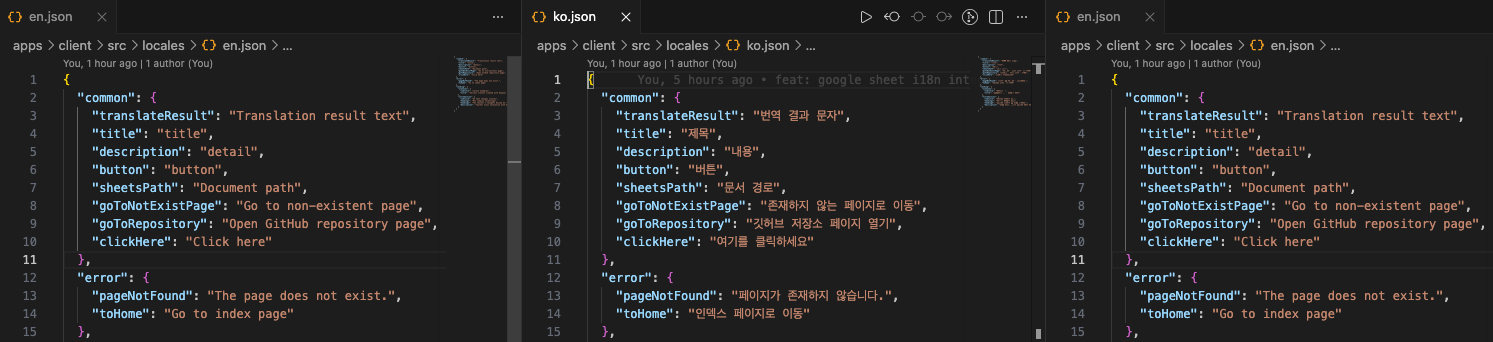
스크립트가 GCP를 타고 구글 시트에 접속해 데이터를 긁어오고, 트리 구조를 조립한 뒤, ko.json, en.json, ja.json 3개의 파일을 폴더에 자동으로 꽂아 넣습니다. 시트 원본은 훼손하지 않으면서, 운영 서버에 올라갈 데이터는 무결하게 유지하는 완벽한 파이프라인이 완성된 것입니다.
📚 승객들은 바퀴가 바뀐 줄도 모릅니다
험난했던 "달리는 기차의 바퀴 바꾸기" 작업이 끝났습니다.
한국어 유저들은 평소처럼 즐겨찾기 된 기존 링크로 접속하며 기차가 흔들림을 전혀 느끼지 못했습니다. 하지만 이제 GNB의 언어 선택 버튼을 누르는 순간, 내부의 미들웨어와 쿠키가 민첩하게 움직이며 정교하게 짜인 다국어 레이아웃 위에 영어와 일본어 데이터를 매끄럽게 얹어냅니다.

서버 사이드 렌더링 덕분에 SEO 점수도 굳건히 지켜냈습니다.
이제 저희 서비스는 한국을 넘어 글로벌 선로를 향해 힘차게 달리고 있습니다. 혹시 지금 라이브 운영 중인 서비스에 다국어라는 거대한 바퀴를 달아야 하는 동료 프론트엔드 개발자가 있다면, 이 치열했던 고민의 기록이 조금이나마 멀미를 줄여주는 나침반이 되길 바랍니다.