09월21일(월)
로컬 문서 RAG AI 챗봇 개발 및 구축 기록 (절차와 조치)
-
프로젝트 개요
프로젝트명: LLM모델(Gemini) 기반 로컬 문서 RAG(검색 증강 생성) AI 챗봇 구축
기술 스택:
LLM Engine: Google Gemini (gemini-3.6-flash)
⇒ 변경 사유는 앞으로 개발과 현재 사용 중인 api활용 측면
Embedding Model: BAAI/bge-m3 (SentenceTransformers 기반 한국어 최적화 임베딩)
Vector Database: ChromaDB (PersistentClient, 로컬 디스크 영구 저장 방식)
Web UI Framework: Streamlit
문서 파싱 : PyPDF (pypdf) -
시계열 진행 상황 및 트러블슈팅 내역
[단계 1] Streamlit 로컬 웹 서버 기동 및 환경 확인
진행 내용: 아나콘다 가상환경(gemini_rag)에서 streamlit run app.py를 실행하여 로컬 웹 서버(http://localhost:8501)를 구동함.
초기 상태: 사이드바 설정 영역과 메인 채팅 인터페이스가 정상적으로 화면에 렌더링됨.
[단계 2] 문서 업로드 시 확장자 불일치 에러 대응
발생 상황: 사이드바의 [Browse files]를 통해 규정 문서를 등록하는 과정에서 표준취업규칙(...).hwp Error: files are not allowed. 에러 발생.
원인 분석:
app.py 소스 코드 내 파일 업로더 컴포넌트가 st.file_uploader(..., type=["pdf"])로 설정되어 있어 HWP 확장자를 거부함.
해결 및 개선 조치:
업로드 창에서 오류가 발생한 HWP 파일을 제거함.
해당 규정 문서를 PDF의 자료를 검색(다운로드)하여 재업로드함.
업로드 성공 후 [문서 DB에 저장하기] 버튼이 정상적으로 활성화됨.
[단계 3] 조항 단위 청킹(Chunking) 및 ChromaDB 벡터 적재
진행 내용:
청킹 전략을 [조항/문단 단위 (추천)]으로 지정하고 DB 저장 실행.
정규식(제\s\d+\s조...) 기반 분할 로직을 거쳐 총 173개 청크로 파싱 완료.
로컬 임베딩 모델(BAAI/bge-m3)을 통해 벡터 임베딩을 추출하고, 로컬 디스크 경로(./chroma_db)의 컬렉션에 적재 완료.
사이드바에 💾 로컬 DB 상태: 173개 청크 영구 보존 중 상태 확인.
[단계 4] Gemini API 모델 지원 중단(404) 및 서버 과부하(503) 트러블슈팅
질문 테스트 진행 중 복합적인 API 호출 오류가 연쇄 발생하여 단계별로 조치함.
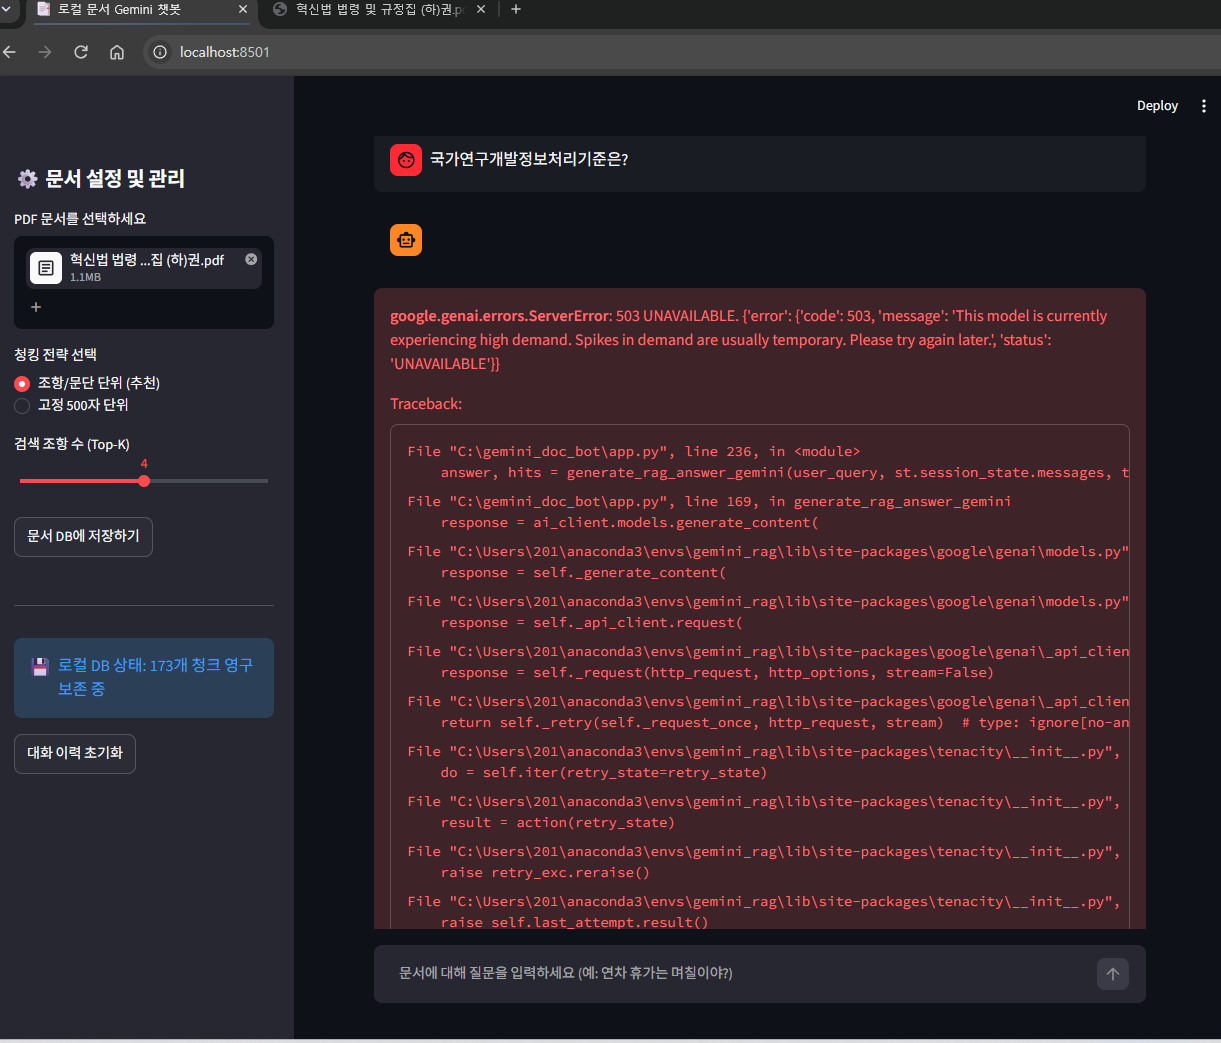
이슈 1: Google API 서버 일시적 과부하 (503 UNAVAILABLE)
증상: google.genai.errors.ServerError: 503 UNAVAILABLE (This model is currently experiencing high demand.) 발생.
원인: 순간적인 구글 API 서버 트래픽 급증 또는 연이은 질문 전송으로 인한 병목.
조치: 사이드바의 [대화 이력 초기화]를 통해 에러 상태를 리셋하고 재시도 유도.
이슈 2: 구형/미지원 모델명 호출에 따른 404 NOT_FOUND
증상:
models/gemini-2.5-flash is no longer available to new users. Please update your code to use models/gemini-3.6-flash...
models/gemini-1.5-flash is not found for API version v1beta...
models/gemini-2.0-flash is no longer available...
원인: 최신 google-genai SDK 환경 및 신규 API 키 정책에 따라 이전 세대 모델 엔드포인트가 차단됨.
실수 및 지연 요인:
에디터(VS Code)에서 app.py 소스 코드를 gemini-3.6-flash로 수정한 후 실제 디스크 저장(Ctrl + S)이 완료되지 않아 이전 코드가 계속 실행됨.
브라우저 세션에 이전 404 에러 로그가 남아 지속적으로 출력됨.
최종 해결 조치:
VS Code에서 app.py 169번 라인의 모델 호출 파라미터를 정식 권장 모델인 model="gemini-3.6-flash"로 명확히 수정.
파일을 확실히 저장(Ctrl + S)하여 미저장 표시(동그라미 점) 해제 확인.
브라우저 사이드바의 [대화 이력 초기화]를 눌러 세션 캐시 제거.
[단계 5] 질문 테스트 및 RAG 파이프라인 검증 성공
테스트 쿼리: 인건비의 용도는?
검색 및 추론 결과:
ChromaDB 벡터 검색을 통해 상위 4개 조항(Top-K=4)이 정확히 추출됨.
최고 유사도: [근거 1] 제6조(인건비 사용용도), 유사도 점수 0.6481.
gemini-3.6-flash 모델이 해당 근거 조항만을 토대로 4가지 항목(참여연구자 급여, 연구근접지원인력 급여, 기관부담금 및 퇴직급여충당금 등)을 조항 출처와 함께 체계적으로 서술함.
하단 [ 참고한 근거 조항 확인] 아코디언 컴포넌트를 통해 유사도 점수와 조항 원문이 사용자에게 정상적으로 노출됨.
- 주요 구성 요소별 사양 및 동작 특성
구분
적용 내용
상세 설명
LLM
gemini-3.6-flash
지연 시간이 짧고 RAG 컨텍스트 주입 추론에 최적화된 최신 경량 모델
Embedding
BAAI/bge-m3
1024차원 고밀도 다국어 임베딩 모델로 법률·규정집의 특정 키워드 및 의미 기반 검색 수행
청킹 엔진
정규식 기반 조항 분할
제N조 단위로 텍스트를 끊어 법률/사규의 완결된 의미 맥락을 보존
저장소 정책
단일 컬렉션 덮어쓰기
현재 코드는 문서 등록 시 기존 DB를 초기화하고 최신 1개 문서만 유지 (delete_collection 구조)
용량 한도
단일 파일 기준 200MB
Streamlit 기본 업로더 한도 적용, 실무 권장치는 10MB~30MB 텍스트 PDF
3-1. 추가 테스트 진행 : 소스 수정 없는 방법 검토
0. 당초 규정 집에서 다른 형태의 자료(보고서 형태) 등록 후 테스트 진행
당장 소스 수정 없이 테스트하는 임시 방법
소스를 당장 고치지 않고 일반 보고서를 테스트 진행, 업로드 후 좌측 사이드바에서:
청킹 전략을 조항/문단 단위 (추천) 대신 고정 500자 단위로 라디오 버튼을 변경하고 [문서 DB에 저장하기]를 진행하면 가능
이에 따라서 연구보고서 파일을 업로드하여 인베딩 작업 진행
3-2. 임베딩 작업 관련 : 테스트 PC의 GPU 한계 확인
1,000개가 넘는 대용량 청크를 로컬에서 빠르게 임베딩하기 위한 핵심 최적화 방법입니다.
1) 배치 크기(Batch Size) 확대
원리: 현재 embedder.encode(chunks)는 기본 배치 크기(보통 32개)로 데이터를 잘라 연산합니다. 배치 크기를 키우면 CPU 멀티스레드나 GPU 병렬 연산 코어를 더 꽉 채워 돌릴 수 있어 속도가 2~3배 이상 빨라집니다.
코드 적용 (app.py 101번 라인 부근):
Python
batch_size를 64 또는 128로 명시적 지정
vecs = embedder.encode(
chunks,
batch_size=64,
normalize_embeddings=True,
show_progress_bar=False
)
2) 외장 GPU(CUDA) 가속 활성화
원리: PyTorch가 CPU 전용 버전으로 설치되어 있으면 아무리 좋은 그래픽카드가 있어도 CPU로만 연산되어 수 분이 걸립니다. CUDA 지원 PyTorch를 활성화하면 1,250개 청크를 5~10초 내외로 끝낼 수 있습니다.
적용 방법:
현재 아나콘다 환경(gemini_rag)에서 GPU 인식 여부 확인:
Bash
python -c "import torch; print(torch.cuda.is_available())"
False가 나온다면 터미널에서 CUDA 버전에 맞는 PyTorch로 재설치합니다:
Bash
pip install torch --upgrade --index-url https://download.pytorch.org/whl/cu121
app.py 로딩 함수에 명시적 디바이스 지정:
Python
@st.cache_resource
def load_embedder():
import torch
device = "cuda" if torch.cuda.is_available() else "cpu"
return SentenceTransformer("BAAI/bge-m3", device=device)
3) 로컬 연산 대신 클라우드 임베딩 API(Google text-embedding)로 전환
원리: 내 PC 하드웨어 자원을 쓰지 않고, 이미 연동된 구글 클라우드 인프라에 텍스트 임베딩을 요청합니다.
장점: PC 사양(CPU/GPU)과 무관하게 1,000개 이상의 청크도 몇 초 안에 병렬로 변환되며 로컬 램 낭비가 전혀 없습니다.
코드 적용 방향:
Python
BGE-M3 로컬 모델 대신 Google GenAI 임베딩 API 활용
result = ai_client.models.embed_content(
model="text-embedding-004",
contents=chunks
)
4) 청크 크기(Chunk Size) 상향 조정
원리: 현재 500자 단위로 잘라 1,253개 청크가 생성되었습니다. chunk_size를 1,000자(overlap 100자)로 늘리면 전체 청크 개수가 약 500~600개 수준으로 줄어들어 연산량이 절반으로 단축됩니다.
3-2. 로컬 문서 Gemini RAG 챗봇 구축 최종 기록
1) 직면했던 문제점 및 원인 분석
문제 1: 모델 Deprecation에 따른 404 NOT_FOUND 에러
에러 내용: google.genai.errors.ClientError: 404 NOT_FOUND ('This model models/gemini-2.5-flash is no longer available to new users...')
원인: 초기 코드에 지정되어 있던 gemini-2.5-flash 모델 엔드포인트가 신규 요청에 대해 제공 중단(Deprecated)되어 구글 API 서버에서 해당 모델을 찾지 못함.
문제 2: 구글 서버 트래픽 스파이크로 인한 503 UNAVAILABLE 에러
에러 내용: google.genai.errors.ServerError: 503 UNAVAILABLE ('This model is currently experiencing high demand...')
원인: 최신 모델인 gemini-3.6-flash로 변경 후 API 호출이 진행되었으나, 특정 시점에 구글 측 서버로 요청이 집중되면서 일시적인 처리 리소스 부족 및 연결 불가 현상 발생. 기존 코드에는 예외 처리 및 재시도 로직이 없어 애플리케이션 화면에서 전체 Traceback 에러가 발생하며 중단됨.
2) 단계별 해결 방법
해결 1: 모델 식별자 최신화
generate_rag_answer_gemini 함수 내부의 모델 호출 파라미터를 사용 가능한 최신 모델인 gemini-3.6-flash로 교체.
해결 2: 지수 백오프(Exponential Backoff) 기반 자동 재시도 로직 구현
from google.genai.errors import ServerError를 임포트하여 서버 일시 장애를 감지하도록 구성.
API 호출 시 최대 3회(max_retries = 3)까지 재시도하는 for 루프를 배치.
1차 실패 시 2초 대기(delay_seconds * attempt), 2차 실패 시 4초 대기 후 점진적으로 재요청하여 일시적 트래픽 스파이크 구간을 자동으로 회피하도록 조치.
해결 3: 우아한 에러 핸들링 (Graceful Degradation)
3회 연속 503 에러가 발생하더라도 앱 전체가 크래시되지 않도록 구성.
예외를 터뜨리는 대신 "서버 사용량 급증으로 일시 응답 불가하니 잠시 후 다시 질문해 달라"는 정제된 안내 문구와 검색된 근거 조항(hits)을 함께 반환하도록 방어 코드 적용.
3) 최종 구축 및 검증 결과
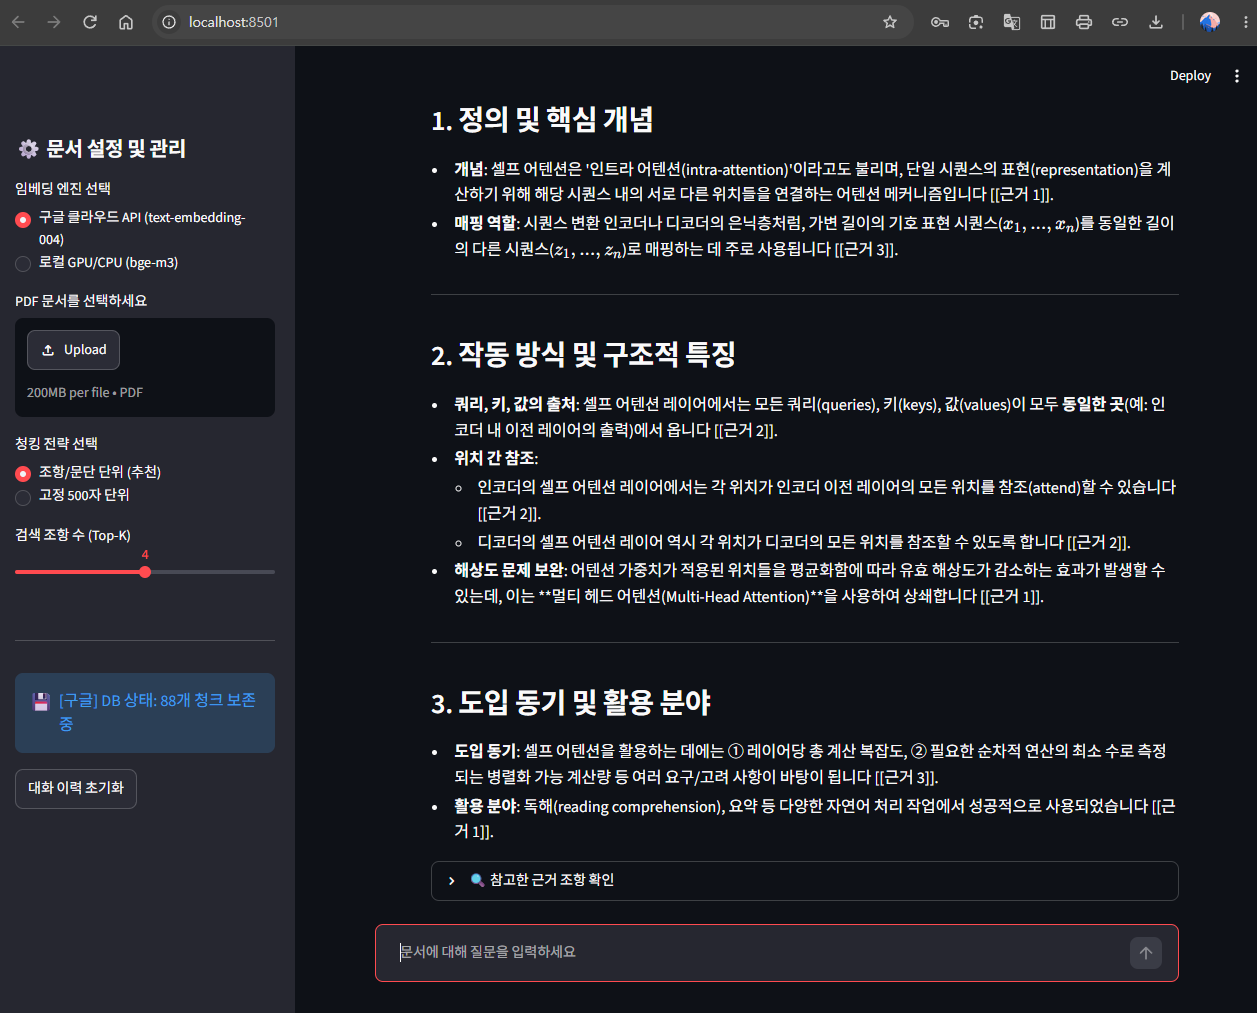
임베딩 및 색인: 구글 클라우드 임베딩(text-embedding-004) 및 조항/문단 단위 청킹을 적용하여 PDF 문서 총 88개 청크 정상 적재 완료.
질의응답 및 근거 검색: 트랜스포머의 개념, 셀프 어텐션의 메커니즘, 레이어당 계산 복잡도 등 기술 문서 질의에 대해 ChromaDB 벡터 검색 유사도(0.64~0.76) 기반의 정확한 근거 인용([근거 1]~[근거 4])과 함께 고품질 답변 생성을 최종 확인.
- 향후 고도화 및 개선 권장 과제
다중 문서 누적 적재 지원:
app.py 내 delete_collection 로직을 제거하고 메타데이터(doc_name) 기반 필터링 검색을 도입하여 여러 문서를 동시에 검색할 수 있도록 개선.
API 예외 처리(Retry) 내재화:
트래픽 급증에 따른 503 UNAVAILABLE 에러 발생 시 프로그램이 멈추지 않고 2~3초 간격으로 자동 재시도하는 tenacity 또는 try-except 재시도 블록 보강.
비정형 문서 확장:
pypdf 외에 표·도식 인식이 가능한 파서 추가 및 필요 시 HWP 문서 자동 텍스트 변환 모듈 연계 검토.
- 응답 서비스 성능을 개선하는 방법 조사(고찰)
5-1. 현재의 기술 스텍을 변경(개선)하는 방안으로,
각 컴포넌트별로 성능 병목을 해소하고 최신 API 생태계와 개발 확장성을 극대화하기 위한 기술 스택 교체 방안입니다.
계층
현재 스택
추천 대체 스택
변경 목적 및 성능 향상 효과
LLM Engine
gemini-3.6-flash
gemini-2.5-pro 또는 최신 Gemini Thinking 모델
복잡한 규정 해석, 단서 조항 비교, 다단계 추론 성능 대폭 강화 및 환각 최소화
문서 파싱
pypdf
PyMuPDF (fitz) 또는 Docling
파싱 속도 5~10배 향상, 법률/규정 내 표(Table)·다단 레이아웃 인식률 극대화
Embedding
BAAI/bge-m3
text-embedding-004 (Google Gemini API)
로컬 PC 연산 부하 제거, 차원 축소 지원 및 Gemini LLM과의 의미 공간 일치도 향상
Vector DB
ChromaDB (로컬)
Qdrant 또는 PostgreSQL (pgvector)
대용량 벡터 처리 성능 향상, 하이브리드 검색(Dense+Sparse) 네이티브 지원
Web UI
Streamlit
Chainlit 또는 FastAPI + Next.js
Streamlit 특유의 전체 재실행(Rerun) 렉 제거, 스트리밍 응답 지연 시간 단축
1) LLM Engine: Pro 계열 및 추론 모델로 상향
변경 방안: 단순 Flash 계열 대신 gemini-2.5-pro를 적용하거나 추론 기능(Thinking Budget)이 활성화된 모델을 채택합니다.
성능 효과: 현재 Flash 모델은 빠른 속도에 유리하지만 "회계 결산 방법"처럼 표현이 다른 질문에 대해 유연하게 문맥을 유추하는 능력이 다소 제한됩니다. Pro 계열은 규정 간 상충 관계나 단서 조항을 교차 검증하여 훨씬 완성도 높은 답변을 도출합니다.
2) 문서 파싱: PyPDF에서 구조화 파서(PyMuPDF / Docling)로 교체
변경 방안: 텍스트만 단순 추출하는 pypdf 대신 표 구조를 Markdown 형태로 변환해 주는 PyMuPDF나 IBM의 Docling을 도입합니다.
성능 효과: 규정 문서에 포함된 '별표(서식)', '정산 기준표', '지급 기준표' 등 테이블 데이터가 깨지지 않고 그대로 청크로 변환되어 표 관련 질문에 대한 검색 성공률이 획기적으로 상승합니다.
3) Embedding: 로컬 BGE-M3에서 Google text-embedding-004 API로 전환
변경 방안: 로컬 CPU/GPU 자원을 소모하는 BGE-M3 모델 로딩(SentenceTransformer)을 제거하고, 이미 연결된 Google GenAI API의 text-embedding-004 엔드포인트를 호출합니다.
성능 효과:
로컬 PC의 메모리 점유율을 대폭 낮추고 앱 초기 구동 속도를 단축합니다.
Google의 단일 API 파이프라인으로 통합되어 키 관리 및 코드베이스가 단순화됩니다.
4) Vector DB: ChromaDB에서 Qdrant 또는 pgvector로 전환
변경 방안: 단일 파일 덮어쓰기에 그치는 로컬 ChromaDB 구조를 Qdrant(로컬 임베디드 모드 지원) 또는 PostgreSQL(pgvector)로 이전합니다.
성능 효과:
하이브리드 검색 기본 내장: 밀집 벡터(시맨틱)와 희소 벡터(키워드/BM25)를 별도 라이브러리 없이 엔진 자체에서 고속 결합합니다.
메타데이터 필터링: 문서 버전, 부서, 생성 연도 등 다차원 필터를 걸고 대량의 문서를 누적 검색할 때 검색 지연이 거의 발생하지 않습니다.
5) 프레임워크 및 UI: Streamlit에서 Chainlit 또는 FastAPI + Modern Web으로 전환
변경 방안: 버튼 클릭 시 전체 스크립트가 위에서부터 재실행되는 Streamlit 구조를 벗어나 LLM 전용 UI 프레임워크인 Chainlit이나 FastAPI + Next.js 백/프론트엔드로 분리합니다.
성능 효과:
토큰 단위 스트리밍 체감 속도: 사용자가 첫 단어를 보기까지 걸리는 응답 대기 시간(TTFT)을 1초 미만으로 단축합니다.
중복 렌더링 방지: 대화 기록이나 슬라이더 조작 시 화면이 깜빡거리며 코드가 재수행되는 오버헤드를 원천 차단합니다.
5-2. 구축된 RAG 시스템의 답변 품질과 검색 정확도를 한 단계 더 끌어올리기 위한 실무 개선 방안으로,
1) 하이브리드 검색(Hybrid Search) 도입
현황: 현재는 BGE-M3 밀집 벡터(Dense Vector) 기반의 시맨틱 검색만 수행합니다.
개선: 키워드 일치율을 정밀하게 잡는 BM25(희소 검색)와 문맥을 이해하는 Dense 검색을 앙상블(Reciprocal Rank Fusion 등)하여 결합합니다. 고유 명사, 법조문 번호(예: 제18조제2항), 전문 용어 검색 시 누락을 대폭 줄일 수 있습니다.
2) 리랭커(Reranker) 파이프라인 추가
현황: ChromaDB에서 벡터 유사도 상위 K개(예: 4~6개)를 바로 LLM 프롬프트에 넣습니다.
개선: 1차 검색에서 Top-K를 15~20개로 넉넉하게 뽑은 뒤, bge-reranker-large 같은 Cross-Encoder 모델로 재채점(Rerank)하여 가장 질문과 밀접한 최상위 3~4개만 LLM에 전달합니다. 질문과 무관한 조항이 프롬프트 노이즈로 작용하는 현상을 차단합니다.
3) 청크 메타데이터 보강 (Contextual Chunking)
현황: 조항 번호와 본문 텍스트만 분할되어 청크로 저장됩니다.
개선: 각 청크 앞에 문서 계층 구조를 명시합니다. (예: [제3장 연구개발비 관리 > 제2절 직접비 사용기준] 제18조...) 이렇게 상위 카테고리 맥락이 청크 텍스트에 포함되면 임베딩 벡터가 훨씬 더 정밀해집니다.
4) 쿼리 변환 및 확장 (Query Expansion / Multi-Query)
현황: 사용자가 입력한 짧은 단문 질문(인건비의 용도는?, 회계 결산 방법과 절차는?)을 그대로 임베딩합니다.
개선: 사용자의 질문을 LLM을 통해 규정 문서에 등장할 법한 전문 법률 용어로 2~3개 변환(예: 회계 결산 -> 연구개발비 사용실적 보고 및 정산 기준)한 후 검색하여 관련 조항을 누락 없이 찾아냅니다.
5) 프롬프트 엔지니어링 튜닝
현황: temperature=0.2로 고정되어 환각을 방지하고 있습니다.
개선: 시스템 지침에 "근거 조항 간의 내용이 상충되거나 예외 조항(단서 조항)이 있는 경우 함께 구분하여 설명할 것", "표나 불릿 포인트를 활용하여 단계별 절차를 명시할 것" 등의 구체적인 답변 템플릿 지침을 추가하여 가독성과 완결성을 높입니다.
5-3 현재 프로그램의 한계와 및 제약사항은 법률이나 규정과 같이 각조와 항으로 구성된 파일에 적합하게 되었음. 일반 보고서(사업계획서, 연구보고서, 시장분석 자료 등)를 다루려면 소스 코드를 반드시 수정하거나 설정을 변경해야 합니다.
현재 소스 코드가 법률·규정집의 고유 형식에 맞춰져 있어 발생하는 문제점과 수정해야 할 구체적인 포인트는 다음과 같습니다.
1) 청킹(Chunking) 로직 수정 (chunk_by_article_or_paragraph)
현재 상태: 제\s\d+\s조 정규식을 사용해 '제N조'를 기준으로만 문서를 자릅니다.
문제점: 일반 보고서에는 '제N조'라는 표현이 없습니다. 따라서 정규식 매칭에 실패하여 단순히 빈 줄(\n\n)이나 500자 단위로 강제 분할되어 문맥이 끊기게 됩니다.
수정 방향: 보고서에서 흔히 쓰이는 목차·개조식 헤딩 번호 체계를 인식하도록 정규식을 확장해야 합니다.
예: 1. , 1) , (1) , 가. , ■ , ● 또는 마크다운 헤더(#, ##) 기준 분할
Python
수정 예시: 보고서 목차 기호 인식 패턴 추가
report_pattern = re.compile(r"(?m)^(\d+.\s+[^\n]+|[가-힣].\s+[^\n]+|■\s+[^\n]+)")
2) 시스템 프롬프트(System Instruction) 수정 (generate_rag_answer_gemini)
현재 상태:
"당신은 사내 규정 및 법률 문서 안내 전문 AI 비서입니다. ... 답변 끝에는 반드시 인용한 근거(예: 제33조 제1항 등)를 명확히 밝히세요."
문제점: AI에게 '법률 비서' 역할이 부여되어 있고 '조항 번호'를 인용하라고 강제되어 있어, 보고서 문서에 대해 어색하게 답변하거나 조항이 없다는 이유로 답변을 회피할 수 있습니다.
수정 방향: 범용 비서 역할과 페이지·단락 번호 인용 방식으로 변경합니다.
Python
수정 예시
system_instruction = (
"당신은 사내 문서 및 전문 보고서 분석 비서입니다.\n"
"반드시 아래 제공된 [문서 내용]만을 바탕으로 질문에 대해 명확하고 논리적으로 답변하세요.\n"
"답변 끝에는 참고한 문서의 제목이나 근거 번호([근거 1], [근거 2] 등)를 명시하세요.\n"
"제공된 내용에서 확인할 수 없는 내용은 억지로 꾸며내지 말고 '문서에서 확인되지 않습니다.'라고 답하세요."
)
3) PDF 텍스트 추출 방식 개선 (extract_text_from_pdf)
현재 상태: pypdf.PdfReader로 단순 텍스트만 읽어옵니다.
문제점: 보고서에는 도표(Table), 2단 구성(다단 편집), 통계 데이터가 많습니다. pypdf는 표의 셀 구조를 무시하고 줄 단위로 글자만 긁어오기 때문에 표 내용이 뒤섞여 검색 정확도가 크게 떨어집니다.
수정 방향: 표 구조를 Markdown 형식으로 보존해 주는 pdfplumber나 PyMuPDF(fitz)로 파서를 교체하는 것이 훨씬 유리합니다.
당장 소스 수정 없이 테스트하는 임시 방법
소스를 당장 고치지 않고 일반 보고서를 올리시려면, 업로드 후 좌측 사이드바에서:
청킹 전략을 조항/문단 단위 (추천) 대신 고정 500자 단위로 라디오 버튼을 변경하고 [문서 DB에 저장하기]를 진행하면 가능
이에 따라서 연구보고서 파일을 업로드하여 인베딩 작업 진행
클로드 강의 내용 정리
강의 노트에 담긴 핵심 메시지는 "AI를 만능 해결사로 두고 방임하는 것이 아니라, 인간이 명확한 핸들(주도권)을 쥐고 구조와 검증 체계를 통제하는 엔지니어링 파트너로 활용하라"는 것입니다. 제시된 원칙별 심층 의미와 실무 실행 방안은 다음과 같습니다.
1. 하지 말아야 할 것 (Don'ts)
① 처음부터 과도한 풀세팅·하네스 구축 지양
- 핵심 의미: 툴, 프레임워크, 수많은 스킬과 플러그인을 시작부터 얹으면 시스템 복잡도만 올라가고 어디서 문제가 생겼는지 추적하기 어려워집니다. 클로드 자체의 기본 성능을 파악하는 것이 우선입니다.
- 실행 방안:
- 가장 순수한 기본 클로드 환경(CLI 또는 기본 대화창)에서 작업을 시작합니다.
- 작업 중 동일한 실수가 3회 이상 반복되거나, 매번 손으로 반복하는 번거로운 패턴이 명확해질 때만 해당 불편을 해소할 최소한의 스킬/규칙을 하나씩 추가합니다.
② 도구에 대한 FOMO(Fear Of Missing Out) 경계
- 핵심 의미: 커뮤니티나 남들이 유행처럼 쓰는 워크플로우와 프롬프트 템플릿이 내 프로젝트 환경과 비즈니스 로직에 반드시 들어맞는 것은 아닙니다.
- 실행 방안:
- 최신 유행 도구를 무조건 도입하지 말고, 내 작업에서 "이 도구가 없어서 생기는 병목이 실제로 존재하는가?"를 먼저 점검합니다.
③ AI에게 운전대(핸들)를 넘기지 말 것
- 핵심 의미: "알아서 다 짜줘", "이 오류 알아서 해결해줘" 식의 지시는 환각(Hallucination)과 비효율적 코드 양산의 지름길입니다. 테슬라 FSD를 쓰더라도 목적지와 안전 확인은 운전자의 몫이듯, 설계와 최종 의사결정은 인간이 해야 합니다.
- 실행 방안:
- 문제 해결 방식과 기술 스택, 라이브러리는 인간이 이미 검증한 규격으로 지정해 줍니다.
- 큰 덩어리를 통째로 넘기지 않고, 작게 쪼갠 단위 작업(모듈, 함수, 스키마) 단위로만 명령합니다.
2. 반드시 해야 할 것 (Dos)
① 컨텍스트 다이어트 및 세션 관리
- 핵심 의미: 대화창에 파일, 로그, 이전 오류 메시지가 계속 누적되면 컨텍스트 창이 오염되고 집중도가 떨어져 모델 성능이 급격히 저하됩니다. 실패한 시도의 로그가 남아있으면 미래의 추론에도 나쁜 편향을 줍니다.
- 실행 방안:
- 프레시한 세션 유지: 실패하거나 막힌 태스크는 계속 붙잡고 늘어지지 말고, 실패한 메시지를 지우거나 새 세션을 열어 정제된 요구사항으로 다시 시작합니다.
- 문서 정제:
claude.md나 시스템 지침은 모든 걸 적지 않고, 반드시 지켜야 할 핵심 규칙 4~5개 위주로 간결하게 유지합니다 (지침이 너무 길면 모델이 일부를 무시함).
② 구체적인 진짜 계획(Spec-First) 수립
- 핵심 의미: 내가 구현하려는 서비스의 입출력 규격, 상태 코드, 종료 조건(Definition of Done)을 모른 채 코딩을 시작하면 엉뚱한 결과가 나옵니다. 상세한 지시와 스펙 정의가 곧 AI 협업의 본질입니다.
- 실행 방안:
- 로직 구현에 들어가기 전, DB 스키마(DDL), Pydantic/인터페이스 스키마, API 엔드포인트 명세를 먼저 작성하게 하고 인간이 승인(Sign-off)합니다.
- "코드를 바로 짜지 말고, 요구사항에 대한 구현 계획과 파일 구조부터 출력해"라고 먼저 제약합니다.
③ 검증 체계 구축 (피드백 루프)
- 핵심 의미: 클로드가 짠 코드가 맞는지 스스로 검증할 수 있는 '시험지'를 사람이 쥐어주어야 합니다. 검증 수단이 없으면 AI의 "잘 동작합니다"라는 말에 속게 됩니다.
- 실행 방안:
- 코드 작성 지시 시 테스트 코드(pytest, 단위 테스트)를 항상 함께 작성하도록 강제합니다.
- 터미널 실행 결과와 테스트 통과 로그를 직접 눈으로 확인한 뒤 다음 단계로 넘어갑니다.
④ 비판적 사고 및 레드팀(Red Teaming) 관점 질의
- 핵심 의미: AI는 기본적으로 사용자의 제안에 순응하려는 성향(Sycophancy)이 강합니다. 무조건적인 긍정 답변을 차단하고 빈틈을 찾아내도록 역할을 부여해야 합니다.
- 실행 방안:
- 예시 프롬프트 전환:
- ❌ "유튜브 링크로 일주일치 인스타 글 써주는 서비스 월 9,900원에 만들려는데 어때?"
- "내가 이 서비스에 네 돈을 투자한다고 했을 때, 절대 손해보지 않도록 결함, 한계점, 비용 구조, API 단가 문제를 철저하게 비판적으로 분석해줘."
초보개발자를 위한 클로드 사용법?
1. 코드 작성보다 '에러 해결 및 코드 리뷰'에 먼저 쓰기
- 에러 로그 원문 그대로 붙여넣기: 터미널에 뜬 에러 스택 트레이스 전체와 관련 함수 코드를 함께 전달한 뒤,
"원인과 해결 방법을 단계별로 설명해 줘"라고 요청하면 원인 분석부터 수정 코드까지 빠르게 파악할 수 있습니다. - 작성한 코드 리뷰 요청: 직접 짠 코드를 넣고
"초보자 관점에서 가독성, 예외 처리, 비효율적인 로직이 있는지 피드백해 줘"라고 프롬프트를 작성해 코드 품질을 점검받으세요.
2. '코드 생성기'가 아닌 '1:1 과외 튜터'로 활용하기
- 한 줄씩 동작 원리 질문: 이해가 가지 않는 오픈소스나 라이브러리 코드를 붙여넣고
"이 코드의 각 줄이 어떤 역할을 하는지 초보자도 알기 쉽게 주석을 달아 설명해 줘"라고 요청합니다. - 비유를 통한 개념 학습:
"비동기 처리(async/await)와 멀티스레드의 차이점을 일상적인 예시로 비유해서 설명해 줘"와 같이 추상적인 CS 개념을 구체화하는 데 유용합니다.
3. 기능 구현 시 '단계적(점진적) 프롬프트' 사용하기
- 한 번에 전체 앱을 요청하지 않기:
"쇼핑몰 사이트 만들어줘"대신,"Python FastAPI로 상품 목록을 조회하는 단일 엔드포인트부터 작성해 줘"처럼 요구사항을 잘게 쪼개어 요청해야 코드 완성도와 이해도가 높아집니다. - 스택과 환경 명시하기: 언어 버전, 사용하는 프레임워크, 라이브러리 버전을 프롬프트 서두에 명시해야 구버전 문법이나 엉뚱한 라이브러리 사용을 방지할 수 있습니다.
4. Claude 핵심 기능 적극 활용
- Projects(프로젝트) 기능 활용: 프로젝트에 사용하는 기술 문서(Docs), 코딩 컨벤션, DB 스키마(ERD) 등을 지식 베이스(Files)로 미리 업로드해 두면 매번 배경 설명을 반복하지 않고도 일관된 답변을 얻을 수 있습니다.
- Artifacts(아티팩트) 활용: 웹 프론트엔드(HTML/React/Tailwind)나 다이어그램(Mermaid) 코드를 생성할 때 우측 프리뷰 창에서 동작 결과를 즉시 시각적으로 확인하며 수정할 수 있습니다.
클로드 사용법은?
1. 프롬프트 구조화: 역할-배경-지시-제약 조건
Claude는 문맥 이해력과 지시 준수 능력이 뛰어납니다. 단순 질문보다 4단계 프레임워크로 입력하면 답변 품질이 크게 올라갑니다.
- 역할(Role):
"당신은 10년 차 Python 백엔드 아키텍트입니다." - 배경 및 맥락(Context):
"현재 Fastify 대신 Express를 쓰고 있으며, 사용자 수가 급증해 DB 연결 풀이 고갈되는 문제가 있습니다." - 핵심 지시(Task):
"커넥션 풀 고갈을 방지할 수 있는 연결 관리 설정 예시 코드를 작성해 주세요." - 제약 조건(Constraints):
"외부 서드파티 라이브러리 추가 없이 기본 pg 모듈만 사용할 것, 주석으로 각 설정값의 이유를 달아줄 것."
2. 긴 문서 분석 및 멀티모달 활용
Claude는 200k 토큰(책 1~2권 분량)에 달하는 대용량 컨텍스트 윈도우를 지원합니다.
- 대용량 파일 통째로 업로드: PDF 보고서, API 명세서, 수백 줄의 CSV 데이터를 첨부한 뒤 질문합니다.
- 예시:
"첨부된 50페이지 분량의 사업계획서에서 리스크 요인 3가지만 발췌해 표로 정리해 줘."
- UI/화면 캡처 기반 질의: 웹페이지 UI 캡처 이미지나 에러 화면 스크린샷을 첨부하고,
"이 레이아웃을 Tailwind CSS와 React 컴포넌트로 똑같이 구현해 줘"또는"이 에러 팝업의 해결 절차를 알려줘"라고 요청할 수 있습니다.
3. 핵심 생산성 기능: Projects와 Artifacts
- Projects (지식 베이스 구축):
- 유료(Pro/Team) 플랜에서 지원하는 기능으로, 프로젝트마다 고유한 지식 베이스(Files)와 커스텀 지침(Custom Instructions)을 지정할 수 있습니다.
- 회사 코딩 컨벤션, DB 스키마(DDL), API 레퍼런스 문서를 올려두면 매번 새로운 대화방마다 사전 정보를 반복 설명할 필요 없이 일관된 답변을 얻습니다.
- Artifacts (실시간 인터랙티브 프리뷰):
- 독립적인 코드, 웹 컴포넌트(HTML/CSS/JS, React), SVG 그래픽, Mermaid 다이어그램, 긴 문서를 생성할 때 우측 전용 창(Artifact)에 분리되어 표시됩니다.
- 프론트엔드 UI 컴포넌트나 다이어그램을 브라우저 내에서 즉시 시각적으로 렌더링해 테스트하고, 수정 사항을 대화창에서 바로 반영할 수 있습니다.
4. 실전 워크플로우 팁
- 단계별 점진적 개발(Step-by-step):
"로그인, 결제, 장바구니가 있는 쇼핑몰을 만들어줘"처럼 거대한 작업을 한 번에 요청하면 완성도가 떨어집니다.DB 스키마 설계엔드포인트 API 작성예외 처리 및 유효성 검사 추가단위 테스트 코드 작성순서로 작업을 쪼개어 단계별로 진행하세요.
- XML 태그 활용:
- Claude는 XML 태그 구조를 매우 잘 인식합니다. 지시문과 입력 데이터를 명확히 분리할 때 유용합니다.
<guidelines>
- 한국어로 답변할 것
- 핵심 결론을 먼저 제시할 것
</guidelines>

<context>
(여기에 분석할 텍스트나 코드 붙여넣기)
</context>

위 가이드라인에 따라 context의 내용을 분석해 주세요.
클로드와 클로드 코드의 차이?
Claude(클로드)는 앤트로픽의 범용 생성형 AI 모델 및 챗봇 서비스 전반을 의미하며, Claude Code(클로드 코드)는 개발 환경(CLI/터미널)에서 코드 작성과 관리를 직접 수행하도록 특화된 에이전트형 개발 도구입니다.
두 도구의 주요 차이점은 다음과 같습니다.
| 구분 | Claude (기본 서비스) | Claude Code (클로드 코드) |
|---|---|---|
| 주요 형태 | 웹 브라우저, 데스크톱 앱, 모바일 앱 | 터미널 기반 CLI(명령줄 인터페이스) 도구 |
| 주 사용 목적 | 문서 작성, 번역, 리서치, 아이디어 구상, 일반 코드 질의응답 | 실제 로컬/원격 코드베이스 내 작업 자동화 및 개발 지원 |
| 코드 처리 방식 | 복사/붙여넣기 기반 (아티팩트 미리보기 지원) | 로컬 파일 읽기/쓰기, 파일 직접 생성 및 편집 |
| 시스템 제어 | 불가 (브라우저 샌드박스 내부 동작) | 터미널 명령 실행, 테스트/빌드 수행, Git 커밋/PR 생성 지원 |
| 대상 사용자 | 일반 사용자, 기획자, 학생, 개발자 등 폭넓은 사용자층 | 실제 개발 환경(터미널)에서 작업하는 소프트웨어 엔지니어 |
- Claude는 일반적인 대화형 AI로, 긴 문서 분석이나 기획서 작성부터 간단한 코드 스니펫 생성 및 리뷰까지 다양한 지적 작업을 대화 형태로 해결합니다.
- Claude Code는 개발자가 사용하는 터미널 안에서 실행되며, 로컬 프로젝트의 디렉터리 구조를 이해하고 파일 수정, 버그 수정, 테스트 실행, Git 작업 등을 자율적으로 수행하는 에이전트 역할을 합니다.