9월11일(금)
마인드 맵 = DBMS와 스토리지의 변천사
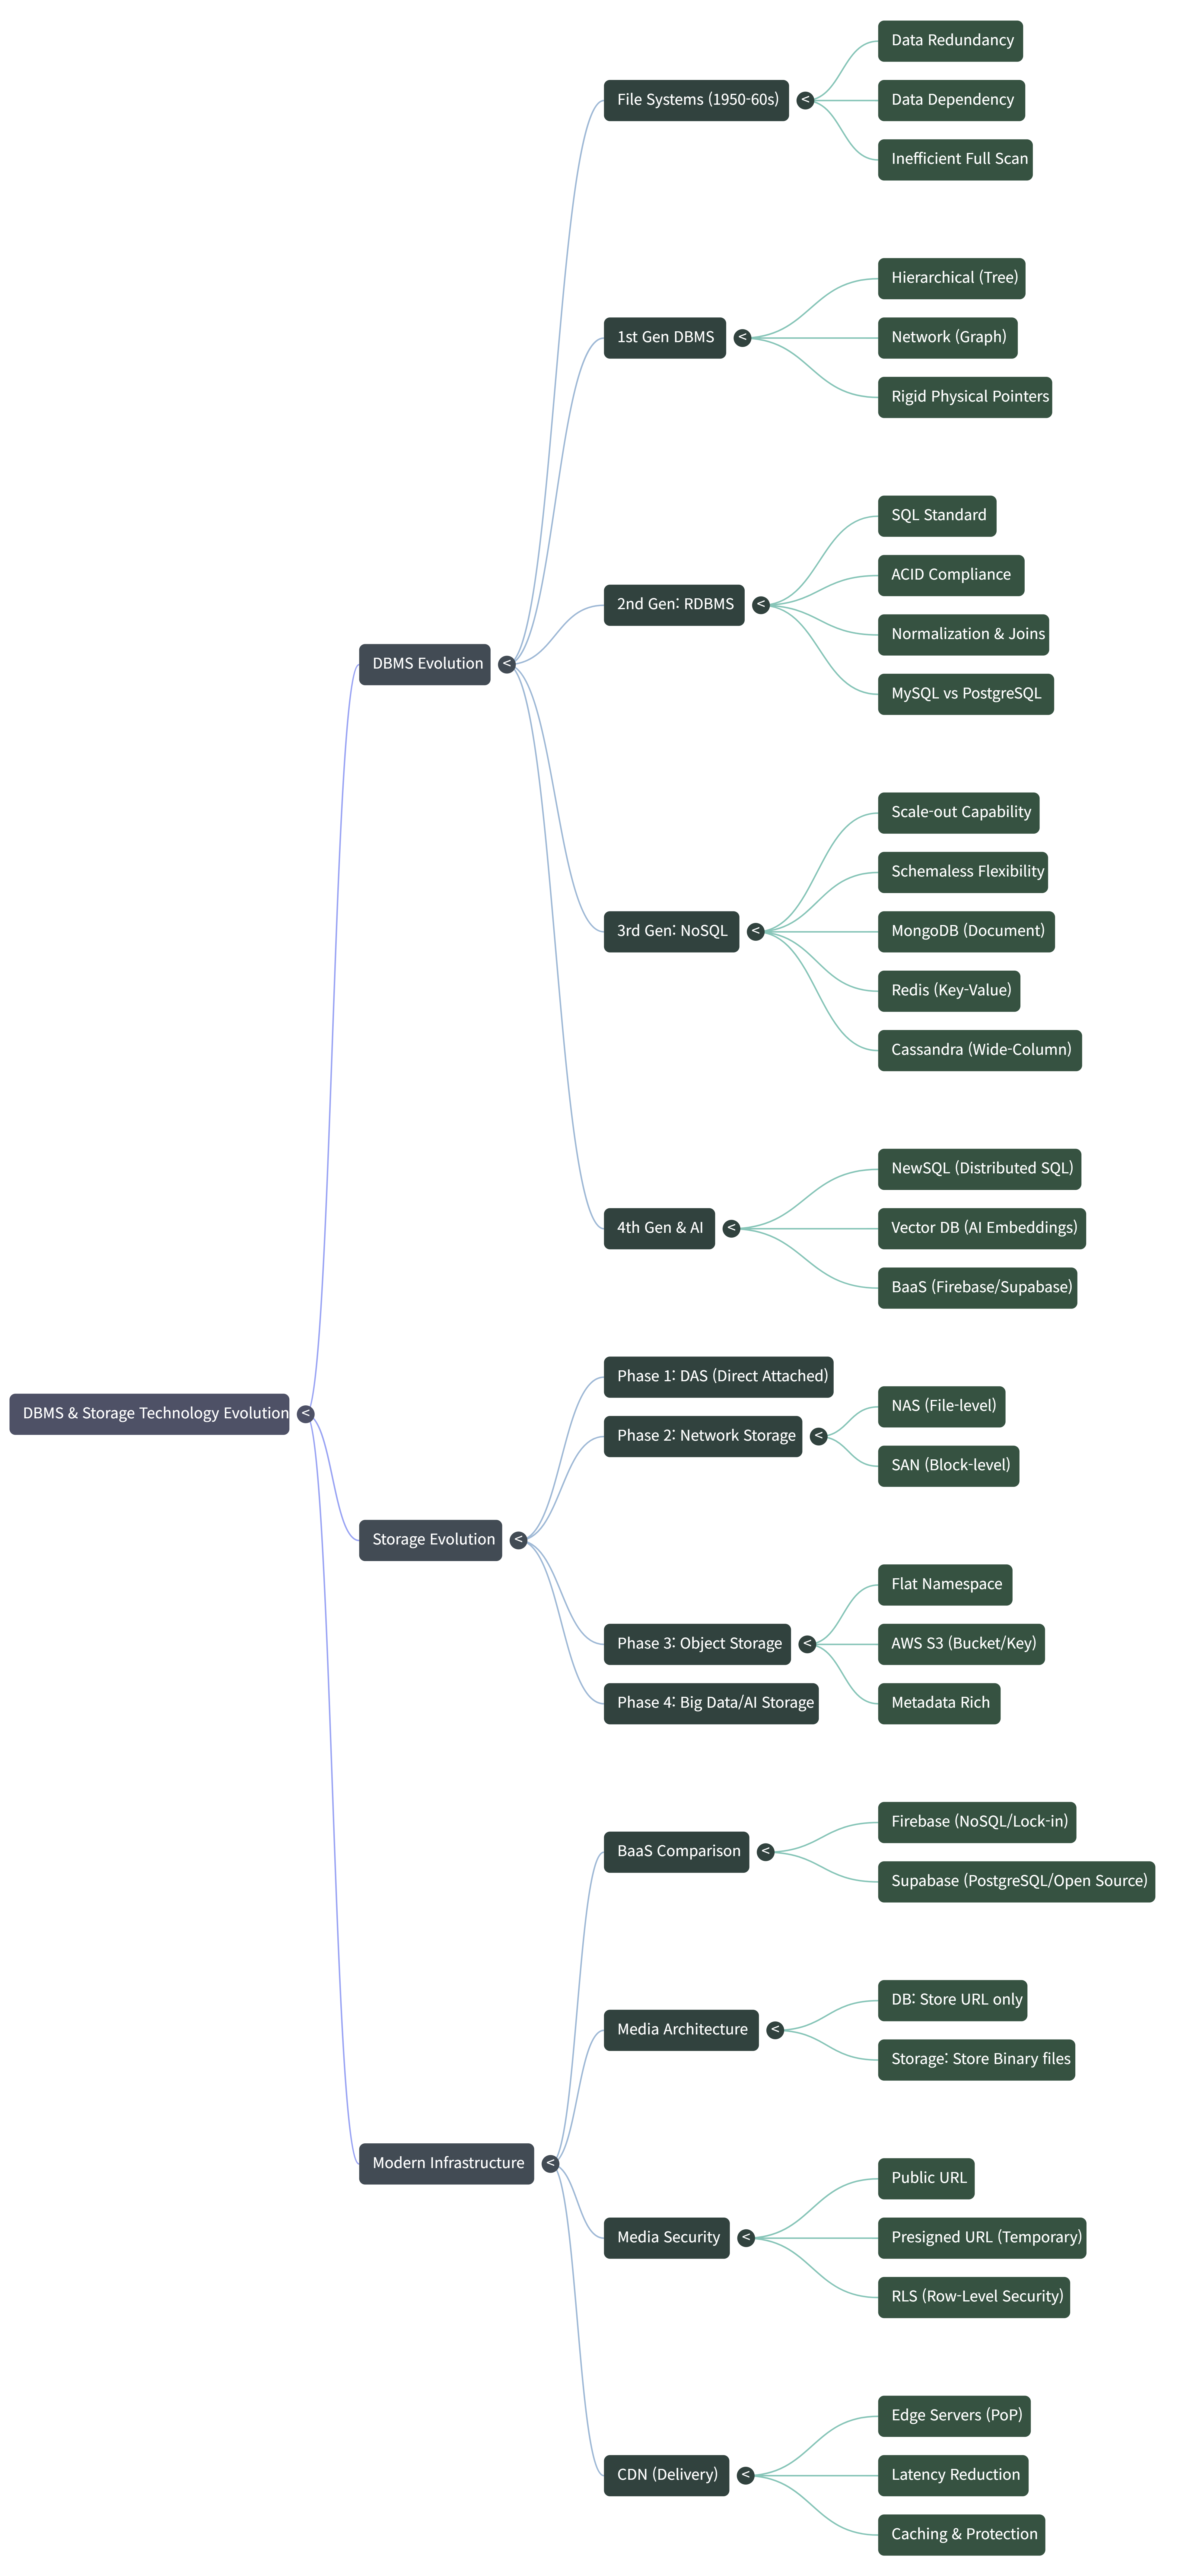
DBMS의 변천사
현재 가지고 계신 소스(노트북 소스)에서는 다음 데이터베이스 관련 정보들이 포함되어 있습니다:
- 관계형 데이터베이스 (RDBMS): MySQL, PostgreSQL, Oracle, SQLite, MS SQL Server 등 테이블 및 관계 기반의 데이터베이스
- 비관계형 데이터베이스 (NoSQL): MongoDB, Redis 등 유연한 스키마 구조를 가진 저장소
- AI 시대의 벡터 데이터베이스 (Vector DB): ChromaDB, Pinecone, pgvector 등 AI 임베딩 데이터를 다루는 DB
- 트랜잭션 ACID 원칙: 데이터 무결성과 신뢰성을 보장하는 4대 특성
다만, 수작업 장부 관리 시대에서 초기 파일 시스템으로의 이행 과정이나 1960~70년대 계층형/망형 데이터베이스와 같은 초창기 DB 탄생 역사와 변천 과정은 제시된 소스에서 해당 정보를 찾을 수 없습니다.
📜 자료관리의 변천사 및 DB 탄생·발전사 (Step-by-Step)
[1. 수작업 장부] ──> [2. 파일 시스템] ──> [3. 계층/망형 DB] ──> [4. RDBMS (SQL)] ──> [5. NoSQL] ──> [6. Vector DB / AI]
   종이 보관           디스크 파일 저장       트리/그래프 포인터       2차원 표 (Table)       JSON/Document     고차원 임베딩 벡터
   수동 검색           중복 & 종속성 문제     복잡한 포인터 연결       ACID 트랜잭션 보장     유연 스키마/분산     RAG / 시맨틱 검색
1단계: 수작업 수기 관리 시대 (Manual Record Keeping)
- 개념: 컴퓨터가 도입되기 전, 모든 데이터를 서류 봉투나 종이 장부에 직접 손으로 적어 파일 래크(가구)에 보관하던 방식입니다.
- 비유: 식당 카운터의 '수기 종이 장부'
- 한계: 데이터 검색 속도가 대단히 느리고, 종이가 불타거나 훼손되면 복구가 불가능하며, 여러 사람이 동시에 장부를 볼 수 없는 치명적 한계가 존재했습니다.
2단계: 파일 시스템 시대 (File System Era)
- 개념: 컴퓨터의 등장과 함께 디스크 저장장치에 텍스트 파일이나 전용 파일 구조(.txt, .csv)로 데이터를 보관하던 방식입니다 (C언어의 파일 입출력 등).
- 비유: 개인 PC 폴더 속의 '엑셀(.xlsx) 파일들'
- 치명적 한계점:
- 데이터 종속성 (Data Dependency): 파일 구조(예: 고객 이름 길이를 20자에서 30자로 변경)가 바뀌면, 그 파일을 읽어오는 모든 프로그래밍 소스 코드를 새로 수정해야 했습니다 .
- 데이터 중복성 및 불일치 (Data Redundancy & Inconsistency): 영업부와 인사부가 동일한 고객 데이터를 각자의 파일로 관리할 경우, 한쪽만 주소를 수정하면 부서 간 데이터가 서로 달라지는 정보 불일치가 발생했습니다 .
- 동시성 제어 및 보안 부재: 여러 프로그램이나 사용자가 동시에 같은 파일에 접근해 글을 쓸 때 데이터가 깨지며, 파일 단위 보안 외에 특정 열(컬럼) 단위 세부 보안 설정이 불가능했습니다.
3단계: 1세대 데이터베이스 — 계층형(HDBMS) & 망형(Network DBMS) DB의 탄생
파일 시스템의 중복성과 종속성을 해결하기 위해, 1960년대 데이터 간의 '연관 관계'를 포인터로 연결하는 최초의 데이터베이스 관리 시스템(DBMS)이 탄생했습니다.
- 계층형 DB (Hierarchical DBMS - 예: IBM IMS):
- 데이터를 트리(Tree) 구조(부모-자식 관계)로 연결하여 관리했습니다.
- 한계: 부모 하나에 자식 여럿(1:N) 구조만 가능하여, 자식이 부모를 여럿 가질 수 있는 다대다(N:M) 관계를 표현하려면 데이터를 중복 복사해야 하는 한계가 존재했습니다.
- 망형 DB (Network DBMS - 예: CODASYL IDMS):
- 계층형의 한계를 극복하고자 데이터를 그래프(Graph) 구조(노드와 엣지)로 묶어 N:M 관계를 표현했습니다.
- 한계: 데이터 구조가 복잡해질수록 연결 포인터가 기하급수적으로 늘어나 관리가 어렵고, 프로그램과의 독립성을 완전히 확보하지 못했습니다.
4단계: 2세대 데이터베이스 — 관계형 데이터베이스(RDBMS)의 혁명
1970년 에드가 F. 커드(Edgar F. Codd) 박사의 논문에서 제안된 '관계형 모델'을 바탕으로, 현대 DB의 표준이 된 RDBMS가 등장했습니다.
- 혁신 (논리 구조와 물리 구조의 완전 분리):
- 복잡한 포인터 연결 대신, 데이터를 사람이 이해하기 쉬운 행(Row)과 열(Column)을 가진 2차원 표(Table) 형태로 구성합니다.
- SQL (Structured Query Language)이라는 대중적인 표준 언어로 데이터를 손쉽게 조회/수정/삭제합니다.
- ACID 원칙: 원자성, 일관성, 격리성, 지속성을 완벽히 보장하여 금융 및 기업의 핵심 시스템에서 데이터 무결성을 수호합니다.
- 대표 제품: Oracle, MySQL, PostgreSQL, SQLite, MS SQL Server
- 새로운 한계: 2000년대 인터넷 폭발로 대용량 소셜 미디어, 이미지/영상/JSON 등 비정형 데이터가 쏟아지자, 엄격한 스키마 구조와 서버 스케일아웃(수평 확장)의 한계에 봉착했습니다.
5단계: 3세대 데이터베이스 — NoSQL의 등장과 빅데이터 시대
21세기 초 초거대 웹 서비스(Facebook, Amazon 등)의 등장과 함께, 고정된 스키마 없이 빠르고 자유롭게 수평 확장이 가능한 NoSQL (Not Only SQL)이 대세로 부상했습니다.
- 핵심 특징:
- 유연한 스키마: 사전 정의 없이 자유롭게 필드를 추가/변경합니다.
- 수평적 확장성 (Scale-out): 고가의 단일 서버 대신 저렴한 서버 노드를 대량으로 연결하여 대규모 빅데이터를 분산 저장합니다.
- 주요 모델:
- 문서(Document) DB: JSON/BSON 구조로 데이터를 유연하게 저장 (예: MongoDB)
- 키-값(Key-Value) DB: 초고속 인메모리 캐싱 및 세션 처리 (예: Redis)
- 와이드 컬럼 / 그래프 DB
6단계: 4세대 데이터베이스 — AI 시대의 Vector DB & Multi-Modal DB
LLM(대형 언어 모델)과 생성형 AI의 등장으로, 단순 텍스트 키워드 일치를 넘어 의미적 유사도(Semantic Search)를 찾아내는 벡터 데이터베이스(Vector DB)가 최신 트렌드로 자리잡았습니다.
- 혁신: 문장, 이미지, 오디오 데이터를 AI 임베딩 모델을 통해 고차원의 숫자 배열(Vector)로 변환해 저장하고, RAG (Retrieval-Augmented Generation, 검색 증강 생성)를 지원하여 AI의 환각(Hallucination)을 방지합니다.
- 대표 제품 & 형태:
- 전용 Vector DB: ChromaDB, Pinecone, Milvus, Qdrant
- 멀티모달 하이브리드 DB: 기존 RDBMS에 벡터 검색 기능을 결합한 PostgreSQL의
pgvector및 Oracle/Redis의 벡터 확장
스토리지 시스템의 발전사
Here's what I found on 인터넷 기술 발전사: 파일 시스템, 스토리지 기술 및 AWS S3:
인터넷 서비스의 대형화 및 클라우드 기술의 발전 과정에서 스토리지는 단일 서버 중심의 로컬 블록 스토리지에서 시작하여, 네트워크 공유를 위한 파일 스토리지(NAS/NFS)를 거쳐, 페타바이트급 비정형 데이터를 자유롭게 다루는 AWS S3 기반 오브젝트 스토리지(Object Storage)로 진화해 왔습니다. 최근에는 S3 버킷 내 오브젝트를 기존 애플리케이션 수정 없이 파일 시스템으로 직주 접근할 수 있는 Amazon S3 Files 기술까지 등장하여 파일 스토리지와 오브젝트 스토리지의 경계가 결합되고 있습니다.
Key themes I noticed:
1. 로컬 블록 스토리지 (Block Storage): OS 커널에서 디스크의 블록 단위에 직접 접근하는 방식(ext4, NTFS 등)으로, 입출력 속도가 극도로 빠르지만 단일 서버 디스크 용량 한계에 종속되어 다수 서버 간 파일 공유가 불가능했습니다.
-
네트워크 파일 시스템 (NAS / NFS / SMB): 네트워크(LAN)를 이용해 여러 웹 서버가 하나의 파일 서버 디렉토리 트리를 공유하는 구조로 발전했으나, 트래픽 폭주 시 중앙 파일 서버에 병목이 생겨 대규모 인터넷 서비스의 수평적 확장(Scale-out)에 한계가 있었습니다.
-
AWS S3 오브젝트 스토리지 혁명 (2006년~): 2006년 아마존웹서비스(AWS)가 출시한 Amazon S3 (Simple Storage Service)는 디렉토리 구조 대신 버킷(Bucket)과 키-값(Key-Value) 구조로 데이터를 파일이 아닌 오브젝트(Object) 단위로 저장합니다. 99.999999999%(11 9's)의 내구성과 무제한 수평 확장성, HTTP REST API 접근성을 무기로 글로벌 인터넷 서비스의 표준 스토리지로 자리잡았습니다.
-
S3의 현대적 진화 (S3 Files & Tiering): 접근 빈도에 따라 비용을 절감하는 스토리지 클래스(Glacier, Infrequent Access 등)와 더불어, 최근에는 S3 버킷을 코드 변경 없이 컴퓨팅 인스턴스에 파일 시스템처럼 직접 마운트하여 사용하는 Amazon S3 Files 및 S3 File Gateway 기술로 통합되고 있습니다.