9월15일(화)
역사적인 '딥러닝의 트랜스포머'을 발표한 논문 "Attention Is All You Need" (Vaswani et al., NIPS 2017)의 핵심 내용을 구조, 원리, 성능 및 의의를 중심으로 체계적으로 정리한 내용입니다.
1. 연구 배경 및 동기 (Introduction & Background)
-기존 시퀀스 모델의 한계:
.기존의 최첨단 시퀀스 변환 모델(Sequence Transduction)은 주로 RNN(LSTM, GRU) 또는 CNN 기반의 인코더-디코더 구조를 채택했습니다.
.RNN 계열은 순차적으로 토큰을 처리하므로 병렬 연산(Parallelization)이 불가능하여 훈련 속도가 느리고, 시퀀스가 길어질수록 메모리 제약 및 장기 의존성(Long-range dependency) 학습이 어려웠습니다.
.CNN 기반 모델(ByteNet, ConvS2S 등)은 병렬화가 가능하지만, 먼 거리의 토큰 간 상호작용을 파악하기 위해 거리에 따라 선형() 또는 로그() 복잡도로 층을 쌓아야 했습니다.
-핵심 제안:
.순환(Recurrence)과 합성곱(Convolution)을 완전히 배제하고, 오직 어텐션 메커니즘(Self-Attention)에만 의존하는 새로운 아키텍처인 "트랜스포머(Transformer)"를 제안했습니다.
2. 모델 아키텍처 (Model Architecture)
트랜스포머는 기존 시퀀스 변환 모델과 마찬가지로 인코더-디코더(Encoder-Decoder) 구조를 유지합니다.
(1) 인코더(Encoder)와 디코더(Decoder) 스택
-인코더:
.동일한 레이어 개가 쌓여 있습니다.
.각 레이어는 2개의 서브 레이어로 구성됩니다:
Multi-Head Self-Attention
Position-wise Feed-Forward Network (FFN)
.각 서브 레이어마다 잔차 연결(Residual Connection)과 레이어 정규화(Layer Normalization)가 적용되어, 출력 형태는 입니다.
.모델의 기본 차원은 입니다.
-디코더:
.동일한 레이어 개가 쌓여 있습니다.
.인코더의 2개 서브 레이어 외에, 인코더의 출력을 참조하는 Multi-Head Attention (Encoder-Decoder Cross-Attention) 레이어가 추가되어 총 3개의 서브 레이어로 구성됩니다.
.디코더의 Self-Attention 서브 레이어에는 마스킹(Masking)이 적용되어, 특정 위치()의 예측 시 미래 시점()의 정보를 미리 보지 못하도록 방지합니다(Auto-regressive 속성 유지).
(2) 어텐션 메커니즘 (Attention)
어텐션은 Query(Q), Key(K), Value(V)를 매핑하는 함수입니다.
-Scaled Dot-Product Attention:
.Dot-Product 어텐션은 고도로 최적화된 행렬 곱셈 라이브러리를 사용할 수 있어 속도와 공간 효율성이 뛰어납니다.
.차원 크기 가 커질수록 내적 결과값이 커져 Softmax 함수의 기울기 소실(vanishing gradient) 문제가 발생할 수 있으므로, 이를 상쇄하기 위해 로 스케일링(나눔)합니다.
-Multi-Head Attention:
.단일 어텐션을 수행하는 대신, 를 서로 다른 학습 가능한 선형 투영을 통해 개의 다른 부분공간(Subspace)으로 사영한 뒤 병렬로 어텐션을 수행합니다.
-모델이 다양한 위치에서 서로 다른 표현 공간(Representation subspaces)의 정보를 동시에 참조할 수 있게 합니다.
-기본 모델에서는 개의 헤드를 사용하며, 각 헤드의 차원은 를 사용합니다.
(3)어텐션의 세 가지 적용 방식:
인코더 Self-Attention: 가 모두 이전 인코더 레이어의 출력에서 옵니다.
디코더 Self-Attention: 가 모두 디코더 내부에서 오며, 마스킹(Masked)을 적용해 미래 토큰 참조를 차단합니다.
인코더-디코더 Cross-Attention: 는 디코더의 이전 서브 레이어에서 오고, 와 는 인코더의 최종 출력에서 옵니다.
(3) 기타 핵심 구성 요소
-Position-wise Feed-Forward Networks (FFN):
.각 위치별로 독립적이고 동일하게 적용되는 2층 완전연결 신경망으로, 중간에 ReLU 활성화 함수를 사용합니다.
.내부 은닉층 차원은 입니다.
-Positional Encoding (위치 인코딩):
.순환(RNN)이나 합성곱(CNN)이 없기 때문에 단어의 순서(위치) 정보를 모델에 주입해야 합니다.
.삼각함수(Sin, Cos)를 사용한 고정 위치 인코딩을 적용하였으며, 임베딩 벡터와 직접 덧셈됩니다.
.학습된 위치 임베딩(learned positional embeddings)과 비교 실험을 진행했으나 성능 차이가 거의 없어, 학습 데이터보다 긴 시퀀스로 외삽(extrapolation)이 가능한 삼각함수 방식을 최종 선택했습니다.
- Self-Attention을 사용하는 이유 (비교 우위)
논문에서는 기존의 Recurrent, Convolutional 레이어와 비교해 Self-Attention의 이점을 3가지 측면에서 입증합니다:
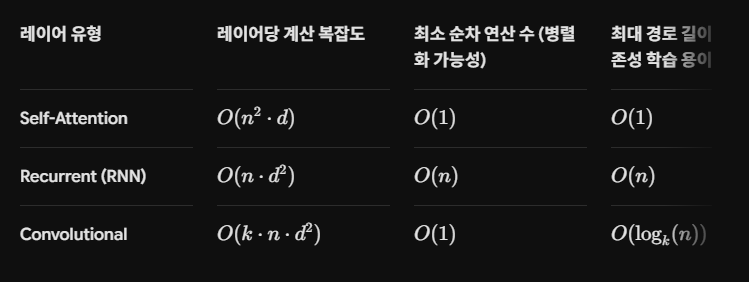
- 경로 길이: 모든 위치 쌍 사이의 거리가 1단계로 연결되어 있어 장기 의존성 학습이 극대화됩니다.
-높은 병렬화: 순차 연산이 에 불과하여 GPU를 통한 대규모 병렬 학습에 매우 적합합니다.
-해석 가능성(Interpretability): 개별 어텐션 헤드가 문법적 구문 구조나 대명사 조응 해소(Anaphora resolution) 등을 학습하는 양상을 시각적으로 확인할 수 있습니다.
- 실험 및 주요 결과 (Experiments & Results)
(1) 기계 번역 (Machine Translation)
-WMT 2014 English-to-German (EN-DE):
28.4 BLEU를 기록하며 기존 최고 앙상블 모델을 2.0 BLEU 이상 능가하는 새로운 SOTA(최고 성능) 달성.
-WMT 2014 English-to-French (EN-FR):
단일 모델 기준 41.8 BLEU를 기록하여 기존 문헌의 최고 단일 모델을 능가함.
-학습 비용:8장의 NVIDIA P100 GPU로 Base 모델은 약 12시간, Big 모델은 3.5일 동안 학습하여 기존 모델들 대비 수분의 일 수준의 연산 비용(FLOPs)으로 압도적인 성능을 달성했습니다.
(2) 모델 일반화 능력 검증 (English Constituency Parsing)
번역 외에도 영어 구문 분석(English Constituency Parsing) 과제에 동일 아키텍처(4레이어)를 적용한 결과, 작업 특화 튜닝이 거의 없음에도 매우 우수한 F1 점수(91.3 ~ 92.7)를 기록하여 모델의 범용성을 입증했습니다.
- 의의 및 영향
(1)패러다임의 전환: 순환 신경망(RNN) 중심의 자연어 처리 생태계를 어텐션 기반 병렬 구조로 완전히 전환시켰습니다.
(2)현대 생성형 AI의 근간: 이후 등장한 BERT(인코더 기반), GPT 시리즈(디코더 기반), T5(인코더-디코더 기반)뿐만 아니라 컴퓨터 비전(Vision Transformer), 멀티모달 모델 전반의 표준 아키텍처가 되었습니다.
< 머신러닝(Machine Learning) : 마인드 맵 >
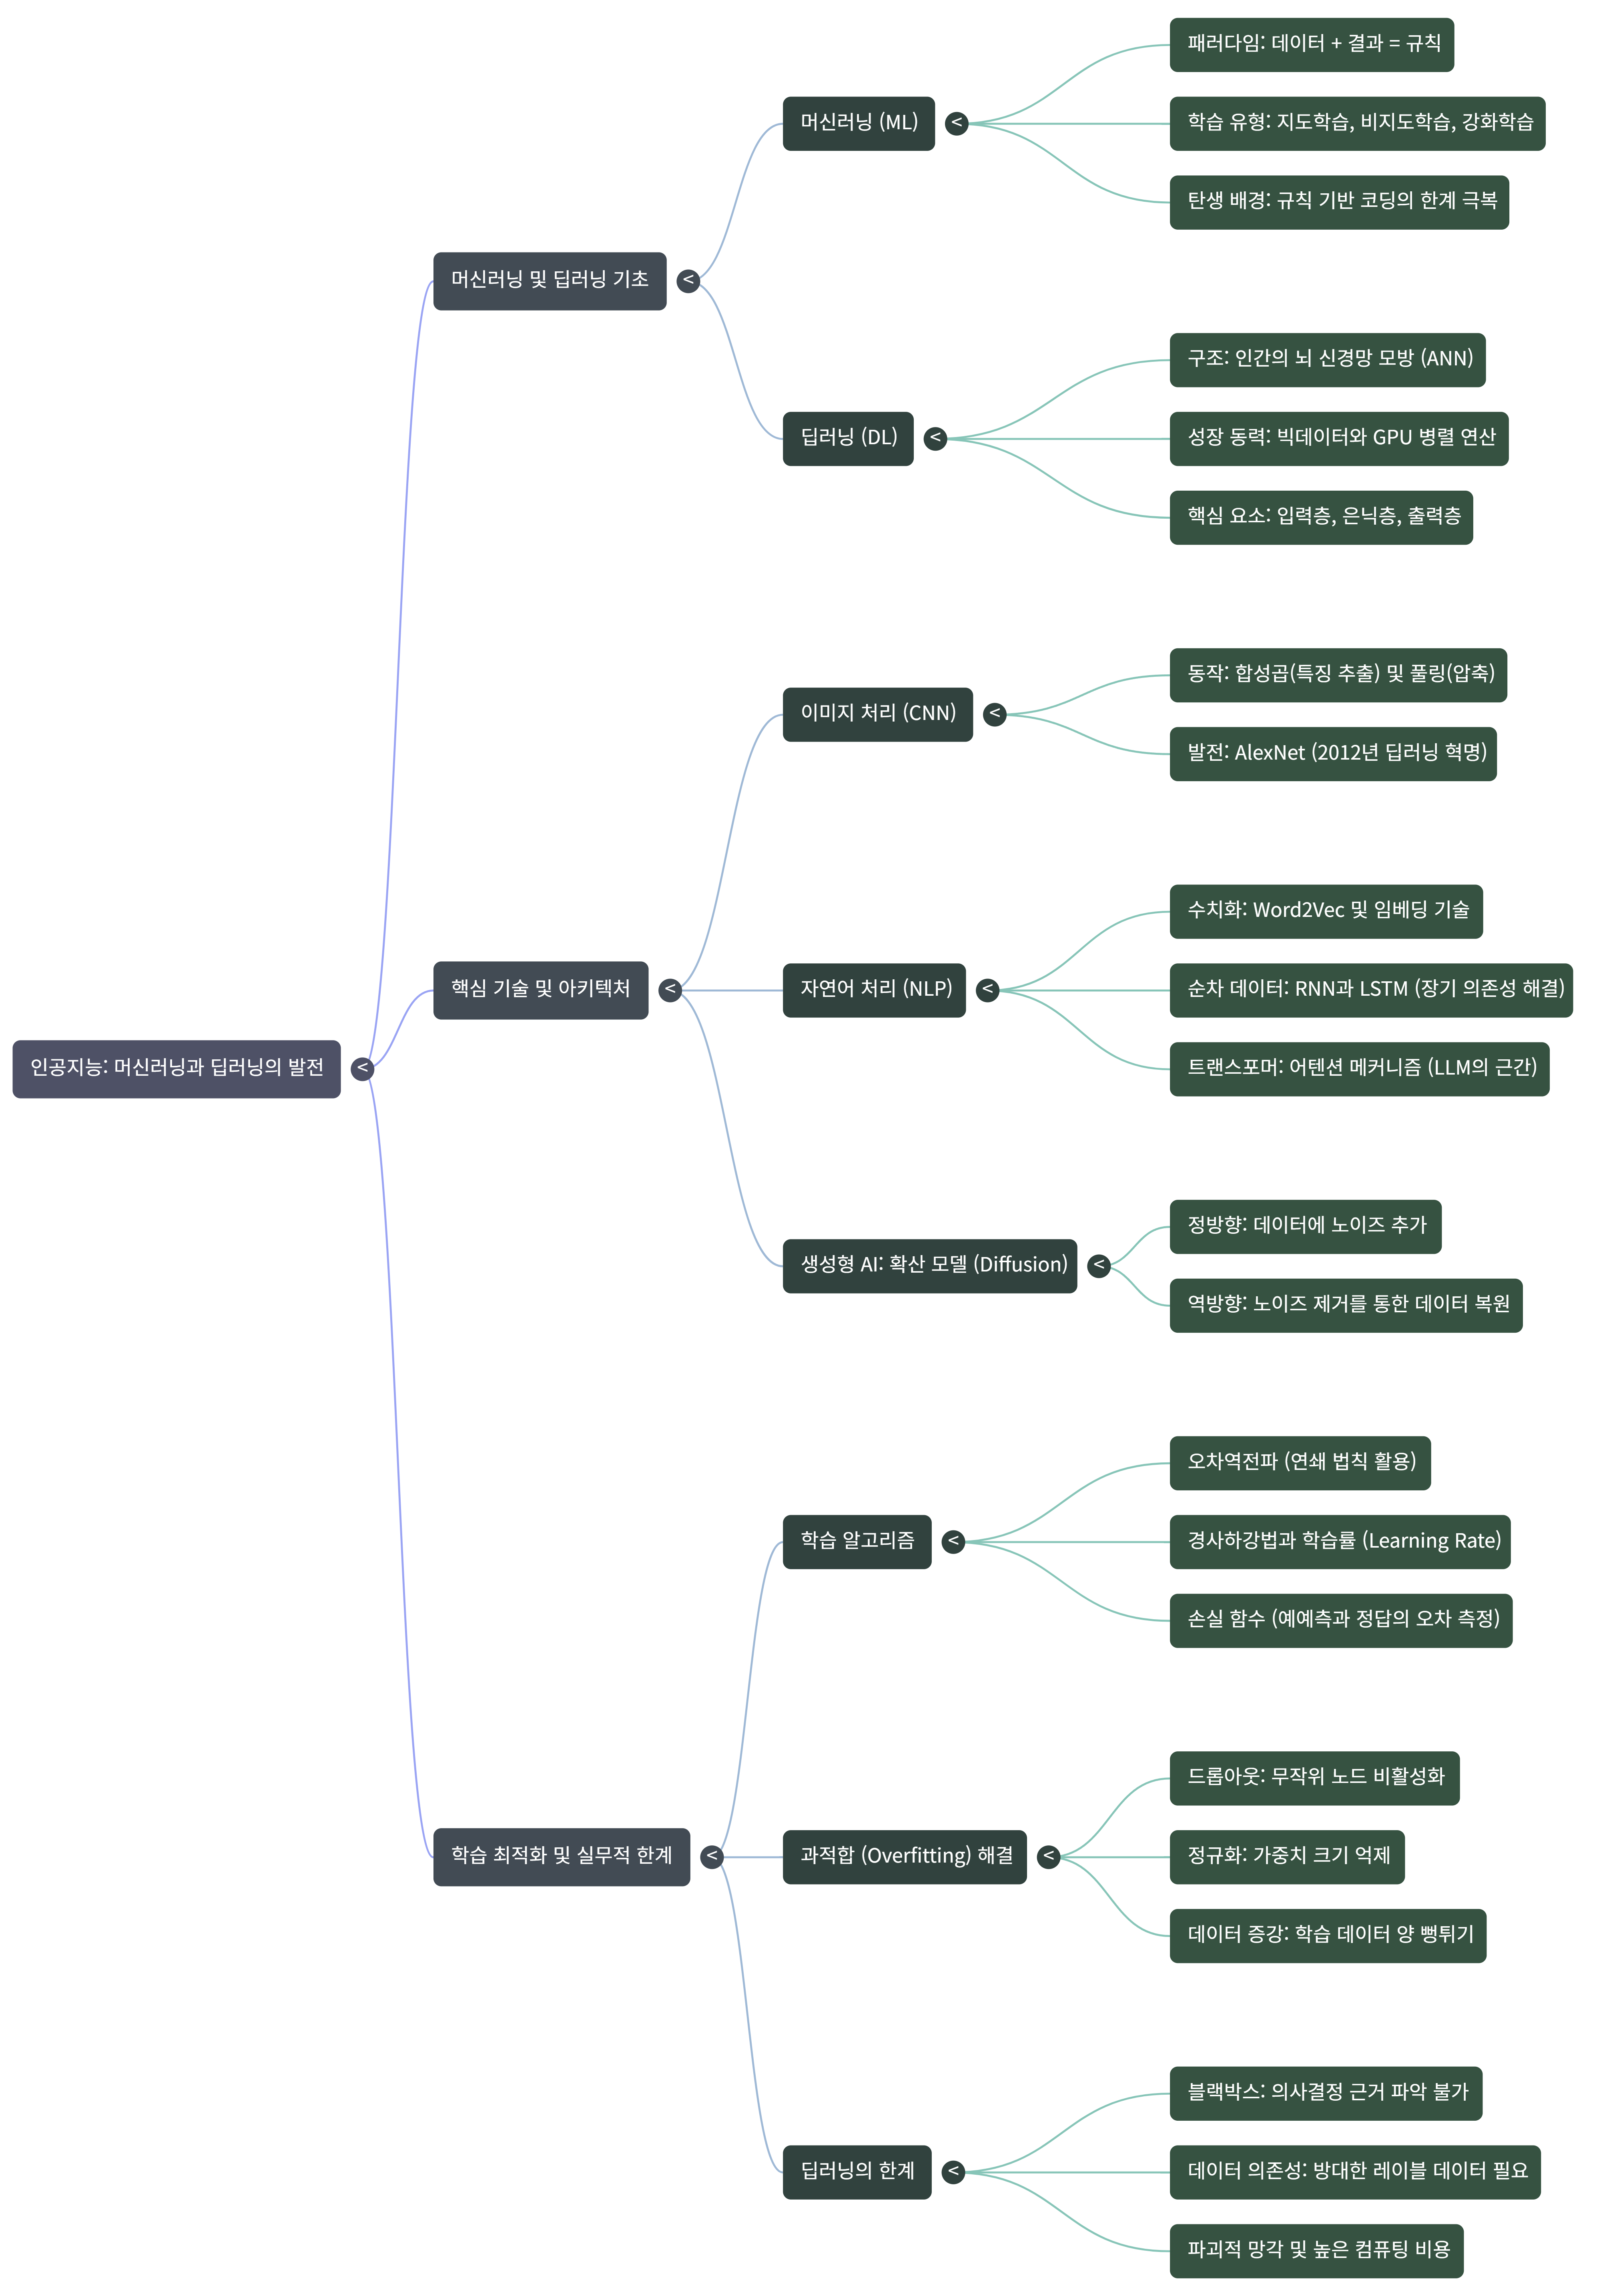
🤖 1. 머신러닝(Machine Learning)의 탄생 배경
초기 인공지능 학자들은 세상의 모든 지식을 규칙(If-Then)으로 컴퓨터에 입력하려 했습니다(기호주의 AI). 하지만 현실 세계의 수많은 예외를 모두 코딩하는 것은 불가능했습니다.
데이터 중심 패러다임 전환 (1950년대~): 1959년 아서 사무엘(Arthur Samuel)은 체커 게임 프로그램을 만들면서 "컴퓨터가 명시적으로 프로그래밍되지 않고도 스스로 학습할 수 있는 능력"을 연구했고, 이때 '머신러닝'이라는 용어가 탄생했습니다.
통계학과의 결합 (1990년대): 1990년대 들어 인터넷이 태동하며 디지털 데이터가 쌓이기 시작했습니다. 학자들은 논리적 규칙 대신 '통계적 확률'을 사용하여 데이터 속에서 스스로 패턴을 찾는 알고리즘(SVM, 의사결정나무 등)을 고도화했습니다.
빅데이터 시대의 개막: 알고리즘이 아무리 좋아도 학습할 '문제집(데이터)'이 없으면 소용이 없습니다. 2000년대 이후 웹 서비스와 스마트폰의 보급으로 전 세계에 막대한 데이터가 축적되면서 머신러닝이 폭발적으로 실용화되기 시작했습니다.
🧠 2. 딥러닝(Deep Learning)의 탄생 배경
딥러닝은 머신러닝의 한 분야로, 인간의 뇌 신경망 구조를 모방한 인공신경망(Artificial Neural Network)을 기반으로 합니다.
퍼셉트론과 인공지능의 겨울 (1950년대~1980년대): 인간의 뉴런을 모방한 '퍼셉트론'이 등장했지만, 당시 컴퓨터의 빈약한 연산 능력과 복잡한 문제(XOR 문제 등)를 풀지 못하는 구조적 한계로 인해 오랜 기간 '인공지능의 겨울(침체기)'을 겪어야 했습니다.
제프리 힌튼과 알고리즘의 돌파구 (2006년): 제프리 힌튼(Geoffrey Hinton) 교수를 비롯한 연구자들이 신경망을 여러 겹(Deep)으로 깊게 쌓았을 때 발생하는 오류를 효과적으로 교정하는 기술(오차역전파 등)을 개선하며 이론적 한계를 극복했습니다.
하드웨어(GPU)의 혁명 (2012년~): 딥러닝의 복잡한 행렬 연산을 CPU 대신 그래픽 카드인 GPU의 강력한 병렬 처리 능력으로 해결하게 되었습니다. 2012년 이미지 인식 대회(ImageNet)에서 GPU를 활용한 딥러닝 모델(AlexNet)이 압도적인 성능으로 우승하며 본격적인 딥러닝의 시대가 열렸습니다.
요약하자면, 기존 규칙 기반 코딩의 한계를 극복하고자 하는 열망이 머신러닝을 탄생시켰고, 막대한 빅데이터와 GPU 연산 능력이 뒷받침되면서 뇌 구조를 모방한 딥러닝이 현대 AI의 핵심으로 자리 잡게 된 것입니다.
"데이터 + 결과(정답) = 규칙(모델)"이라는 정의는 머신러닝의 패러다임 전환을 가장 직관적이고 정확하게 꿰뚫은 명제입니다.
실제로 딥러닝의 대가 페드로 도밍고스(Pedro Domingos) 교수나 구글 브레인을 이끌었던 프랑수아 숄레(François Chollet) 역시 전통적 프로그래밍과 머신러닝의 차이를 설명할 때 이 도식
을 표준으로 제시합니다.
📊 패러다임 비교: 전통적 프로그래밍 vs 머신러닝
구분
입력 (Input)
처리 과정
출력 (Output)
전통적 프로그래밍 (규칙 기반)
데이터 + 규칙(코드/로직)
컴퓨터가 규칙을 데이터에 적용
결과(정답)
머신러닝 (지도학습 기준)
데이터 + 결과(정답/라벨)
알고리즘이 패턴과 가중치 학습
규칙(모델/함수)
💡 명제에 대한 평가
1. 뛰어난 직관성 (Positive)
패러다임의 역전 설명: 개발자가 일일이 조건문(if-else)을 코딩하던 시대에서, 컴퓨터가 데이터와 정답 사이의 통계적 상관관계를 역추적해 함수()를 스스로 만들어내는 시대가 되었음을 비전공자나 초보자도 한눈에 이해할 수 있게 해줍니다.
지도학습(Supervised Learning)의 본질: 입력 (데이터)와 출력 (정답)가 주어졌을 때, 그 관계를 매핑하는 파라미터(가중치와 편향)를 찾아내는 과정을 군더더기 없이 표현했습니다.
2. 개념적 한계와 누락된 지점 (Caveats)
정답이 없는 학습(비지도학습·강화학습)의 배제:
비지도학습(Unsupervised Learning): 군집화(Clustering), 차원 축소 등은 '정답' 없이 오직 데이터 자체의 내재된 구조와 분포만으로 규칙을 찾습니다.
강화학습(Reinforcement Learning): 정답 대신 환경과의 상호작용에 따른 보상(Reward)을 통해 최적의 행동 규칙(Policy)을 학습합니다.
'정적인 규칙(Hard Rule)'으로의 오해 가능성: 머신러닝이 찾아내는 규칙은 전통적인 논리 규칙(A이면 B이다)이 아니라, 확률적이고 통계적인 가중치 덩어리(Soft Pattern)입니다.
🛠️ 실무 적용을 위한 조언
"데이터와 정답"의 품질(Quality)이 모델을 결정합니다
전통적인 시스템은 개발자의 논리력(코드 품질)이 소프트웨어 품질을 좌우했지만, 머신러닝 시스템에서는 데이터 정제(Cleaning)와 라벨링(Annotation)의 정확도가 곧 모델의 성능입니다. (Garbage In, Garbage Out)
개념을 확장하여 정립하세요
기본 개념을 잡을 때는 해당 명제를 기준점으로 삼되, 실제 아키텍처나 비즈니스 문제를 정의할 때는 다음과 같이 외연을 넓히는 것이 좋습니다."지도학습은 데이터 + 정답 = 모델이지만, 머신러닝 전체는 데이터 + 피드백 체계(라벨/목적함수/보상) = 일반화된 패턴(모델)이다."
모델을 만든 후의 '추론(Inference)' 흐름도 함께 고려해야 합니다
학습을 통해 모델(규칙)을 얻었다면, 실제 서비스 단계에서는 다시 전통적인 구조와 유사하게 새로운 데이터 + 규칙(학습된 모델) = 예측 결과의 형태로 운영 서버에 배포되어 동작한다는 전체 수명 주기(MLOps)를 염두에 두시는 것이 실무적으로 유용합니다.
인공지능이 데이터를 '인지(Perception)'하는 과정은 인간의 감각 기관이 작동하는 방식과는 완전히 다릅니다. AI는 눈으로 보거나 글씨를 읽는 것이 아니라, "모든 데이터를 수학적인 숫자(벡터와 행렬)로 변환하여 계산"하는 방식으로 세상을 인지합니다.
그 과정을 4가지 핵심 단계로 나누어 설명해 드립니다.
🔢 1. 모든 데이터의 수치화 (Vectorization & Embedding)
AI는 컴퓨터 프로그램이므로 '고양이 사진'이나 '안녕하세요'라는 텍스트 자체를 이해할 수 없습니다. 따라서 가장 먼저 모든 비정형 데이터를 숫자의 배열(텐서, Tensor)이나 다차원 벡터(Vector)로 변환해야 합니다.
이미지 데이터: 픽셀(Pixel) 단위로 쪼개어, 각 픽셀이 가진 빛의 삼원색(RGB) 밝기를 0~255 사이의 숫자로 나타낸 거대한 3차원 숫자 행렬로 인지합니다.
텍스트 데이터(자연어): 단어나 문장을 쪼개어(Tokenization), 수천~수만 차원의 좌표 공간 내에 특정 위치(숫자값)로 매핑하는 임베딩(Embedding) 과정을 거칩니다. (최신 LLM이나 RAG 구조에서 문장의 의미를 검색할 때 쓰이는 기술의 근간입니다.)
음성 데이터: 소리의 주파수 파형을 잘게 쪼개어 시간에 따른 진폭의 변화를 숫자로 표현하거나, 이미지 형태(스펙트로그램)로 변환하여 인지합니다.
🧠 2. 계층적 특징 추출 (Hierarchical Feature Extraction)
숫자로 변환된 데이터는 딥러닝의 인공신경망(Neural Network)을 통과하며 거대한 행렬 곱셈(가중치 연산)을 거칩니다. 이때 모델은 층(Layer)이 깊어질수록 점점 더 복잡하고 고차원적인 '특징(Feature)'을 스스로 찾아냅니다.
예시 (얼굴 인식):
첫 번째 층 (Low-level): 픽셀들의 숫자 차이를 계산해 단순한 '명암'이나 '선(가로줄, 세로줄)'만 인지합니다.
중간 층 (Mid-level): 선들을 조합하여 '동그라미', '눈의 형태', '코의 윤곽' 같은 부분적 형태를 인지합니다.
마지막 층 (High-level): 이러한 윤곽들을 조합해 최종적으로 '사람의 얼굴'이라는 복잡한 패턴을 인식하게 됩니다.
🌌 3. 잠재 공간(Latent Space)에서의 군집화 및 유사도 측정
수많은 연산을 거쳐 추출된 데이터의 특징들은 잠재 공간(Latent Space)이라는 거대한 수학적 공간 위에 좌표로 찍히게 됩니다.
AI는 이 공간에서 숫자들 간의 거리와 방향(유사도)을 측정하여 데이터를 인지합니다.
예를 들어, '강아지' 사진들과 '고양이' 사진들을 벡터 공간에 뿌려보면, 강아지는 강아지들끼리, 고양이는 고양이들끼리 뭉쳐(군집) 있습니다. AI는 새로 입력된 데이터가 이 공간 안에서 "어느 무리에 더 가까운지"를 수학적 거리로 계산하여 대상을 판별합니다.
⚖️ 4. 활성화 함수(Activation Function)를 통한 판단
단순한 더하기와 곱하기 연산(선형 연산)만으로는 현실 세계의 복잡한 문제를 풀 수 없습니다. 따라서 뉴런의 역할을 하는 각각의 노드 끝에는 '활성화 함수(예: ReLU, Sigmoid 등)'라는 것이 존재합니다.
이 함수는 이전 층에서 넘어온 숫자 값들이 특정 임계치를 넘었는지 판단하여, "이 특징(Feature)은 중요하다(다음 층으로 강하게 전달)" 또는 "이 특징은 무시해도 좋다(값을 0으로 만듦)"를 결정합니다.
인공지능 모델이 데이터를 인지하는 방법은?
"현실의 데이터를 거대한 차원의 벡터(숫자)로 바꾸고, 가중치가 부여된 복잡한 행렬 곱셈을 통해 패턴을 찾아낸 뒤, 수학적 거리를 계산해 통계적으로 가장 확률이 높은 정답을 도출하는 것"입니다.
이러한 인지 과정 중에서 텍스트나 이미지가 어떻게 '벡터(Vector)'라는 숫자로 변환되는지, 그 임베딩 기술의 원리에 대해 더 깊이 알아보고 싶으신가요?
전통적인 규칙 기반 시스템(Rule-based System)은 개발자가 명시적으로 작성한 조건문(If-Then-Else)에 따라 작동합니다. 이 방식은 조건과 결과가 명확히 통제된 업무(예: 회계 정산, 특정 권한 체크)에서는 완벽하게 동작하지만, 개발자가 사전에 모든 예외와 조건을 수치화하여 정의할 수 없는 영역에서는 치명적인 한계에 부딪힙니다.
규칙으로 풀기 어려운 대표적인 난제들은 다음과 같습니다.
-
비정형 데이터(Unstructured Data)의 인식과 처리
시각 및 청각 정보 인식: 카메라에 찍힌 '고양이'를 식별하는 코드를 짠다고 가정해 보겠습니다. 털 색깔, 바라보는 방향, 조명의 밝기, 일부분이 가려진 상태 등 경우의 수가 무한합니다. 이를 픽셀 단위의 조건문으로 정의하는 것은 물리적으로 불가능합니다. (컴퓨터 비전, 음성 인식의 영역) -
자연어의 모호성과 문맥(Context) 이해
언어의 유연성: 인간의 언어에는 동음이의어, 은유, 반어법, 그리고 생략이 존재합니다. 예를 들어 "시스템 참 잘~ 돌아간다"라는 문장이 칭찬인지, 심각한 오류를 비꼬는 것인지 판별하려면 문맥을 이해해야 합니다. 단어의 존재 유무나 문법 규칙만으로는 이러한 언어의 모호성을 해결할 수 없습니다. -
규칙의 기하급수적 폭발(Combinatorial Explosion)과 충돌
유지보수의 한계: 비즈니스가 복잡해질수록 예외 상황을 처리하기 위한 규칙(Rule)이 기하급수적으로 늘어납니다. 수만 개의 규칙이 쌓이게 되면, 새로 추가한 규칙이 기존 규칙과 충돌(Rule Conflict)하여 시스템 전체가 마비되거나 스파게티 코드(Spaghetti Code)가 되어 유지보수가 불가능해집니다. -
인간의 암묵지(Tacit Knowledge) 구현
폴라니의 역설(Polanyi's Paradox): "우리는 우리가 말로 설명할 수 있는 것보다 훨씬 더 많은 것을 알고 있다"는 원리입니다. 사람의 얼굴을 1초 만에 알아보는 능력이나 두 발 자전거를 타는 균형 감각은 인간 스스로도 어떤 '규칙'으로 수행하는지 논리적으로 설명할 수 없기 때문에, 코드로 옮겨 적을 수 없습니다. -
동적 환경에 대한 실시간 적응
패턴의 변화: 금융 사기(FDS), 스팸 메일, 주식 시장, 사용자 추천 알고리즘 등은 패턴이 실시간으로 변화합니다. 해커가 새로운 수법을 쓸 때마다 사람이 일일이 규칙을 분석해 업데이트하는 방식으로는 변화의 속도를 따라잡을 수 없습니다.
🧠 딥러닝(Deep Learning) 이란?
-
딥러닝의 기술적 정의
딥러닝은 머신러닝(기계학습)의 한 분야로, 인간의 뇌 신경망(뉴런) 구조를 수학적으로 모방한 인공신경망(Artificial Neural Network)을 '깊게(Deep)' 여러 겹으로 쌓아 올린 알고리즘입니다. 방대한 양의 비정형 데이터(이미지, 영상, 텍스트, 음성) 속에서 스스로 복잡한 패턴을 찾아내는 데 특화되어 있습니다. -
핵심 동작 원리 및 아키텍처
딥러닝 모델은 수많은 '노드(Node, 인공 뉴런)'들이 거미줄처럼 연결된 다층 구조를 가집니다.
① 입력층 ➔ 은닉층 ➔ 출력층 구조:
데이터가 들어오는 '입력층(Input Layer)'과 최종 결론을 내는 '출력층(Output Layer)' 사이에 데이터를 복잡하게 가공하고 해석하는 '은닉층(Hidden Layer)'이 존재합니다. 이 은닉층이 2개 이상 깊게 쌓여 있을 때 비로소 '딥(Deep)' 러닝이라고 부릅니다.
② 특징의 자동 추출 (Representation Learning):
기존 머신러닝은 사람이 직접 "고양이는 귀가 뾰족하고 수염이 있다"라는 특징을 데이터에서 추출해 주어야 했습니다. 반면 딥러닝은 데이터를 층층이 통과시키며 스스로 특징을 학습합니다. (예: 1번째 층은 '점과 선' 인식 ➔ 중간 층은 '윤곽선과 모양' 인식 ➔ 마지막 층은 '고양이의 얼굴' 인식)
③ 오차역전파 (Backpropagation)와 가중치 업데이트:
가장 중요한 학습 원리입니다. 모델이 내놓은 예측값과 실제 정답(Label) 사이의 차이, 즉 '오차(Loss)'를 계산한 뒤, 이 오차를 줄이기 위해 출력층에서부터 입력층으로 역방향으로 거슬러 올라가며 노드 간의 연결 강도(가중치, Weight)를 미적분(경사하강법)을 통해 미세하게 조정합니다. 이 과정을 수십만 번 반복하며 완벽한 규칙을 찾아냅니다.
- 딥러닝의 폭발적 성장 배경 (왜 지금인가?)
이론 자체는 1980년대에 이미 완성되어 있었으나, 최근에서야 폭발적으로 발전한 이유는 두 가지 인프라적 제약이 풀렸기 때문입니다.
빅데이터(Big Data): 인터넷과 스마트폰의 보급으로 신경망을 학습시킬 압도적인 양의 데이터가 축적되었습니다.
GPU 연산 능력: 수백만~수십억 개의 가중치를 동시에 계산(행렬 곱셈)해야 하는 엄청난 연산량을, 직렬 처리 방식의 CPU 대신 병렬 처리에 특화된 그래픽 카드(GPU)가 해결해 주었기 때문입니다.
- 대표적인 활용 분야 (Architecture Types)
CNN (합성곱 신경망): 이미지나 영상의 특징을 추출하는 데 탁월하여 얼굴 인식, 자율주행차의 비전 시스템, 의료 영상 분석 등에 쓰입니다.
RNN / Transformer: 순서가 있는 시계열 데이터나 문맥을 파악하는 데 특화되어 번역기, 음성 인식, 그리고 현재 귀하께서 보고 계시는 챗GPT나 Gemini 같은 초거대 언어 모델(LLM)의 핵심 근간이 됩니다.
🐈 딥러닝 모델의 고양이 인식 메커니즘 (CNN 아키텍처 기준)
딥러닝 모델, 특히 이미지 인식에 가장 널리 쓰이는 합성곱 신경망(CNN, Convolutional Neural Network)이 고양이 사진을 보고 "이것은 고양이다"라고 판별하는 과정은 다음과 같은 4단계로 이루어집니다.
1단계: 시각 데이터의 수치화 (Input Layer)
컴퓨터는 이미지를 시각적으로 '보는' 것이 아니라, 픽셀(Pixel)이라는 수많은 숫자의 배열(행렬)로 인식합니다.
RGB 행렬 변환: 컬러 고양이 사진이 입력되면, 가로세로 픽셀 크기에 Red, Green, Blue 3개의 색상 채널을 가진 거대한 3차원 숫자 행렬(Tensor)로 변환됩니다.
예를 들어, 빛이 전혀 없는 검은 털 부분은 '0'에 가까운 숫자로, 가장 밝은 흰 털 부분은 '255'에 가까운 숫자로 치환되어 모델에 입력됩니다.
2단계: 특징 추출 (Convolutional Layer)
CNN의 핵심 과정으로, 모델이 이미지를 훑으며 수학적 돋보기를 대고 패턴과 특징(Feature)을 뽑아내는 단계입니다.
필터(Filter) 연산: 모델 내부에는 수많은 수학적 '필터(또는 커널)'가 존재합니다. 이 필터들이 원본 이미지 행렬 위를 미끄러지듯(Sliding) 이동하며 행렬 곱셈을 수행합니다.
계층적 특징 인식:
초기 층(Low-level): 가로선, 세로선, 색상의 경계선(명암 차이)과 같은 아주 단순한 픽셀의 변화만 추출합니다.
중간 층(Mid-level): 앞서 추출된 선들을 결합하여 동그라미, 뾰족한 삼각형(고양이의 귀), 뻗어나가는 직선(수염) 등의 부분적 형태를 인식합니다.
마지막 층(High-level): 이러한 부분 형태들이 모여 전체적인 고양이 얼굴 윤곽, 눈동자의 위치 등 매우 복잡하고 고차원적인 객체의 패턴을 종합적으로 파악하게 됩니다.
3단계: 정보 압축 및 중요도 선별 (Pooling Layer)
특징을 추출하는 과정 사이사이에 데이터를 압축(Downsampling)하는 과정을 거칩니다.
공간 축소: 수백만 개의 픽셀 데이터를 모두 연산하면 과부하가 걸리므로, 특정 구역(예: 2x2 픽셀 묶음)에서 가장 강한 특징(가장 큰 숫자)만 남기고 나머지는 버립니다(Max Pooling).
유연성 확보: 이 과정을 통해 고양이가 사진의 정중앙에 있든, 구석에 작게 있든, 조금 찌그러져 있든 그 위치나 크기에 크게 구애받지 않고 유연하게 형태를 보존하며 인식할 수 있게 됩니다(위치 불변성).
4단계: 최종 판단 및 분류 (Fully Connected Layer)
추출되고 압축된 특징들을 모아 최종적인 판단을 내리는 단계입니다.
1차원 배열화(Flattening): 3차원 행렬로 이루어진 고양이의 공간 특징 데이터들을 한 줄의 긴 숫자 배열(1차원 벡터)로 쫙 폅니다.
소프트맥스(Softmax) 확률 계산: 이 숫자들을 기존의 일반적인 인공신경망에 통과시킨 뒤, 마지막 출력층에서 확률을 계산하는 수학적 함수를 적용합니다.
결과 도출: 모델은 "강아지일 확률 15%, 호랑이일 확률 5%, 고양이일 확률 80%"와 같이 각 분류(Class)별 확률 점수를 계산해 냅니다. 가장 높은 확률을 가진 카테고리가 최종 정답으로 출력됩니다.