스케쥴링 알고리즘( Scheduling Algorithm )
。스케쥴링 큐에서CPU 제어권의 할당을 대기하는Ready Queue에 적재된프로세스중CPU Core의 제어권을 배정할우선순위 프로세스를 결정하는알고리즘
▶스케쥴링 알고리즘을 통해프로세스 실행순서결정 후 단기 스케쥴러에 의해 선택되어디스패처를 통해프로세스에게CPU 할당
MLQ , MLFQ
스케쥴링종류
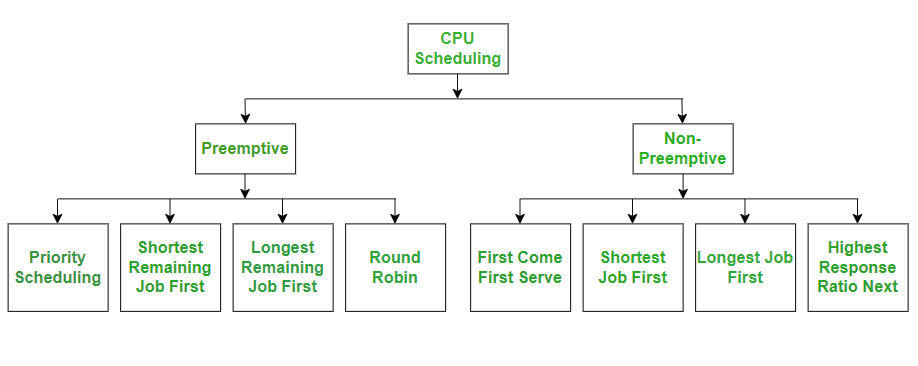
선점형 스케쥴링( Preemtive Scheduling )
。CPU가 배정된프로세스가CPU 스케쥴러에 의해CPU를 강제로 회수
▶ 더 높은우선순위 프로세스가 발생 시CPU를 회수
。FCFS,SRTF,RR,Priority-based
비선점형 스케쥴링( Non-Preemtive Scheduling )
。CPU가 배정된프로세스가Waiting status로 변경되거나Terminate될때까지CPU를 계속 점유
▶ 안정성은 좋으나 효율이 좋지않음
。FCFS,SJF,Priority-based
기아( Starvation )
。 먼저Ready Queue에 적재되어Ready상태로 높은 값의Priority를 갖는 특정프로세스보다Ready Queue에 유입되는 낮은 값의Priority를 갖는프로세스들이 우선Execute되어 무한정으로 대기하는 현상
▶indefinite blocking라고 한다.
。Dead Lock에서도 나오는 개념
SJF,SRTF,Priority-based는기아현상에 주의
기아해결법 :aging
。오랜 기간동안Ready Queue에서 대기중인프로세스에 대해priority값을 점진적으로 감소시키는 기법
FCFS스케쥴링 ( First-Come , First-Served )
。가장 간단한CPU Scheduling Algorithm
▶비선점형 스케쥴링방식
。CPU를 가장 먼저 요청한프로세스에게CPU를 먼저 배정
▶FIFO Queue를 통해 쉽게 구현가능
。먼저subimit된프로세스의burst에 따라서Average Waiting time이 크게 변한다.
▶소요시간이 긴프로세스가 먼저 도착 시 전체효율이 감소
FCFS 스케쥴링의 문제점
Average waiting time이 다른스케쥴링에 비해 최소가 되지않음
프로세스마다의CPU Burst의 변화가 클 경우Average waiting time과Average Turnaround time의 변화폭도 상당히 변화
비선점형 스케쥴링( Non-preemtive ) 방식
。프로세스에CPU를 배정하여Execute할때 중간에CPU를 회수하지 않으므로.
호송 효과( Convoy Effect )
。CPU를 오래 점유하는프로세스가 먼저Execute되어, 그 뒤에 짧은 실행 시간을 가진프로세스들이 불필요하게 오래 대기하는 현상
▶burst가 작은프로세스들이 먼저Execute하는 것에 비해서CPU 사용률이 낮게 도출
ex )ML등을 수행하는 아주 큰CPU Bound하나와 다수의I/O Bound로 구성 시
。SJF를 사용하여 해결
- 원리 : 사전설정
。time : 0부터 시작
。각프로세스( )의CPU brust가ms기준으로 다음과 같음
FCFS스케쥴로Waiting time,Turnaround time계산
。Waiting time: 각프로세스의 실행전까지 대기시간
。Turnaround time: 각프로세스의Execute시 제출부터 완료까지의 시간
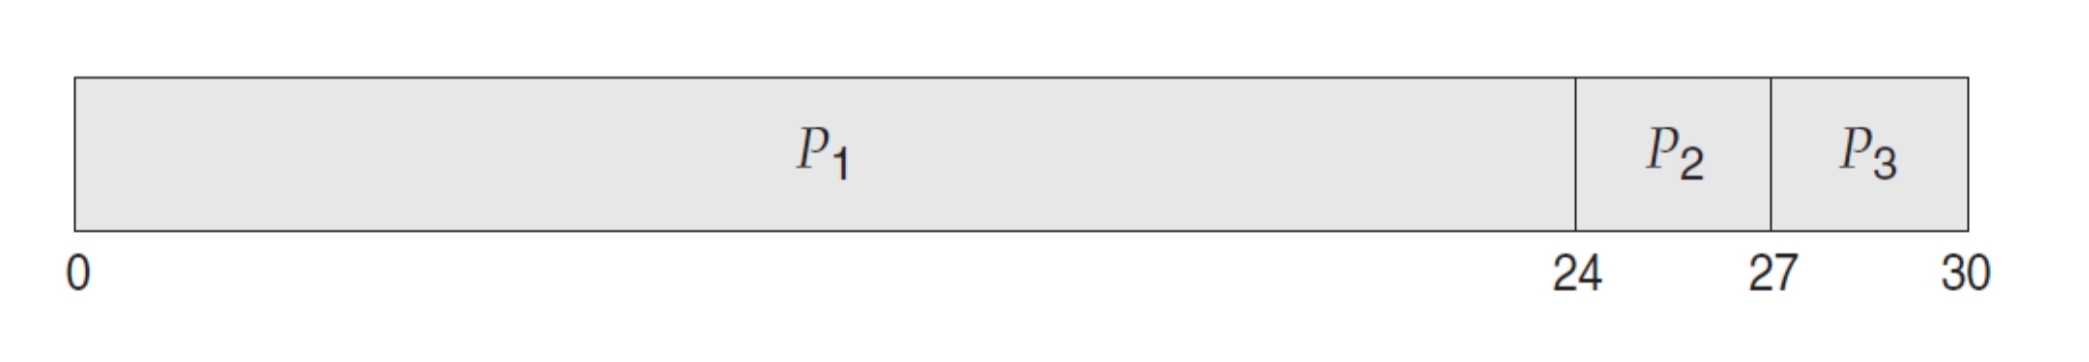
FIFO Queue로프로세스가 →→ 순으로 들어온 경우
。FCFS policy로Gantt Chart에 의해 다음처럼 표현
Waiting time계산
。각프로세스의Waiting time
, ,
▶ 실행까지 초를 대기
Total Waiting time:
。Average Waiting time:
。먼저Submit된 의Burst가 매우 크므로 , 의Waiting time이 크게 도출
Turnaround time계산
。각프로세스의Turnaround time
, ,
▶ 각각의프로세스의 제출부터 완료까지의Waiting time + CPU Burst을 도출
。Total Turnaround time:
。Average Turnaround time:
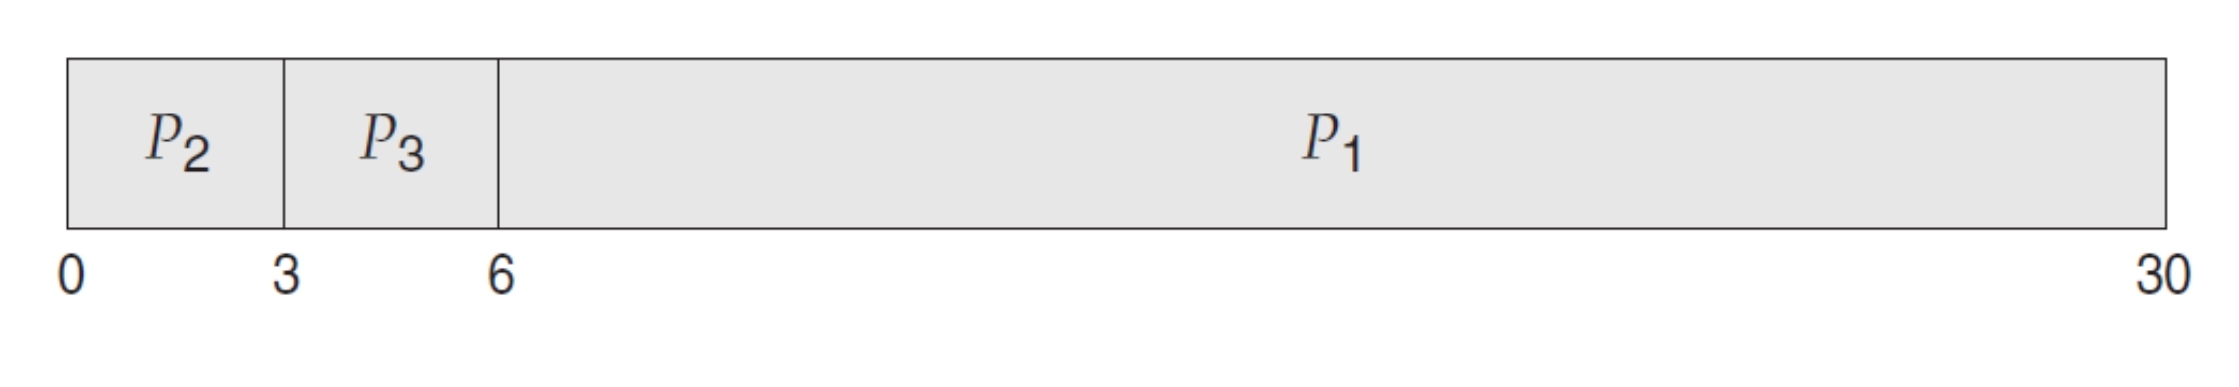
FIFO Queue로프로세스가 →→ 순으로 들어온 경우
Waiting time계산
。각프로세스의Waiting time
, ,
。Total Waiting time:
。Average Waiting time:
。먼저Submit된 의Burst가 작으므로 앞전의 예제의Waiting time보다 획기적으로 작게 도출
Turnaround time계산
。각프로세스의Turnaround time
, ,
▶ 각각의프로세스의 제출부터 완료까지의Waiting time + CPU Burst을 도출
。Total Turnaround time:
。Average Turnaround time:
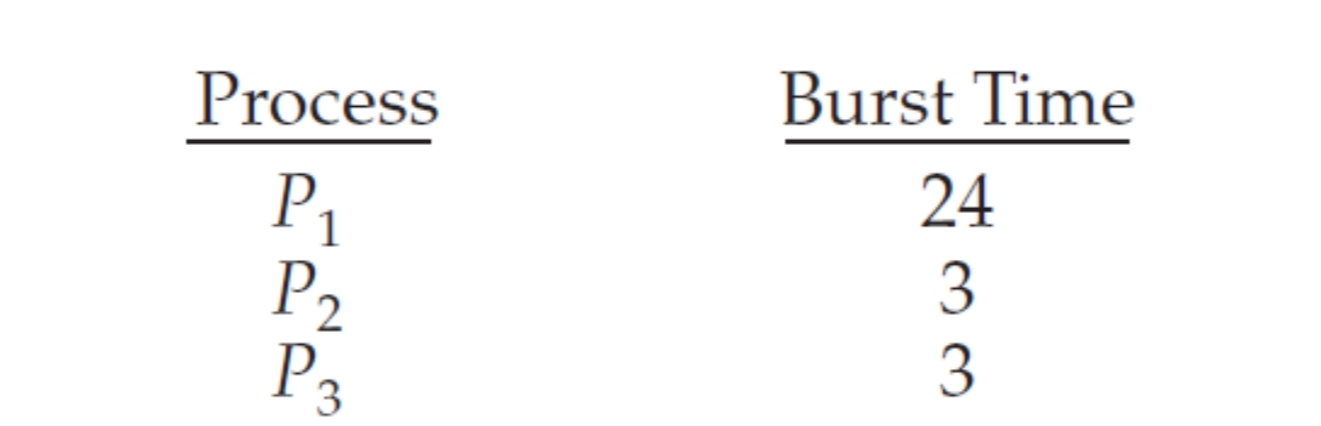
SJF스케쥴링 ( Shortest next CPU burst First ) =SRTF( Shortest Remaining Time First )
。Ready Queue에서 각프로세스에서 실행할CPU burst중 가장 짧은CPU Burst를 가진프로세스에 우선적으로CPU를 배정하는알고리즘
▶프로세스의next CPU burst가 서로 동일한 경우,FCFS 스케줄링방식으로CPU를 배정
next CPU burst=predicted CPU burst
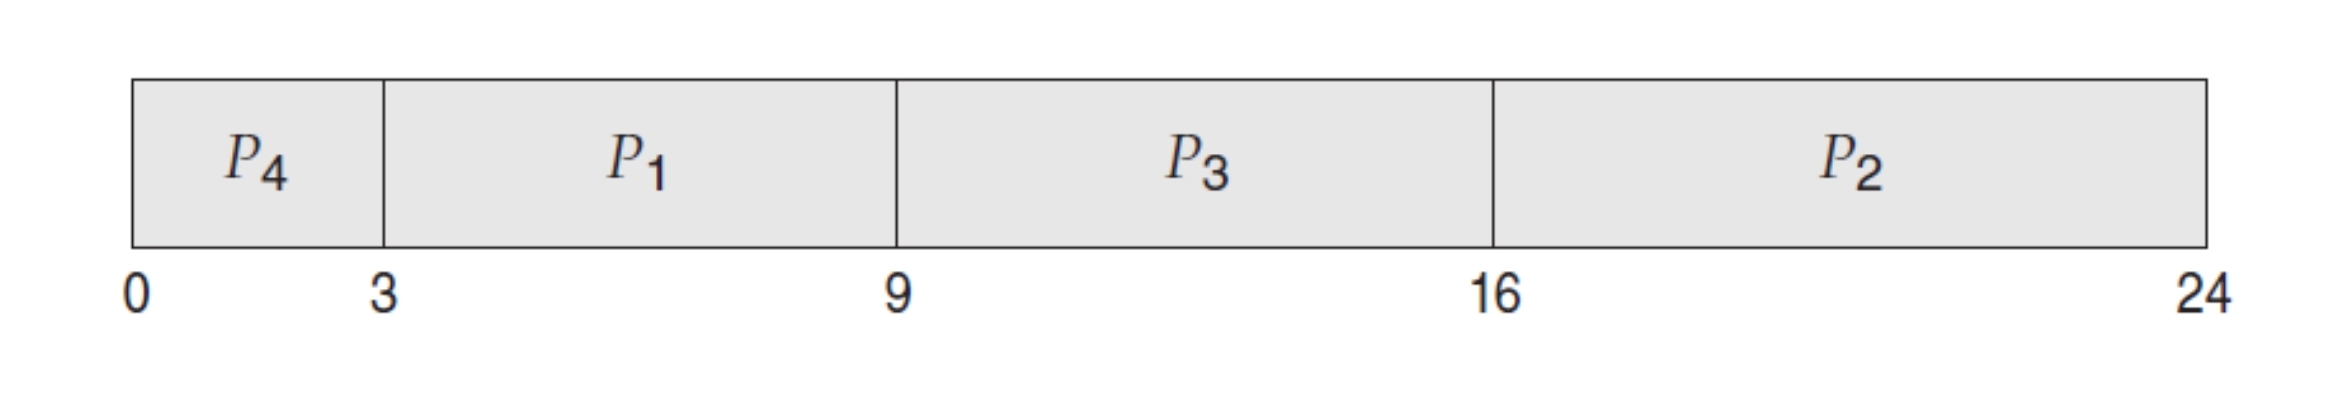
。제공된프로세스들에 대해SJF 스케쥴링시 최소Average Waiting time을 제공하므로 최적화된스케줄링기법
▶FCFS와 비교하여 짧은next CPU Burst를 지닌프로세스를 먼저Execute할 경우 전체프로세스의Waiting time이 감소하므로.
。SJF 스케쥴링은비선점형 스케쥴링또는선점형 스케쥴링( =SRTF 스케쥴링)으로 구현
SJF/SRTF는기아 현상( Starvation )에 주의
。CPU Burst가 긴프로세스의 경우 오랜시간동안CPU를 할당받지 못해기아현상이 발생할 수 있다.
▶기아현상: 우선순위가 낮은 프로세스가 장시간동안 자원을 할당받지 못한 상태
SJF원리 : 사전설정
각프로세스의Burst time(ms)
, , ,
SJF스케쥴로Waiting time,Turnaround time계산
。Burst time가 작은프로세스순으로 스케쥴링
▶ → → →
Waiting time계산
。각프로세스의Waiting time
, , ,
。Total Waiting time:
。Average Waiting time:
Turnaround time계산
。각프로세스의Turnaround time
, , ,
。Total Turnaround time:
。Average Turnaround time:
SJF스케쥴링의 문제점
。각프로세스의next CPU burst를 알 수 없으므로 구현이 어렵다
▶ 해당task의 작업처리시간을 정확히 예측할 수 없으므로.
。따라서,next CPU Burst를 근사적으로 예측
프로세스의next CPU Burst를 예측하는 방법
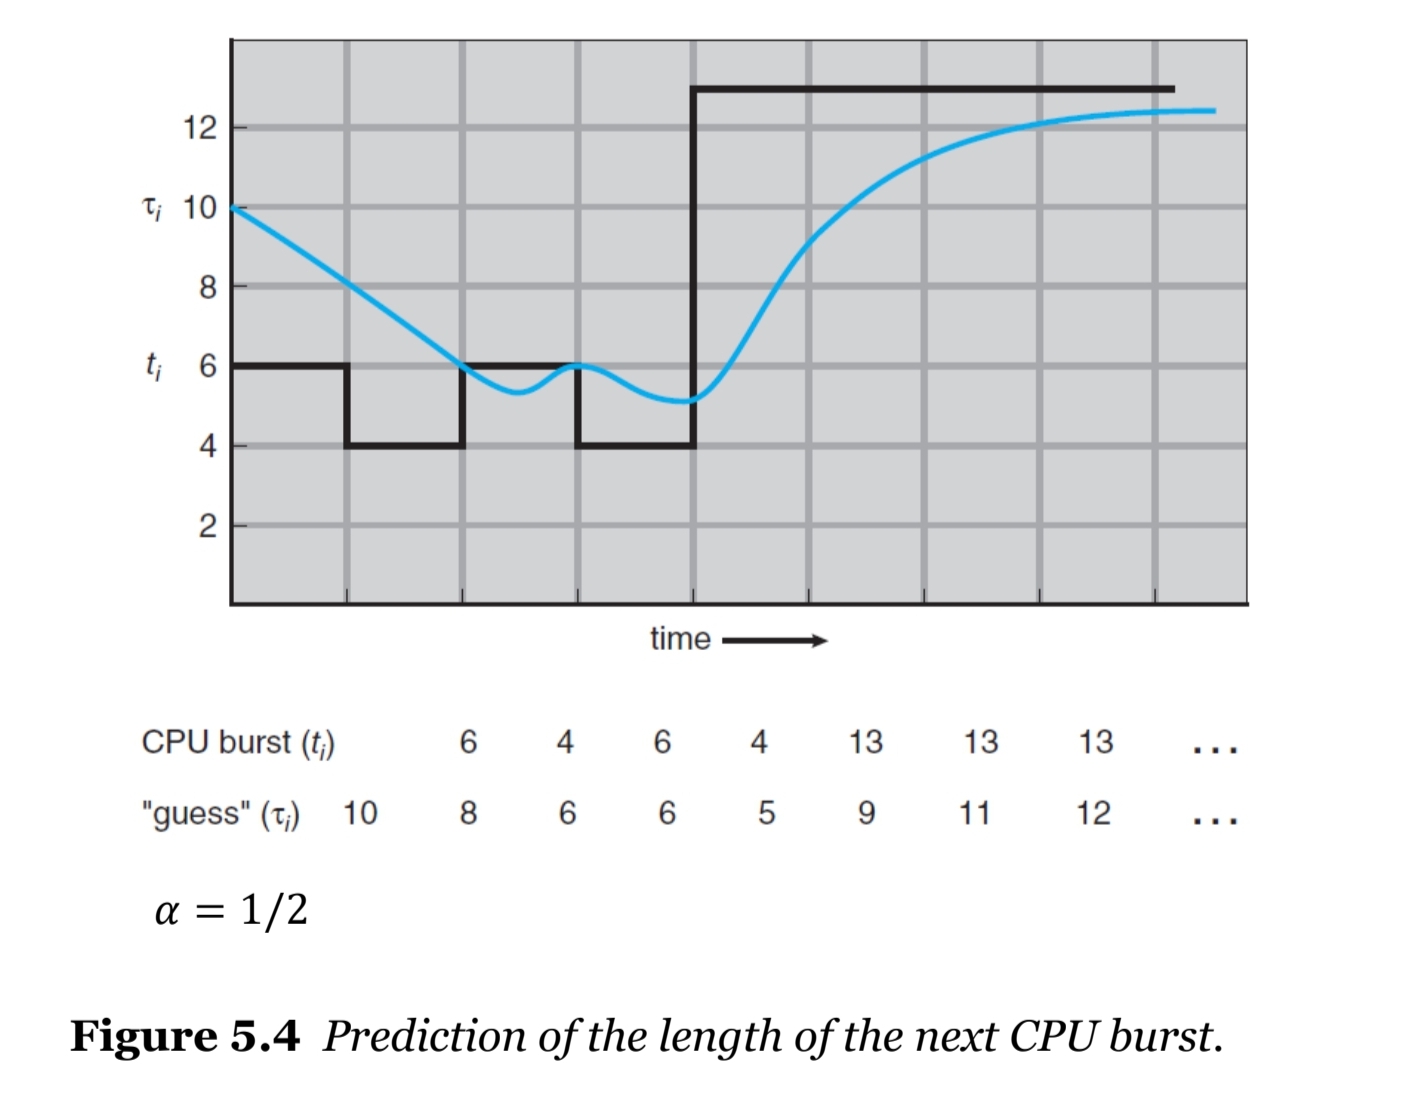
。과거시점에서 측정된CPU Burst들을 통해exponential average를 도출
。 : 번CPU Burst실제값
。 : 번next CPU Burst예측값
。 : 번의next CPU Burst의 예측값
。 : 가중치
▶ 값을 조정하면서 과거의CPU Burst예측값과 최근CPU Burst간의 가중치를 부여가능
▶ 에 가까울 경우 과거 예측값을 중점적으로 반영
。 일때,
▶
。실제CPU Burst( 검정 )에 매우 근사하게 도출
SRTF스케쥴링( Shortest Remaining Time First )
。선점형 SJF 스케쥴링방식
。CPU가 배정된프로세스의Remaining time보다Ready Queue에 새로 적재된프로세스의 예측된next CPU Burst가 짧을 경우 해당프로세스로Context Switching수행
▶비선점형 SJF 스케쥴링은 해당 경우 현재CPU가 배정된프로세스를 완료 시킨 후next CPU Burst가 짧은프로세스로CPU배정
SRTF원리 : 사전설정
。각프로세스의Burst time(ms)과Ready Queue에 들어온Arrival time
SRTF스케쥴로Waiting time계산
。현재CPU선점중인프로세스의Remaining time과 새로Ready Queue로 들어온프로세스의next CPU burst를 비교 후Context Switching을 수행
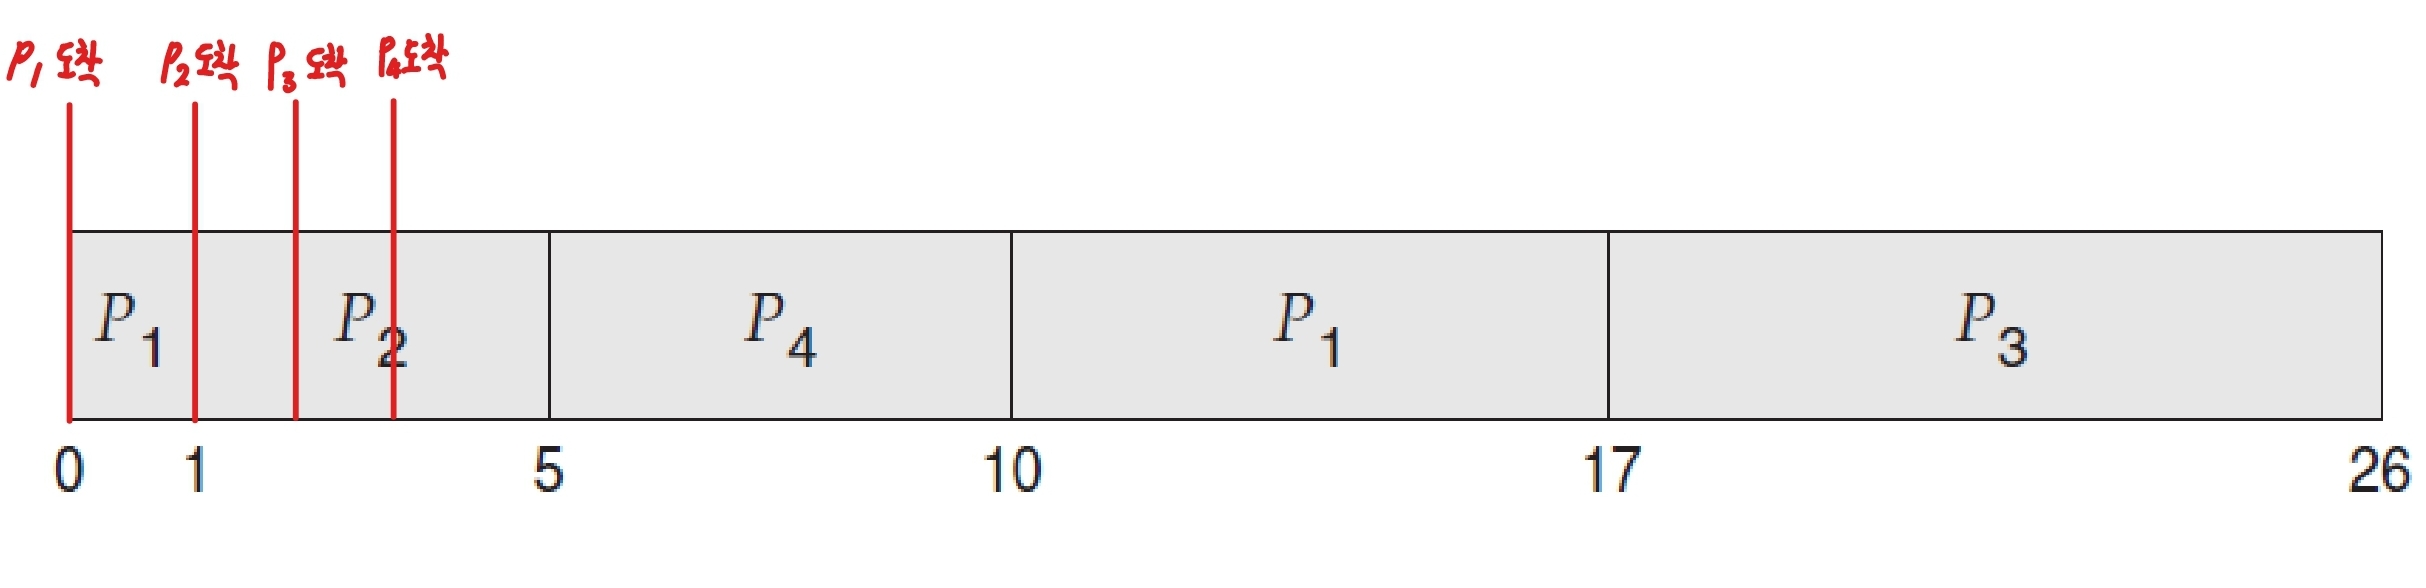
SRTF 스케쥴링
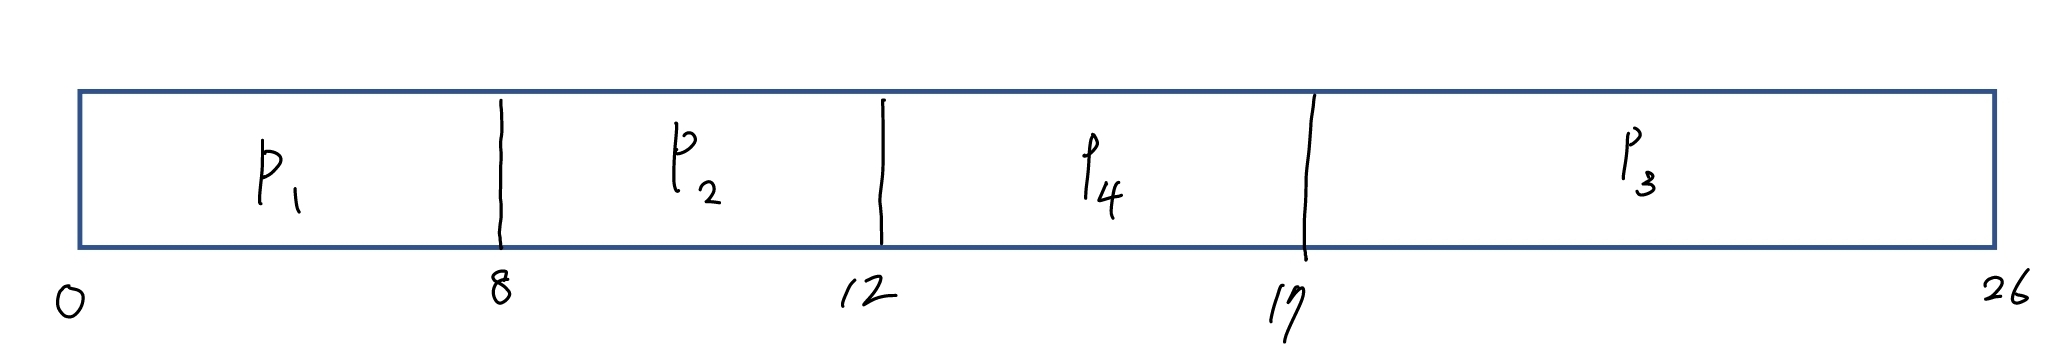
- 이 맨처음
Ready Queue진입 후CPU 배정되어1ms소요 후Ready Queue진입
Remaining time= 8 - 1 = 7
CPU Burst = 4
▶Remaining timeCPU Burst이므로 간Context Switching
CPU배정 후1ms소요 후Ready Queue진입
Remaining time= 4 - 1 = 3
CPU Burst = 9
▶Remaining timeCPU Burst이므로Execute유지
CPU배정 후2ms소요 후Ready Queue진입
Remaining time= 4 - 2 = 2
CPU Burst = 5
▶Remaining timeCPU Burst이므로Execute유지
▶ 모든프로세스가Ready queue에 들어왔으므로 는Context Switching없이Execute
Terminate후CPU Burst가 가장 작은프로세스로CPU할당
CPU Burst: , ,
▶ → → 순으로Execute
。최종적으로 → → → → 순으로Execute
Waiting time계산
。각프로세스의Waiting time
, , ,
▶waiting time에arrival time을 고려하는 경우
。Total Waiting time:
。Average Waiting time:
SJF 스케쥴링으로 도출 시
Average Waiting time:
▶SRTF가비선점형 SJF에 비해 효율적
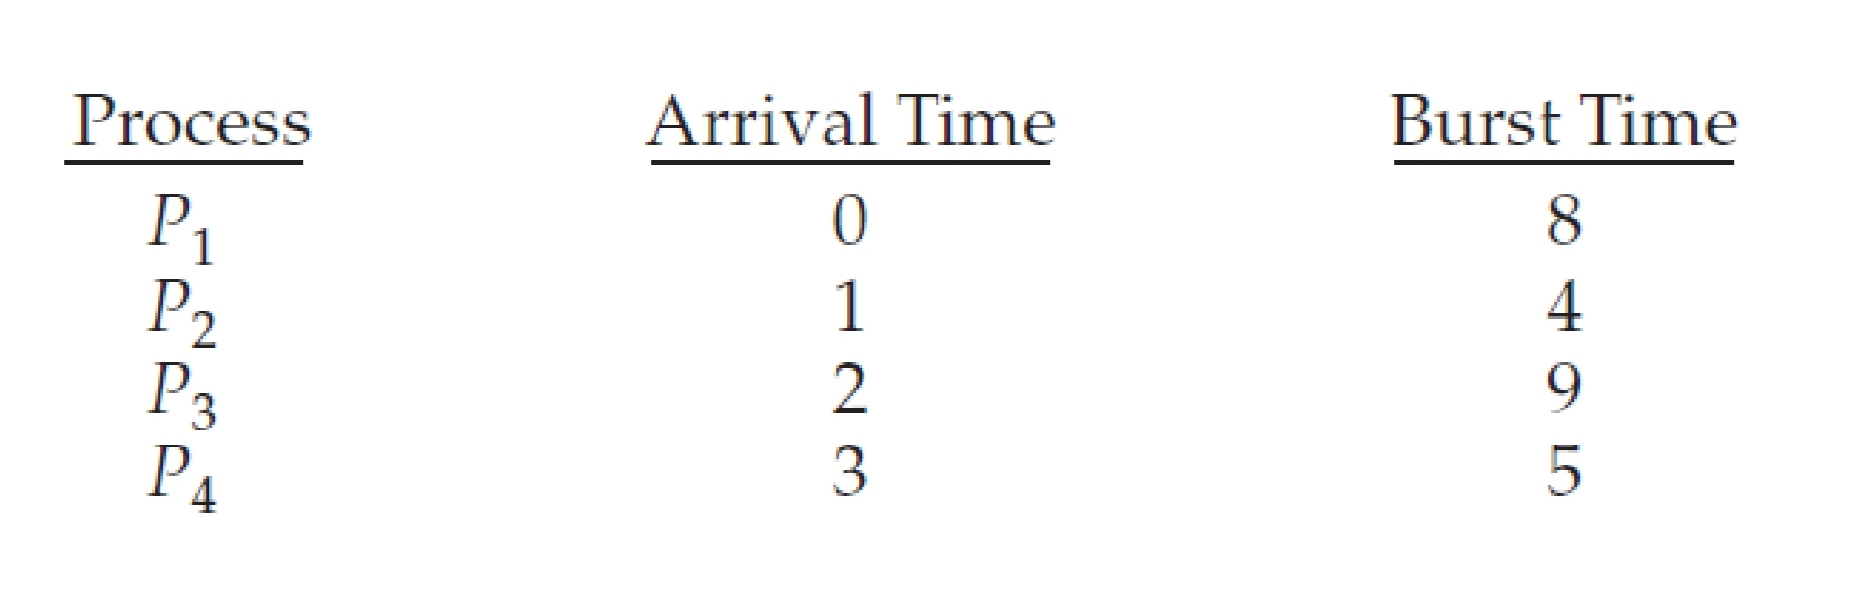
Priority-based스케쥴링
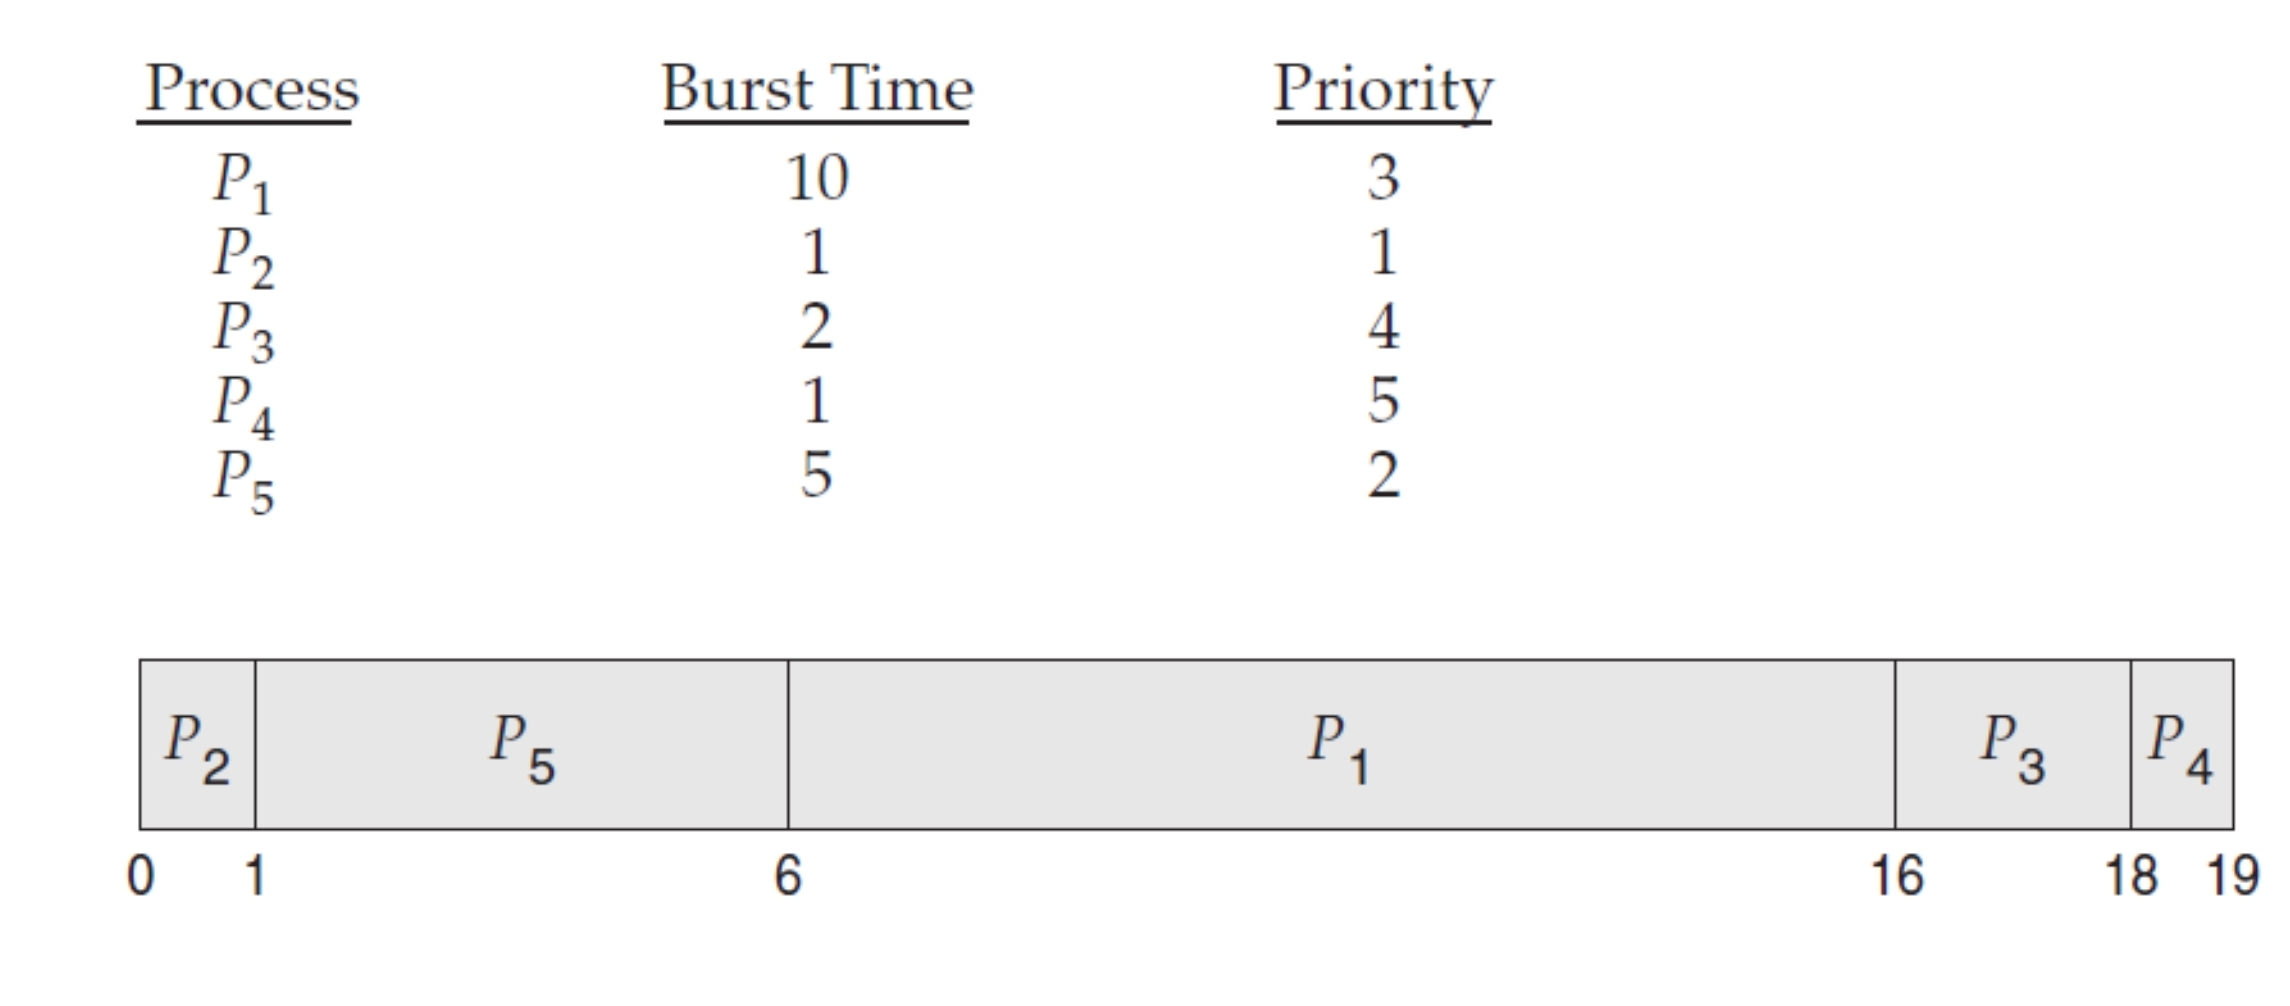
。PCB의 우선순위 정보( =Priority)를 기준으로 우선의Priority를 갖는프로세스에게CPU제어권을 배정하는스케쥴링방식
▶ 각프로세스간Priority가 동일한 경우FCFS 스케쥴링
。SJF 스케쥴링의 경우Priority-based 스케쥴링의Special case.
▶SJF의Priority는next CPU burst의 역순
。일반적으로RR 스케쥴링기법과 조합하여 사용
Priority-based 스케쥴링은선점형 스케쥴링이거나비선점형 스케쥴링
。비선점형:Ready Queue에 더 높은우선순위의프로세스가 도착하더라도 대기
。선점형:Ready Queue에 더 높은우선순위의프로세스가 도착 시CPU 제어권회수
Priority-base 스케쥴링원리 : 사전설정
Priority-based 스케쥴링의 문제점
。기아현상
▶Aging 기법으로 해결
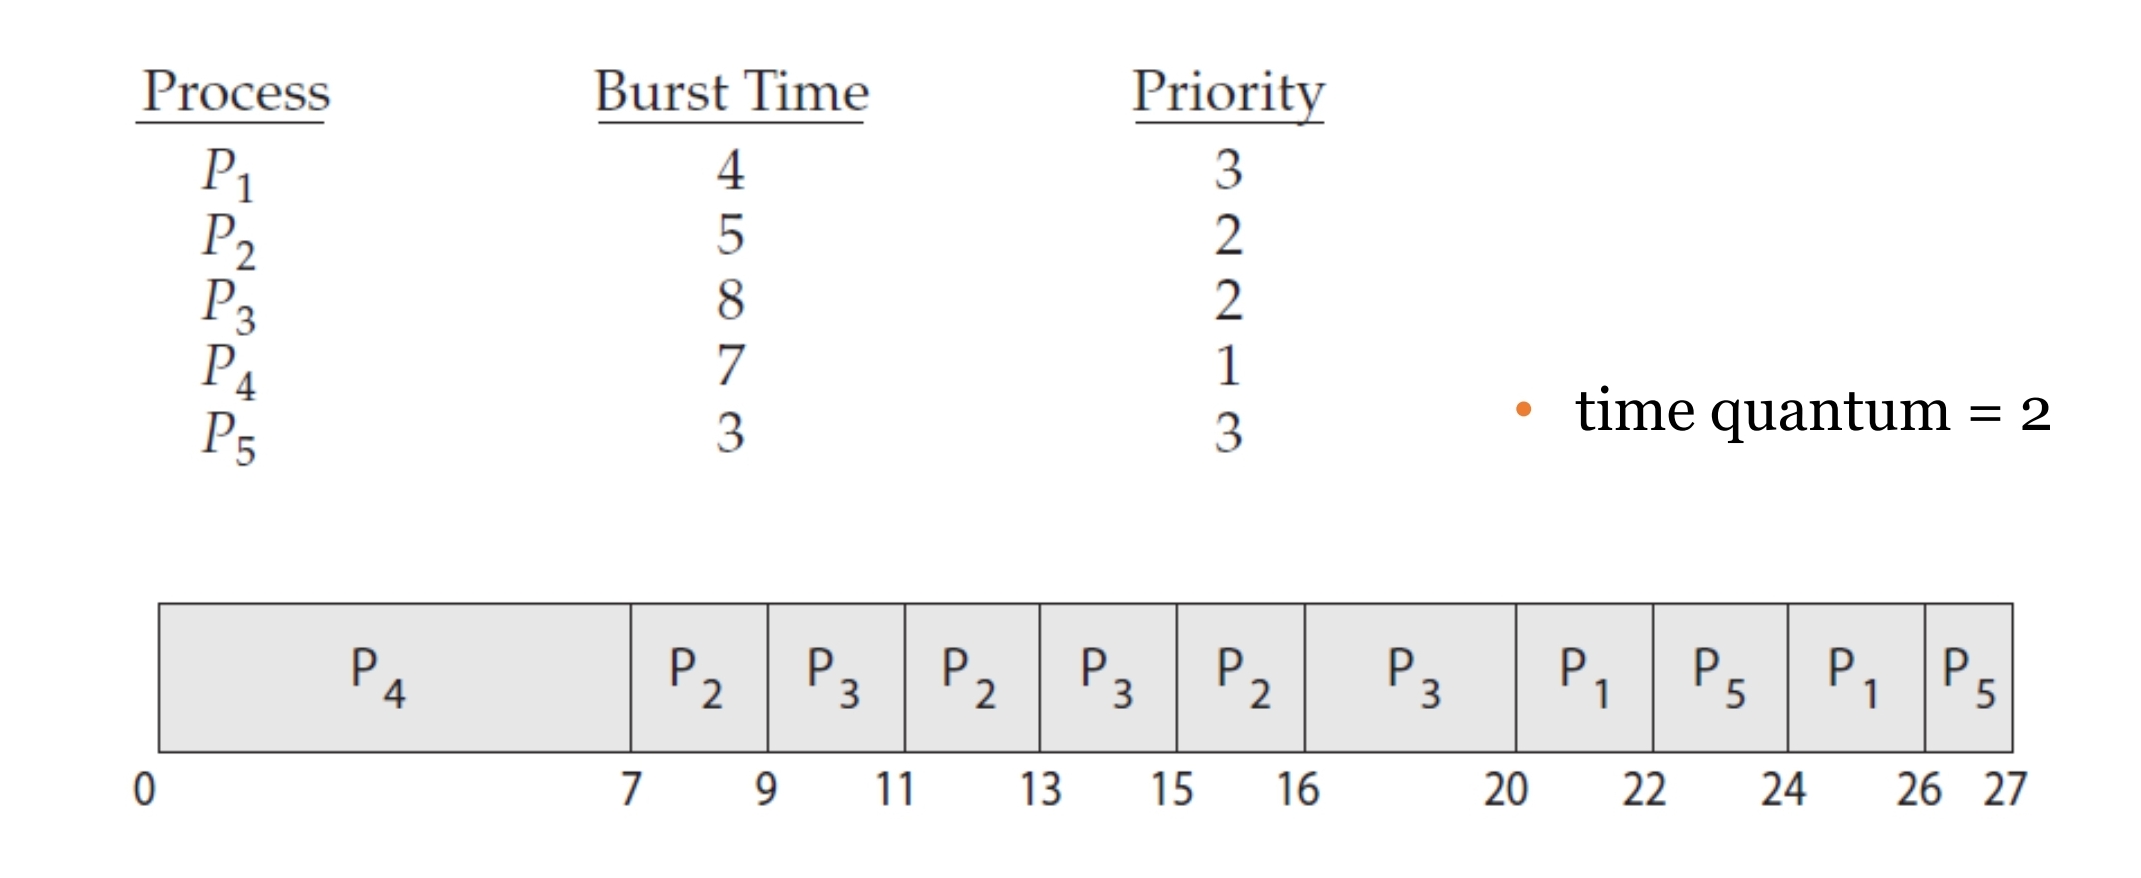
Round Robin,Prioirty-base조합 원리
。프로세스들을 우선Priority를 기준으로스케쥴링을 수행 후 동일한Priority가 발생한 경우Round Robin 스케쥴링을 사용하여스케쥴링을 수행
▶ & 와 & 는priority가 동일하므로 각각RR 스케쥴링수행
RR스케쥴링 ( Round-Robin )
。Ready Queue에 적재된프로세스들에게 각각 동일한시분할을 통해 분할된시간단위(quantum)를 부여하여Interleaving을 수행하는 방식
▶선점형 FCFS방식으로서quantum을 최소화할 경우 가장 빠른응답시간을 기대할 수 있음.
。FCFS방식과 유사하므로Ready Queue는Circular Queue로 구현
▶할당시간(quantum)이 지난프로세스는Cirular Queue의 맨 뒤에서 다시할당을 대기
。단기 스케쥴러는 1time quantum단위로Ready Queue의 각프로세스에게CPU를 배정
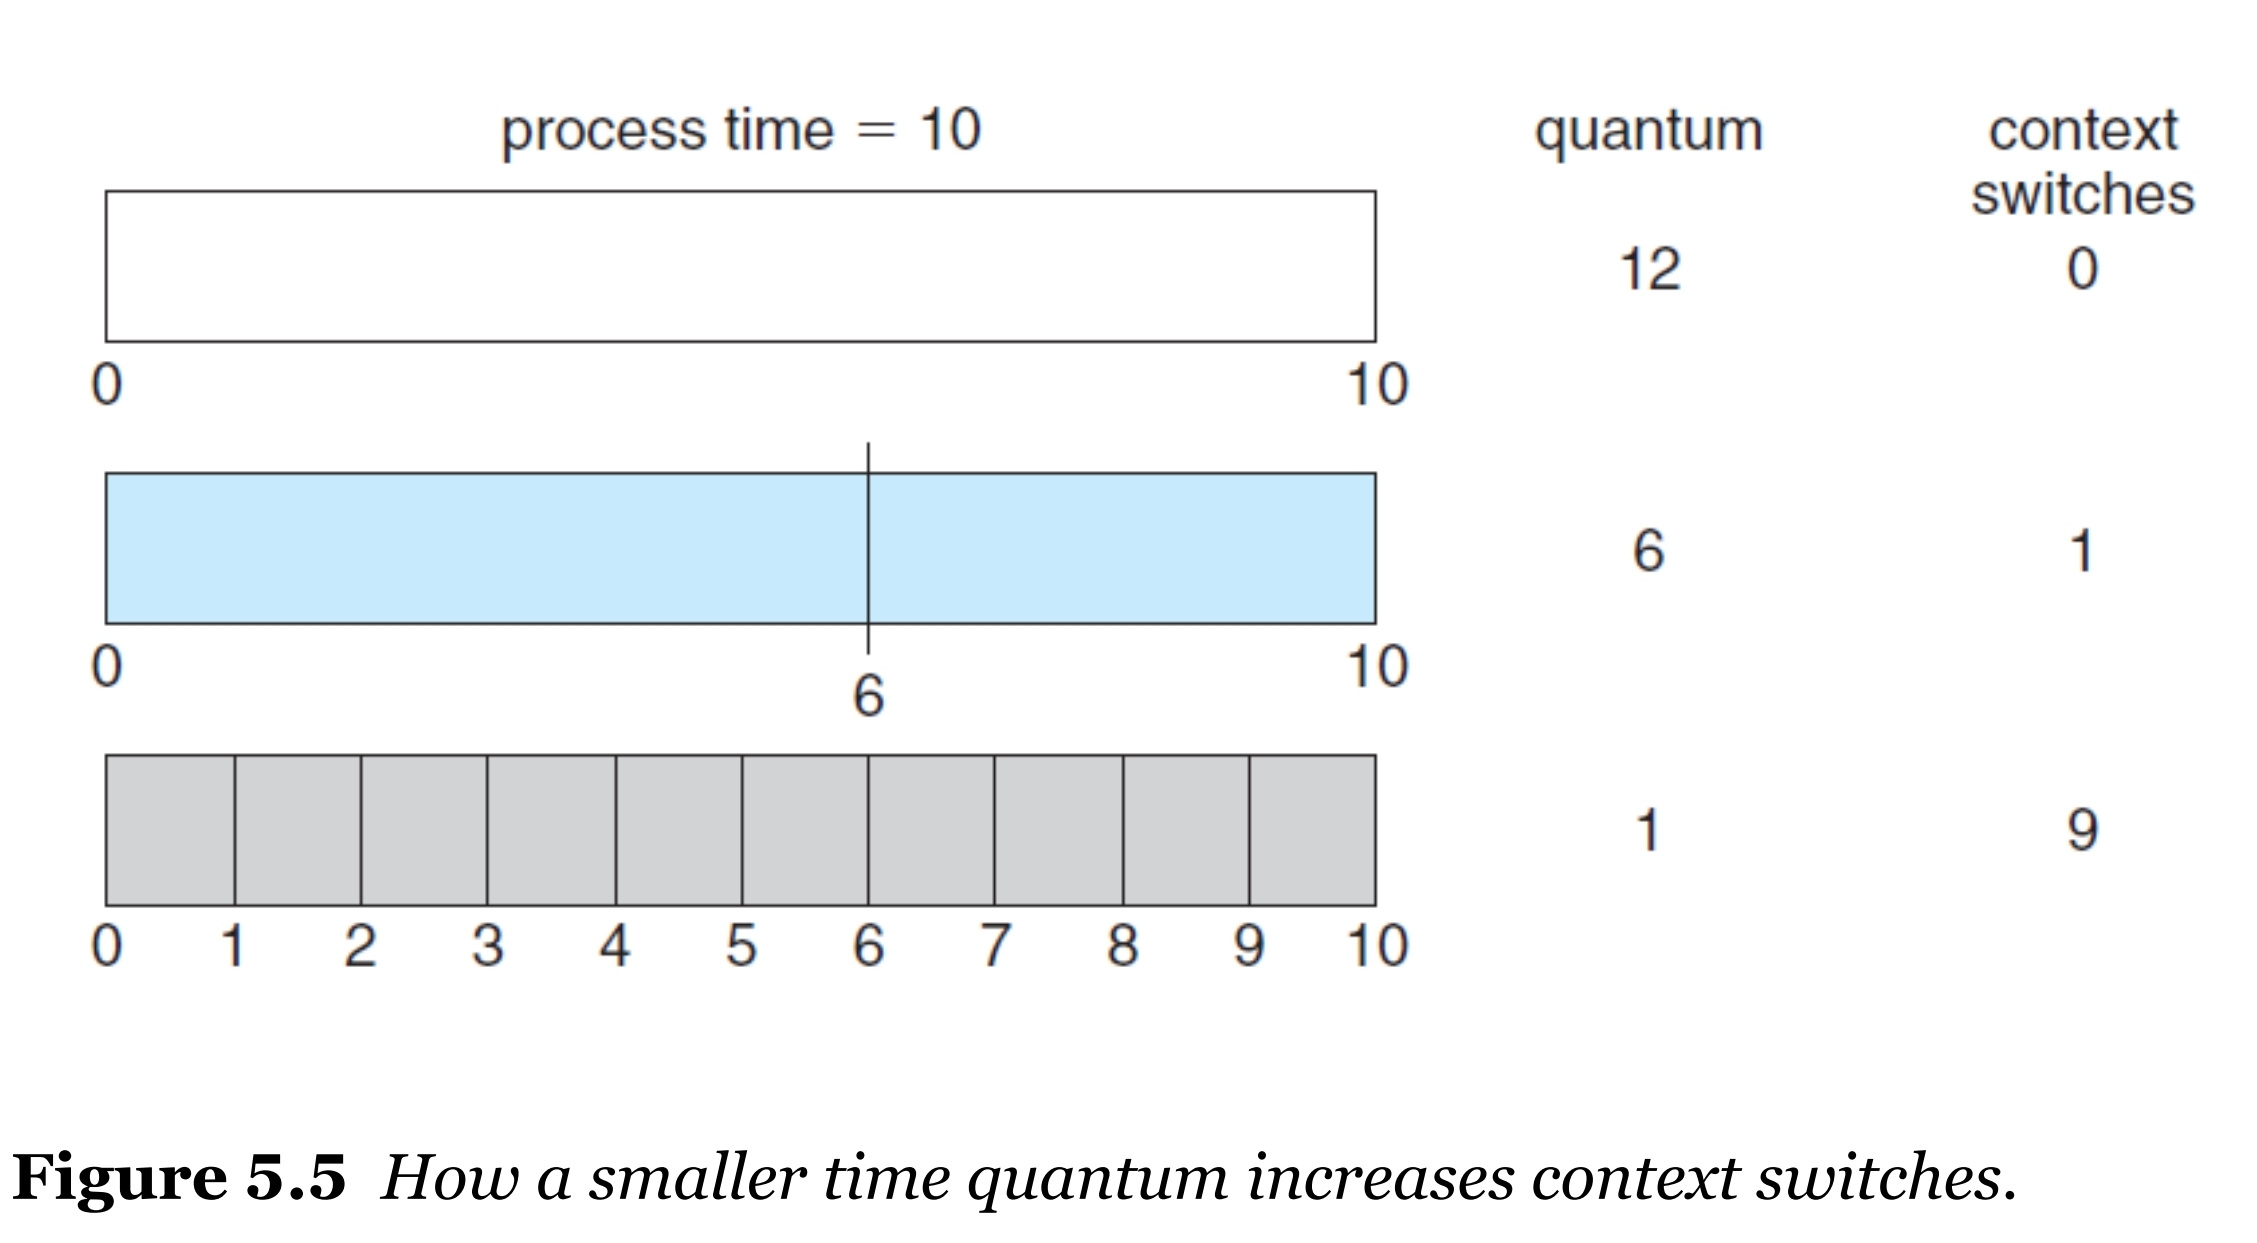
▶time quantum의 사이즈에 따라Context Switching빈도가 변화하면서 성능이 상당하게 변화
。RR policy의average waiting time은 다른스케쥴링에 비해 길 수 있어 최적은 아니지만,Priority-base 스케쥴링과 조합해서 사용 시 좋은 효율을 보임
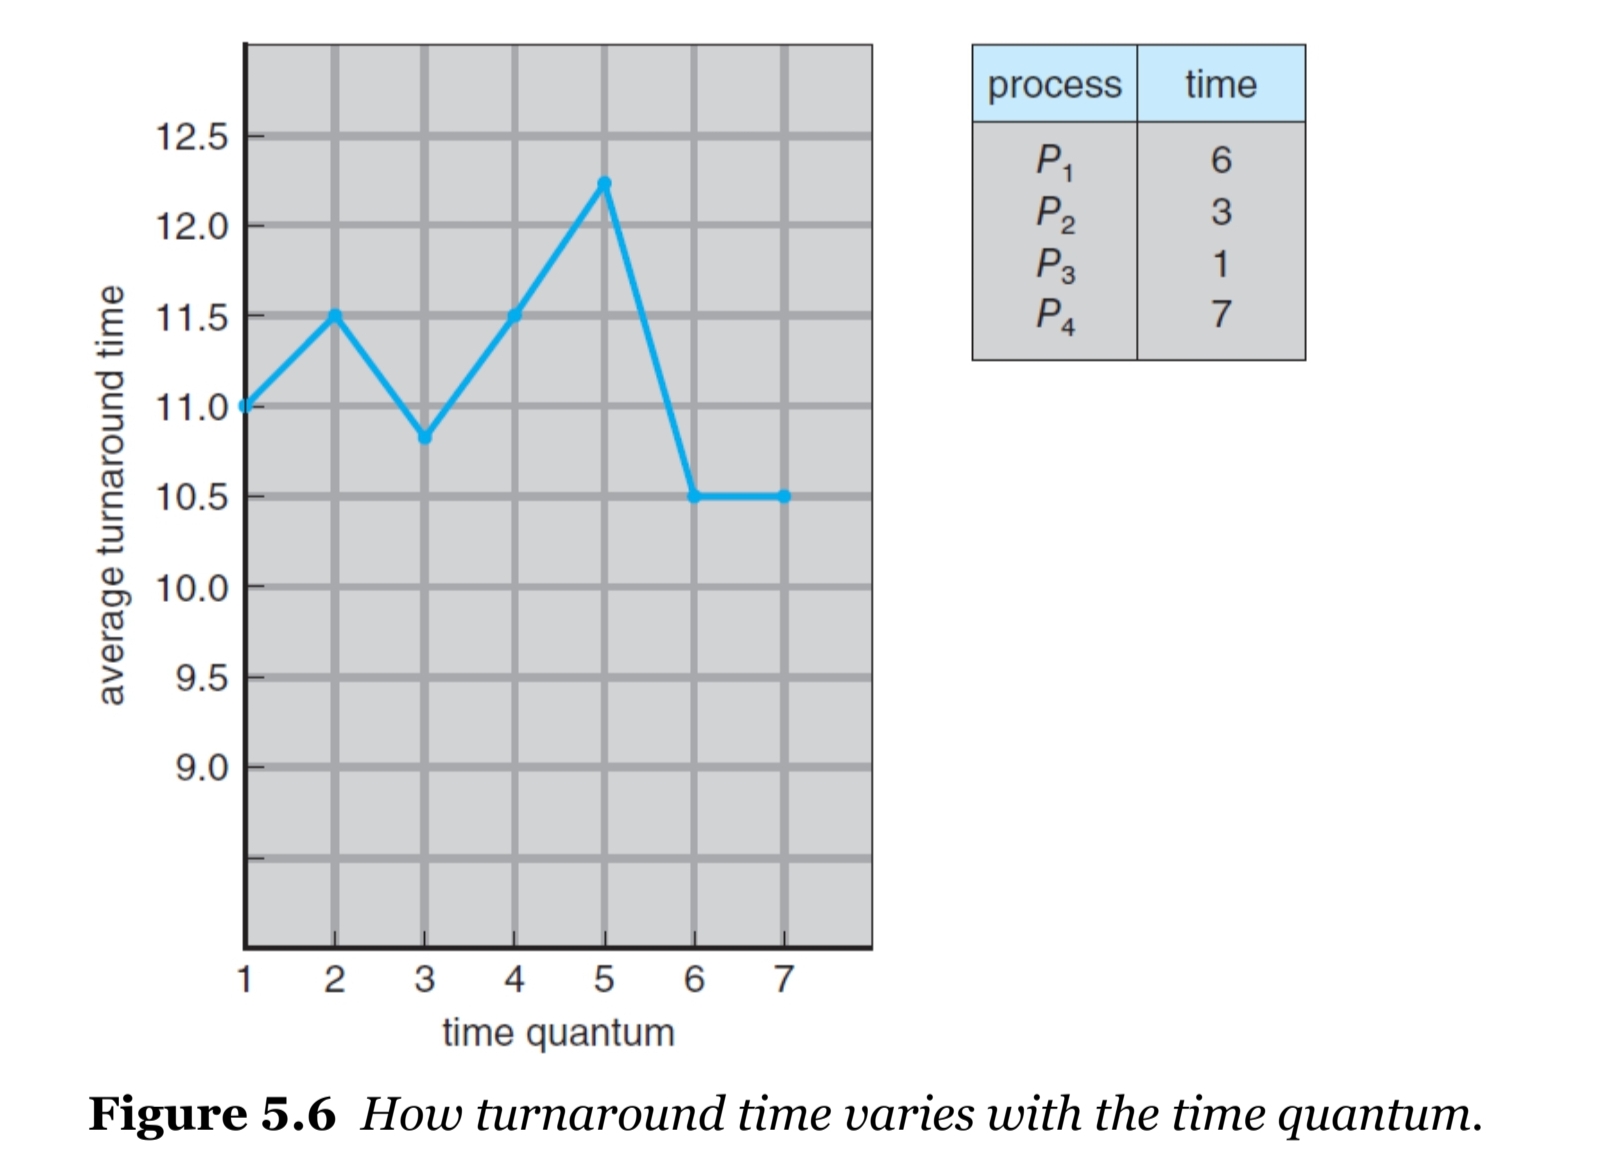
RR 스케쥴링은Time Quantum Size에 따라OS의 성능이 결정
。Time Quantum Size에 따라Context Switch의 빈도 변화
▶Time quantum의 사이즈가 작을수록Context Switch빈도 증가
。Time quantum size가 너무 작아서Context Switch의 발생이 잦을 경우Dispatch Latency때문에 성능이 좋지 않음
▶time quantum = 0.001 ms,dispatch latency = 0.001 ms인 경우 아무런 작업을 처리하지 못하고프로세스를Context Switch
。Time quantum의 사이즈가 클 경우Context Switch가 거의 발생하지않아비선점형인FCFS와 동일한 특성을 지니게됨
▶Time Quantum Size에 따른turnaround time변화
- Time Quantum ( = Time Slice )
。CPU 스케쥴링에서 각프로세스에게 할당된 시간단위
▶10 ~ 100 ms의 매우 작은 시간 단위로 설정
RR스케쥴링 원리
。CPU Burst의time quantum대비 대소여부에 따라 2가지 case가 존재
。선점형 프로세스이므로CPU회수 발생
프로세스의CPU Burst가1 time quantum보다 작은 경우
。CPU Burst후프로세스는CPU를 자발적으로 해제 (release the CPU voluntarily)
ex )1 time quantum = 10 ms일때CPU Burst = 5 ms
프로세스의CPU Burst가1 time quantum를 초과한 경우
。timer가OS에게인터럽트를 전송 및Context Switch를 실행
▶CPU회수된프로세스는Ready Queue 꼬리로 전달됨
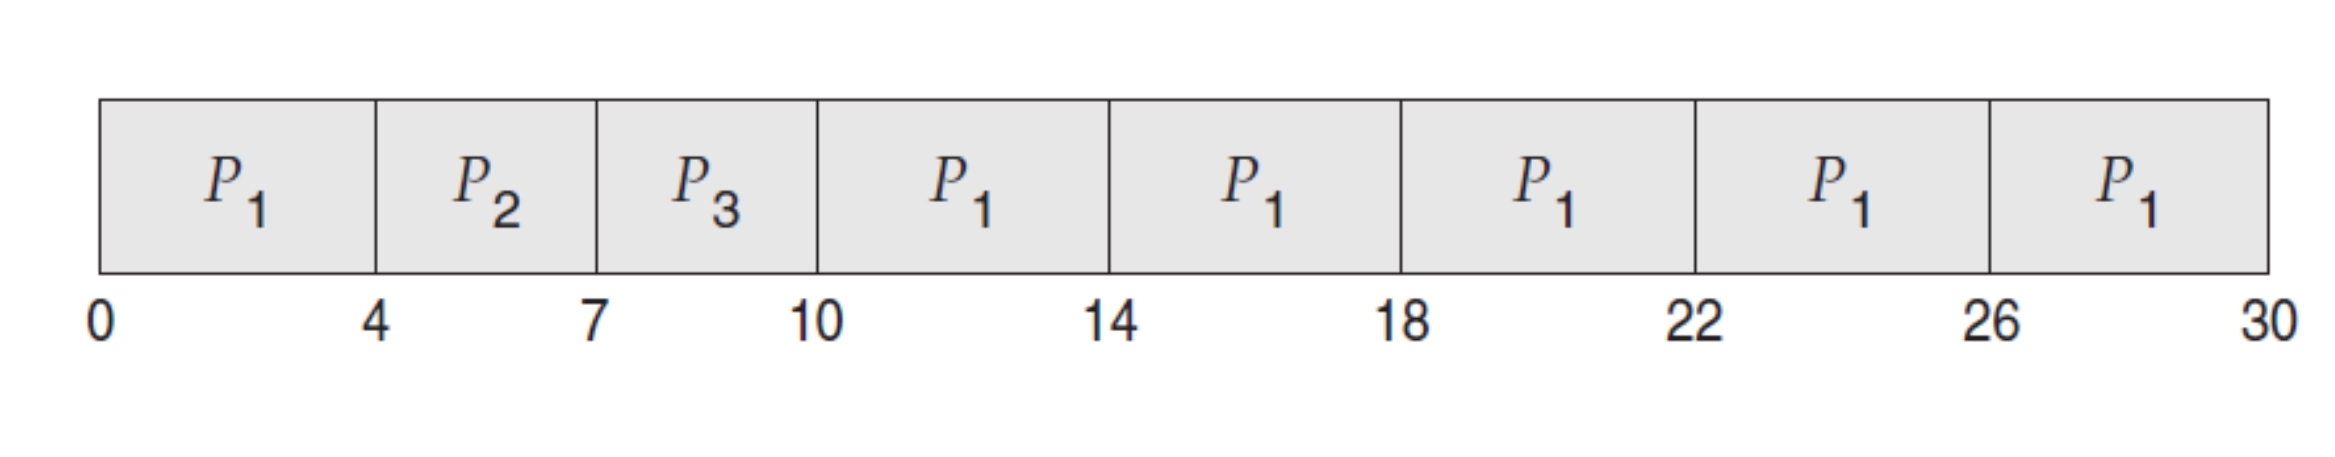
RR원리 : 사전설정
각프로세스의Burst time(ms)
, ,
time quantum = 4ms
RR스케쥴로Waiting time계산
Circular Queue로 → → 순으로 들어온 경우
。은4ms경과 후 로Context Switching및Ready Queue의 꼬리로 전달
Waiting time
, ,
Average Waiting time=
MLQ스케쥴링 ( Multi-Level Queue )
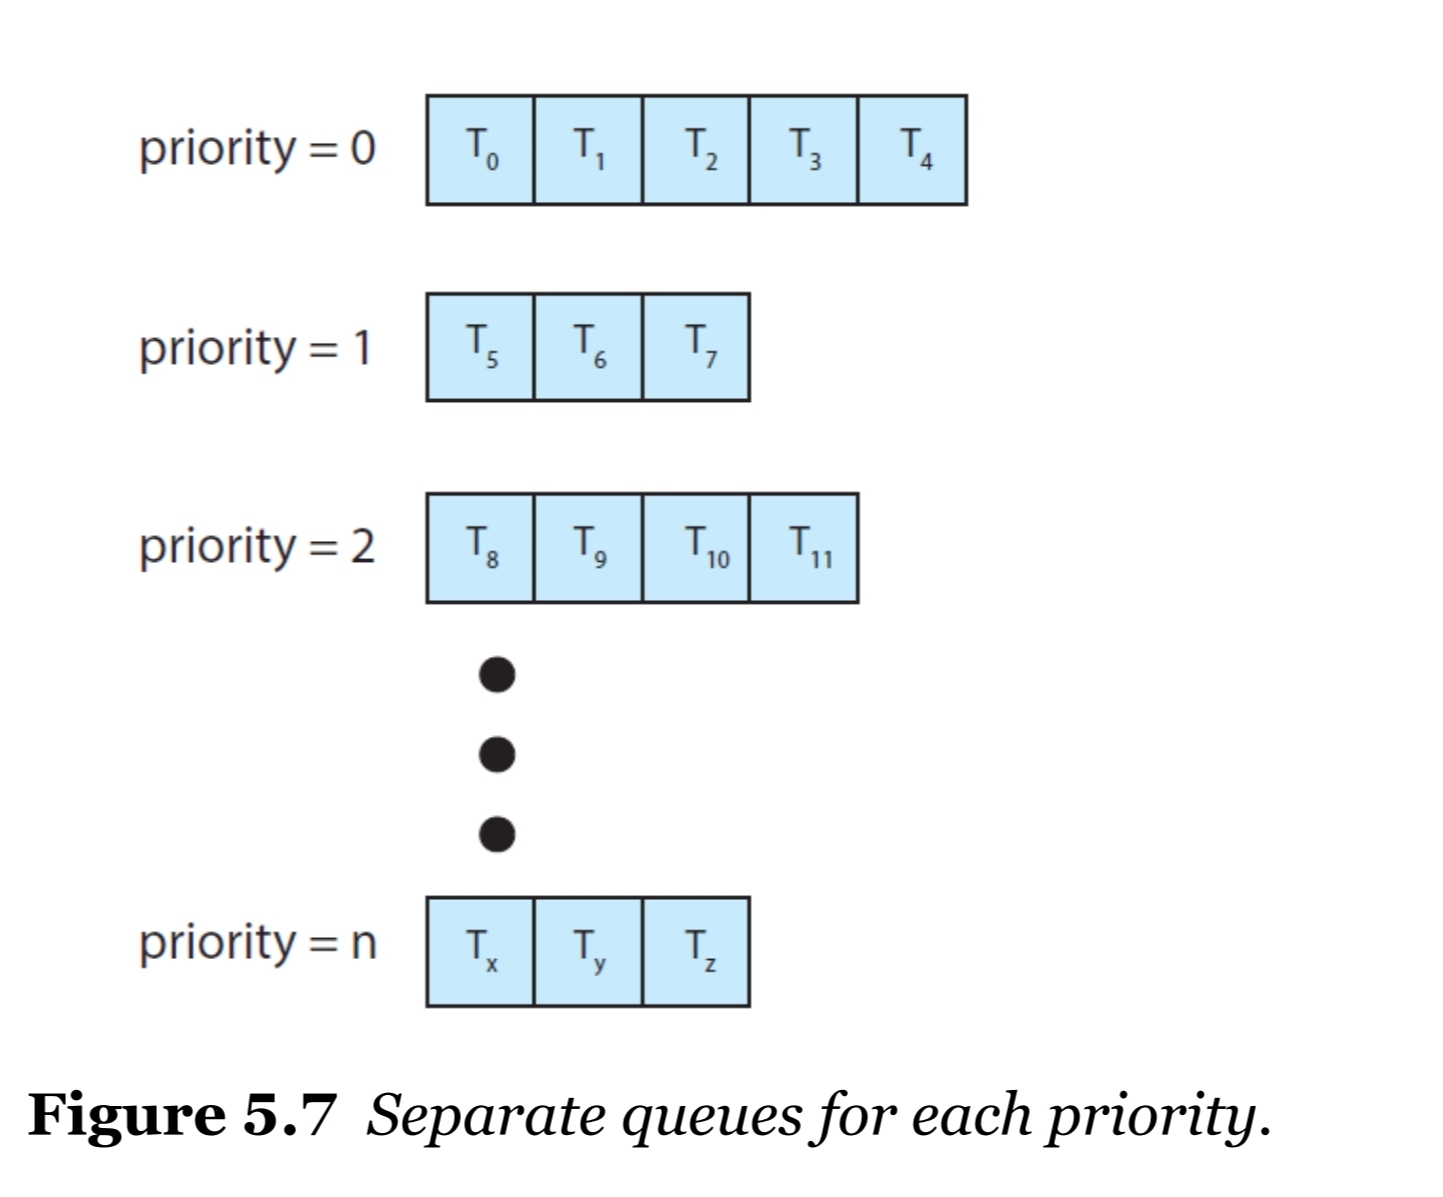
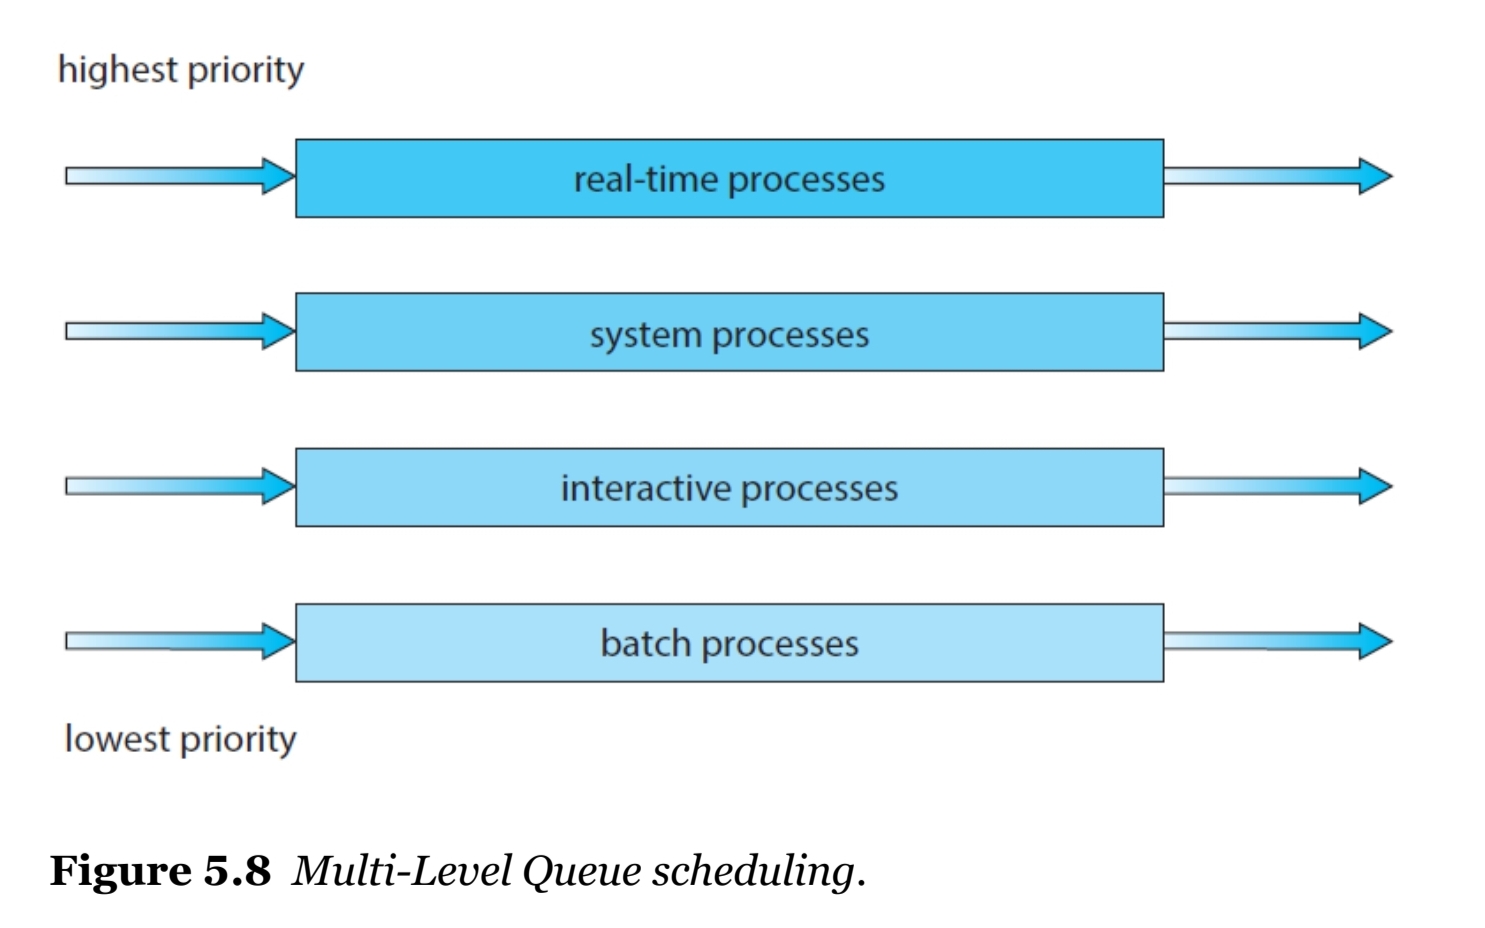
。Ready Queue내프로세스들을priority가 배정된 각 범주의Ready Queue로 구분 및priority에 따라스케쥴링수행
。각Ready Queue는 독자적인스케쥴링 알고리즘을 보유.
。각 범주 (real-time,system,interactive,batch,... )의Ready Queue로프로세스를 분할 후priority의 순서대로Ready Queue에 소속된프로세스를 우선처리
MLQ 스케쥴링문제점
。가장 높은priority의Ready Queue에 소속된프로세스수가 압도적으로 많아 그보다 낮은priority의Ready Queue에 소속된프로세스가Execute되지 않을 수 있음
ex ) 많은 작업량의 높은priority의CPU Bound에 의해 적은 작업량의I/O Bound는 실행되지못함.
▶MLFQ 스케쥴링사용
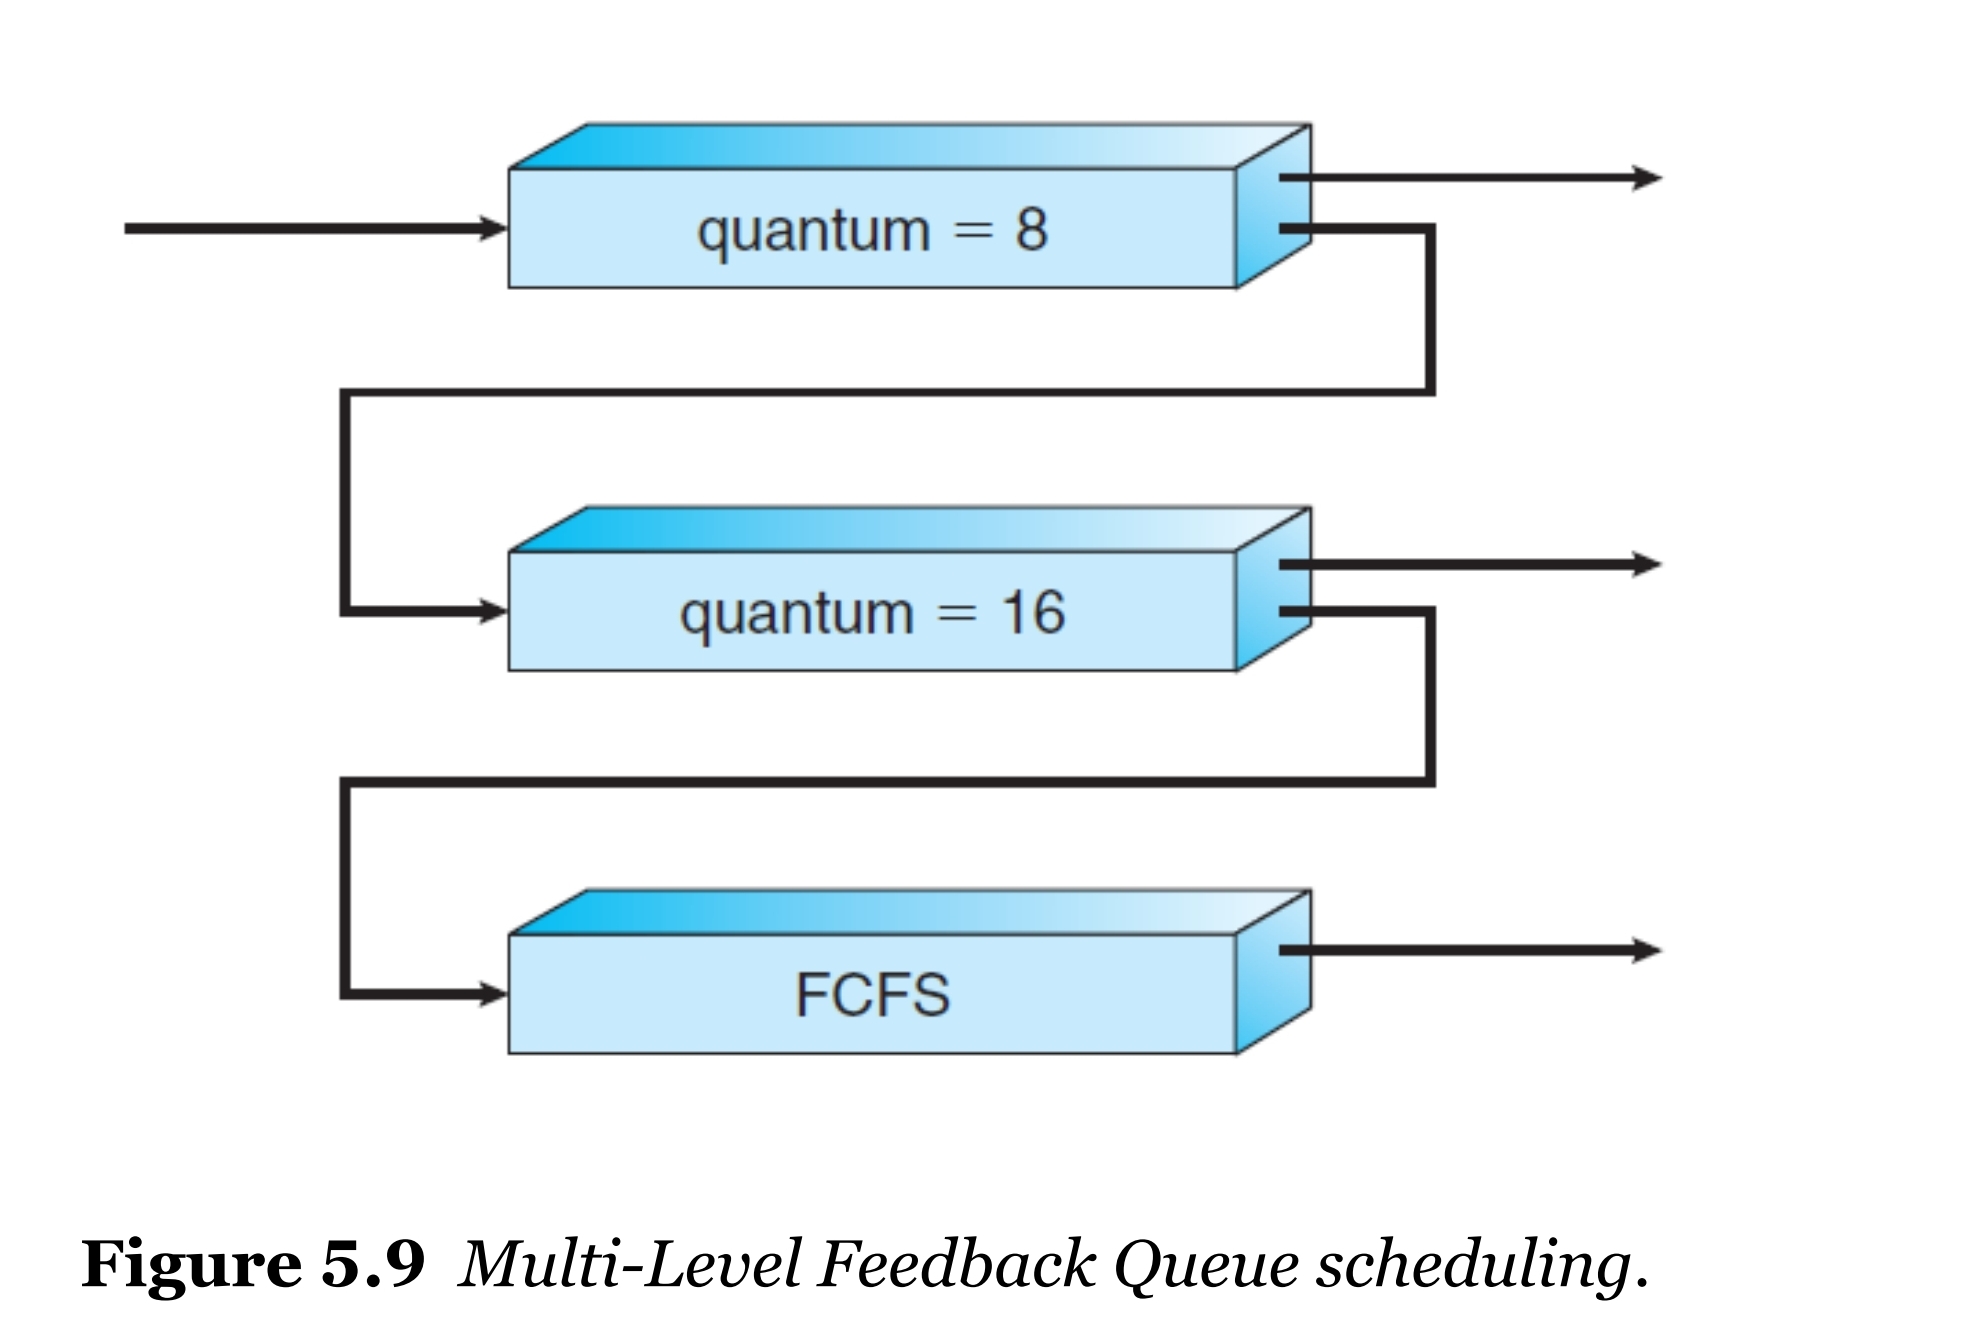
MLFQ스케쥴링 ( Multi-Level Feedback Queue )
。실제OS에서 가장 자주 사용되는스케쥴링방식
。여러개의 우선순위가 다른Ready Queue를 사용하여 하나의Ready Queue에서 처리못한프로세스를 우선순위가 더 높은Ready Queue로feedback하여 우선순위를 높여준다.
。MLQ 스케쥴링의 낮은priority의Ready Queue에 소속된프로세스는 실행되지 않는 단점을 개선
▶RR의 개념을 차용
MLFQ원리
。큰 작업량의 높은 우선순위의프로세스를time quantum만큼 작업함으로써 다른 낮은 우선순위의프로세스에 대한Execute기회를 제공
▶프로세스는 작업을 거칠때마다 할당된time quantum이 증가하면서 점점 많은CPU burst time을 할당받으면서 동시에 우선순위가 높아짐
- 초기 큰 작업량을 보유한 높은
priority의프로세스가 들어간 경우8 ms만큼CPU를 배정 후Context Switch를 발생시켜Wait Queue로 전달
。 이후 다음priority의프로세스에CPU를 배정
。Wait Queue로 전달된프로세스는 더 높은 우선순위의Ready Queue로 전달
- 전달된
Wait Queue에서Ready Queue를 통해Running시 다음번에16 ms만큼 증가된cpu burst time동안CPU를 배정.
- 전달된
Wait Queue에서Ready Queue를 통해Running시 작업이 완료될 때까지CPU를 배정
스레드 스케쥴링( Thread Scheduling )
。대부분의OS의CPU Scheduling은프로세스보다는Kernel Thread를 대상으로스케쥴링을 지원
▶ 위스케쥴링 알고리즘개념을프로세스에서스레드로 대입하여 이해하기.
。User Thread는User Level Library에 의해 생성 및 관리되므로OS에 의해 인식되지않아CPU Scheduler에 의한스케쥴링은 적용되지않으나,Kernel Thread와매핑하여 간접적으로 상호작용
실시간 운영체제( Real-time Operating System )의스케쥴링
。Soft Realtime또는Hard Realtime의스케쥴링은Priority-base 스케쥴링사용
실시간( Real-time ) 종류
。실시간: 정해진 시간 내 작업을 완료
- Soft Realtime
。critical real-time process가스케쥴대로 완료될 보장은 없지만non-critical real-time process보다는 우선Execute될 보장이 있는 방식
ex ) 전화에서RF신호가0.1초당1MB씩 처리할때,RF신호가0.1001초 경과해서 처리해도 괜찮은 경우
- Hard Realtime
。task가 반드시deadline이내에 완료되야하는 방식
