우리가 자바소스 코드를 만들면, 자바 컴파일러는 우리가 만든 자바소스코드를 바이트코드로 변환합니다.
변환된 파일을 JVM의 클래스로더는 로딩->링크->초기화 과정을 거칩니다. 그 후, JVM이 운영체제로부터 일정 할당받은 RunTime Data Area의 메서드 영역에 올려놓습니다.
그렇게 Runtime Data Area에 올라온 목적파일을 각 운영체제가 이해할 수 있는 기계어로 변환하는 작업을 하는 것이 실행엔진입니다.
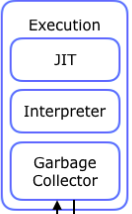
바이트 코드를 기계어로 번역하는 역할을 인터프리터와 JIT컴파일러가 담당합니다.
✅ 인터프리터
인터프리터는 런타임 중 바이트 코드를 한 라인씩 읽고 기계어로 번역합니다. 반복 호출되는 코드를 매번 번역해야해서 속도가 느리다는 단점이 있습니다.
✅ JIT(Just In Time) 컴파일러
JIT 컴파일러는 인터프리터의 속도 문제를 개선하기 위해 사용하는 컴파일러입니다.
자주 실행되는 바이트 코드 영역을 런타임 중에 기계어로 컴파일하여 사용합니다.
컴파일 임계치를 만족하는 코드는 JIT 컴파일러에 의해 컴파일이 수행됩니다.
- method entry counter : JVM 내에 있는 메소드가 호출된 횟수
- back, edge loop counter : 메소드가 루프를 빠져나오기까지 회전한 횟수
컴파일 임계치가 일정 횟수에 도달한 코드는 컴파일 하기 충반하다 판단되어 큐에 들어가 대기하고, 컴파일 쓰레드에 의해 컴파일 됩니다.
컴파일된 코드는 캐싱되어 사용할 수 있기에 속도를 향상시킬 수 있습니다.
캐싱된 코드는 RunTime Data Area의 Native Method Stack에 저장되어 인터프리터에 역할 필요 없이 바로 실행됩니다.
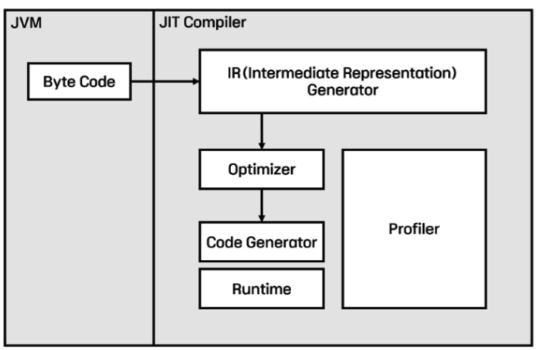
- JIT컴파일러는 내부적으로 바이트 코드를 최적화처리를 위한 IR이라는 중간 코드로 표현합니다.
- 옵티마이저는 IR코드를 최적화합니다.
- Code Generator는 최적화된 중간코드를 기계어로 번역한다.
- Profiler는 반복 호출되는 메서드를 찾는 역할을 담당합니다.
✅ Garbage Collector 가비지 컬렉터
클래스로더가 로딩이 끝나면 클래스 타입의 객체를 생성해서 Heap 영역에 저장한다고 했었습니다.
가비지 컬렉터는 자동으로 메모리를 관리해주는 기능으로,
Heap 영역 메모리 공간에 할당된 객체 중 사용되지 않거나 오래된 객체의 메모리를 반환함으로써 메모리 사용의 효율을 증가시킵니다.
개발자 입장에서는 메모리 누수에 신경쓰지 않아도 된다는 것이 장점입니다.
✅ Garbage Collector 동작 원리
가바지 컬렉터는
- 대부분의 객체는 금방 접근 불가능한 상태가 됩니다.
- 오래된 객체에서 젊은 객체로의 참조는 아주 적게합니다.
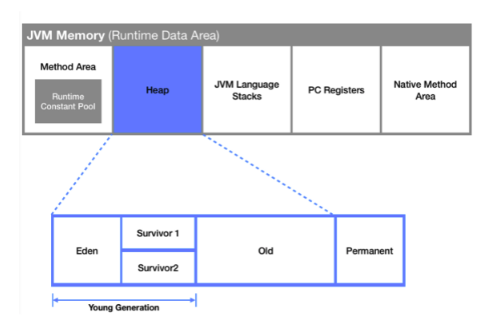
새롭게 생성된 객체의 대부분은 Young Generation이라고 불리는 Young 영역에 생성됩니다. 생성되고 나서 참조되지 않는 이유 등으로 Young 영역에 있던 객체들이 사라지는데 이를 MinorGC가 발생했다고 합니다.
Young영역에서 살아남은 객체는 Old Generation이라 불리는 Old영역에 생성됩니다. 이 영역에 있던 객체가 사라지는 것을 MajorGC라고 합니다.
✔️ Young 영역
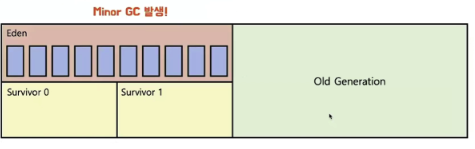
새로 생성된 객체는 Eden영역에 위치합니다.
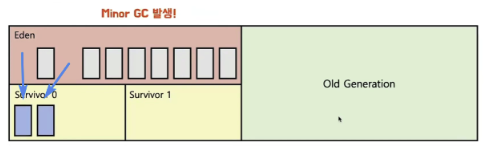
Eden영역이 꽉차면 unReachable한 객체를 삭제하는 minorGC가 한 번 발행한 후, 살아남은 객체는 두 개의 Survivor영역 중 하나로 이동됩니다.
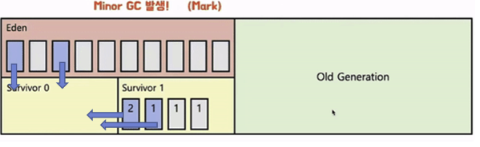
한 Survivor 영역에 쌓다가 Survivor 영역이 꽉차게 되면, 쌓여있던 객체를 다른 Survivor으로 옮기기 전에 MirnorGC를 통해 제거할 걳은 제거하고 살아남은 객체를 옮깁니다.
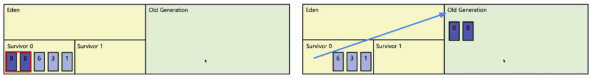
이 과정을 계속 반복하다 살아남은 객체(임계값에 도달한 객체)는 Old 영역으로 이동한다.
위 과정을 보면 알겠지만, Survivor 영역 중 하나는 반드시 비어있는 상태로 남아야 한다.
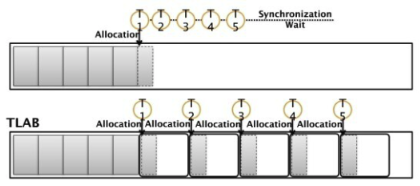
또한, 메모리를 할당할 때 마지막으로 메모리가 할당된 객체를 통해서 다음 객체를 할당하는 방식인 bump-the-pointer 기술로 신속하게 처리할 수 있습니다.
하지만, 멀티 쓰레드 환경에서는 해당 방식이 Thread-safe하지않기 대문에 락을 사용할 수 밖에 없으며 성능이 매우 떨어질 수 있습니다.
그래서 개선된 TLAB방식입니다.
쓰레드마다 할당을 위한 주소 범위를 부여해서 그 범위 내 아무런 동기화 작업 없이 할당하게 하는 것입니다.
많은 수의 스레드가 영역을 할당받은 채 사용되지 않으면 메모리 단편화가 발생할 수 있으니, 스레드별 사이즈를 감소시키는 방식을 사용할 수 있습니다.
✔️ Old 영역
old영역에 객체가 계속 쌓이면 메모리가 부족해지고, 이떄 MajorGC가 발생합니다.
✔️ GC 방식 종류와 특징
📌Serial GC
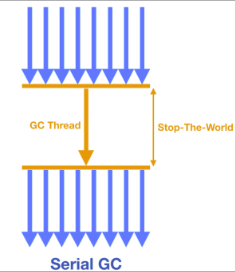
SerialGC는 Young영역에서는 Mark and Sweep 과정을 수행되며 Eden 영역에서 Survior 영역으로 이동시키고 계속해서 살아남는 객체를 Old 영역으로 이동시킵니다.
Old 영역에서는 Compact과정도 추가됩니다.
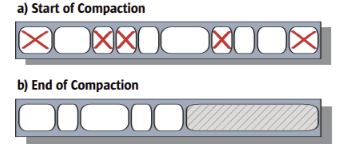
객체를 정리한 뒤, 남은 객체들을 한 곳으로 모으는 작업입니다.
SerialGC는 1개의 쓰레드만 이용하기 때문에 객체를 옮길때 객체를 1개씩 순차적으로 옮기기 떄문에, CPU의 코어가 여러개인 운영 서버에서 SerialGC를 사용하는 것은 피애햐합니다.
실행 명령어 - java -XX:+UseSerialGC -jar Application.java
📌Parallel GC
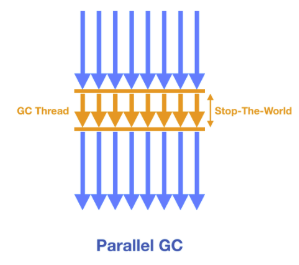
이는 SerialGC와 기본적인 알고리즘은 같지만, Young영역의 MinorGC를 멀티쓰레드로 수행.(Old영역은 여전히 싱글쓰레드) 그렇기에 GC 처리량을 증가시킬 수 있어 Serial방식보다 Stop thw world가 짧습니다.
실행 명령어 - java -XX:+UseParallelGC -jar Application.java
실시간 성이 매우 강조되는 프로그램일 경우 GC에게 메모리를 맞기는 것은 맞지 않을 수 있습니다.
따라서 어플리케이션의 사용성을 유지하면서 효율적이게 GC를 실행하는 최적화 작업이 개발자의 숙제가 됩니다.
그렇기에 GC튜닝은 필요합니다.
📌Parallel Old GC (Parallel Compacting Collector)
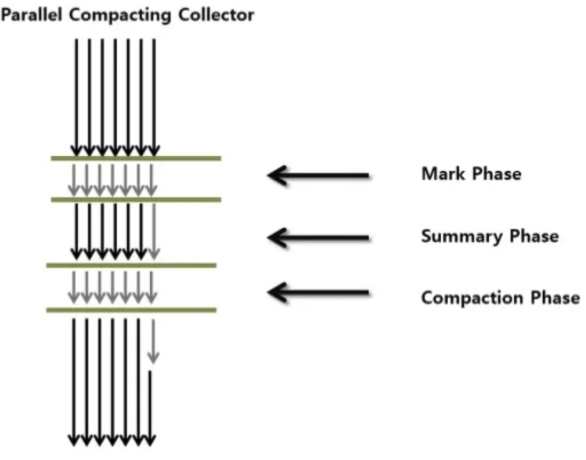
ParallelGC를 개선한 버전으로, Young영역 뿐만 아니라, Old영역에서도 멀티 쓰레드로 GC수행합니다.
카비스 컬렉션 청소방식인 Mark-Summary-Compact방식을 이용합니다.(Mark-Sweep-Compact가 아닌)
- mark단계에서는 old영역을 region별로 나누고 region별로 살아있는 객체를 식별한다.
- summary단계에서는 region별 통계정보로 살아있는 객체의 밀도가 높은 부분이 어디까지 인지 dense prefix를 정한다. 오랜 기간 참조된 객체는 앞으로 사용할 확률이 높다는 가정하에 dense prefix를 기준으로 compact영역을 줄인다.
- compact단계에서는 compact영역을 destination과 source로 나누며 살아있는 객체는 destination으로 이동시키고 참조되지 않는 객체는 제거한다.
실행 명령어 - java -XX:+UseParallelOldGC -jar Application.java
📌CMS GC (Concurrent Mark Sweep)
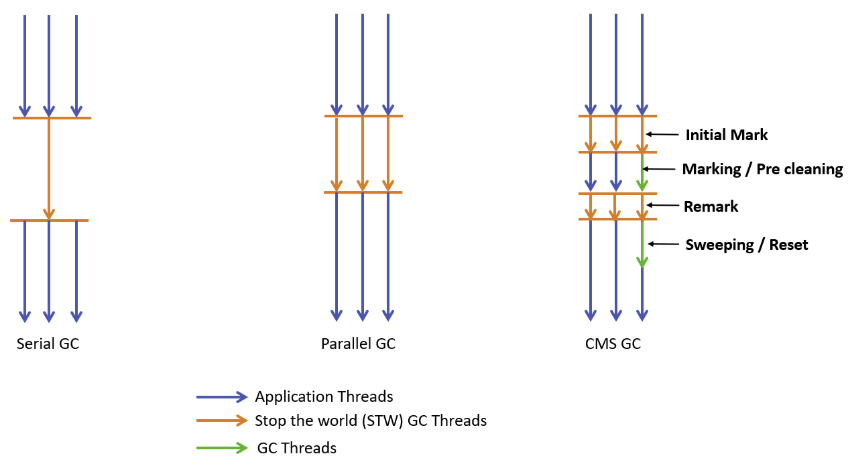
어플리케이션의 쓰레드와 GC 쓰레드가 동시에 실행되어 stop-the-world 시간을 최대한 줄이기 위해 고안된 GC입니다.(단, GC 과정이 매우 복잡해짐.)
GC 대상을 파악하는 과정이 복잡한 여러단계로 수행되기 때문에 다른 GC 대비 CPU 사용량이 높습니다.
메모리 파편화 문제가 있으며,CMS GC는 Java9 버젼부터 deprecated 되었고 결국 Java14에서는 사용이 중지
실행 명령어 - java -XX:+UseConcMarkSweepGC -jar Application.java
📌G1 GC
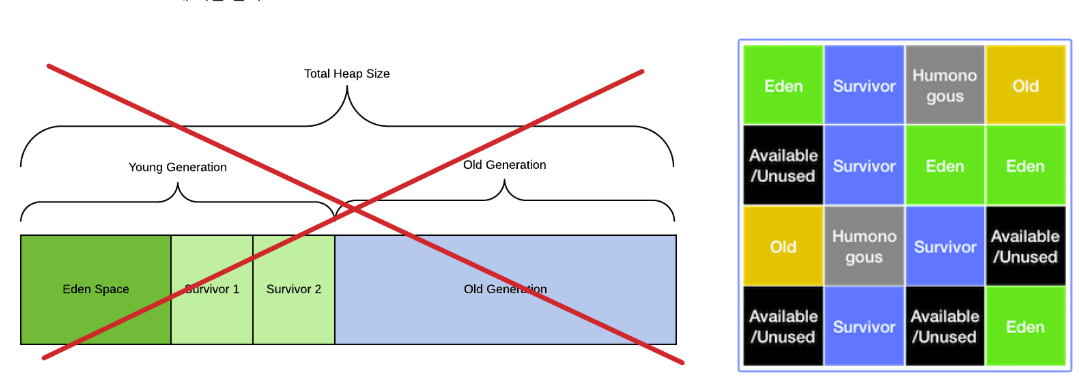
G1 GC는 지금까지의 GC방식과는 메모리 구조가 완전히 다릅니다.
일정크기의 논리적 단위인 region으로 구분하고 있습니다.
G1 GC는 객체가 Eden → Survivor → Old로 가는 기존 동작구조는 그대로 유지하지만, 각 영역이 고정된 공간이 아니라 매번 동적으로 할당된 Region일 뿐이다.
한마디로, 메모리구조와 Old영역에 동작구조가 바뀌는 것임.
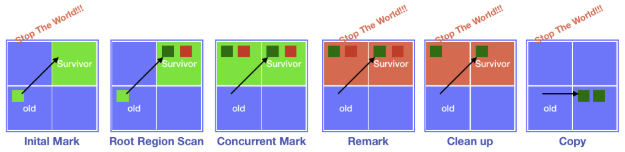
- Initial Mark : Old Region에 존재하는 객체들이 참조하는 Survivor Region을 찾습니다.
- Root Region Scan : 위에서 찾은 Survivor 영역의 객체들에 대한 스캔 작업을 실시합니다.
- Concurrent Mark : 전체 Heap의 scan 작업을 실시하고, GC 대상 객체가 발견되지 않은 Region은 이후 단계를 제외한다.
- Remark : 애플리케이션을 멈추고(stop the world 발생) 최종적으로 GC 대상에서 제외할 객체를 식별한다.
- Cleanup : 애플리케이션을 멈추고(stop the world 발생) 살아있는 객체가 가장 적은 Region에 대한 미사용 객체를 제거한다.
- Copy : GC 대상의 Region이었지만, Cleanup 과정에서 완전히 비워지지 않은 Region의 살아남은 객체들을 새로운 Region에 복사하여 Compaction을 수행한다. (stop the world 발생)
- 살아있는 객체가 아주 적은 Old 영역에 대해 [GC pause(mixed)] 를 로그로 표시하고, Young GC가 이루어질 때 수집되도록 한다.
📌Z GC
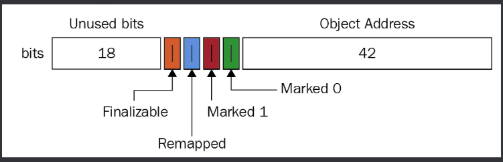
Z GC는 개발되고 있는 알고리즘으로, 메모리를 재배치 하는 과정을 bit Pointer라는 것을 활용하여 stop the world 과정없이 진행합니다.
[참고]
https://inkyu-yoon.github.io/docs/Language/Java/ExecutionEngine
