개인 프로젝트를 다 진행했는데, Real MySQL 책 내용을 보다보니 복잡한 쿼리에 대해서 직접 인덱스를 설정해서 확인해보고 싶어서 진행해보았습니다.
기본적으로 복잡한 쿼리를 하려면 어떤걸 하는게 좋을까 생각하다가, 월별로 통계를 내고 집계함수들을 사용하면 복잡한 쿼리가 되겠다 싶어서 한번 진행해봤습니다.
📌 인덱스 설정 전
일단 SELECT에 집계함수를 다 사용하게 했으며, group by,order by까지 사용했습니다.
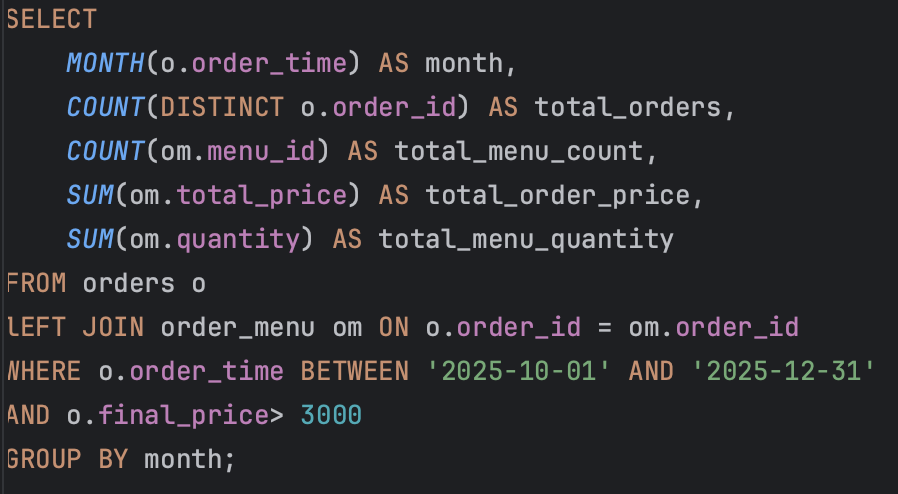
orders에는 1200만건, order_menu에는 1700만건의 데이터를 넣어놨다보니, 위 쿼리를 작성했을때 굉장히 느린 성능을 만날 수 있었습니다.

explain ANALYZE 을 통하여 확인해본 결과 약 17~18초 정도가 걸리는 것을 확인했습니다.
![]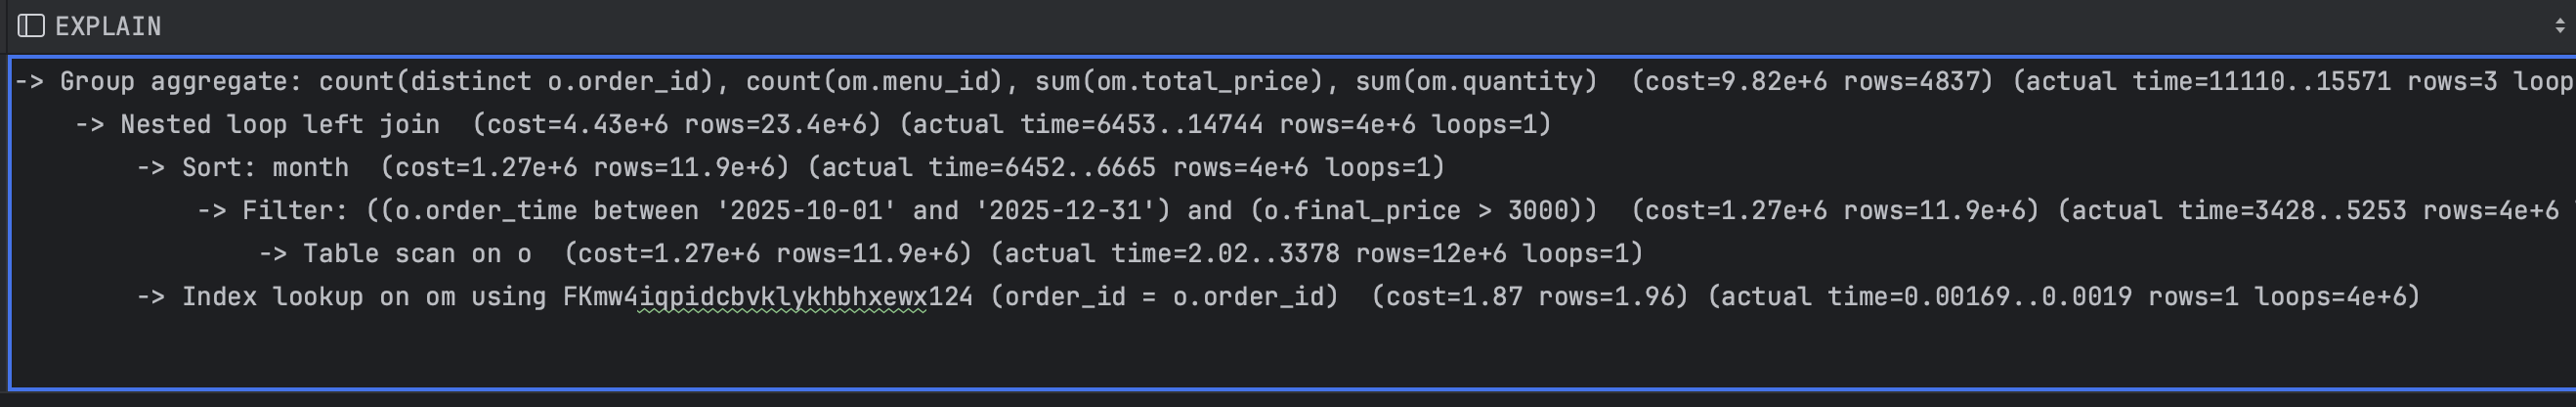
-> Group aggregate: count(distinct o.order_id), count(om.menu_id), sum(om.total_price), sum(om.quantity)  (cost=9.82e+6 rows=4837) (actual time=11110..15571 rows=3 loops=1)
    -> Nested loop left join  (cost=4.43e+6 rows=23.4e+6) (actual time=6453..14744 rows=4e+6 loops=1)
        -> Sort: month  (cost=1.27e+6 rows=11.9e+6) (actual time=6452..6665 rows=4e+6 loops=1)
            -> Filter: ((o.order_time between '2025-10-01' and '2025-12-31') and (o.final_price > 3000))  (cost=1.27e+6 rows=11.9e+6) (actual time=3428..5253 rows=4e+6 loops=1)
                -> Table scan on o  (cost=1.27e+6 rows=11.9e+6) (actual time=2.02..3378 rows=12e+6 loops=1)
        -> Index lookup on om using FKmw4iqpidcbvklykhbhxewx124 (order_id = o.order_id)  (cost=1.87 rows=1.96) (actual time=0.00169..0.0019 rows=1 loops=4e+6)
위 실행결과를 바탕으로 인덱스를 어떻게 걸지를 고민해보았습니다.
📌 인덱스 설계
1️⃣ 첫번째로 실행의 Type칼럼과 Key칼럼
Type 칼럼은 MySQL이 테이블에 접근하는 방식을 나타내며, 성능 지표 중 하나입니다.
- 사진을 보면 orders 테이블은 ALL로 표시되어 전체 테이블을 스캔하고 있습니다.
- 반면, order_menu 테이블은 order_id가 외래키(FK)로 설정되어 있어 ref로 인덱스를 사용함을 알 수 있습니다.
Key 칼럼은 MySQL이 실제로 사용한 인덱스 이름을 나타냅니다.
- orders 테이블은 인덱스를 사용하지 않아 전체 스캔이 발생합니다.
- order_menu 테이블은 외래키 인덱스(FKmw4iqpidcbvklykhbhxewx124)를 사용합니다.
즉, 이 쿼리에서는 orders 테이블이 병목 요인이 될 가능성이 높고, order_menu 테이블은 인덱스를 통해 효율적으로 접근하고 있음을 알 수 있습니다.
2️⃣ 두번째로 드라이빙 테이블 Orders의 Extra칼럼
Using where는 스토리지 엔진에서 가져온 데이터를 MySQL 엔진 층에서 다시 필터링했음을 의미합니다. 이것이 성능 저하의 원인인지 판단하려면 filtered 칼럼을 함께 살펴봐야 합니다.
현재 상태: 옵티마이저는 전체 약 1,192만 건의 데이터 중 단 3.7%만이 필터링 조건에 부합할 것으로 예측했습니다. 즉, 약 1,000만 건 이상의 불필요한 데이터가 메모리로 로드되어 버려지고 있다는 뜻입니다.
원인 분석: 현재 WHERE 절에서 order_time 칼럼을 기준으로 범위 조건을 사용하고 있으나, 해당 칼럼에 인덱스가 생성되어 있지 않아 인덱스 레인지 스캔을 활용하지 못하고 (Full Table Scan)이 발생하고 있습니다.
위 내용을 바탕으로 인덱스를 설정했습니다.
CREATE INDEX idx_orders_ot_fp ON orders(order_time, final_price);위 인덱스는 복합 인덱스(Composite Index)로 설계되었습니다.
선행 컬럼 : order_time
WHERE 절에서 자주 조회되는 컬럼을 인덱스의 첫 번째 컬럼으로 두어 검색 효율을 높였습니다.뒤에 컬럼: final_price
order_time으로 먼저 데이터의 범위를 크게 좁힌 뒤, 인덱스 내부에 물리적으로 함께 저장된 final_price를 곧바로 비교합니다.
-> 1,200만 건 중 날짜 조건에 맞는 400만 건을 가져온 뒤 다시 가격으로 거르는 것이 아니라, 인덱스를 스캔하는 과정에서 '날짜와 가격'을 동시에 체크하여 결과 세트를 완성합니다.
📍PK 자동 포함을 활용한 "부분적 커버링"
InnoDB의 참조 인덱스는 리프 노드에 인덱스 컬럼과 함께 PK값이 논리적 주소로 저장됩니다.
일반적으로 인덱스에 포함되지 않은 컬럼을 조회할 때는 인덱스 리프 노드에서 찾은 PK를 가지고 클러스터링 인덱스(테이블 본체)를 다시 찾아가는 과정이 필요합니다. 실제 데이터는 디스크의 여러 페이지에 흩어져 저장되어 있기 때문에, 이 과정에서 랜덤 I/O가 발생하며 성능 저하의 주된 원인이 됩니다.
하지만 이번에 설계한 (order_time, final_price) 복합 인덱스는 InnoDB의 특성상 내부적으로 (order_time, final_price, order_id) 형태로 저장됩니다.
이 덕분에 COUNT(DISTINCT o.order_id)와 같은 쿼리를 수행할 때, 굳이 실제 테이블 데이터에 접근할 필요가 없습니다. 필요한 모든 정보가 인덱스 리프 노드 안에 이미 모여 있기 때문에, 디스크의 테이블 영역을 건드리지 않고 인덱스 페이지만 읽어서 결과를 반환하는 커버링 인덱스와 동일한 메커니즘으로 동작하게 됩니다.
📌 orders 테이블에 인덱스 설정 후
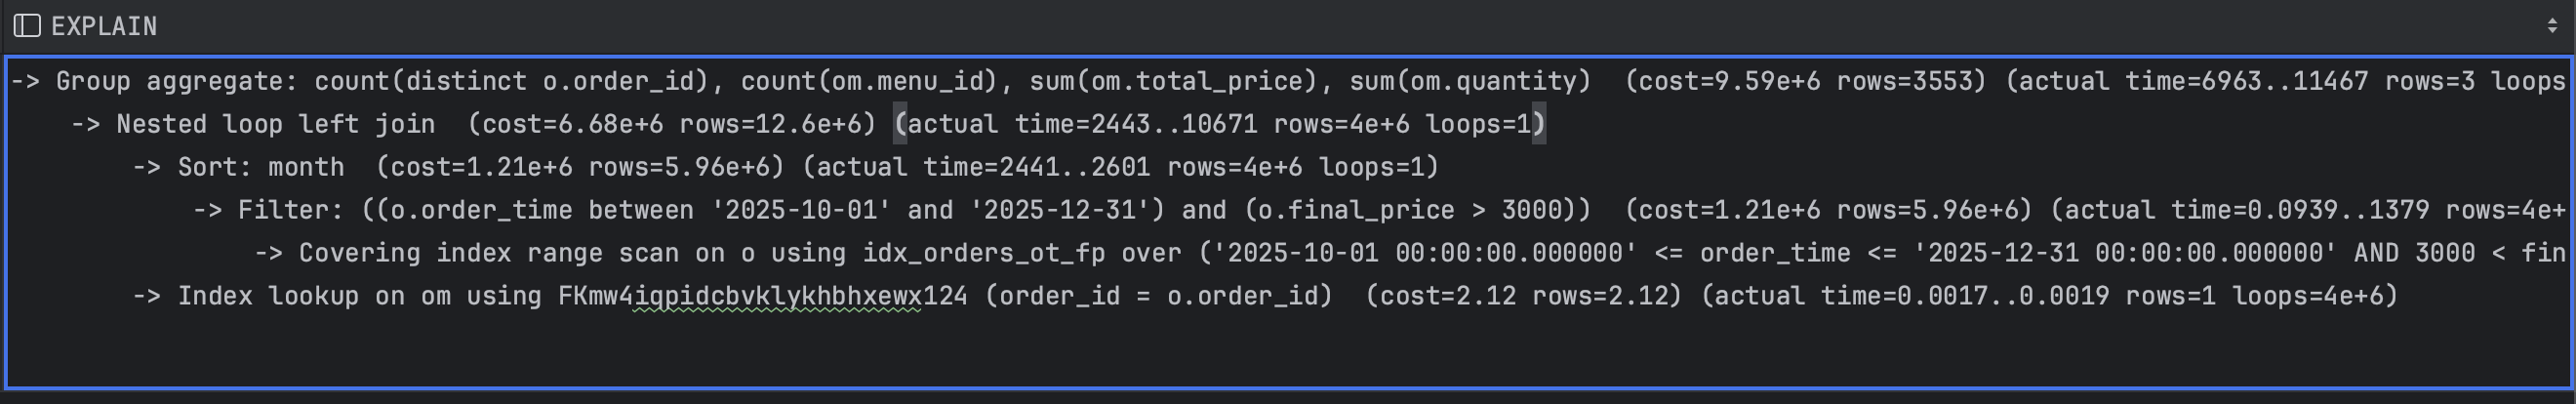
-> Group aggregate: count(distinct o.order_id), count(om.menu_id), sum(om.total_price), sum(om.quantity)  (cost=9.59e+6 rows=3553) (actual time=6963..11467 rows=3 loops=1)
    -> Nested loop left join  (cost=6.68e+6 rows=12.6e+6) (actual time=2443..10671 rows=4e+6 loops=1)
        -> Sort: month  (cost=1.21e+6 rows=5.96e+6) (actual time=2441..2601 rows=4e+6 loops=1)
            -> Filter: ((o.order_time between '2025-10-01' and '2025-12-31') and (o.final_price > 3000))  (cost=1.21e+6 rows=5.96e+6) (actual time=0.0939..1379 rows=4e+6 loops=1)
                -> Covering index range scan on o using idx_orders_ot_fp over ('2025-10-01 00:00:00.000000' <= order_time <= '2025-12-31 00:00:00.000000' AND 3000 < final_price)  (cost=1.21e+6 rows=5.96e+6) (actual time=0.076..644 rows=4e+6 loops=1)
        -> Index lookup on om using FKmw4iqpidcbvklykhbhxewx124 (order_id = o.order_id)  (cost=2.12 rows=2.12) (actual time=0.0017..0.0019 rows=1 loops=4e+6)
기존 쿼리 실행 시간: 약 18초
인덱스 적용 후 실행 시간: 약 12초
로 성능이 개선되는 것을 확인할 수 있었습니다.
💡 추가 성능 개선 가능성
order_menu 테이블에서도 인덱스를 타지만,
SELECT 절에 있는
    COUNT(om.menu_id) AS total_menu_count,
    SUM(om.total_price) AS total_order_price,
    SUM(om.quantity) AS total_menu_quantity
컬럼은 실제 데이터를 찾아야 하기 때문에, 클러스터링 인덱스를 통해 레코드 페이지를 읽는 작업이 필요합니다.
즉, 조인된 테이블에서도 커버링 인덱스를 적용하면 성능 향상 가능이 있습니다.
📌 order_menu 테이블에 인덱스 설정 후
CREATE INDEX idx_om_oid_mid_price_qty ON order_menu(order_id, menu_id, total_price,quantity);해당 인덱스 또한, order_id가 Join으로 사용하기 때문에 선행 인덱스로 설정하고 select에 존재하는 menu_id,total_price,quantity와 차례대로 조합하여 복합인덱스+커버링인덱스를 구성했습니다.

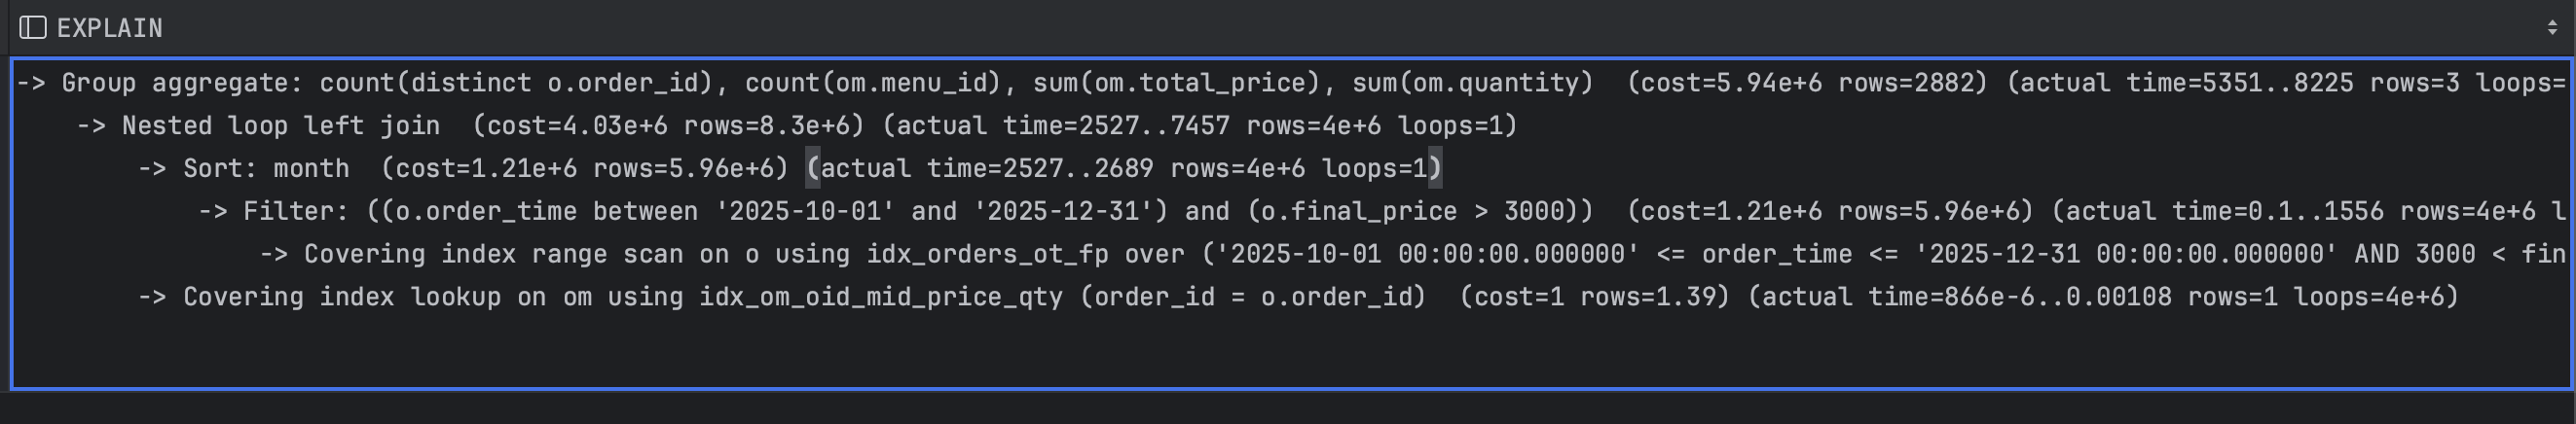
-> Group aggregate: count(distinct o.order_id), count(om.menu_id), sum(om.total_price), sum(om.quantity)  (cost=5.94e+6 rows=2882) (actual time=5351..8225 rows=3 loops=1)
    -> Nested loop left join  (cost=4.03e+6 rows=8.3e+6) (actual time=2527..7457 rows=4e+6 loops=1)
        -> Sort: month  (cost=1.21e+6 rows=5.96e+6) (actual time=2527..2689 rows=4e+6 loops=1)
            -> Filter: ((o.order_time between '2025-10-01' and '2025-12-31') and (o.final_price > 3000))  (cost=1.21e+6 rows=5.96e+6) (actual time=0.1..1556 rows=4e+6 loops=1)
                -> Covering index range scan on o using idx_orders_ot_fp over ('2025-10-01 00:00:00.000000' <= order_time <= '2025-12-31 00:00:00.000000' AND 3000 < final_price)  (cost=1.21e+6 rows=5.96e+6) (actual time=0.0828..794 rows=4e+6 loops=1)
        -> Covering index lookup on om using idx_om_oid_mid_price_qty (order_id = o.order_id)  (cost=1 rows=1.39) (actual time=866e-6..0.00108 rows=1 loops=4e+6)
따라서, 쿼리 실행 시간을 측정해보니 총 약 8~10초가 걸리는 것을 확인했습니다.
총 18초가 걸리던 쿼리가 8~10초로 줄어 약 2배이상 빨라진 것입니다.
하지만 실제 환경에서 8~10초는 여전히 상당히 느린 편이라고 판단했습니다.
그래서 데이터베이스 최적화 외에도 애플리케이션 단에서 성능을 개선할 방법을 고민했습니다.
현재 쿼리는 3개월치 데이터를 한 번에 조회하고 있습니다.
그렇다면, 데이터를 월별로 나누어 병렬로 쿼리를 수행한 후 결과를 합치는 방식으로 처리하면 전체 응답 시간을 더 단축할 수 있겠다는 아이디어를 생각하게 되었습니다.
📌 병렬 스트림 처리
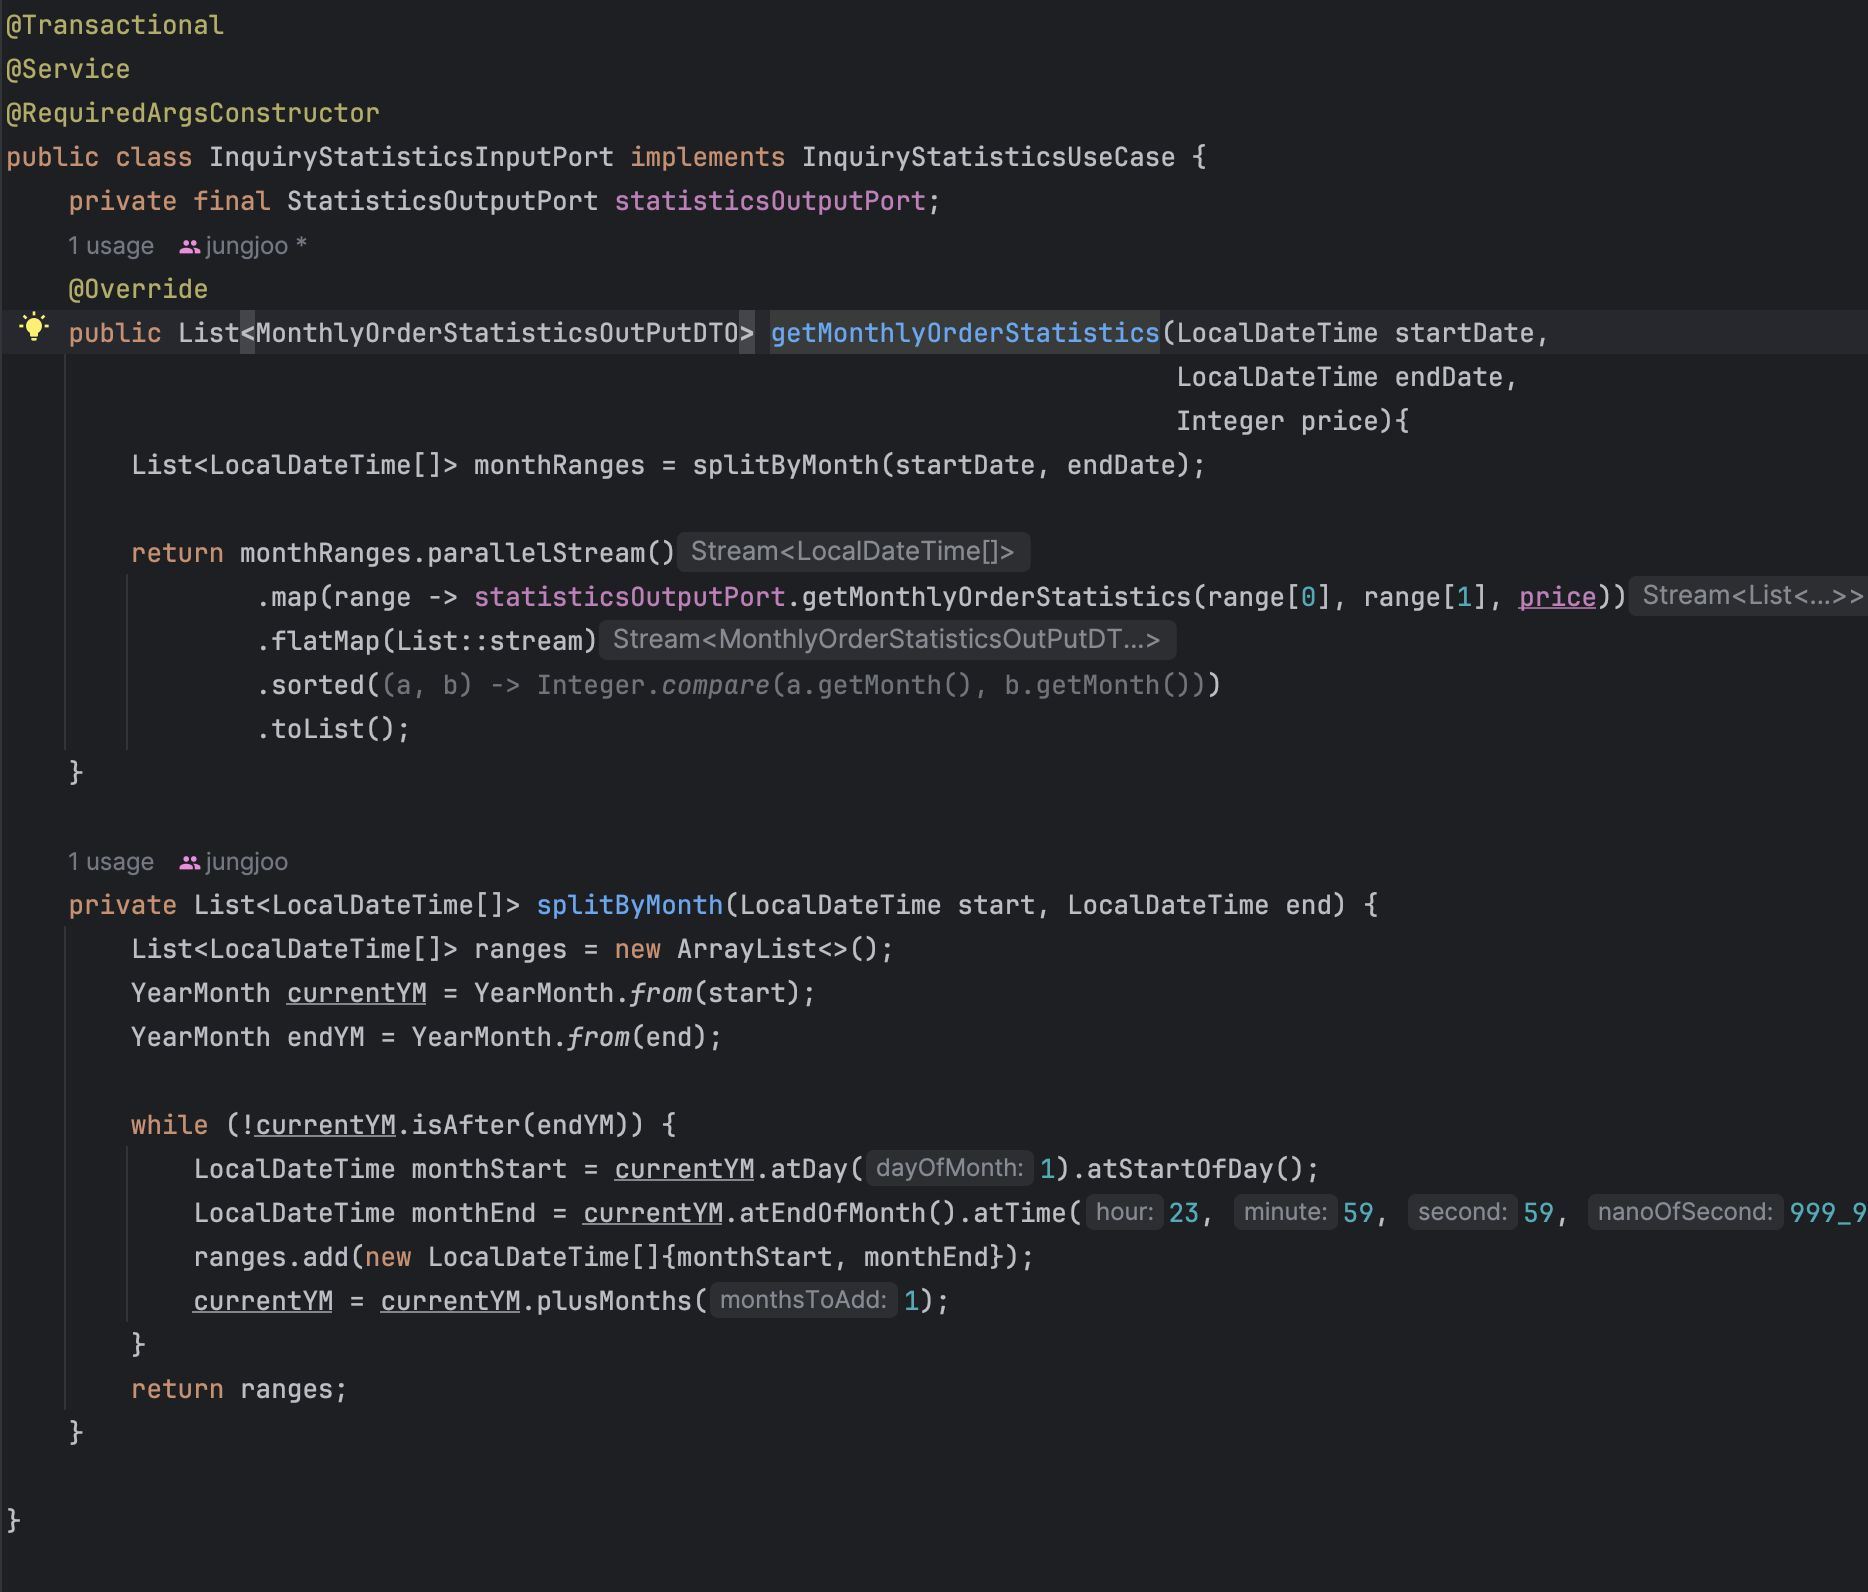
위 코드처럼 월 단위로 잘라서 병렬 스트림을 통해서 가지고 오게 했습니다.
그 결과,
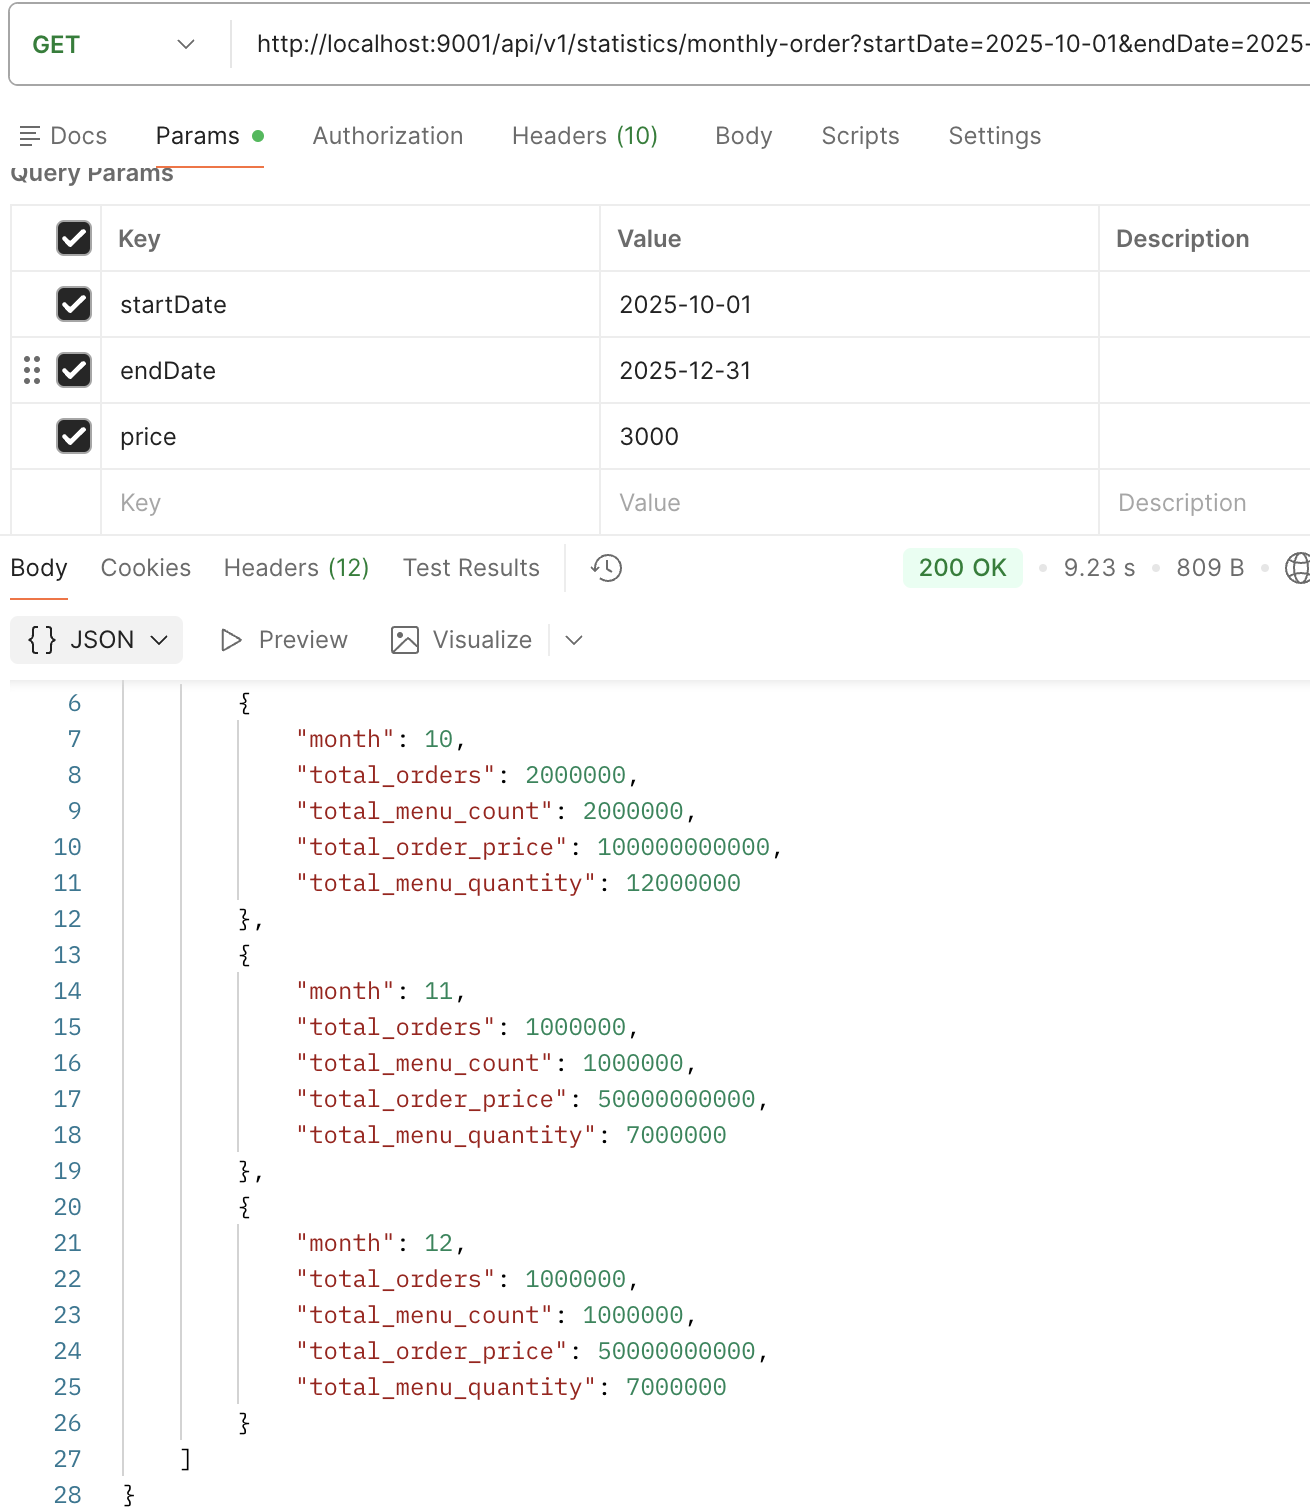
기존 8~10초가량 걸렸던 조회가
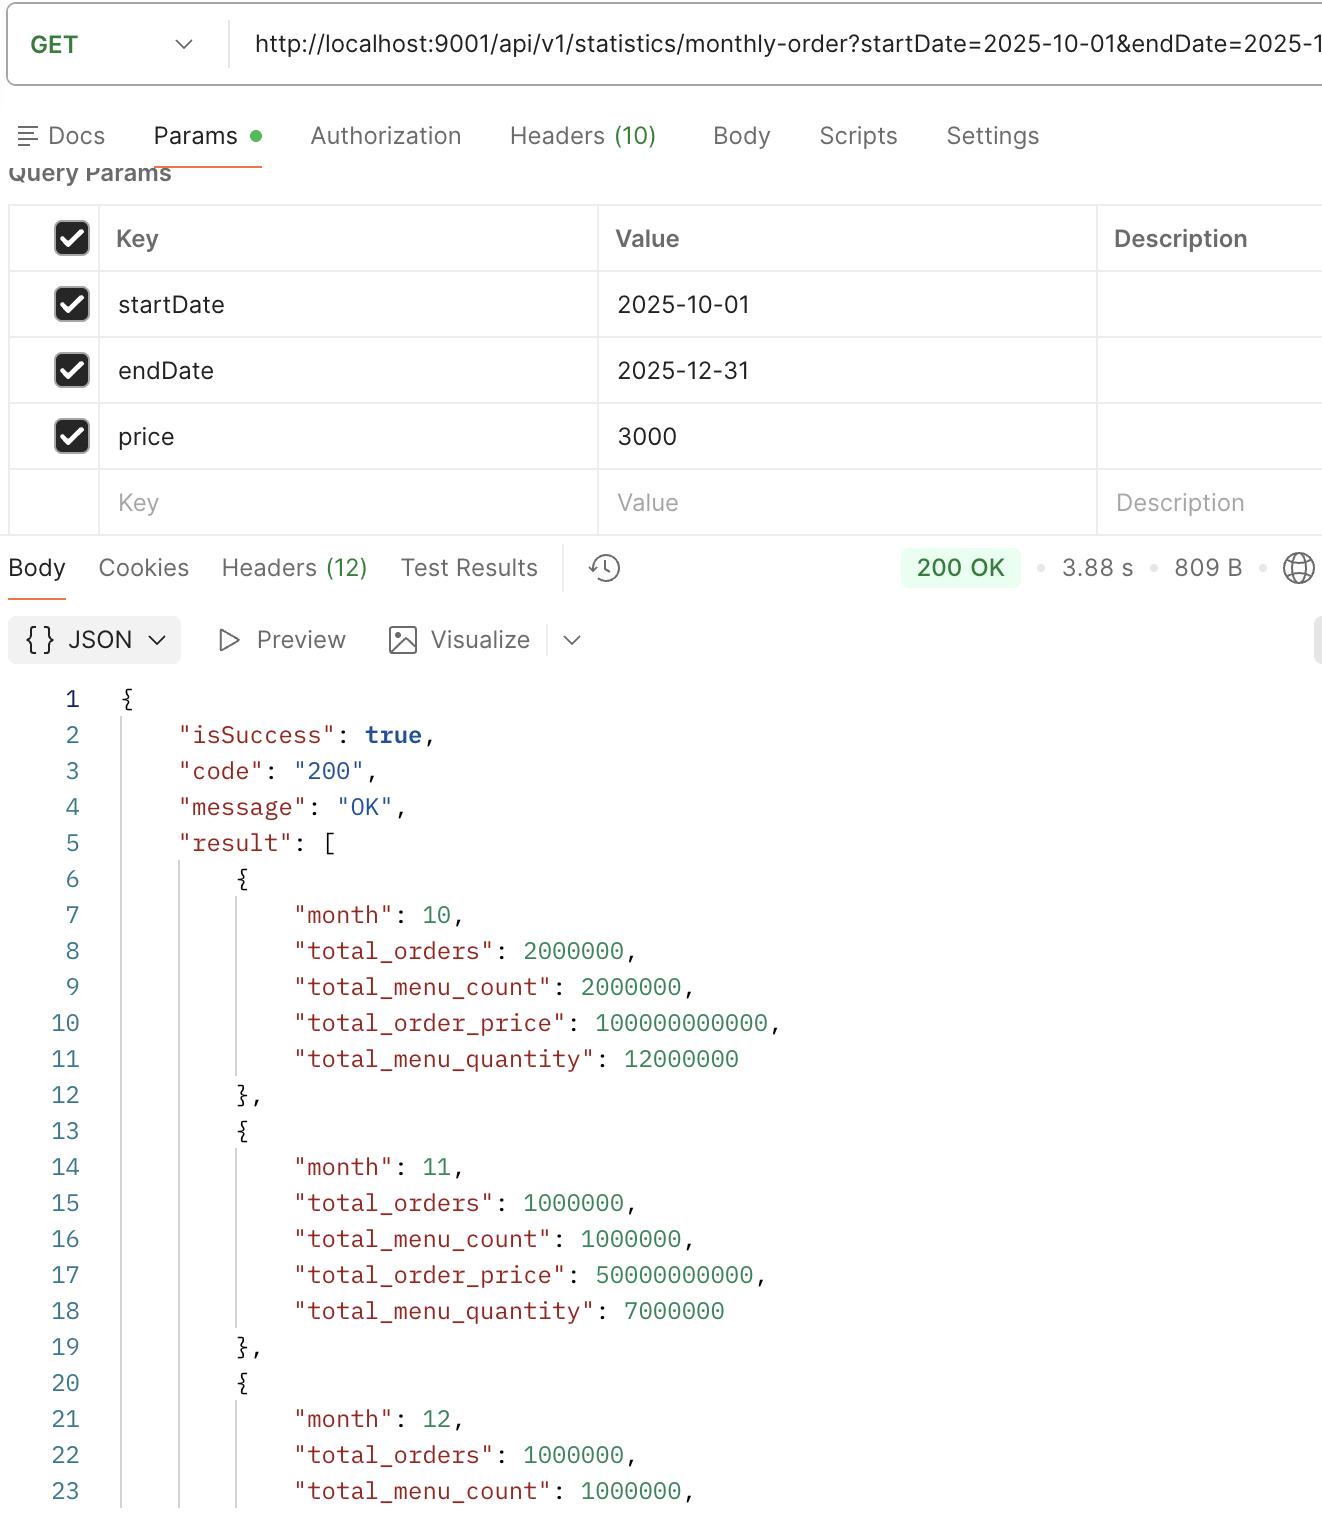
약 3.8초까지 조회 성능이 올랐음을 확인했습니다.
하지만 병렬 스트림을 사용할 경우 커넥션 풀이 고갈 될 수 있기때문에 잘 조절해서 사용해야합니다.
🤔 3.8초, 과연 최선일까? (추가 개선 아이디어)
인덱스 튜닝과 병렬 처리를 통해 4.7배의 성능 향상을 이루었지만, 여전히 사용자 경험 측면에서는 개선의 여지가 있습니다. 실무라면 다음과 같은 추가 전략을 고려해 볼 수 있을 것 같습니다.
-
통계 테이블 도입 (Summary Table): 실시간 집계가 아닌, 스케줄러를 통해 일별/월별로 미리 집계된 통계 테이블을 조회한다면 0.01초 내외로 응답이 가능합니다.
-
Materialized View(구체화 뷰): 복잡한 조인 결과를 미리 저장해두어 대규모 스캔 자체를 피할 수 있습니다.
-
Redis 캐싱: 한 번 조회된 월별 통계 데이터는 데이터 변경이 잦지 않으므로 캐시에 저장해 재사용할 수 있습니다.
이번 프로젝트는 '실제 대규모 데이터를 인덱스만으로 어디까지 밀어붙일 수 있는가'를 확인한 값진 경험이었습니다.
