데이터베이스 성능을 최적화하는 데 있어 인덱스는 매우 중요한 역할을 합니다. 올바르게 인덱스를 사용하면 데이터 접근 속도가 현저히 빨라지고, 특히 대규모 데이터셋에서 그 효과를 크게 체감할 수 있습니다. 이전 포스팅에서 캐싱을 적용해서 API 성능을 개선하였는데, Index만 적절히 사용하여도 쿼리속도가 충분히 개선될 수 있습니다.
이번 포스팅에서는 인덱스를 활용하여 성능을 개선하는 방법에 대해 다뤄보겠습니다.
📌 Index 란?
- 도서 관에 카테고리, 번호별로 정렬되어있는 책들
인덱스는 데이터베이스 테이블의 데이터를 빠르게 검색하기 위해 사용하는 데이터 구조입니다. 책의 색인처럼, 테이블에서 필요한 데이터를 효율적으로 찾을 수 있도록 정렬된 상태로 유지하여 데이터 검색 속도를 크게 향상시킵니다. 일반적으로 인덱스는 테이블의 특정 컬럼에 대해 생성되며, 그 구조에 따라 다양한 종류가 존재합니다.
📌 Index 의 종류
인덱스는 그 특성에 따라 여러 가지 종류로 나뉘며, 각기 다른 상황에 사용됩니다. 주요 인덱스 유형은 다음과 같습니다.
| 분류 | Index 종류 | 설명 |
|---|---|---|
| 유일성 | Unique Index | 중복을 허용하지 않는 인덱스로, 각 값이 테이블 내에서 유일해야 함. 주로 기본 키(primary key)나 고유 제약 조건에 사용됨 |
| Non-Unique Index | 중복된 값을 허용하며, 테이블 내에서 여러 행이 동일한 인덱스 값을 가질 수 있음. 일반적인 검색을 최적화하기 위해 사용됨 | |
| ----- | ----- | ------ |
| 구성컬럼수 | Single Index | 하나의 컬럼에 대해 생성된 인덱스로, 특정 컬럼의 검색 속도를 높이기 위해 사용됨 |
| Composite Index | 두 개 이상의 컬럼을 결합하여 생성된 인덱스. 복합 검색 조건에서 성능을 높이기 위해 사용되며, 컬럼의 순서에 따라 효율성이 달라질 수 있음 | |
| ----- | ----- | ------ |
| 클러스터 | Clustered Index | 데이터 레코드의 물리적 순서가 인덱스의 정렬 순서와 동일한 인덱스. InnoDB에서 기본 키가 클러스터드 인덱스로 구현되며, 테이블 당 하나만 생성 가능함 |
| Non-Clustered Index | 인덱스의 엔트리가 데이터 레코드와 별도로 저장되며, 물리적인 순서와는 관계없이 논리적 정렬을 제공. 테이블 당 여러 개의 인덱스 생성 가능 | |
| ----- | ----- | ------ |
| 기타 | Covering Index | Covering Index는 쿼리에서 사용되는 모든 컬럼이 인덱스에 포함되어 있어 데이터 페이지에 접근하지 않고도 필요한 데이터를 인덱스만으로 처리할 수 있는 인덱스입니다. |
📌 Index 생성시 고려사항
1. 쿼리 패턴 분석
자주 사용하는 쿼리에서 WHERE 절이나 JOIN 절에 사용되는 컬럼을 인덱싱하는 것이 좋습니다. 예를 들어, 주문일자와 같은 컬럼이 자주 사용된다면 해당 컬럼에 인덱스를 설정해 범위 검색 성능을 높일 수 있습니다.
2. 카디널리티(Cardinality)
인덱스의 효율성은 해당 컬럼의 카디널리티에 따라 달라집니다. 카디널리티는 데이터 값의 고유 개수를 의미하며, 고유 값이 많을수록 인덱스의 효율성이 높습니다.
이는 고유 값이 많을 수록 인덱스 자체에서 필터링 범위를 빠르게 좁혀주기 때문에, 불필요하게 많은 데이터 페이지를 읽지 않아도 되기 때문입니다.
3. 복합 인덱스의 순서
일반적으로 카디널리티가 높은 컬럼(고유한 값이 많은 컬럼)을 인덱스의 첫 번째 위치에 배치하는 것이 좋습니다. 이렇게 하면 인덱스 검색 범위를 더 좁힐 수 있어 효율성이 향상됩니다.
하지만 상황에 따라서는 WHERE 절에서 자주 필터링하는 컬럼을 선두에 두어야 인덱스가 효과적으로 활용될 수도 있긴합니다.
4. 데이터 변경 빈도
인덱스는 데이터를 삽입, 수정, 삭제할 때마다 업데이트되므로, 변경이 잦은 컬럼에 인덱스를 설정하면 오히려 성능 저하를 초래할 수 있습니다. 변경이 적고 조회가 많은 컬럼에 인덱스를 설정하는 것이 바람직합니다.
5. 인덱스 크기와 저장 공간
인덱스는 별도의 저장 공간을 차지하므로, 너무 많은 인덱스를 생성하면 저장 공간이 낭비되고, 데이터베이스 성능에도 영향을 줄 수 있습니다. 특히 큰 테이블에 많은 인덱스를 생성하면 데이터베이스의 메모리 사용량과 디스크 I/O가 증가할 수 있습니다.
📌 Index를 이용한 조회 유의사항
1. 인덱스 컬럼의 값과 타입을 그대로 사용할 것
인덱스는 컬럼의 원래 값에 대해 작동하므로, 값에 변형이 가해지면 인덱스 효율이 떨어질 수 있습니다.
-- price 컬럼에 인덱스가 적용된 경우

-- 올바른 인덱스 사용
WHERE price > 10000 / 100;  -- price 컬럼에 대한 Index Search

-- 잘못된 인덱스 사용
WHERE price * 100 > 10000;  -- price * 100 에 대한 Index 적용 X
2. 범위 조건 사용 주의 (LIKE, BETWEEN, <, > 등)
범위 조건은 인덱스를 사용할 수 있지만, 해당 컬럼 이후의 다른 컬럼 인덱스는 무시될 가능성이 높습니다.
코드 복사
-- 복합 인덱스 예시: (product_id, ordered_at, count, is_abroad)
WHERE product_id = 1 AND is_abroad = 1 AND ordered_at > '2024-01-01'
-- product_id와 ordered_at는 인덱스 사용 가능
-- is_abroad는 인덱스 사용되지 않음
3. AND와 OR의 차이점
AND는 행을 줄여 효율을 높이지만, OR은 각 조건의 행을 비교해야 하므로 Full Scan을 유발할 확률이 높습니다.
4. =와 IN은 다음 컬럼도 인덱스 사용 가능
IN은 사실 여러 개의 = 조건을 결합한 것이므로, 다음 컬럼도 인덱스를 사용할 수 있습니다.
5. 커버링 인덱스 (Covering Index)
조회하려는 모든 컬럼이 인덱스에 포함되면 실제 데이터 행에 접근할 필요가 없어져, 높은 성능의 조회가 가능합니다.
📌 Index는 어떻게 자료를 배치할까?
Index 데이터를 배치하는 방식에는 다양한 방법이 있지만 대표적으로 2가지를 알아 보겠습니다.
1. B-Tree 인덱스
B-Tree(Balanced Tree) 인덱스는 MySQL에서 가장 널리 사용되는 인덱스 자료 구조입니다.
특징
- 균형 트리 구조로 구성되어 있어, 데이터의 삽입, 삭제, 검색이 효율적입니다.
- 데이터가 정렬된 상태로 저장되기 때문에 특정 키의 범위 검색이 빠르게 수행됩니다.
- 순차적으로 데이터에 접근할 수 있어, 정렬된 결과를 반환할 때 효율적입니다.
- MySQL의 InnoDB 스토리지 엔진에서는 기본적으로 B-Tree 인덱스를 사용하여 기본 키와 보조 인덱스를 저장합니다.
사용 사례
- 범위 검색이 빈번한 경우: 예를 들어, 날짜 범위로 조회하거나 특정 값 이상의 데이터를 검색하는 경우에 적합합니다.
- 정렬된 데이터 접근이 필요한 경우: 특정 컬럼의 값으로 정렬된 데이터를 조회할 때 유리합니다.
2. Hash 인덱스
Hash 인덱스는 해시 테이블을 사용하여 특정 값의 검색을 빠르게 수행하는 인덱스 자료 구조입니다.
특징
- 정확한 값 검색이 필요할 때 빠른 접근을 제공합니다. 예를 들어, 특정 값을 등가 조건(=)으로 검색할 때 최적화된 성능을 보여줍니다.
- 범위 검색이나 정렬된 검색은 불가능하거나 비효율적입니다. 해시 값으로 데이터를 분산하기 때문에 데이터의 순서를 보장하지 않습니다.
- MySQL의 Memory 스토리지 엔진에서 주로 Hash 인덱스가 사용됩니다.
사용 사례
- 정확한 키-값 검색이 자주 일어나는 경우에 적합합니다. 예를 들어, 특정 사용자 ID를 기준으로 데이터를 찾는 경우에 유리합니다.
📌 B-Tree 구조에 대해 좀 더 알아보자
무분별하게 배치되어있는 데이터
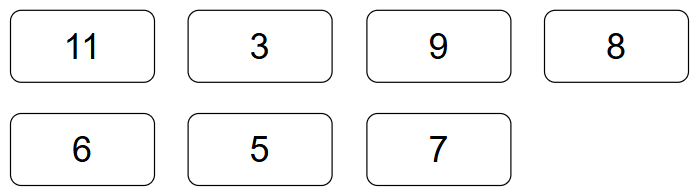
위와 같이 무분별하게 배치되어있는 데이터에서 6이 어디에 있는지 찾으려면 어떻게 해야할까요?
모든 데이터를 뒤져야지 찾을 수 있게 됩니다.
데이터가 N개 있을 때 N번의 연산이 필요하므로 O(n)의 시간 복잡도를 가지게 됩니다.
일렬로 순서대로 배치되어있는 데이터

하지만 위와같이 일렬로 데이터가 배치되어있다면 중간 값을 기준으로 해당 데이터보다 작다면 왼쪽에서 데이터를 찾고, 해당 데이터보다 크다면 오른쪽에서 데이터를 찾게됩니다. 이를 통해서 데이터를 찾는 범위를 절반씩 소거해 갈 수 있게 됩니다.
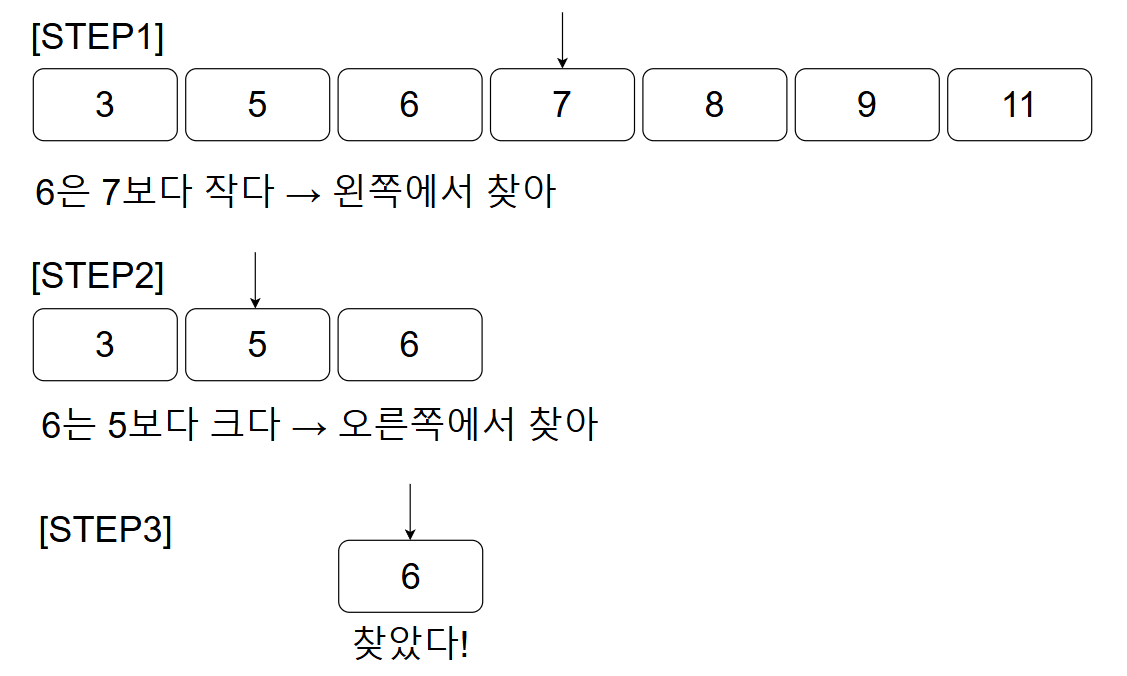
찾고자 하는 데이터의 범위가 한 번의 연산을 거칠 때마다 절반씩 줄어들기 때문에, 이진 탐색은 log₂ N의 시간 복잡도를 갖습니다. 빅오 표기법에서는 밑이 상수일 경우 이를 생략하는 관례가 있으므로, 이진 탐색의 최종 시간 복잡도는 O(log N)로 표기됩니다.
일렬로 정렬된 데이터를 트리구조로 표현
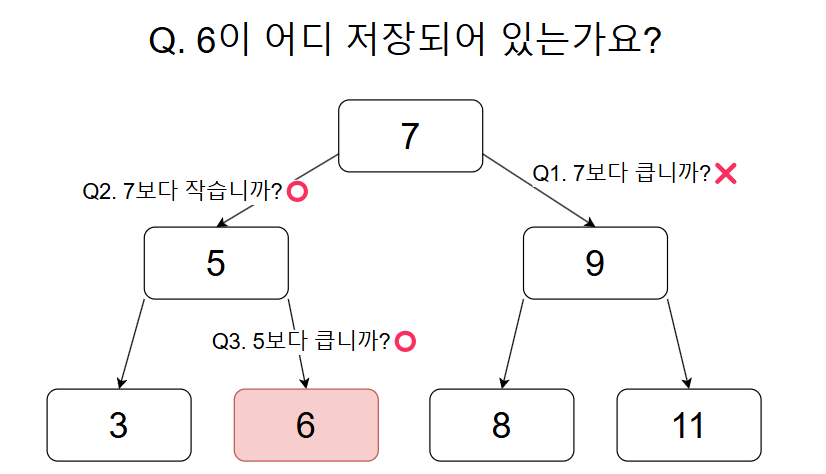
일렬로 정렬되어 있던 데이터를 찾는 과정을 트리구조로 표현하면 위와같이 표현할 수 있습니다.
이를 이진 탐색 트리(Binary Search Tree) 라고 표현합니다.
이진 탐색트리는 현재 각각의 노드에 하나의 데이터만 있습니다. 각각의 노드에 2개, 3개의 데이터를 넣을 수 있다면 찾는 범위를 절반씩 줄이는게 아니라 2/3, 3/4 씩 줄일 수 있지 않을까요? 이와 같은 구조를 B-tree 라고 부릅니다.
B-tree 구조
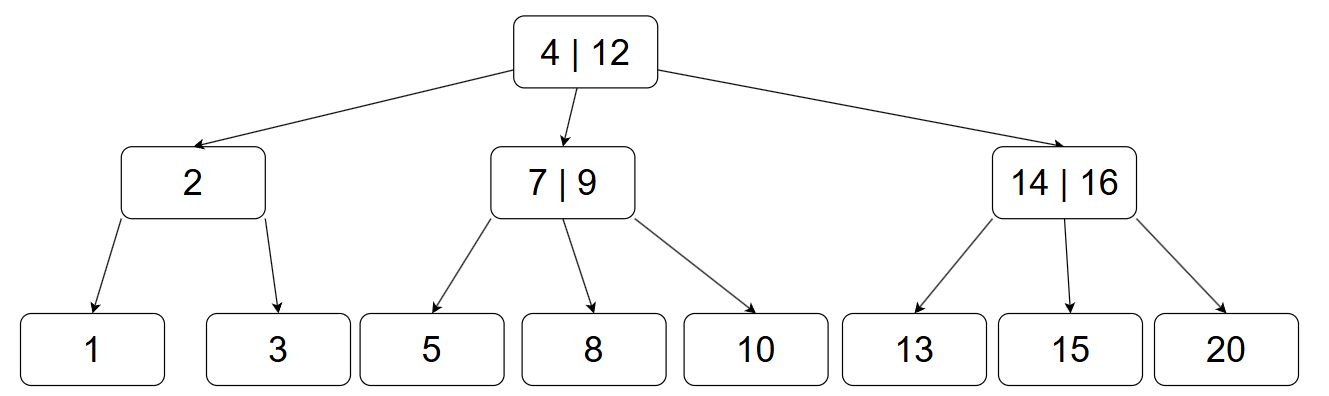
이와 같이, B-트리는 하나의 노드에 여러 개의 키 값을 저장함으로써, 이진 트리보다 적은 이동으로 더 넓은 범위의 데이터를 탐색할 수 있습니다. 이를 통해 시간 복잡도는 비슷하지만 디스크 접근 횟수가 줄어들어 대용량 데이터 환경에서 효율적으로 탐색을 할 수 있습니다.
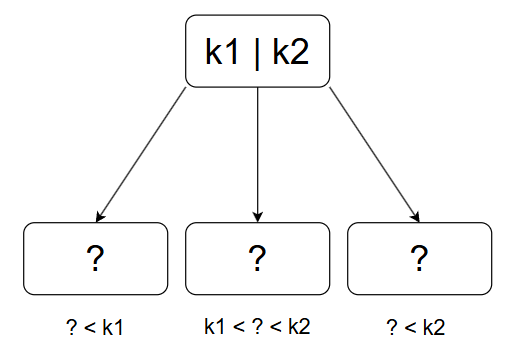
여기서 key의 개수를 M개라고 표현하고, B-tree를 M차 트리라고 표현합니다. B-tree에는 주요 파라미터가 있는데 이는 B-tree의 구조와 속성을 정의 하는 주요 기준이 됩니다.
-
M: 각 노드의 최대 자녀 노드 수
- B-트리에서 M은 트리의 차수를 나타내며, 각 노드는 최대 M개의 자식 노드를 가질 수 있습니다. 즉, M차 B-트리의 각 노드는 최대 M개의 자식을 연결할 수 있습니다.
-
M - 1: 각 노드의 최대 키 수
- 각 노드는 최대 M개의 자식을 가질 수 있으므로, 이때 노드가 저장할 수 있는 최대 키의 수는 M - 1개가 됩니다. 이는 자식 수가 M개일 때 각 자식 사이를 구분하기 위한 키가 M - 1개 필요하기 때문입니다.
-
⌈M / 2⌉: 각 노드의 최소 자녀 노드 수
- 각 노드는 최소 ⌈M / 2⌉개의 자식을 가져야 합니다. 이 조건은 B-트리의 균형을 유지하도록 도와주며, 모든 노드가 일정한 자식 개수를 가지도록 보장합니다. 단, root node와 leaf node는 제한을 받지 않고, 자식이 없거나 최소 2개의 자식을 가질 수 있습니다.
-
⌈M / 2⌉ - 1: 각 노드의 최소 키 수
- 각 노드가 가져야 하는 최소 키 수는 ⌈M / 2⌉ - 1개입니다. 이는 각 노드가 자식 수의 최소 개수를 가질 때 필요한 최소 키 수를 의미합니다. 이 최소 키 개수 조건은 루트 노드에는 적용되지 않습니다.
| 파라미터 | 설명 | 예외 조건 |
|---|---|---|
| M | 각 노드의 최대 자녀 노드 수 (트리의 차수) | 없음 |
| M - 1 | 각 노드의 최대 키 수 | 없음 |
| ⌈M / 2⌉ | 각 노드의 최소 자녀 노드 수 | root 노드, leaf 노드 제외 |
| ⌈M / 2⌉ - 1 | 각 노드의 최소 키 수 | root 노드 제외 |
B+tree
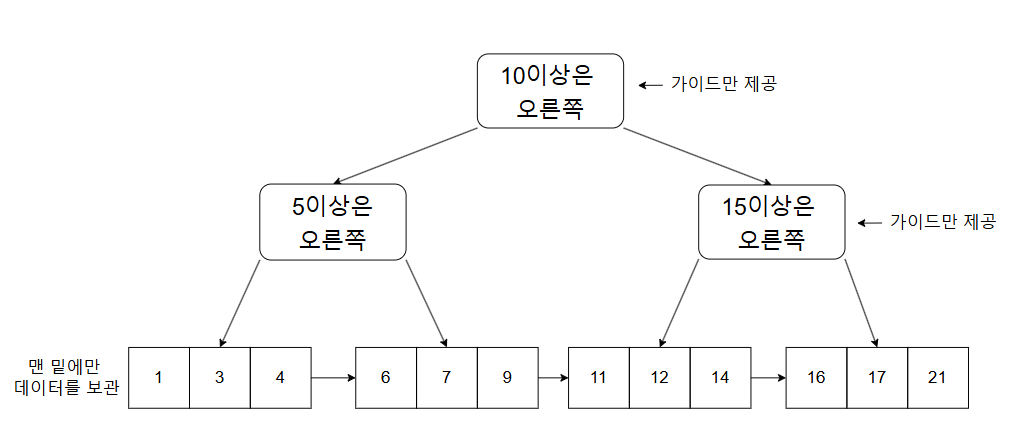
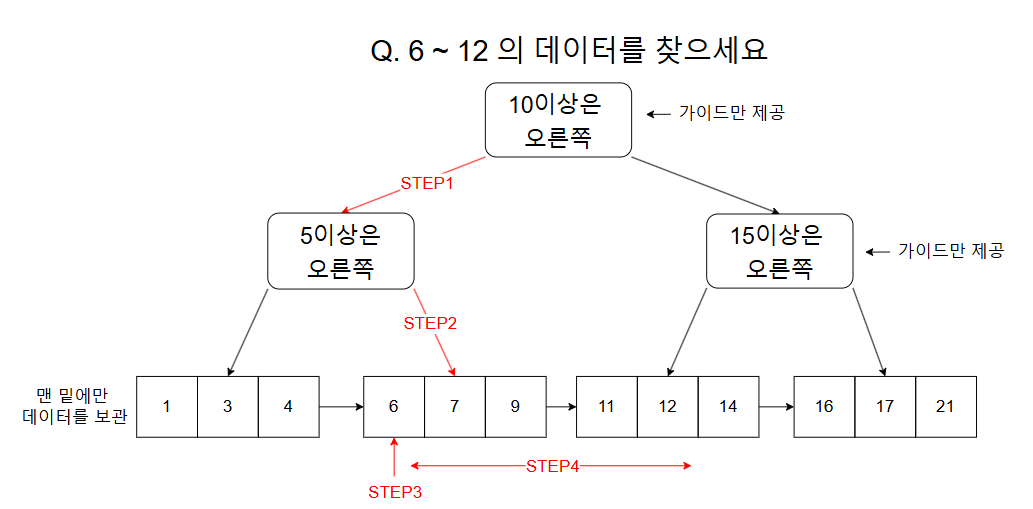
B+트리(B+ Tree)는 B-트리의 변형으로 B+트리는 B-트리와 구조가 비슷하지만, 몇 가지 중요한 차이점이 있어 검색과 범위 조회에 더 적합한 특성을 가집니다.
-
데이터 저장 위치
- B+트리에서는 모든 실제 데이터(레코드)가 리프 노드에만 저장됩니다. 내부 노드는 데이터가 아닌 탐색을 위한 키만을 가지고 있습니다.
- B-트리와 달리, 내부 노드는 검색용으로만 사용되고 데이터는 리프 노드에만 존재합니다.
-
리프 노드의 연결
- B+트리의 리프 노드들은 링크드 리스트 형태로 서로 연결되어 있어, 리프 노드를 순서대로 쉽게 접근할 수 있습니다.
- 이 연결 덕분에 B+트리는 특정 범위의 데이터를 빠르게 검색할 수 있어 범위 조회(range query)에 유리합니다.
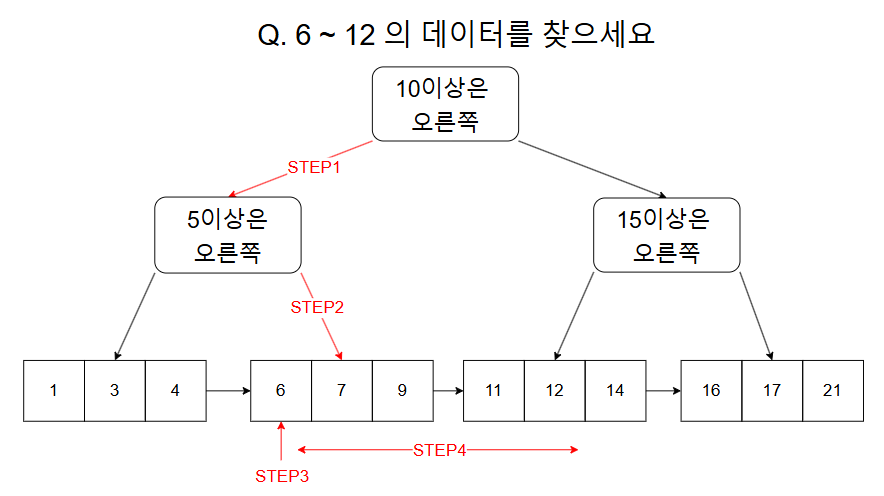
- 루트에서부터 시작하여 내부 노드를 탐색하면서 리프 노드까지 내려갑니다. 리프 노드에서 실제 데이터를 찾을 수 있으며, 데이터가 있는 리프 노드들은 정렬된 상태로 연결되어 있습니다.
- 범위 검색이 필요한 경우, 원하는 키 값을 가진 리프 노드에 도달한 뒤 링크드 리스트를 따라가며 순차적으로 데이터를 읽어 올 수 있습니다.
B+Tree 와 B-tree의 차이점
| 특징 | B-트리 | B+트리 |
|---|---|---|
| 데이터 저장 위치 | 내부 노드와 리프 노드에 저장 | 리프 노드에만 저장 |
| 리프 노드 연결 | 연결되지 않음 | 링크드 리스트로 리프 노드가 연결되어 있음 |
| 범위 검색 | 범위 검색에 다소 비효율적 | 리프 노드 간 링크드 리스트로 빠르게 범위 검색 가능 |
| 검색 시 접근 깊이 | 데이터가 내부 노드에 있으면 더 짧은 경로 | 모든 데이터가 리프 노드에 있어 항상 리프 노드까지 탐색 |
✨ 마무리
이번 글에서는 인덱스의 기본 개념과 구조에 대해 알아보았는데, 막연하게만 알고 있던 개념들을 구체적으로 정리할 수 있는 좋은 기회가 되었습니다. 특히 B-트리와 B+트리 같은 자료 구조를 이해하면서 데이터베이스가 어떻게 성능을 최적화하는지 더 깊이 알게 된 것 같습니다.
다음에는 이론에서 한 걸음 나아가 실제로 인덱스를 적용하고 최적화하는 과정을 다뤄보고자 합니다. 이 과정에서 인덱스가 어떻게 성능에 영향을 미치는지 직접 경험하며 더 많은 인사이트를 얻을 수 있기를 기대해 봅니다.
참고자료