추천 시스템
모든 고객에 대해서, 모든 아이템에 대한 예상 선호도를 예측하는 시스템.
추천 시스템의 필요성
- 추천 시스템: 유저, 아이템의 주변 정보 및 상호작용 기록 바탕으로 유저가 선호할 가능성이 높은 아이템을 예측해 제공하는 AI 서비스
- 목적: 유저의 의사결정을 돕고, 개인화된 경험을 제공하는 것이 목적
- 작동원리
- Pull 방식(검색, Search): 사용자가 분명한 의도를 가지고 쿼리(Query)를 사용하여 상품이나 정보를 직접 찾는 행위 → 사용자가 주도적으로 정보를 시스템으로부터 당겨오는(Pull) 방식
- Push 방식(추천, Recommandation): 사용자가 직접 의도를 가진 키워드를 제공하지 않아도, 시스템이 취향에 맞는 아이템을 먼저 제공하는 것 → 시스템이 사용자에게 적합한 정보를 밀어주는(Push) 방식
추천시스템의 활용 분야
E-commerce: 개인 추천을 통해 개인 맞춤형 쇼핑 경험 제공 (ex. Amazon, Coupang)Contents: 유저 취향에 맞는 영상, 음악, 가사 추천 (ex. Netfilx, Youtube, Spotify)POI(Point Of Interest): 유저 기반 서비스에서 유저 선호도를 반영한 장소 추천 (ex. Google Maps)
추천시스템의 주요 난제
- 확장 가능성 (Scalability): 대규모 데이터 처리 및 실시간 추천 시스템 설계 필요
- 도메인 종속성 (Domain Dependency): 특정 산업/서비스 특화 모델 필요
- 비즈니스 목표 다양성 (Business Objective Diversity): 모델의 최적화 방향과 비즈니스 목표의 충돌 가능성
- 콜드 스타트 (Cold Start): 신규 유저, 아이템에 대한 데이터 부족 문제 해결 필요
- 유저 선호도 복잡성 (Complexity of User Preference): User 취향 정밀 반영 모델 설계 필요
- 호흡이 긴 영화 콘텐츠 같은 경우 유저 입장에서 기회비용이 크기 때문에, 추천이 만족스럽지 않을 시 기업에 손해(구독 취소 등)가 있을 수 있다.
- 추천이 적합한 도메인과 그렇지 않은 도메인이 존재한다. → 고관여 제품의 경우 추천의 효용성이 떨어진다. (ex. 자동차, 집 등)
추천 시스템 종류
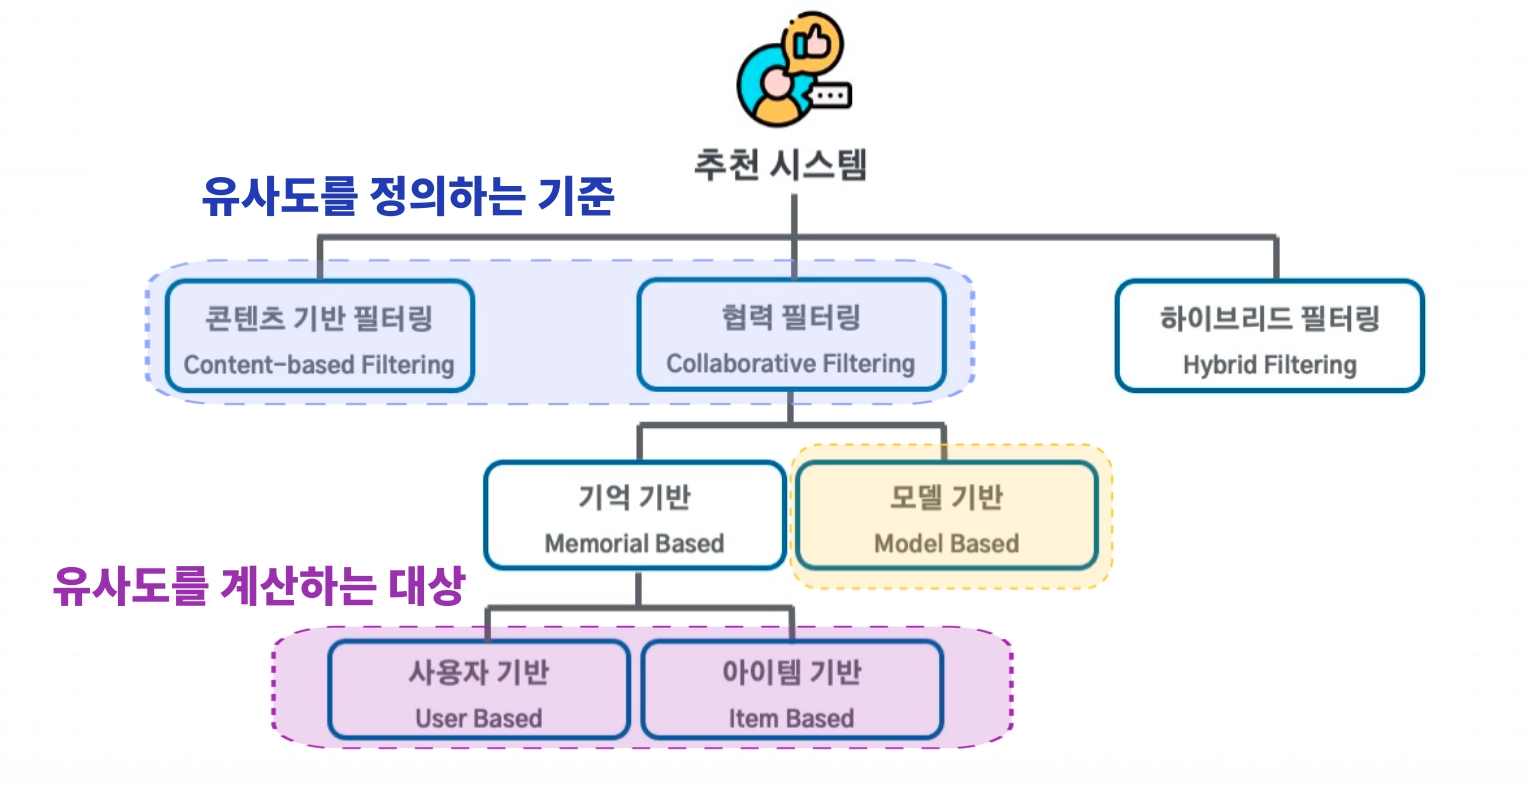
Contents-based Filtering (콘텐츠 기반 필터링)
- 아이디어: User가 좋아한 Item의 속성과 비슷한 Item 추천 → 과거에 선호했던 아이템의 속성과 비슷한 다른 아이템을 추천하는 방식
- 활용 데이터: Item 자체의 메타데이터(장르, 키워드, 설명 등)
- 동작 원리: 사용자가 평소 즐겨보는 비디오의 특성 분석 → 사용자 프로필 생성 → 각 콘텐츠의 특성을 분석한 비디오 프로필과 비교하여 유사도가 높은 아이템을 추천
- 장점
- 해석의 용이성: Item의 명확한 속성(메타데이터)을 기반으로 추천이 이루어지므로 사용자에게 해당 Item을 왜 추천했는지 직관적으로 설명 가능
- 새로운 아이템 추천 가능: 기존 User의 누적된 상호작용 데이터(평점, 클릭 등)가 없더라도 아이템 고유의 속성만 파악되면, 새로운 Item도 원활하게 추천 가능
- 단점
- 과도한 유사성 & 우연한 발견(Serendipity) 부족: User가 이미 경험한 Item의 속성 안에서만 추천이 멤돌 수 있다.
- 예시: User가 이전에 시청했던 영화와 비슷한 장르, 동일한 배우가 출연하거나 비슷한 키워드를 가진 다른 영화를 추천하는 것
Collaborative Filtering (협업 필터링)
- 아이디어: 비슷한 취향을 가진 다른 User의 행동 데이터를 기반으로 아이템을 추천하는 방식
- 가정:
- 사용자로부터 아이템에 대한 명시적/묵시적 평가 데이터로 구할 수 있다.
- 사용자들의 평가 데이터에서 취향이 비슷한 사람을 찾아낼 수 있고, 취향이 비슷한 사람은 선호 패턴이 비슷하다.
- 활용 데이터: User와 Item간의 상호작용 데이터(평점, 클릭, 구매 내역 등)를 핵심 정보로 활용
- 동작 원리: User의 기존 행동을 바탕으로 다른 사용자와의 취향 유사도를 분석하여 추천
- 협업 필터링은 유사도를 계산하는 방식에 따라 크게 두 가지로 나뉜다.
- Memory-based(기억 기반): User나 Item간의 유사도를 수식으로 직접 계산하는 방식
- Model-based(모델 기반): 머신러닝이나 딥러닝을 이용해 User와 Item의 숨겨진 특징(Latent Vector)을 임베딩하고 패턴을 학습하는 방식
- 장점
- 우연한 발견(Serendipity): Item의 내용이나 속성에만 얽매이지 않기 때문에, 사용자의 기존 선호도 범위를 벗어난 Item을 추천해줄 수 있다.
- 단점
- Cold Start 문제: 다른 User과 비교할만한 과거 상호작용 데이터가 필수적이므로, 신규 User나 신규 Item에 대해서는 추천을 제공하기가 어렵다.
- Data Sparsity(희소 행렬 문제): 시스템 내 전체 Item의 수에 비해 한 명의 User가 소비하는 Item은 극히 일부이므로, 전체 User와 Item간의 상호작용을 거대한 행렬로 만들었을 때 대부분의 칸이 값이 없는 상태로 남게 되는 현상 → 유사도 계산이나 모델 학습에 어려움이 발생할 수 있음
- Cold Start 문제: 다른 User과 비교할만한 과거 상호작용 데이터가 필수적이므로, 신규 User나 신규 Item에 대해서는 추천을 제공하기가 어렵다.
- 예시: 특정 영화를 감상한 User1과 평소 시청 기록이나 취향이 비슷하게 겹치는 User2를 찾아 User1이 좋게 평가한 다른 영화를 User2에게도 추천해주는 것
Memory-based Filtering
수식을 통해 직접 유사도를 계산하는 기억 기반 추천 시스템은 유사도를 계산하는 대상이 사람인지, 상품인지에 따라 다음과 같이 나뉜다.
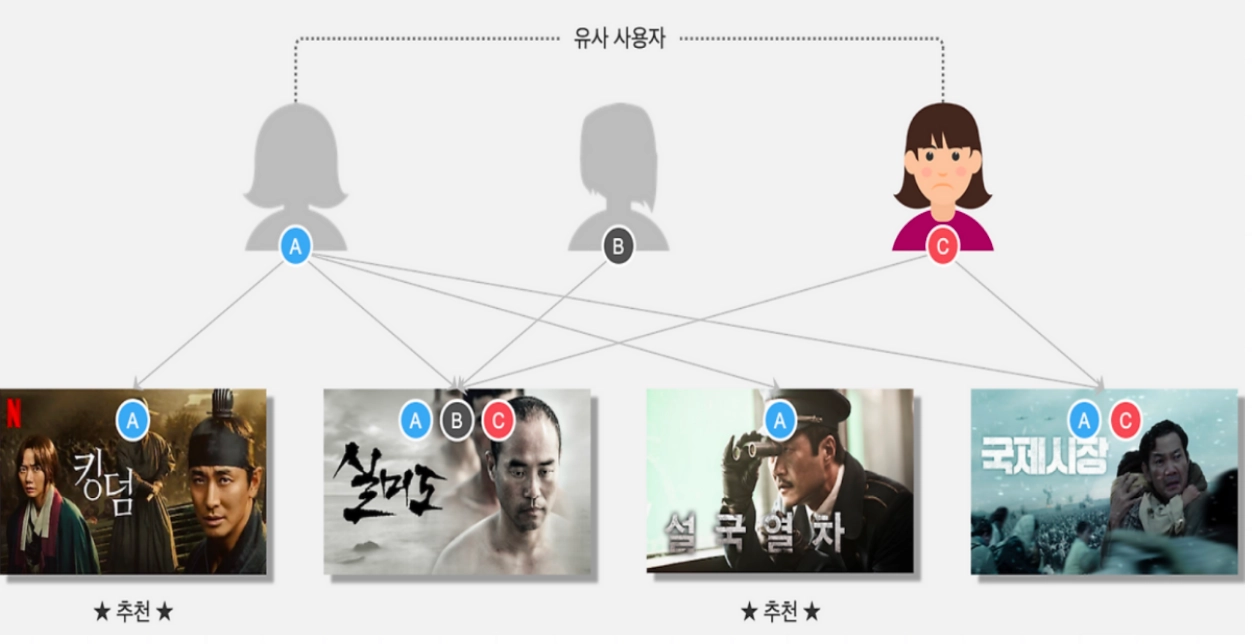
[User 기반 협업 필터링]
- 아이디어: 나와 행동 패턴(취향)이 비슷한 사람들이 좋아하는 Item이라면, 나도 좋아할 것이다
- 작동 원리: 추천 받을 타겟 사용자와 전체 시스템 내 사용자들의 과거 데이터를 비교 → 취향이 가장 비슷한 ‘유사 사용자 그룹’ 찾아냄 → 유사 그룹의 사람들은 좋아하지만 타겟 사용자는 아직 경험하지 않은 아이템을 골라 추천
- 예시:
[Item 기반 협업 필터링]
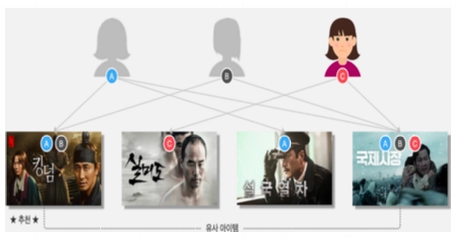
- 아이디어: 함께 자주 소비되는 Item들은 서로 성격이 비슷할 것이다.
- 작동 원리: 아이템 간의 유사도를 직접 계산하는 방식. 전체 소비자들의 소비 패턴 분석 → ‘아이템 A’를 소비한 사람이 ‘아이템 B’도 묶어서 소비하는 성향이 짙음 → 두 아이템은 유사하다 판단 → 타겟 사용자가 과거에 소비했던 아이템들의 목록 확인 → 그 아이템들과 가장 유사도가 높은 새로운 아이템 점수화하여 추천
- 예시:
아 몰라몰라 안해안해