[사이트] 문제 이름 #문제 번호
문제 링크 : https://www.acmicpc.net/problem/6566
1. Constraints (제한 사항)
- 알고리즘 문제와 요구와 제한사항
문제
평생 영어 단어를 암기한 준민이는 단어를 애너그램 그룹으로 나누려고 한다.
단어 w가 단어 v의 애너그램이 되려면, 단어 w의 알파벳 순서를 바꿔서 v를 만들 수 있어야 한다. 이렇게 애너그램인 단어들을 묶어서 애너그램 그룹이라고 한다. 그룹의 크기는 그 그룹에 포함된 단어의 수이다.
단어가 주어졌을 때, 크기가 가장 큰 애너그램 그룹 다섯 개를 구하는 프로그램을 작성하시오.
입력
입력은 최대 30,000 줄로 이루어져 있고, 각 줄에는 알파벳 소문자로 이루어진 단어가 하나씩 주어진다. 입력은 EOF로 끝난다.
출력
크기가 가장 큰 애너그램 다섯 개를 출력한다. 만약, 그룹의 수가 다섯개보다 작다면, 모두 출력한다. 그룹은 크기가 감소하는 순으로, 크기가 같을 때는 각 그룹에서 가장 사전 순으로 앞서는 단어의 사전 순으로 출력한다.
각 그룹을 출력할 때, 크기와 포함된 단어를 출력하며, 단어는 사전 순으로 출력해야 한다. 같은 단어는 한 번만 출력한다.
제한
시간 제한 = 1초
메모리 제한 = 128 MB
나의 생각
- 문자는 모두 소문자 리스트
2. Ideas (문제 풀이 방식)
- 문제를 해결할 수 있는 방법 (최대 3개) + 시간/공간 복잡도
(1) Hashmap 이용
: 문자열의 알파벳 갯수를 a~z까지 계산해서 hashmap의 key로 저장하고 문자열은 value로 저장한다.
일단 haspmap의 각 value들을 정렬한 뒤
그 다음 value의 길이와 value들의 사전 순으로 정렬하여 출력한다.
시간 복잡도 : O(N x L)
공간 복잡도 : O(N x L)
(L = 문자열의 최대 길이)
3. Code (작성한 코드)
- 아이디어에서 다룬 내용을 바탕으로 구현한 코드
def anagram_group(hashmap: dict) -> dict:
    for key, value in hashmap.items():
        hashmap[key] = sorted(value)

    # 다중 조건 검색
    return list(sorted(hashmap.items(), key=lambda x: (-len(x[1]), x[1])))
# 백준을 위한 입출력
hashmap = {}
while True:
try:
string = str(input())
alpha_cnt = [0] * 26
for char in string:
alpha_cnt[ord(char) - ord('a')] += 1
string_key = tuple(alpha_cnt)
if string_key not in hashmap.keys():
hashmap[string_key] = [string]
else:
hashmap[string_key] += [string]
except:
break
solution = anagram_group(hashmap)
for i in range(5):
size = len(solution[i][1])
print(f"Group of size {size}:", end=' ')
for string in solution[i][1]:
print(string ,end=' ')
print(".")
풀다가 다중 정렬 key 사용 방법이 궁금해서 찾아보았다.
4. Test cases (테스트케이스)
- 테스트 케이스에 대해서 고민해보고, 직접 테스트해보기
undisplayed
trace
tea
singleton
eta
eat
displayed
crate
cater
carte
caret
beta
beat
bate
ate
abet
: 출력은 맞았다. 바로 제출해야겠다.
또 틀렸다. 이제는 틀리는 게 익숙하다.
5. 다시 생각하기 (1)
코드에는 문제가 없어 보여서
문제를 다시 차근차근 읽어보았다.
놓친 게 혹시 있는가?
생각하지 못한 경우의 수
1. 그룹의 수가 5개보다 작은 경우
2. 같은 단어가 들어오는 경우
def anagram_group(hashmap: dict) -> None:
    for key, value in hashmap.items():
        hashmap[key] = sorted(value)

    # 다중 조건 검색
    solution = list(sorted(hashmap.items(), key=lambda x: (-len(x[1]), x[1])))

    for i in range(min(5, len(solution))): # 1번 고치기
        size = len(solution[i][1])
        print(f"Group of size {size}:", end=' ')
        for string in solution[i][1]:
            print(string ,end=' ')
        print(".")

hashmap = {}

while True:
    try:
        string = str(input())
        alpha_cnt = [0] * 26

        for char in string:
            alpha_cnt[ord(char) - ord('a')] += 1

        string_key = tuple(alpha_cnt)

        if string_key not in hashmap.keys():
            hashmap[string_key] = [string]
        else: # 2번 고치기
            if string not in hashmap.get(string_key):
                hashmap[string_key] += [string]
    except:
        break

anagram_group(hashmap)
또 틀렸다고..? 무언가 놓치고 있는 것이 확실하다.
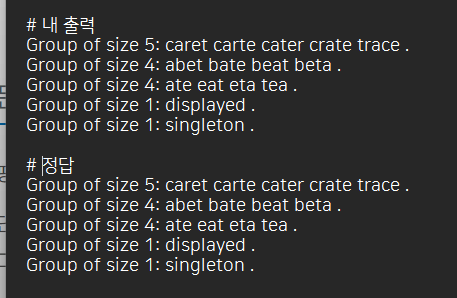
도대체 뭐가 틀렸다는 거지 눈뜨고 봐도 차이점을 모르겠다.
5. 다시 생각하기 (2)
진짜 뭔지 모르겠어서 질문을 들어가봤다.
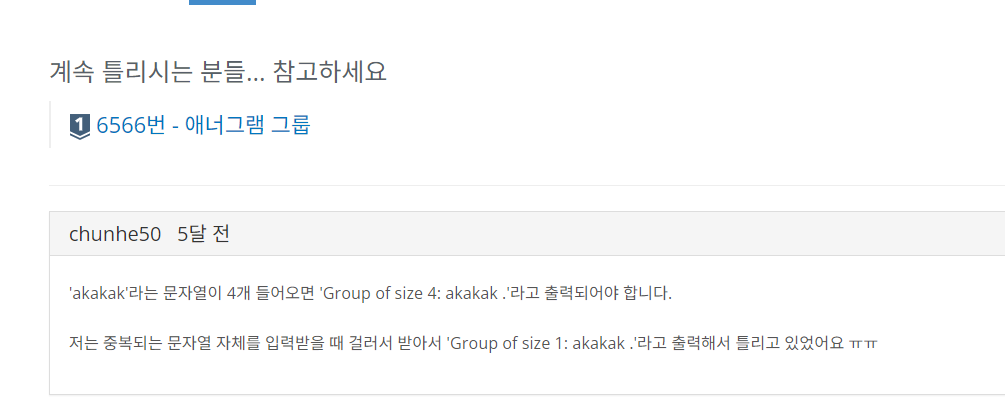
아이 이런 거는 테스트케이스에 넣어주면 좋지 않을까?
나도 입력에서 거르고 있어서 고쳐줬다.
def anagram_group(hashmap: dict) -> None:
    for key, value in hashmap.items():
        hashmap[key] = sorted(value)

    # 다중 조건 검색
    solution = list(sorted(hashmap.items(), key=lambda x: (-len(x[1]), x[1])))

    for i in range(min(5, len(solution))): # 1번 고치기
        size = len(solution[i][1])
        print(f"Group of size {size}:", end=' ')
        prev = ''
        for string in solution[i][1]:
            if string == prev: pass # 마지막 문제 고치기
            else: print(string, end=' ')

            prev = string
        print(".")

hashmap = {}

while True:
    try:
        string = str(input())
        alpha_cnt = [0] * 26

        for char in string:
            alpha_cnt[ord(char) - ord('a')] += 1

        string_key = tuple(alpha_cnt)

        if string_key not in hashmap.keys():
            hashmap[string_key] = [string]
        else:
            hashmap[string_key] += [string]
    except:
        break

anagram_group(hashmap)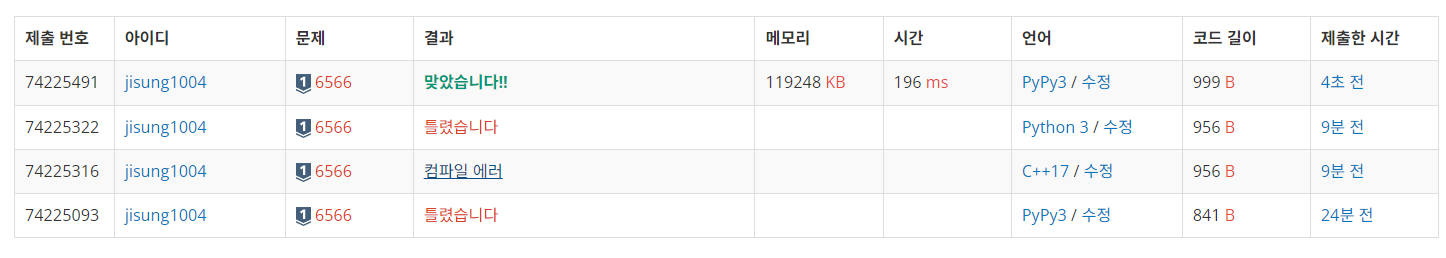
Python Tutor
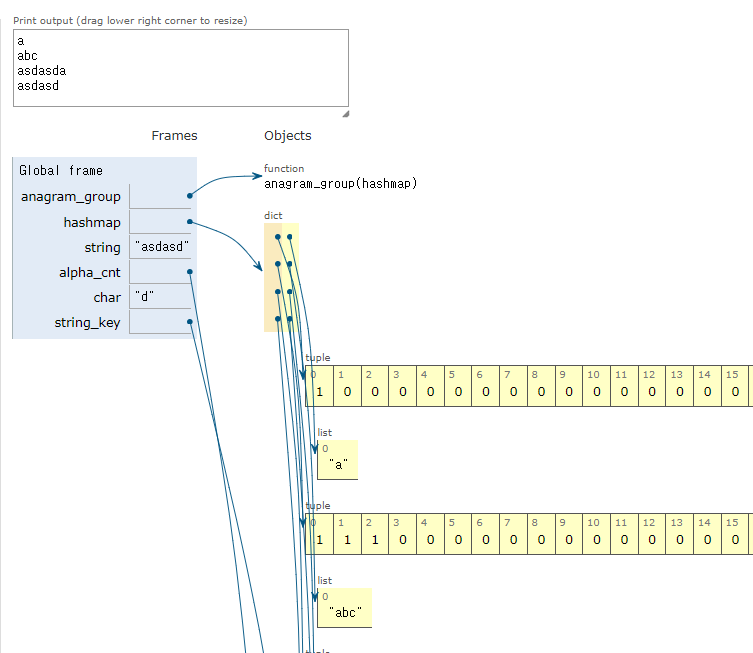
hashmap 개념을 알고 있다면 머리로 생각하는 것은 그렇게 어렵지 않은 문제였다.
마무리
문제를 잘 읽자. 사실 맨마지막 문제도 문제를 꼼꼼히 읽었으면 생각할 수 있지 않았을까?