처음엔 useEffect였지만, 지금은 React Query입니다
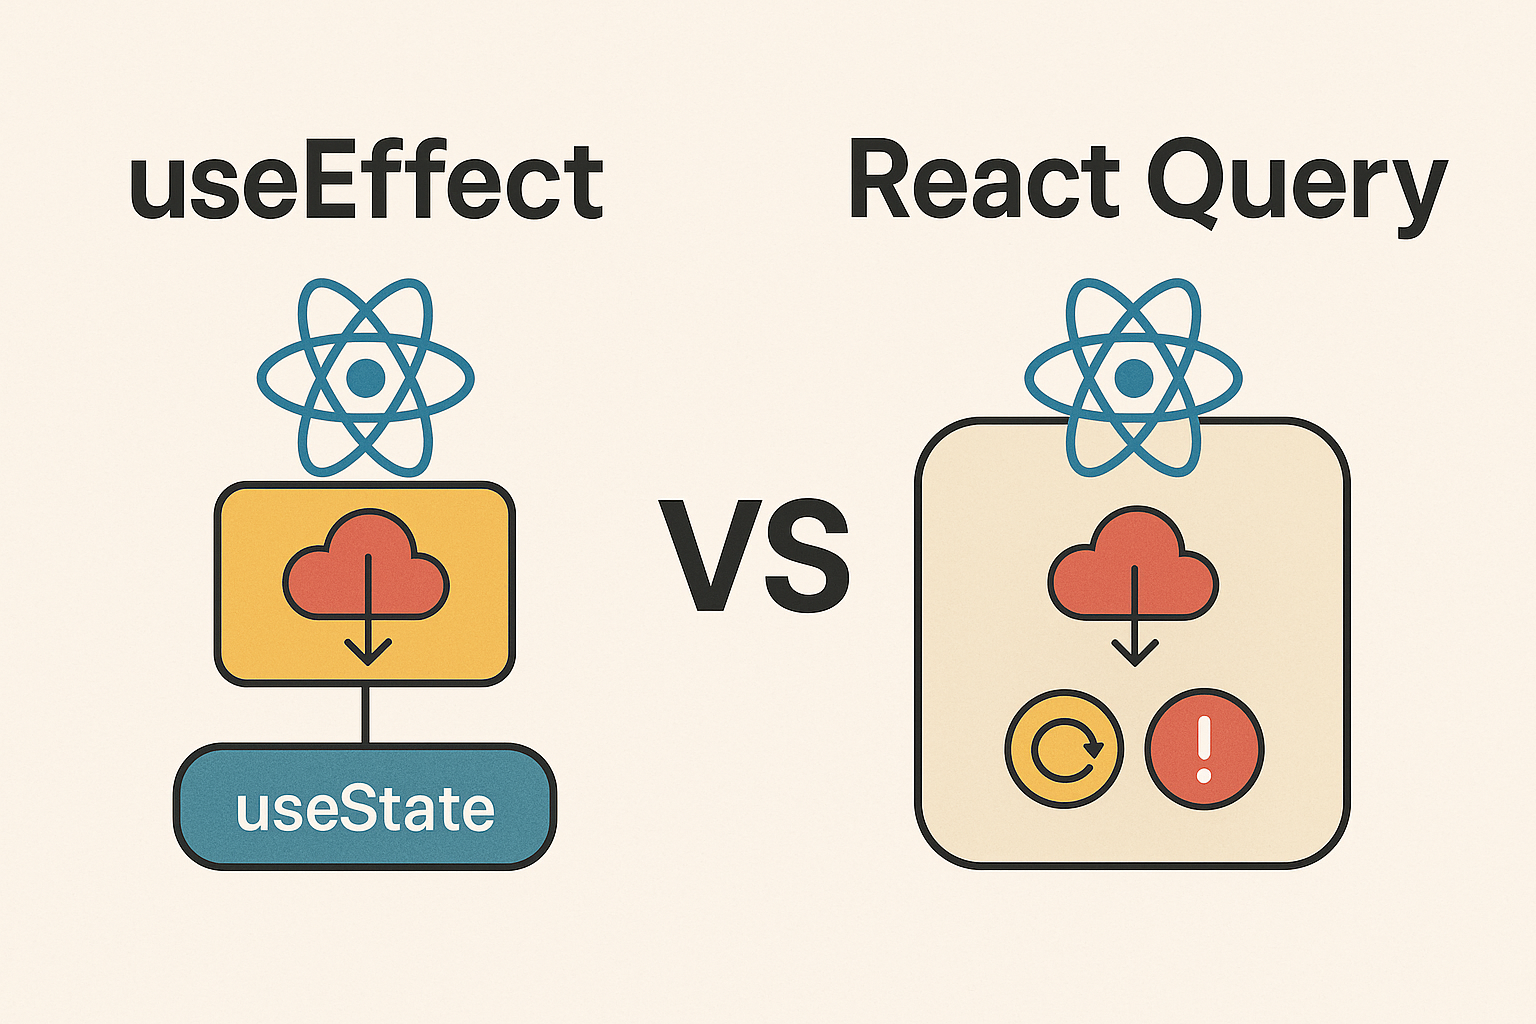
React Query 적용하기 전, 나의 API 연동 방식
프론트엔드 개발을 시작한 지 1년 4개월 정도 되었다.
처음 API를 연동할 때는 가장 많이 사용된다는 이유로 axios를 선택했고, 서버에서 받아온 데이터를 useState, useEffect로 관리했다.
그 당시에는 리액트로 개발 전반적인 흐름을 이해하는 데 목적이 있었기 때문에 어떤 라이브러리가 더 적합할지, 데이터를 어떻게 효율적으로 다뤄야 할지 깊이 고민하지 않았다.
첫 프로젝트가 끝난 뒤, 다음 프로젝트부터는 '어떻게 하면 데이터를 더 잘 관리할 수 있을까?', '어떤 라이브러리를 적용하면 좋을까?' 같은 고민을 자연스럽게 하게 됐고, 실제로 적용해보며 하나씩 배워갔다.
개발 초기 API 연동 방식
- 서버 요청은 컴포넌트마다 useEffect 안에서 직접 처리
- 응답 데이터를 useState로 저장해 상태를 관리했고, 로딩/에러 상태도 매번 따로 구현
- 재요청이 필요한 경우도 별도 함수로 직접 작성해서 처리
당시에는 일단 작동만 하면 된다고 생각했고, 코드의 중복이나 성능에 대한 고민은 많지 않았다.
그래서 프로젝트하는 동안 데이터 흐름이 복잡해지고 유지보수도 어렵다는 문제는 느꼈지만 당장은 기한 내에 완성하는 것에만 집중하였다.
다음 프로젝트부터의 변화
현재 진행 중인 프로젝트에서는 React Query를 이용해 서버 데이터를 비동기적으로 관리하고 있다.
프로젝트를 시작하면서 팀원들과 컨벤션을 맞춰보던 중, React Query를 적용하면 더 효율적으로 데이터 관리할 수 있다라는 의견에 도입하게 되었다.
하지만 막상 쓰기 시작하고 보니, 왜 이 라이브러리를 써야 하는지, 어떤 점이 기존 방식보다 나은지에 대해서는 깊게 공부하지 않았다.
그래서 이번 포스팅에서는 내가 직접 경험했던 두 방식(API 연동과 상태 관리 방식)을 비교하면서, React Query를 왜 써야 하는지 정리해보려 한다.
기존 방식의 문제점
1. 중복 요청&캐싱 미지원
useEffect(() => {
  fetchAllDosageData(); // 컴포넌트가 마운트될 때 전체 데이터를 가져옴
}, [fetchAllDosageData]);
useEffect를 사용해서 컴포넌트가 마운트될 때마다 API 요청이 발생하고 있다. 이 방식은 캐시를 사용하지 않기 때문에, 같은 데이터를 사용하는 다른 컴포넌트에도 중복 요청이 발생할 수 있다.
이는 불필요한 네트워크 비용, UI 반응 저하, 서버 부하 증가로 이어질 수 있다.
2. 로딩/에러 상태 처리의 반복과 복잡성
const [dosageData, setDosageData] = useState<DosageData[]>([]);

const fetchAllDosageData = useCallback(async () => {
  try {
    const response = await axios.get(
      'https://www.everycare.site/api/v1/medicines/records/list',
      {
        headers: {
          'Content-Type': 'application/json',
          Accept: 'application/json',
          Authorization: `Bearer ${token}`,
        },
        withCredentials: true,
      },
    );
    ...
    setDosageData(groupedData);
  } catch (error) {
    console.error('Failed to fetch dosage data:', error);
  }
}, [token]);
axios 요청 후 결과를 useState로 수동 저장하고 있고 에러 핸들링도 try/catch로 수동 구현하고 있다. isLoading 상태도 따로 없기 때문에, 로딩 중 여부를 UI에 반영하려면 추가 작업이 필요하다. 또한 재요청(refetch)을 하려면 별도의 함수 호출도 추가 작업이 필요하다.
React Query 소개
위와 같은 문제점을 효율적으로 처리해주는 게 바로 React Query였다.
당시에는 간단히 공부하고 적용했지만, 이번 포스팅에서 이 라이브러리가 왜 필요한지, 어떤 점이 기존 방식보다 나은지 자세히 문서화해보겠다.
React Query는 React Component에서 서버의 상태를에서 서버의 상태를 불러오고, 캐싱하며, 지속적으로 동기화하고 업데이트 하는 작업을 도와주는 라이브러리다.
Hook을 사용하여 React Component 내부에서 자연스럽게 서버의 데이터를 사용할 수 있는 방법이다.
React Query에 대한 개념은 이전에 작성한 글이 있어서, 이번 포스팅에서는 생략하고 직접 적용하면서 느낀 점과 기존 방식과의 비교에 초점을 맞춰 정리해보려고 한다.
개념이 궁금하다면 React Query로 데이터 흐름, 이렇게 쉬워도 되나요? 참고해보면 도움이 될 것이다.
React Query를 적용한 코드
이벤트 상세 조회 (GET)
const useEventDetail = () => {
  const { id } = useParams();

  const eventId = Number(id);

  const { data } = useQuery({
    queryKey: ['eventDetail', eventId],
    queryFn: () => eventDetail({ eventId }),
  });

  return { data };
};
호스트 생성 요청 (POST)
export const useHostCreation = () => {
  return useMutation<ApiResponse<null>, Error, HostCreationRequest>({
    mutationFn: async (requestBody: HostCreationRequest) => {
      return await createHost(requestBody);
    },
  });
};
React Query를 써야 하는 이유
1. 데이터를 '상태'가 아닌 '캐시'로 관리한다.
React Query는 캐싱 기반의 백엔드 상태 동기화 라이브러리이다.
동일한 queryKey를 기준으로 요청을 캐싱하기 때문에 여러 컴포넌트에서 동일한 데이터를 사용하더라도 네트워크 요청이 한 번만 발생한다. 이는 성능 최적화에 유리하다.
2. 복잡한 상태 관리 없이도 로딩/에러/데이터 상태 등이 자동으로 관리된다.
isLoading, error, data 등 상태가 자동으로 제공돼서 매번 useState로 상태 선언하고, try/catch로 감쌀 필요가 없다. 이는 코드도 간결해지고 일관성도 유지된다.
3. API 요청에 대한 재사용성과 확장성이 높다.
요청 로직이 queryFn으로 모듈화되면서 여러 컴포넌트에서 중복없이 재사용 가능하다. 나중에 stale-time, suspense, pagination 등 기능 확장도 쉬워진다.
React Query를 통해 단순히 "잘 작동하는 코드"가 아니라 "더 효율적이고 안정적인 코드"를 작성하는 방법을 배울 수 있었다.
처음엔 그저 기능이 좋아 보여서 적용했지만, "왜 이 기술을 써야 하는가"를 스스로 생각하고 선택하는 능력이 중요하다는 것을 느꼈다. 이것은 단순한 구현 능력보다도 기술 선택에 대한 판단력이고, 프론트엔드 개발자로서 꼭 필요한 역량 중 하나라고 생각한다.
이전에는 잘 몰랐지만, 라이브러리 하나를 선택하는 기준과 근거를 갖는 것도 좋은 코드를 작성하는 것만큼 중요한 부분이라는 것을 깨달았다.
좋은 내용의 글 감사합니다. 덕분에 React Query 의 필요성에 대해서 알게되었네요~