프로세스와 스레드, 프로그램이 작동하는 방식에 대해 잘 이해하고 있는지가 기술면접 단골 질문 사항이라고 한다.
기본적인 용어 및 개념과 원리, 프로세스와 스레드의 차이점 등을 정리해보려한다.
프로세스와 스레드란?
프로세스(Process) : 운영체제로부터 자원을 할당받은 작업의 단위
스레드(Thread) : 프로세스가 할당받은 자원을 이용하는 실행 흐름의 단위
이렇게만 들으면 간단한 CS 및 운영체제 지식이 있는 분들이라면 대충 감이 오시겠지만, 확실한걸 좋아하는 나는 그 두루뭉실하게 느껴지는 감이 더 답답한 것 같다.
이번 포스팅으로 기초를 탄탄하게 다져보도록 하자.
먼저, 프로세스를 설명하기 위해서는 '프로그램'에 대해 알아야 한다.
프로그램과 프로세스의 관계
프로그램(Program)이란?
먼저 이해하기 쉬운 간단한 설명 및 정의는 이렇다.
컴퓨터에서 실행할 수 있는 파일을 통칭.
→ 예: 윈도우의.exe파일, Mac의.dmg파일 등
좀 더 어렵게 표현하자면, 특정 작업을 수행하기 위해 작성된 일련의 지침이라고도 한다.
프로그램은 아직 "파일을 실행하지 않은 상태"이기 때문에 정적(Static)이라는 표현을 사용한다.
그래서 정적 프로그램(Static Program)이라고 하며, 이를 줄여서 프로그램(Program)이라고 부른 것이다.
프로세스(Process)란?
이제, 프로세스에 대해 설명하기 위해 프로그램을 좀 더 CS적으로 설명하자면
프로그램 : 파일이 저장 장치에 저장되어 있지만 메모리에는 올라가 있지 않은 정적인 상태.
여기서 "메모리에 올라가 있지 않다"는 것은 아직 운영체제가 프로그램에게 독립적인 메모리 공간을 할당해주지 않았다는 뜻이다.
모든 프로그램은 운영체제에게서 실행되기 위한 메모리 공간을 할당해 줘야 실행 가능하다.
프로그램을 실행하는 순간 해당 파일은 컴퓨터 메모리에 올라가게 된다. 이러한 동적인 상태의 프로그램을 프로세스(Process)라고 한다.
메모리에 적재된 프로그램은 CPU에게 자원을 할당받아 동적인 "실행" 상태가 된다.
위키피디아에서는 프로세스의 정의에 대해 "실행되고 있는 컴퓨터 프로그램"이라고 정의를 내리고 있으며, 스케줄링 단계에서의 "작업"과 같은 단어라고 봐도 무방하다고 하고 있다. 실제로 프로세스라는 단어가 작업 중인 프로그램을 의미하는 단어이기 때문이다.
프로세스와 스레드의 관계
프로세스의 한계
과거에는 프로그램 하나를 실행하면 시작부터 종료까지 오직 하나의 프로세스만을 사용하여 진행했다.
이로 인해, 예를 들어 파일 하나를 다운로드하는 동안에는 다른 작업을 할 수 없어 긴 시간을 그대로 기다려야만 했다.
시간이 흐를수록 프로그램은 점점 복잡해졌고, 더 이상 하나의 프로세스만으로는 프로그램을 실행하기에 무리가 생기게 되어 사람들은 새로운 방안을 모색해야만 했다.
처음에는 단순히 생각해서 "하나의 프로그램에 여러 프로세스를 만들면 되지 않을까" 싶지만, 이는 현실적으로 불가능하다. 왜냐하면 운영체제가 안정성을 위해 각 프로세스가 자신에게만 할당된 메모리 영역에만 접근할 수 있도록 제한했기 때문이다.
만약 여러 프로세스가 하나의 프로그램을 구성한다면, 이들끼리 정보를 주고받기 위해 서로의 메모리에 접근해야 하는데, 이는 운영체제의 보호 매커니즘에 위배되어 오류나 충돌이 발생할 수 있기 때문이다.
이러한 한계를 극복하기 위해 등장한 개념이 바로 스레드(Thread)다.
스레드(Thread)란?
하나의 프로세스 내에서 동시에 진행되는 작업 갈래, 흐름의 단위를 말함.
이해를 돕기위한 예시로, 크롬 브라우저가 실행되면 프로세스 하나가 생성될 것이다.
그런데 우리는 브라우저에서 파일을 다운 받으며 온라인 쇼핑을 하면서 게임을 하기도 한다.
즉, 하나의 프로세스 안에서 여러가지 작업들의 흐름이 동시에 진행되기 때문에 가능한 것인데, 이러한 일련의 작업 흐름들을 스레드라고 하며 여러개가 있다면 이를 멀티(다중) 스레드라고 부른다.
프로세스의 한계에서 유추할 수 있듯, 스레드는 프로세스와 다르게 서로 다른 스레드간의 메모리를 공유하며 작동한다. 스레드끼리 프로세스의 자원을 공유하면서 프로세스 실행 흐름의 일부가 되는 것이다.
❓프로세스의 한계를 극복하기 위해 등장한 스레드
처음에 하나의 프로세스로만 동작하는 한계를 극복하기 위해 스레드가 등장했다고 했는데, 여기서 든 의문이 "그러면 쓰레드는 처음 생겼을 때 부터 "멀티스레딩"을 전제로 등장한 것인가?" 였다.
프로세스가 하나이기 때문에 생긴 문제점을 보완하려 등장했는데 스레드도 하나라면 결국, 프로그램을 처리하는 일꾼은 여전히 1명인 것이 아닌가? 라는 생각이 들었다.결론부터 말하자면, 스레드는 처음에 프로세스 내에서 더 가볍고 효율적인 실행 단위를 만들기 위한 수단으로 등장했다.
배경 설명
초기 운영체제에서는 작업을 오직 프로세스 단위로만 실행했다. 하지만 프로세스는 메모리, 컨텍스트 전환 비용이 크고 무겁다는 단점이 있었다. 이러한 한계를 해결하기 위해 프로세스 내에서 실행 흐름을 나눌 수 있는 더 가벼운 단위, 즉 스레드라는 개념이 등장한 것이다.
한계 극복
위의 크롬 브라우저 예시를 이어서 들자면, 과거에는 한 프로세스(크롬)가 파일을 다운로드 중이면 사용자 입력(UI)이 멈췄다.
하지만 현재는 한 프로세스 안에서 다운로드 스레드, 사용자 입력 스레드, UI 갱신 스레드를 나누어 처리하며 끊김 없이 동시에 작업 처리가 가능해졌다.이는 하나의 단일 스레드(single thread)가 여러 작업을 빠르게 번갈아 처리하는 방식으로, 겉보기엔 동시에 여러 일을 수행하는 것처럼 보이지만 실제로는 순차적인 처리(병행)에 불과하다.
이러한 단일 스레드 방식의 한계를 극복하기 위해, 하나의 프로세스 안에서 여러 개의 스레드가 동시에 실행되는 '멀티스레딩(multithreading)' 개념이 등장하게 된다.
프로세스 & 스레드의 메모리
프로세스와 스레드의 내부 동작 방식에 대해 좀 더 자세히 알아보자.
프로세스의 자원 구조
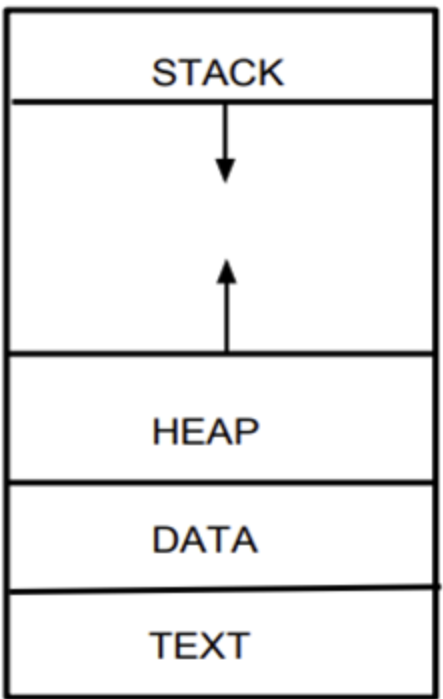
- 코드영역(Code/Text)
- 프로그래머가 작성한 프로그램 함수들의 코드가 CPU가 해석 가능한 기계어 형태로 저장되어 있다.
- 데이터 영역(Data)
- 코드가 실행되면서 사용하는 전역 변수나 각족 데이터들이 모여있다. 데이터 영역은
.data,.rodata,.bss영역으로 세분화 된다..data: 전역 변수 또는 static 변수 등 프로그램이 사용하는 데이터를 저장
.BSS: 초기값 없는 전역 변수, static 변수가 저장
.rodata:const같은 상수 키워드 선언 된 변수나 문자열 상수가 저장
- 코드가 실행되면서 사용하는 전역 변수나 각족 데이터들이 모여있다. 데이터 영역은
- 스택 영역(Stack)
- 지역 변수와 같은 호출한 함수가 종료되면 되돌아올 임시적인 자료를 저장하는 독립적인 공간이다. Stack은 함수의 호출과 함께 할당되며, 함수의 호출이 완료되면 소멸한다. 만일 stack 영역을 초과하면 stack overflow 에러가 발생한다.
- 힙 영역(Heap)
- 생성자, 인스턴스와 같은 동적으로 할당되는 데이터들을 위해 존재하는 공간이다. 사용자에 의해 메모리 공간이 동적으로 할당되고 해제된다.
위의 그림에서 Stack과 Heap 영역이 위아래로 화살표가 쳐 있는 것을 볼 수 있는데, 이는 코드 영역과 데이터 영역은 선언할 때 그 크기가 결정되는 정적 영역이지만, 스택 영역과 힙 영역은 프로세스가 실행되는 동안 크기가 늘어났다 줄어들기도 하는 동적 영역이기 때문에 이를 표현한 것이다.
아래 그림을 보면서 간략히 정리하자면, 프로그램이 여러개 실행된다면 메모리에 프로세스들이 담길 주소 공간이 생성되게 되고 그 안에 Code, Data, Stack, Heap 공간이 만들어지게 된다.
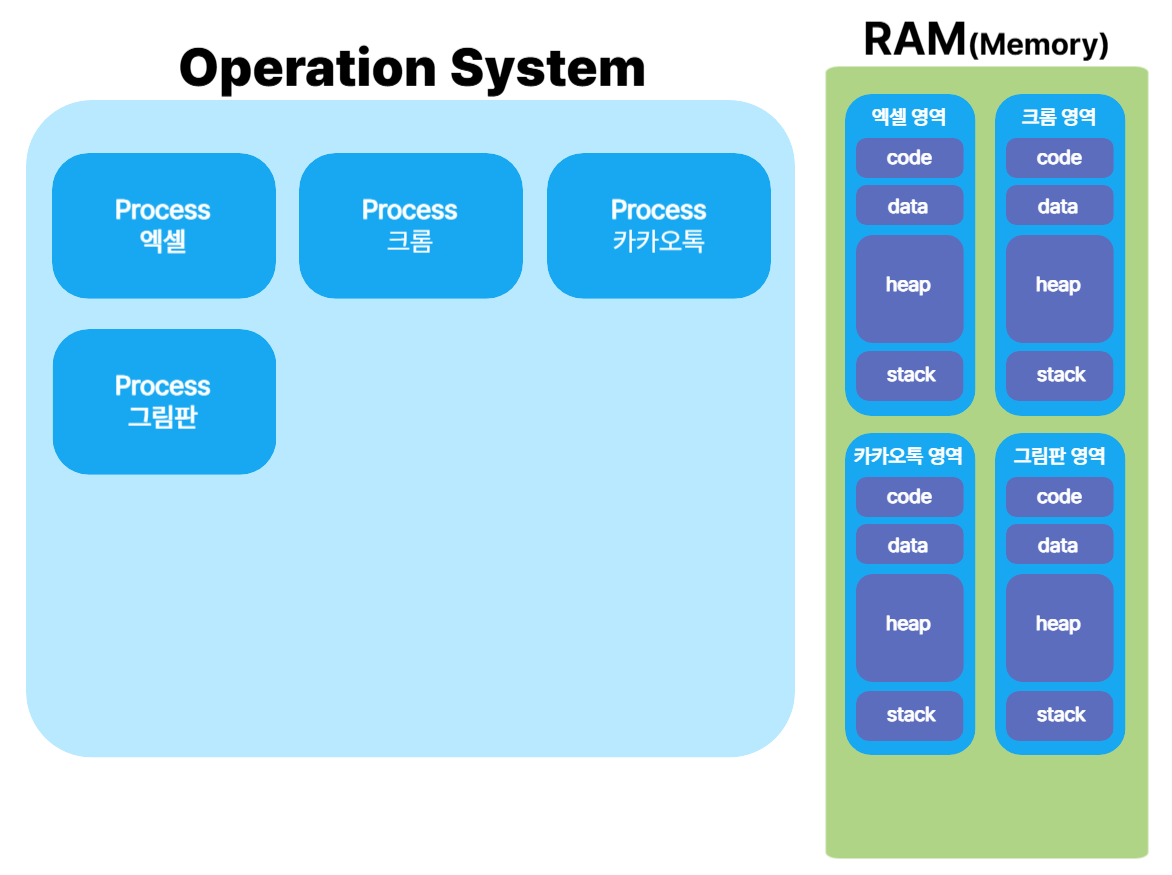 (이미지 참고 : Inpa Dev's tistory)
스레드의 자원 공유
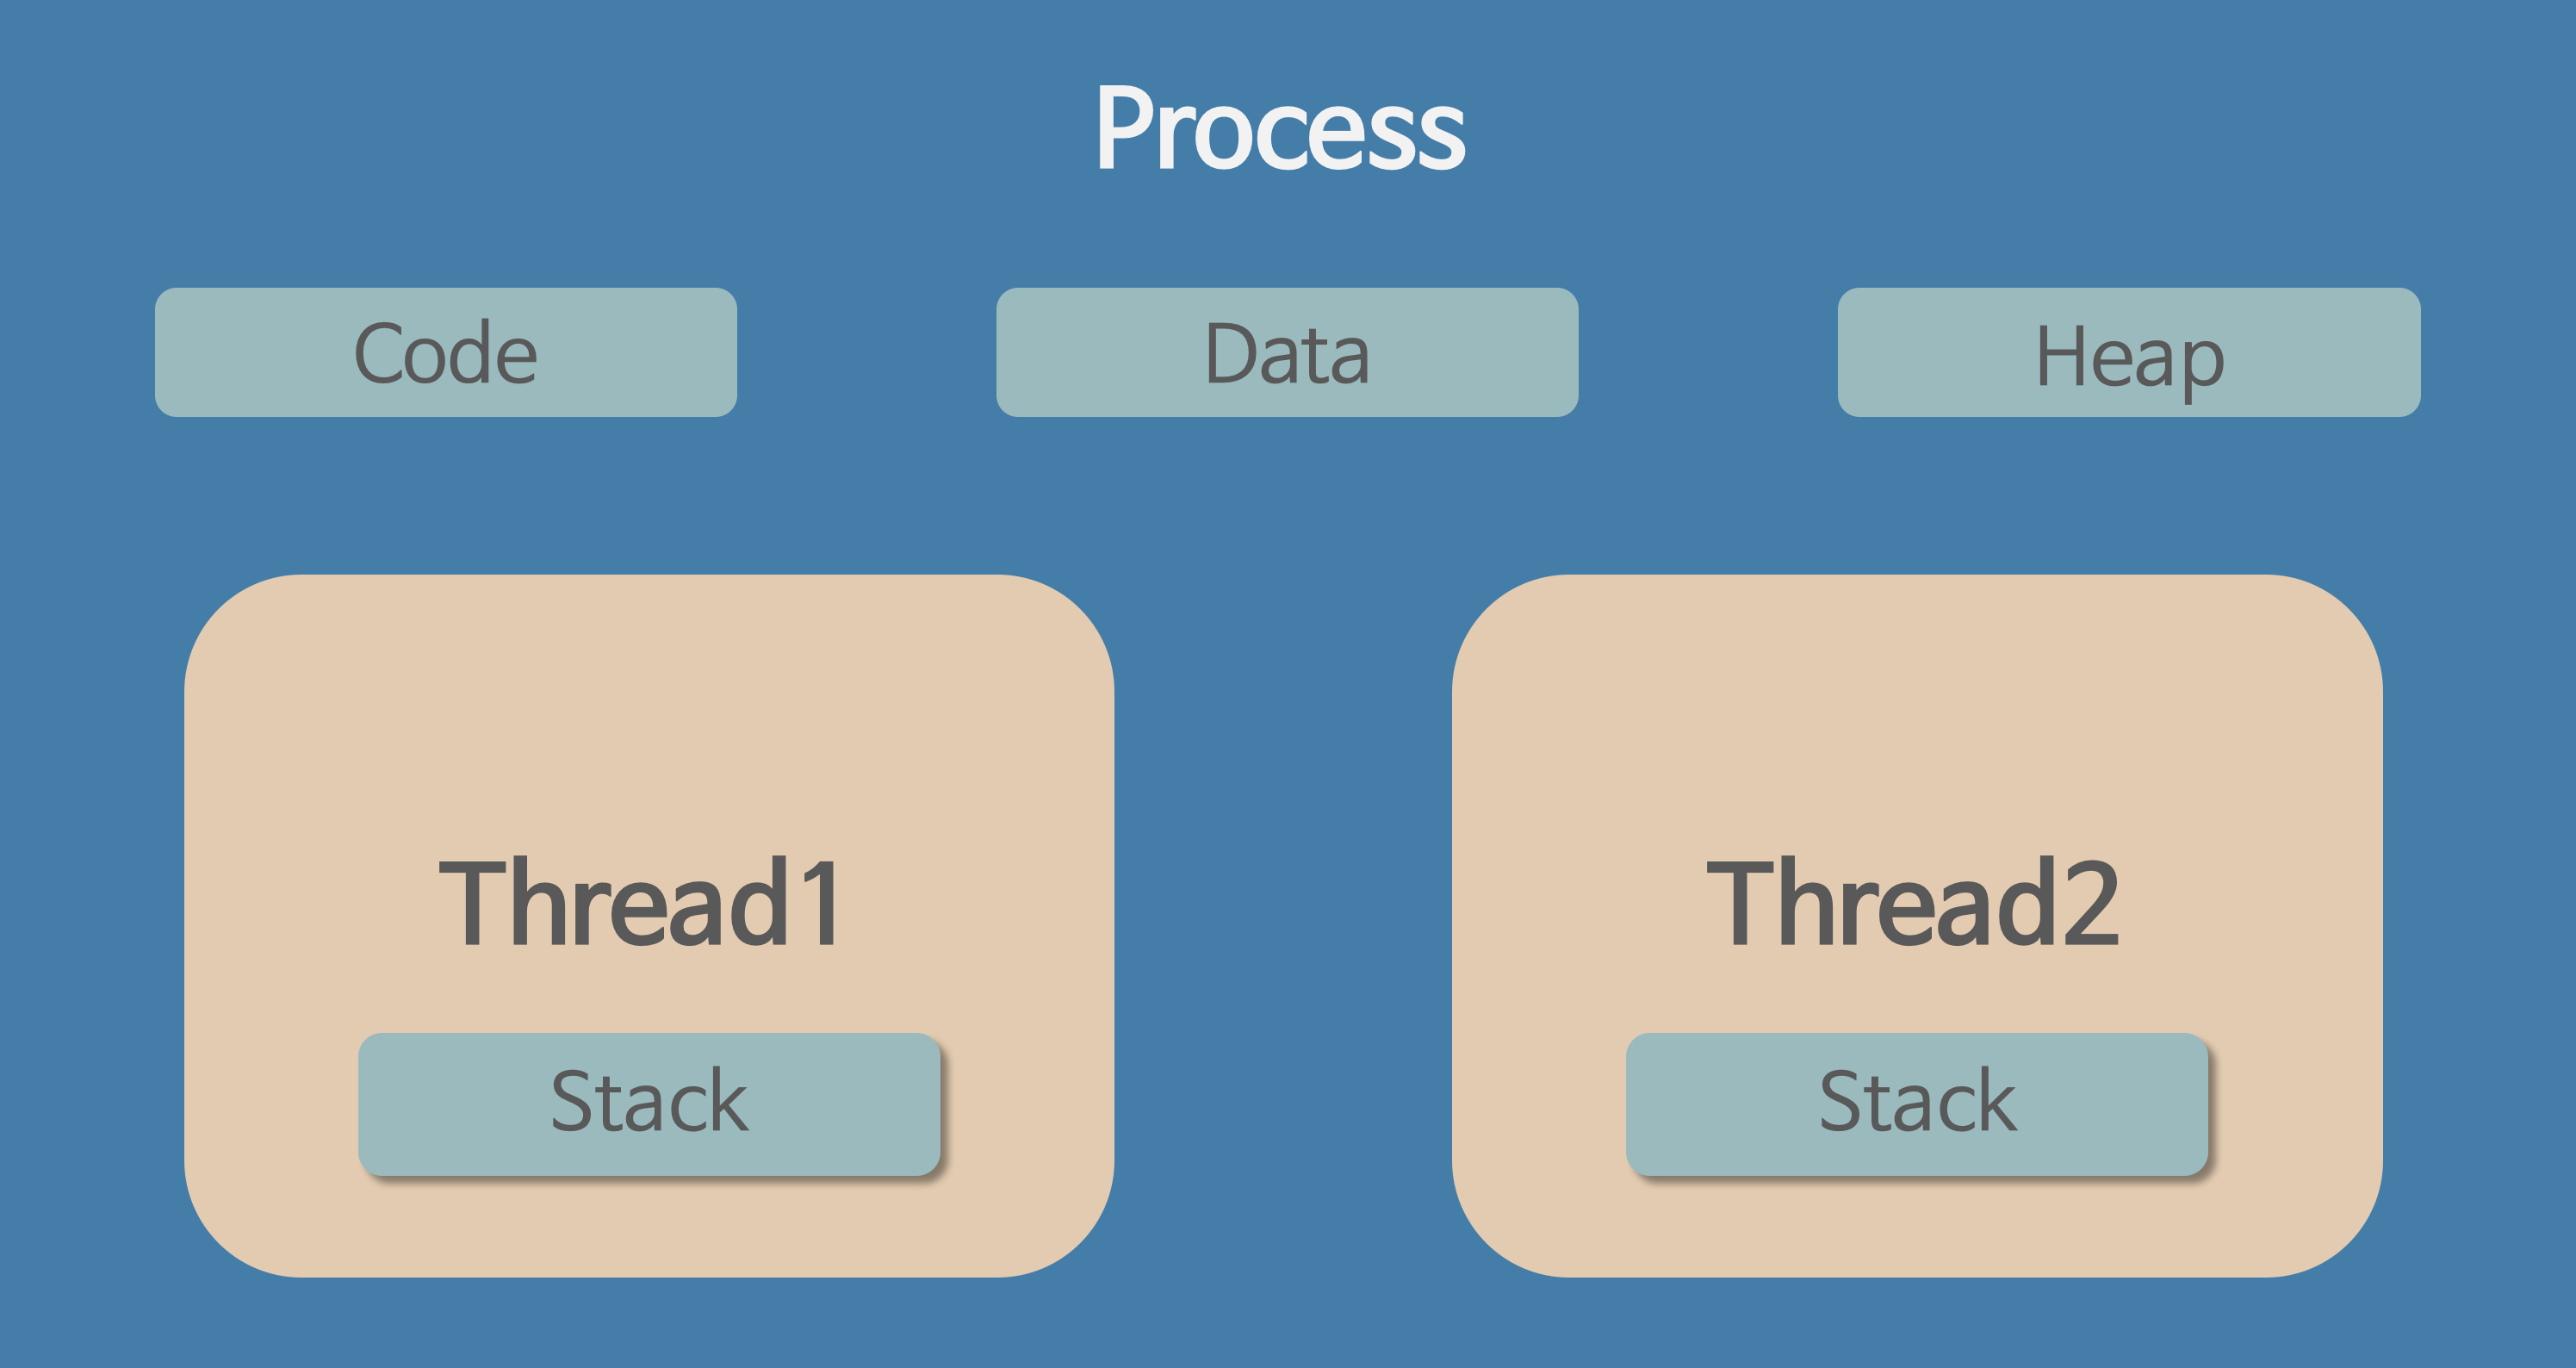
스레드가 여러개(= 멀티스레딩, multithreading) 있으면 우리가 파일을 다운 받으며 동시에 웹 서핑을 할 수 있게 해준다. 이는 스레드끼리 프로세스의 자원을 공유하면서 프로세스 실행 흐름의 일부가 되기 때문에 동시 작업이 가능한 것이다. 그래서 아래 사진과 같이 하나의 프로세스 내에 여러 개의 스레드가 들어있는 상태인 것이다.
 (이미지 출처 : Heee's Development Blog)
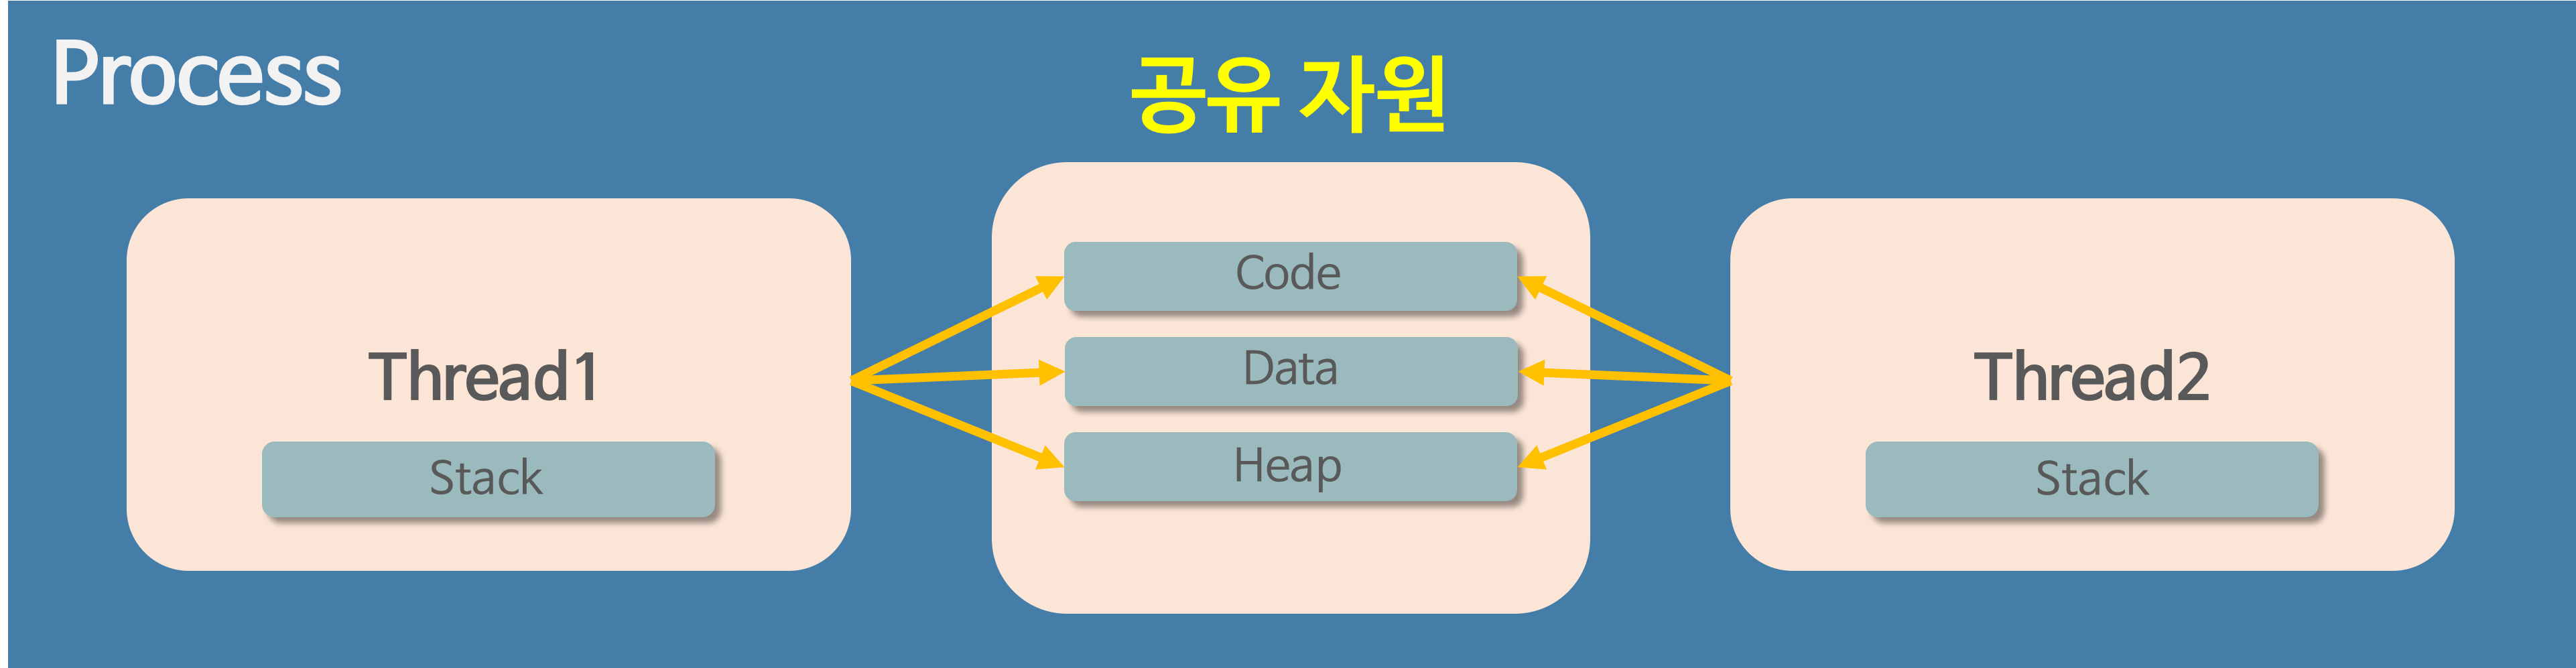
이때 프로세스 4가지 메모리 영역(Code, Data, Heap, Stack) 중 스레드는 Stack만 할당받아 복사하고 Code, Data, Heap은 프로세스내의 다른 스레드들과 공유된다. 따라서 각각의 스레드는 별도의 stack을 가지고 있지만 heap 메모리는 고유하기 때문에 서로 다른 스레드에서 가져와 읽고 쓸 수 있게 된다.
 (이미지 출처 : Heee's Development Blog)
stack은 함수 호출 시 전당되는 인자, 되돌아갈 주소값, 함수 내에서 선언하는 변수 등을 저장하는 메모리 공간이기 때문에, 독립적인 스택을 가졌다는 것은 독립적인 함수 호출이 가능하다 라는 의미이다. 그리고 독립적인 함수 호출이 가능하다는 것은 독립적인 실행 흐름이 추가된다는 말이다. 즉, stack을 가짐으로써 스레드는 독립적인 실행 흐름을 가질 수 있게 되는 것이다.
이렇게 구성한 이유는 하나의 프로세스를 다수의 실행 단위인 스레드로 구분하여 자원을 공유하고, 자원의 생성과 관리의 중복성을 최소화하여 수행 능력을 올리기 위해서다.
프로세스의 자원 공유
기본적으로 각 프로세스는 메모리에 별도의 주소 공간에서 실행되기 때문에, 한 프로세스는 다른 프로세스의 변수나 자료구조에 접근할 수는 없다. 그렇다면 프로세스는 영원히 다른 프로세스 정보에 접근할 수 없을까?
현재 우리가 사용하는 대부분의 컴퓨터 프로그램을 보면 다른 프로그램에 있는 정보를 가져오는 경우는 심심치 않게 볼 수 있을 것이다. 이처럼 특별한 방법을 통해 프로세스가 다른 프로세스의 정보에 접근하는 것이 가능하다. 프로세스 간 정보를 공유하는 방법에는 다음과 같은 방법들이 있다.
1. IPC(Inter-Process Communication) 사용
2. LPC(Local inter-Process Communication) 사용
3. 별도로 공유 메모리를 만들어서 정보를 주고받도록 설정
그러나 프로세스 자원 공유는 단순히 CPU 레지스터 교체뿐만이 아니라 RAM과 CPU 사이의 캐시 메모리까지 초기화되기 때문에 자원 부담이 크다는 단점이 있다. 그래서 다중 작업이 필요한 경우, 스레드를 이용하는 것이 훨씬 효율적이다.
이에 현대 컴퓨터의 운영체제에선 다중 프로세싱을 지원하고 있지만 다중 스레딩을 기본으로 하고 있다.
프로세스 간의 정보 공유 방식에 대해선 다음에 벨로그에서 따로 다뤄보겠다.
[참고]
https://velog.io/@raejoonee/%ED%94%84%EB%A1%9C%EC%84%B8%EC%8A%A4%EC%99%80-%EC%8A%A4%EB%A0%88%EB%93%9C%EC%9D%98-%EC%B0%A8%EC%9D%B4
https://inpa.tistory.com/entry/%F0%9F%91%A9%E2%80%8D%F0%9F%92%BB-%ED%94%84%EB%A1%9C%EC%84%B8%EC%8A%A4-%E2%9A%94%EF%B8%8F-%EC%93%B0%EB%A0%88%EB%93%9C-%EC%B0%A8%EC%9D%B4
https://gmlwjd9405.github.io/2018/09/14/process-vs-thread.html
https://velog.io/@aeong98/%EC%9A%B4%EC%98%81%EC%B2%B4%EC%A0%9COS-%ED%94%84%EB%A1%9C%EC%84%B8%EC%8A%A4%EC%99%80-%EC%8A%A4%EB%A0%88%EB%93%9C