반갑습니다.
이번 글에서는 관측성(Observability) 도구인 OpenTelemetry와 Langfuse에 대해 알아볼까 합니다.
LLM 서비스를 운영하다 보면 로그를 살펴볼 일이 아주 많은데, 복잡한 Agent일수록 로그 찾기가 쉽지 않습니다.
이 문제를 해결해주는 것이 오늘 소개할 도구들입니다.
시작 ~!
Observability(관측성)란?
시스템 바깥에서 나온 출력(트레이스, 메트릭, 로그)만 보고도 시스템 내부에서 무슨 일이 일어났는지 파악할 수 있는 능력을 말합니다.
print 문 로그만으로도 어느 정도 가능하지 않냐?(실제로 저도 자주 사용합니다) 라고 할 수 있는데,
서비스가 커지면 이야기가 달라집니다.
- 요청 하나가 API 서버 → 검색 서버 → LLM → DB를 거치는데, 로그는 서버마다 뿔뿔이 흩어져 있음
- "느리다"는 건 알겠는데 어느 구간에서 느린지를 모름
- 에러 로그는 찍혔는데 그 에러가 어떤 요청 때문에 났는지 못 찾음
자동차 블랙박스에 비유할 수 있겠습니다.
사고(장애)가 난 뒤에 "그 시점에 정확히 무슨 일이 있었는지"를 되감아 볼 수 있어야 하죠.
블랙박스 없이 목격자 진술(파편화된 로그)만으로 사고를 재구성하려면,, 많이 힘듭니다.
관측성 확보는 개발 단계에서는 중요성이 간과되는 경우가 많지만, 이후에 발목을 잡는 경우가 많습니다.
OpenTelemetry란?
OpenTelemetry(줄여서 OTel)는 애플리케이션의 트레이스 / 메트릭 / 로그를 표준화된 방식으로 생성하고 내보내기 위한 개방형 표준입니다.
CNCF(클라우드 네이티브 컴퓨팅 재단, 쿠버네티스 만든곳) 프로젝트이구요.
이전에 MCP 글에서 프로토콜은 "상호간의 약속"이라고 설명드렸었는데, OTel도 같은 맥락입니다.
MCP가 "LLM이 도구를 쓰는 방식을 통일하자"는 약속이라면,
OTel은 "관측 데이터를 만들고 보내는 방식을 통일하자"는 약속입니다.
OTel의 등장 배경
OTel 이전에는 이런 문제들이 있었습니다.
- Datadog을 쓰면 Datadog 전용 에이전트로 계측하고, New Relic으로 갈아타려면 계측 코드를 전부 다시 짜야 함 (벤더 락인)
- 트레이싱은 Zipkin 방식, 메트릭은 Prometheus 방식,, 시그널마다 표준이 제각각
- 마이크로서비스 A와 B가 서로 다른 도구를 쓰면 요청 흐름이 중간에 끊김
한 줄로 적어보면 "계측 코드가 특정 벤더에 종속된다" 가 되겠네요.
그래서 계측(코드에 심는 부분)은 표준으로 한 번만 해두고,
데이터를 받아 저장/시각화하는 백엔드는 자유롭게 갈아끼울 수 있도록 만든 것이 OTel입니다.
OTel이 다루는 3가지 시그널
| 시그널 | 답하는 질문 | 예시 |
|---|---|---|
| Trace | 이 요청이 어디를 거쳐 얼마나 걸렸나? | API 호출 → 검색 → LLM 호출 |
| Metric | 시스템이 전반적으로 어떤 상태인가? | 초당 요청 수, 에러율, p99 레이턴시 |
| Log | 그 시점에 무슨 일이 있었나? | 에러 메시지, 이벤트 기록 |
셋 중 OTel의 주력은 Trace입니다. 이 글에서도 트레이스 위주로 설명하겠습니다.
OTel의 구조
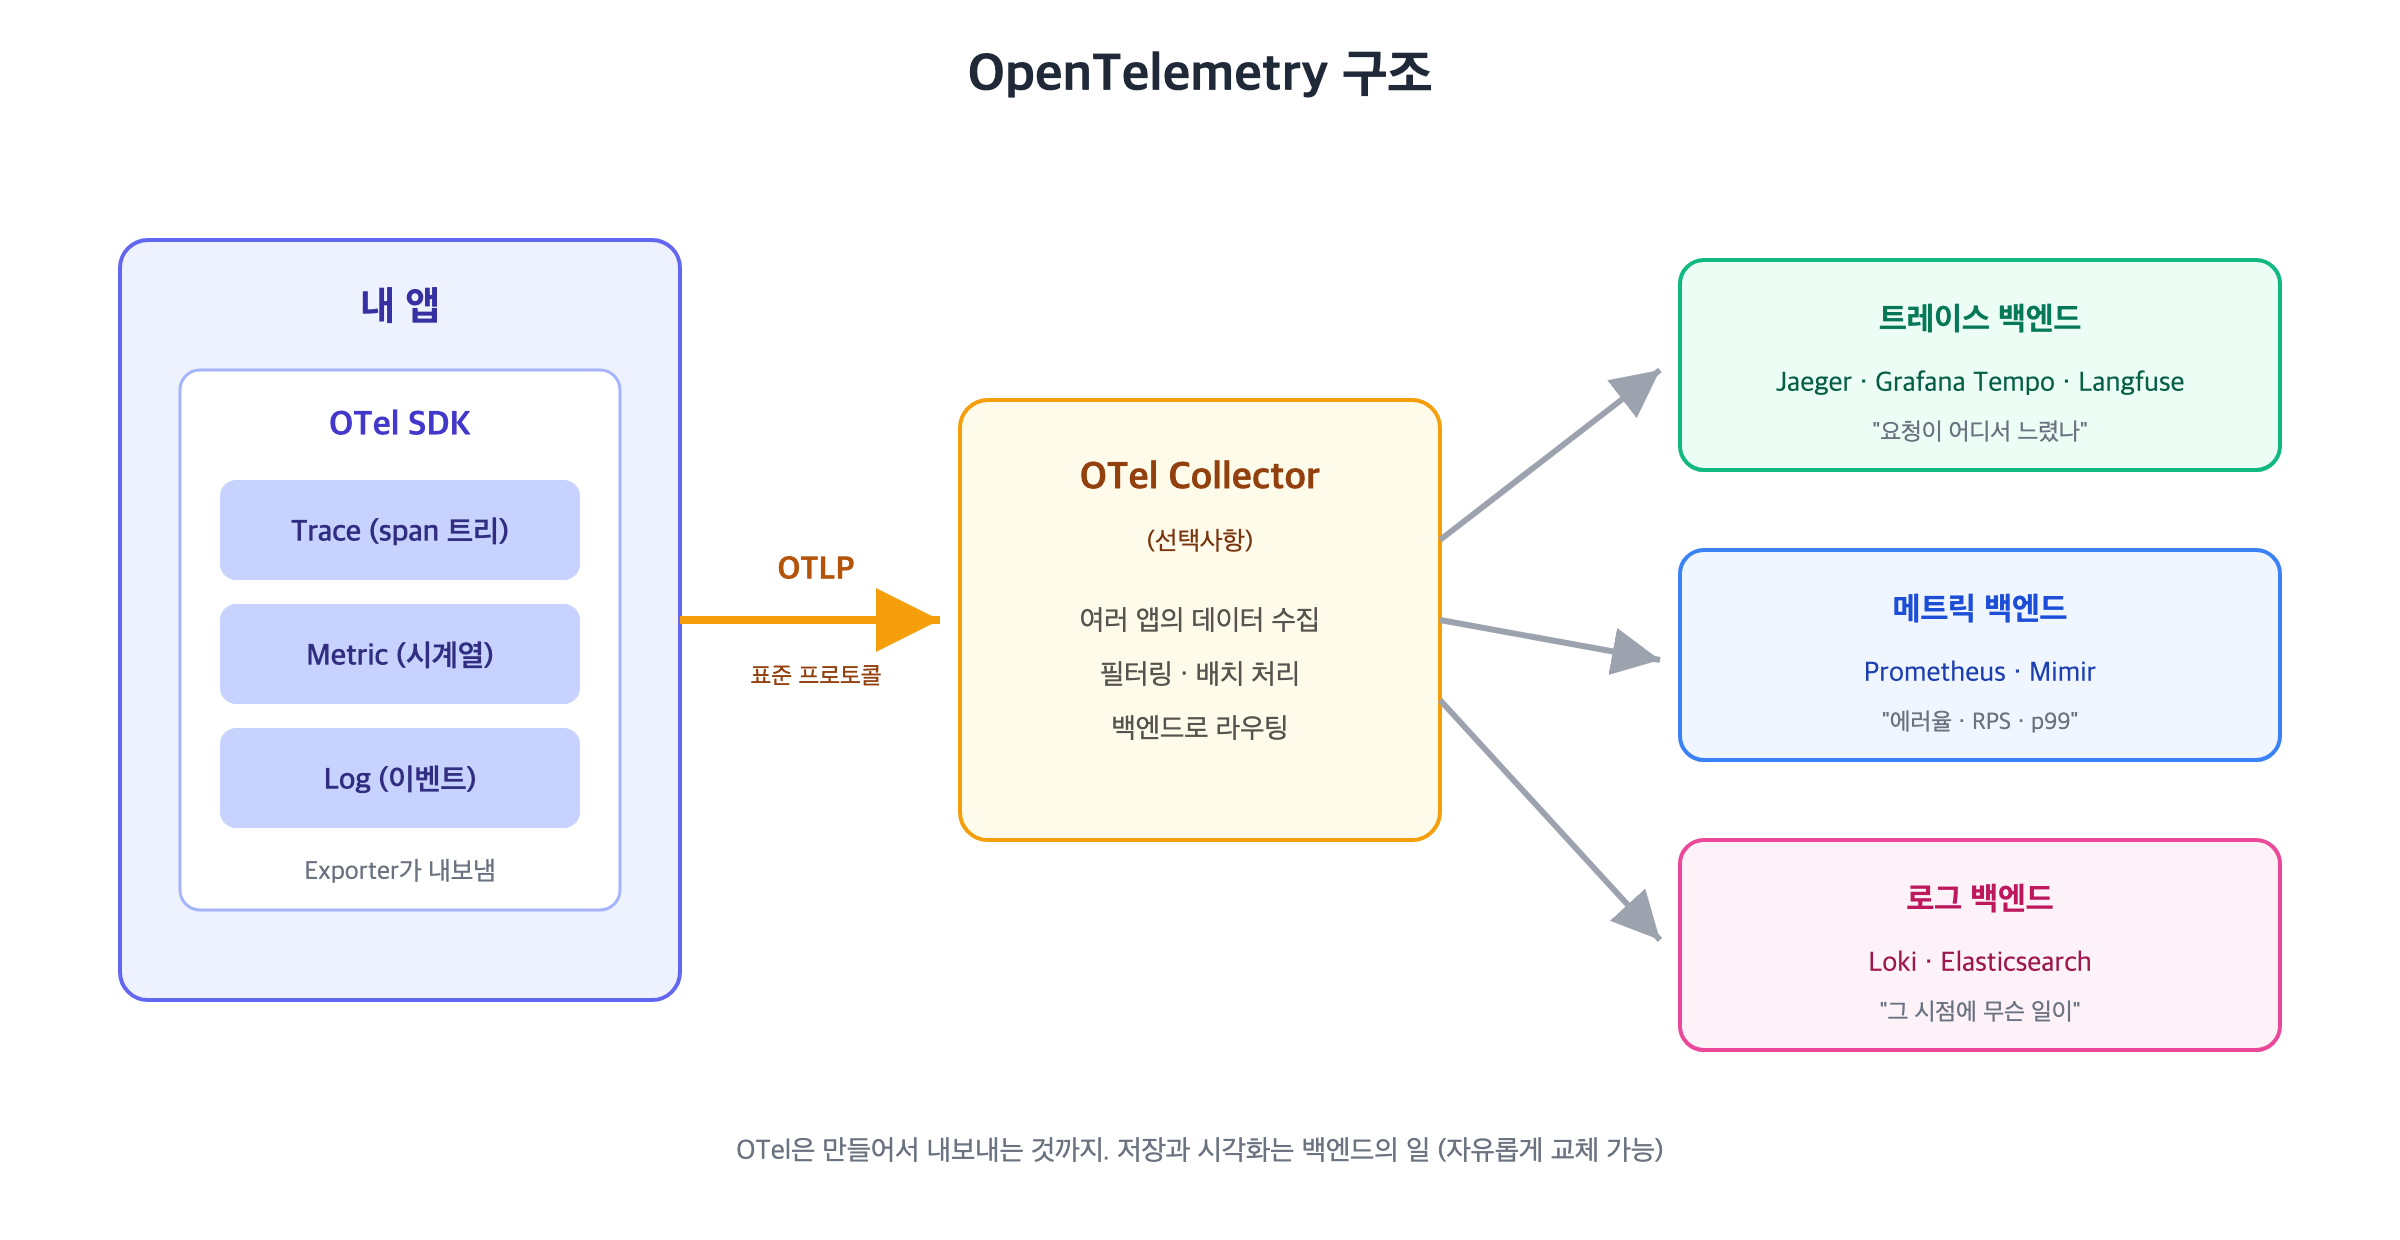
핵심 구성요소를 하나씩 살펴보겠습니다.
Trace / Span
- Trace : 요청 하나의 전체 여정입니다. "사용자가 주문 버튼을 눌렀다" 부터 응답까지 전부요.
- Span : 여정 속 개별 작업 단위(함수 하나, DB 쿼리 하나)입니다. 부모-자식 관계로 연결되어 트리를 이룹니다.
Exporter
만들어진 데이터를 OTLP(OpenTelemetry Protocol) 라는 표준 프로토콜로 백엔드에 내보내는 역할입니다.
받는 쪽이 OTLP만 알아들으면 뭐든 백엔드가 될 수 있습니다. Jaeger, Grafana Tempo, Datadog, 그리고 뒤에 나올 Langfuse까지요.
Collector (선택사항)
앱과 백엔드 사이에 두는 중간 게이트웨이입니다.
여러 앱의 데이터를 한 곳에 모아 필터링/배치 처리한 뒤 원하는 백엔드로 라우팅해줍니다.
없어도 동작은 하지만, 서비스가 여러 개라면 두는 것이 일반적입니다.
여기서 중요한 포인트는, OTel 자체는 저장소도 UI도 아니라는 것입니다.
데이터를 만들어서 표준 방식으로 내보내는 것까지만 OTel의 일이고,
저장하고 예쁘게 보여주는 건 백엔드(Jaeger 등)의 일입니다.
예시 코드
주문 처리 함수를 계측하는 예시입니다.
# pip install opentelemetry-sdk opentelemetry-exporter-otlp

from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor, ConsoleSpanExporter

# 1) 셋업 : 데이터를 어디로 보낼지 정합니다 (여기선 콘솔, 실전에선 OTLPSpanExporter)
provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(ConsoleSpanExporter()))
trace.set_tracer_provider(provider)

tracer = trace.get_tracer("my-app")

# 2) 계측 : 추적하고 싶은 구간을 span으로 감쌉니다
def handle_order(order_id: str):
    with tracer.start_as_current_span("handle_order") as span:
        span.set_attribute("order.id", order_id)  # 나중에 검색 가능한 메타데이터

        with tracer.start_as_current_span("fetch_user"):  # 자식 span
            user = fetch_user_from_db(order_id)

        with tracer.start_as_current_span("charge_payment"):  # 자식 span
            charge(user)

handle_order("ord-123")
실행하면 이런 트리가 만들어지고, Jaeger 같은 UI에서 타임라인 막대로 볼 수 있습니다.
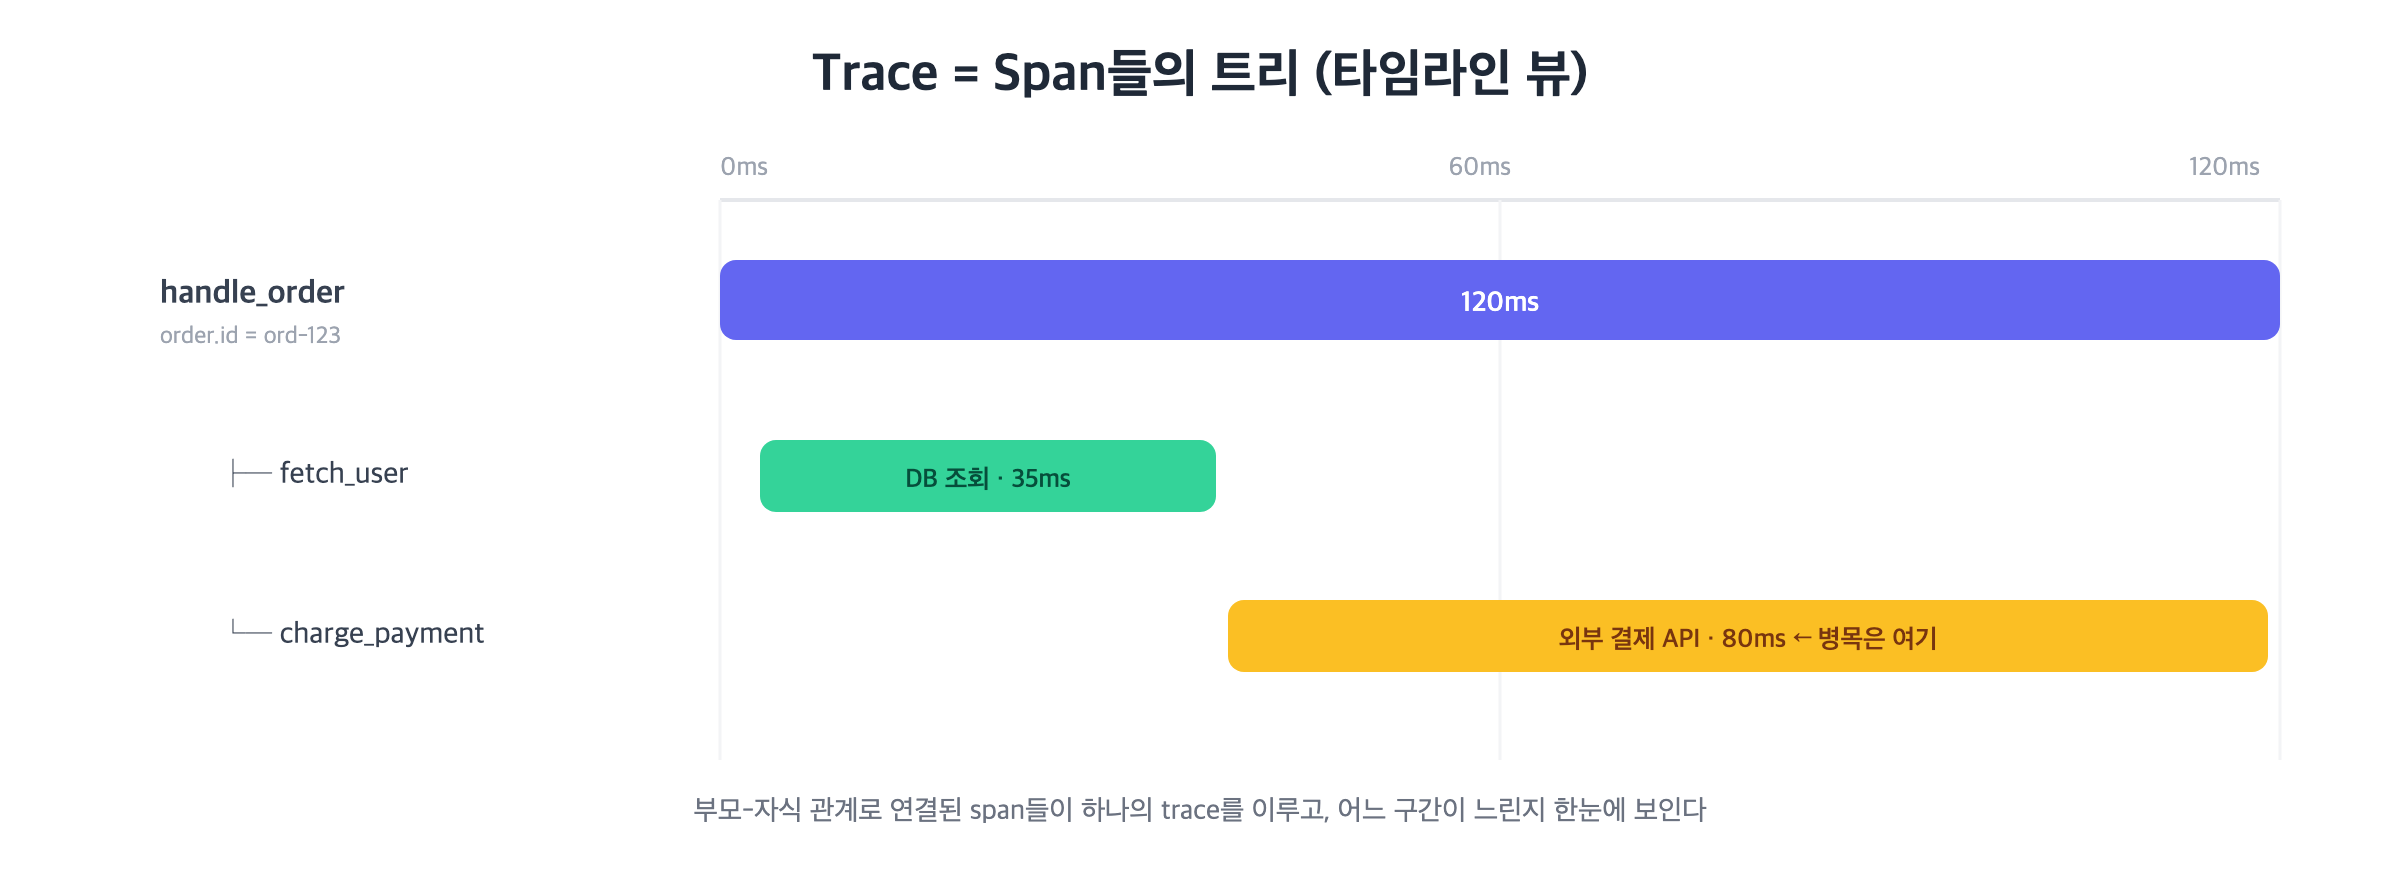
(허허 클로드코드가 이미지를 잘만들긴 하네요)
이제 "결제 구간이 전체 시간의 대부분을 잡아먹는구나"를 한눈에 알 수 있죠.
매번 span을 직접 심는 건 귀찮으니, 실무에서는 자동 계측도 많이 사용합니다.
# pip install opentelemetry-instrumentation-fastapi opentelemetry-instrumentation-requests

from opentelemetry.instrumentation.fastapi import FastAPIInstrumentor
from opentelemetry.instrumentation.requests import RequestsInstrumentor

FastAPIInstrumentor.instrument_app(app)  # 들어오는 모든 HTTP 요청이 자동으로 trace
RequestsInstrumentor().instrument()       # 나가는 외부 API 호출도 자동으로 자식 span
두 줄 넣었을 뿐인데 모든 요청이 추적됩니다. 기특합니다.
FastAPI, SQLAlchemy, Redis, requests 등 웬만한 유명 라이브러리는 전부 자동 계측이 존재하니, 직접 span을 심는 건 비즈니스 로직 구간 정도만 해주면 됩니다.
자동 계측은 어떻게 동작할까?
내 코드는 한 줄도 안 고쳤는데 어떻게 모든 요청이 추적되는 걸까요?
마법 같지만 원리는 단순합니다. 몽키 패칭(Monkey Patching)이라고 하는데, 즉 라이브러리의 원본 함수를 span으로 감싼 함수로 바꿔치기하는 것입니다.
RequestsInstrumentor().instrument()가 내부에서 하는 일을 개념 코드로 표현하면 이렇습니다.
# 실제 구현을 단순화한 개념 코드입니다

original_send = requests.Session.send  # 1) 원본 함수를 백업해두고

def traced_send(self, request, **kwargs):
    # 2) span으로 감싼 대체 함수를 만듭니다
    with tracer.start_as_current_span(f"HTTP {request.method}") as span:
        span.set_attribute("http.url", request.url)
        response = original_send(self, request, **kwargs)  # 원본은 그대로 호출
        span.set_attribute("http.status_code", response.status_code)
        return response

requests.Session.send = traced_send  # 3) 원본 자리에 슬쩍 바꿔치기
이후 앱 어디에서 requests.get()을 호출하든, 자기도 모르게 traced_send를 거치게 됩니다.
호출하는 쪽 코드는 하나도 안 바뀌었는데 모든 HTTP 호출에 span이 생기는 이유가 이것입니다.
파이썬이 런타임에 함수를 갈아끼울 수 있는 동적 언어라서 가능한 기법이지요.
FastAPI 쪽은 방식이 조금 다릅니다. FastAPIInstrumentor는 앱에 미들웨어를 끼워넣어서, 요청이 들어올 때 span을 열고 응답이 나갈 때 닫습니다. 모든 엔드포인트에 데코레이터를 일괄로 씌웠다고 생각하시면 되겠습니다.
그리고 자동 계측이 몰래 해주는 일이 하나 더 있는데, 바로 Context Propagation입니다.
이름은 거창하지만, 택배 송장번호를 생각하면 쉽습니다.
택배는 물류센터 A → 허브 → 물류센터 B로 옮겨 다니지만, 우리는 송장번호 하나로 전체 여정을 조회할 수 있습니다.
각 센터가 물건을 넘길 때 송장번호를 떼버리지 않고 그대로 붙여서 넘기기 때문이죠.
트레이스도 똑같습니다. trace ID가 송장번호이고, 서버들이 요청을 넘길 때 이 번호를 붙여서 넘깁니다.
주문 서버 A가 결제 서버 B를 호출하는 시나리오로 보겠습니다.
[서버 A — 주문 서버]
- 사용자 요청이 도착하면 A의 자동 계측이 trace를 시작하고 trace ID를 발급합니다. (송장번호
abc123발급) - A가 처리 중 결제 서버 B를 호출합니다.
requests.post("http://b서버/pay")하는 순간, 자동 계측이 나가는 요청 헤더에 송장번호를 몰래 실어 보냅니다.
POST /pay HTTP/1.1
Host: b서버
traceparent: 00-abc123-{A의 span ID}-01   ← 자동 계측이 몰래 추가한 헤더
[서버 B — 결제 서버]
- 요청이 도착하면 B의 자동 계측이 헤더부터 확인합니다. "어, 송장번호
abc123이 붙어 있네?" - B는 새 trace를 만들지 않고, 자신의 span을
abc123trace의 자식으로 등록합니다.
이제 Jaeger에서 abc123을 조회하면 A에서의 처리 구간과 B에서의 처리 구간이 하나의 타임라인으로 쭉 이어져 보입니다.
서버 세 개, 네 개를 거쳐도 마찬가지입니다. 각자 헤더를 읽고, 다음 서버로 다시 붙여서 넘기니까요.
만약 이 헤더가 없었다면 어떻게 될까요?
B는 들어온 요청을 "처음 보는 요청"으로 취급해 새 trace를 만들어버립니다.
A의 트레이스 따로, B의 트레이스 따로,, 결국 두 화면을 띄워놓고 타임스탬프를 눈으로 맞춰가며 대조하게 됩니다.
이 모든 것이 가능한 이유는 traceparent라는 헤더의 규격이 표준으로 통일돼 있기 때문입니다.
A는 Python, B는 Java로 짜여 있어도 상관없습니다. (물론 둘 다 Otel이 연동되어있어야 합니다.)
MCP 글에서 "규격을 통일하면 서로 처음 보는 시스템끼리도 대화할 수 있다"고 했던 것과 정확히 같은 이치입니다.
Langfuse란?
Langfuse는 LLM 애플리케이션 전용 오픈소스 관측 플랫폼입니다.
OTel과 달리 저장소와 UI까지 포함된 완성형 제품이구요. Docker로 셀프호스팅할 수 있어 사내망 환경에서도 사용할 수 있습니다. (민감정보를 다루는 조직에겐 이게 꽤 큽니다)
왜 LLM 앱에는 전용 도구가 필요할까?
일반 웹 서비스는 "몇 ms 걸렸나, 에러율이 몇 %인가"가 중요하지만,
LLM 앱을 운영하다 보면 궁금한 것들이 좀 다릅니다.
- 이 이상한 답변을 만들 때 정확히 어떤 프롬프트가 들어갔지?
- RAG라면 어떤 문서가 검색되어 Context로 들어갔지?
- Agent라면 어떤 도구를 어떤 순서로 호출했지?
- 토큰은 몇 개 썼고 비용은 얼마지?
- 답변 품질 점수는? 사용자 반응은?
일반 APM 도구는 이런 질문에 답을 못 해줍니다. HTTP 200 OK로 잘 끝난 요청이니까요.
LLM 앱의 장애는 500 에러가 아니라 "멀쩡하게 이상한 답변" 의 형태로 오기 때문에, 프롬프트와 응답 원문까지 들여다볼 수 있는 전용 도구가 필요합니다.
Langfuse의 구조
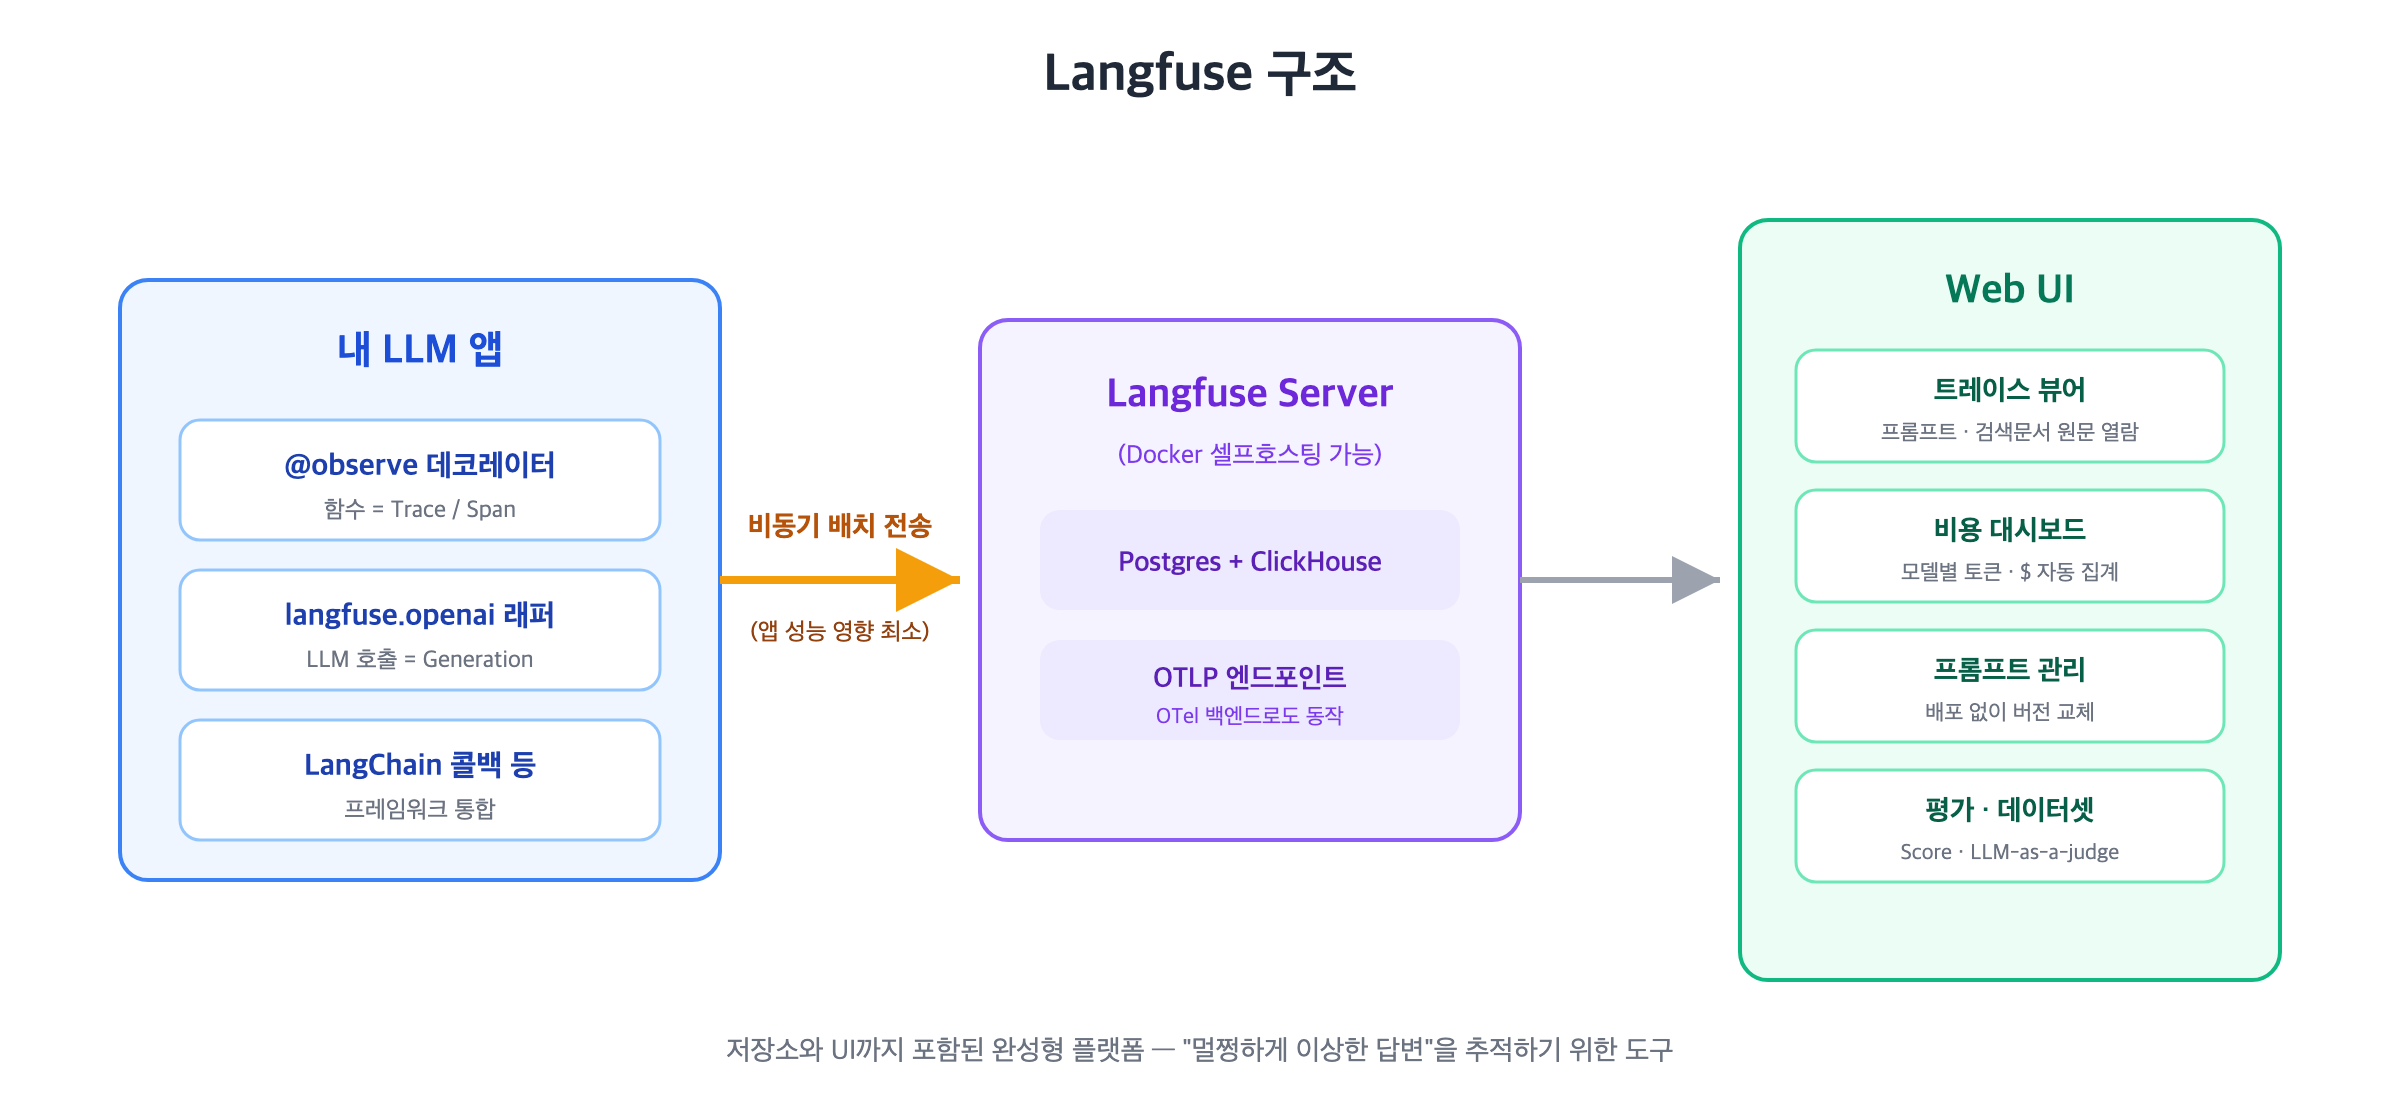
데이터 모델은 OTel과 비슷하되 LLM에 특화되어 있습니다.
- Trace : 사용자 요청 1건 (챗봇 질문 1개)
- Span : 일반 작업 단위 (문서 검색, 전처리 등)
- Generation : LLM 호출 전용 span입니다. 모델명, 입출력 메시지, 토큰 수가 기록되고 비용이 자동 계산됩니다.
- Score : 트레이스에 붙이는 품질 점수 (사용자 👍👎, LLM-as-a-judge 평가 등)
트레이싱 외에도 프롬프트 버전 관리(코드 배포 없이 프롬프트 교체), 평가용 데이터셋 관리, 비용 대시보드까지 한 플랫폼에서 제공합니다.
코드로 살펴보자
가장 쉬운 방법은 @observe 데코레이터입니다. RAG 챗봇 예시로 보겠습니다.
# pip install langfuse openai
# 환경변수 : LANGFUSE_PUBLIC_KEY, LANGFUSE_SECRET_KEY, LANGFUSE_HOST

from langfuse import observe
from langfuse.openai import openai  # OpenAI SDK의 드롭인 교체. 이거 하나로 LLM 호출이 자동 기록됩니다

@observe()  # 이 함수 전체가 하나의 Trace가 됩니다
def answer_question(question: str) -> str:
    docs = retrieve_docs(question)
    return generate(question, docs)

@observe()  # 자식 Span으로 기록
def retrieve_docs(question: str) -> list[str]:
    return vector_db.search(question, top_k=3)

@observe()
def generate(question: str, docs: list[str]) -> str:
    # langfuse.openai 래퍼 덕분에 이 호출의 프롬프트/응답/토큰/비용이 전부 자동 기록됩니다
    res = openai.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": f"참고 문서: {docs}"},
            {"role": "user", "content": question},
        ],
    )
    return res.choices[0].message.content

answer_question("환불 규정이 어떻게 되나요?")
이렇게만 해두면 Langfuse UI에서 트레이스가 이렇게 보입니다. (Langfuse 공식 데모 화면입니다)
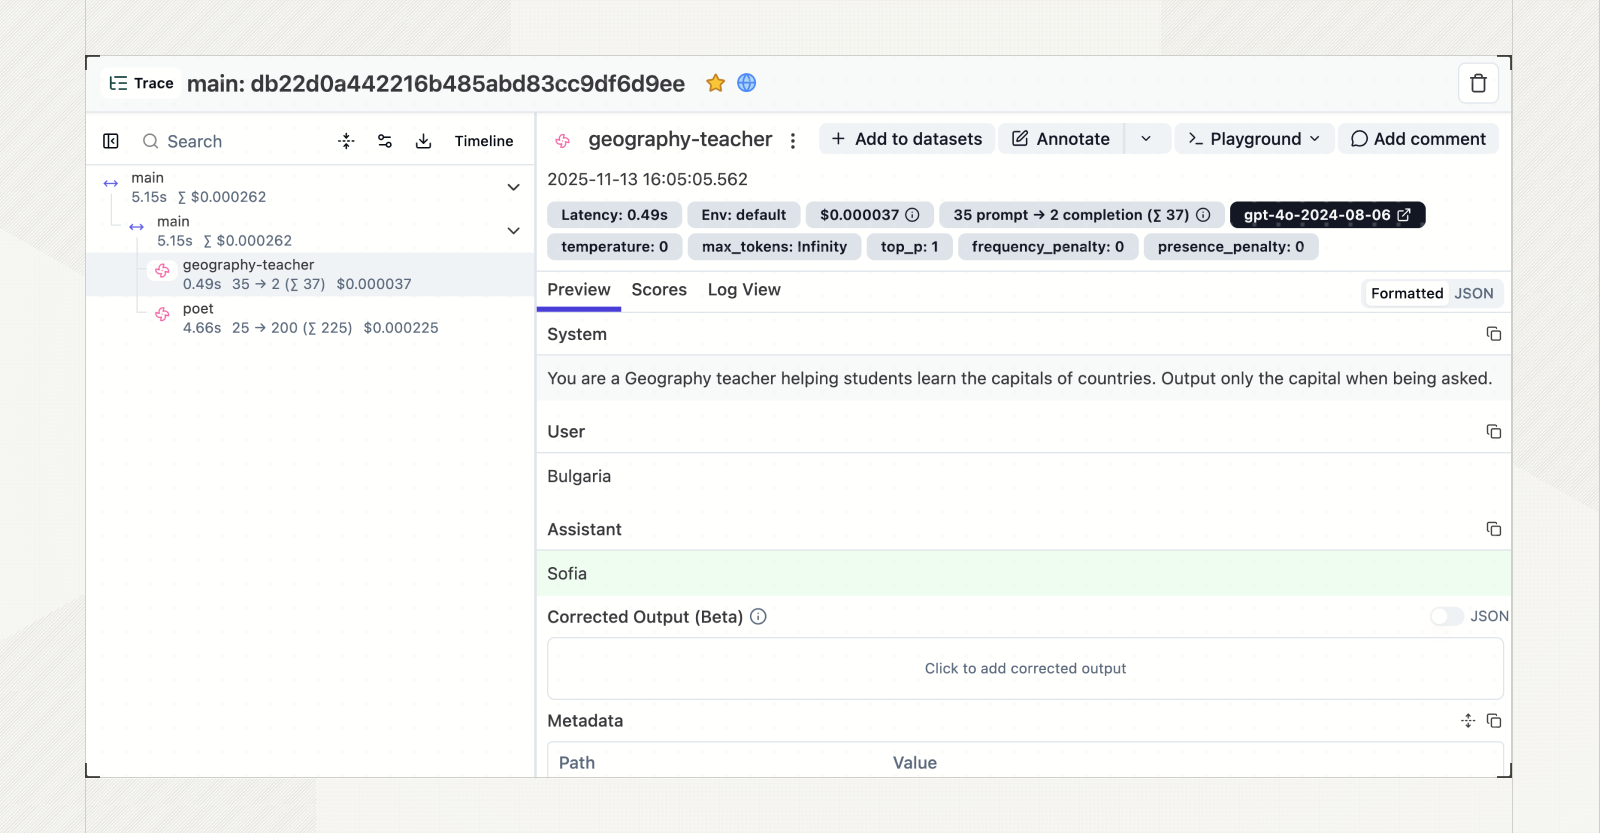
왼쪽에는 트레이스가 span 트리로 펼쳐지고, 각 항목마다 소요시간 / 토큰 수 / 비용이 붙어 있습니다.
Generation을 클릭하면 오른쪽처럼 모델명, 파라미터, 그리고 LLM에 실제로 들어간 System/User 메시지 전문과 응답까지 전부 확인할 수 있습니다.
저희 RAG 예시라면 retrieve_docs span에서 검색된 문서 3건의 실제 내용도 같은 방식으로 열어볼 수 있겠죠.
"이 답변 왜 이래?"라는 질문에 대해, 검색이 문제였는지 프롬프트가 문제였는지를 트레이스만 보고 판단할 수 있게 되는 것이지요.
사용자 피드백을 점수로 남기는 것도 간단합니다.
from langfuse import get_client

langfuse = get_client()
langfuse.score_current_trace(name="user-feedback", value=1)  # 👍 = 1, 👎 = 0
이렇게 쌓인 점수들로 "지난주 배포 이후 👎 비율이 늘었나?" 같은 질문에 답할 수 있습니다.
둘은 경쟁 관계일까?
여기까지 읽으면 "그래서 둘 중 뭘 써야 하나?"라는 생각이 드실 텐데,
사실 Langfuse는 OTel 위에 지어져 있습니다.
Langfuse SDK(v3부터)는 내부적으로 OTel 표준으로 트레이스를 만들고,
Langfuse 서버는 OTLP를 받아주는 OTel 백엔드이기도 합니다.
그래서 이미 OTel로 계측된 앱이 있다면, 환경변수만 바꿔서 Langfuse로 보낼 수도 있습니다.
import base64, os

LANGFUSE_AUTH = base64.b64encode(
    f"{os.environ['LANGFUSE_PUBLIC_KEY']}:{os.environ['LANGFUSE_SECRET_KEY']}".encode()
).decode()

os.environ["OTEL_EXPORTER_OTLP_ENDPOINT"] = "https://cloud.langfuse.com/api/public/otel"
os.environ["OTEL_EXPORTER_OTLP_HEADERS"] = f"Authorization=Basic {LANGFUSE_AUTH}"
# 이제 표준 OTel SDK가 만든 span들이 Langfuse에 쌓입니다
인프라 트레이스(FastAPI, DB 쿼리)와 LLM 트레이스(프롬프트, 토큰)가 한 화면에 합쳐지는 것이죠.
정리하면 이렇게 선택하시면 되겠습니다.
| 상황 | 선택 |
|---|---|
| 마이크로서비스/인프라 전반의 성능·에러 추적 | OTel + Jaeger/Grafana/Datadog |
| LLM 앱의 프롬프트·비용·품질 디버깅 | Langfuse |
| LLM 앱인데 인프라 트레이싱도 필요 | OTel로 계측하고 백엔드를 Langfuse로 |
경험상 RAG나 Agent를 운영한다면 Langfuse를 먼저 붙이는 것을 추천합니다.
데코레이터 몇 개로 시작할 수 있는데, "이 답변이 왜 이렇게 나왔지?"를 추적하는 시간이 극적으로 줄어듭니다.
로그 파일에서 프롬프트를 grep으로 찾아 헤매던 시절로는,, 돌아갈 수 없습니다.
'
'
'
OpenTelemetry와 Langfuse에 대해 알아봤습니다.
개발을 하다보면 로그 확인 및 분석이 많은 시간을 차지하는 만큼, 관측성에 대해서는 익숙해지는 게 좋을 것 같습니다.
틀린 부분이 있다면 언제든 댓글 부탁드립니다.
감사합니다 !