반갑습니다.
오랜만에 인사드립니다.
잠시 블로그 작성을 쉬어가는 동안, 개인적으로 많은 성장의 시간을 가졌습니다.
이제는 어디 가서 어엿한 실무 AI Engineer라고 스스로를 소개할 수 있을 듯 하네요.
그동안 저는 20곳 이상의 대기업 및 공공기관의 다양한 도메인 문서를 바탕으로 RAG 기반 에이전트 PoC, BMT를 개발해 왔습니다. 감사하게도 많은 경쟁 속에서 제 RAG Agent가 높은 평가를 받아 다수의 사업 수주에 기여하는 성과도 거두었습니다.
이번 글에서는 제가 현업에서 직접 부딪히며 쌓아온 RAG 최적화 노하우를 나누고자 합니다. 많은 AI 엔지니어 분들이 실무에서 RAG 파이프라인을 구축하며 한 번쯤 겪어보셨을 치열한 고민과 그 해결책들을 담았습니다. 이 글이 여러분의 프로젝트에 작은 실마리가 되기를 바랍니다.
이번 글에서는 Vector DB 구축에 대해서 다룹니다.
Vector DB 구축
일반적으로 RAG 시스템은 문서 검색을 위한 VectorDB를 구축한 뒤 개발됩니다.
해당 Section에서는 Vector DB의 구축 과정에 대해 설명합니다.
Vector DB?
Vector DB는 질문과 유사도가 높은 문서 Chunk를 제공하는 역할을 담당합니다.
Weaviate, Milvus, ChromaDB, Faiss 등이 존재하죠.
청크 벡터가 100~1000개정도라면 질문 벡터와 청크 벡터간에 코사인 유사도를 전부 검색한 뒤 내림차순으로 정렬하겠지만, 1억개와 같이 큰 경우에는 매 검색마다 이를 전부 검색하기 어렵기 때문에 자주 쓰이는 VDB들은 ANN(Approximate Nearest Neighbor) 알고리즘으로 검색합니다.
아주 많은 Chunk들을 비슷한 벡터를 갖는 N개의 Cluster로 구분한 뒤 질문 벡터와 유사한 Cluster에서 유사도를 검색하는 방법입니다.
위에서 설명드린 VDB들은 Vector 검색 뿐만 아니라 TF-IDF, BM25와 같은 키워드 기반 검색 모듈도 내장하고 있는 경우가 많습니다.
일반적으로 키워드 기반 검색 Score와 유사도 기반 검색 Score를 가중합하여 최종 Score를 계산하는 하이브리드 검색 기법을 많이 사용합니다.
한국어의 경우에는 VDB에 내장돼 있는 기본 Tokenizer로는 한국어 문장을 제대로 분리하지 못해 키워드 기반 검색 품질이 떨어지기에 Kiwi, KoNLPy와 같은 한국어 형태소분석기의 Tokenizer를 활용하여 검색 품질을 개선하곤 합니다.
키워드 검색에서 한국어 검색 품질이 떨어지는 예시
Q. 인공지능은 어렵다
- BPE Tokenizer : 인공지능 / ##은 / 어렵 / ##다
-> ##은 혹은 ##다 와 같은 토큰이 많이 겹쳐 가중치가 심하게 올라감 - 띄워쓰기 기반 토크나이저 : 인공지능은 / 어렵다
-> 인공지능이, 인공지능에, 인공지능의 등의 유사 단어와 매칭이 하나도 안돼서 가중치가 심하게 내려감 - 형태소 분리 : 인공지능(명사) / 은(조사) / 어렵(형용사) / 다(어미)
-> 인공지능 이라는 명사가 분리되므로 올바른 Scoring 가능. 조사, 어미 등을 제외하는 커스터마이징을 거치면 검색 품질을 좀 더 개선 가능
문서 파싱
사실상 VectorDB 구축에서 가장 어려운 부분입니다.
이세상 문서를 모두 완벽하게 파싱하는 것은 아직까지도 풀리지 않은 문제입니다.
최근 들어서는 딥러닝 모델들을 활용하여 95% 이상의 문서들을 정복했지만, 남은 5%가 많은 어려움을 가져다주죠.
문서의 종류
문서들을 완벽히 파싱하기 위해서는 문서의 기본적인 구조는 알아두는 것이 유용합니다.
- .pdf : element의 좌표만 존재합니다. (x,y) 좌표에 무엇이 있는지만 작성돼 있습니다.
- .docx, .hwpx, .pptx : 확장자 뒤에 'x'로 끝나는 문서들은 xml구조로 구성된 문서입니다. 폰트, 텍스트, 이미지 등이 하나의 압축파일로 저장돼 있으며, 파싱이 쉽습니다.
- hwp : 한컴의 독자 규칙에 따라 바이너리 데이터로 뭉쳐져 있는 문서입니다. 한컴에서 개발한 모듈을 거치지 않으면 100% 파싱이 어렵습니다. 최근에는 hwp 파서가 오픈소스로 많이 풀리는 추세입니다.
문서별 파싱 전략
다양한 문서들은 어떤 방식으로 파싱해야 할까요 ?
.pdf : 파이썬을 기준으로 Pymupdf와 같은 라이브러리를 활용하면 PDF 문서를 쉽게 가져올 수 있습니다.
Pymupdf 라이브러리는 pdf의 문자와 좌표를 쭉 가져온 뒤, 잘 규정해 놓은 Rule을 기반으로 띄워쓰기인지 문단이 나눠져 있는지 등을 파악해 Document 객체로 변환하여 사용자가 활용하기 쉬운 인터페이스를 제공합니다.
docx, pptx : Unstructured 라이브러리는 PPTX 파일 혹은 DOCX 파일 등의 내부 xml 구조를 파싱하여 사용하기 쉬운 형태의 데이터로 제공해줍니다.
hwpx : hwpx 내부 xml 문서를 파싱하여 활용합니다. 직접 개발할 수도 있고, 오픈소스를 탐색해서 활용할 수도 있습니다. pdf로 변환한 뒤 pdf 처리 로직을 태울 수도 있겠습니다.
hwp : hwp 파일은 방법이 여러가지가 있을 수 있는데,
1. 한글과컴퓨터로 들어가 hwpx로 내보내기 : 문서가 아주 많은 경우 번거롭습니다.
2. 직접 개발하기 : https://tech.hancom.com/python-hwp-parsing-1/ 한컴 테크에서 파싱 과정에 대한 설명이 자세히 기록돼 있습니다.
3. 오픈소스 활용하기 : 다양한 오픈소스가 존재합니다. Libreoffice와 같은 다른 플랫폼을 활용하거나, 깃허브에 존재하는 오픈소스 등이 있겠습니다. 다만 이 경우 파싱 결과가 만족스럽지 못할 수도 있습니다.
문서 파싱 예시
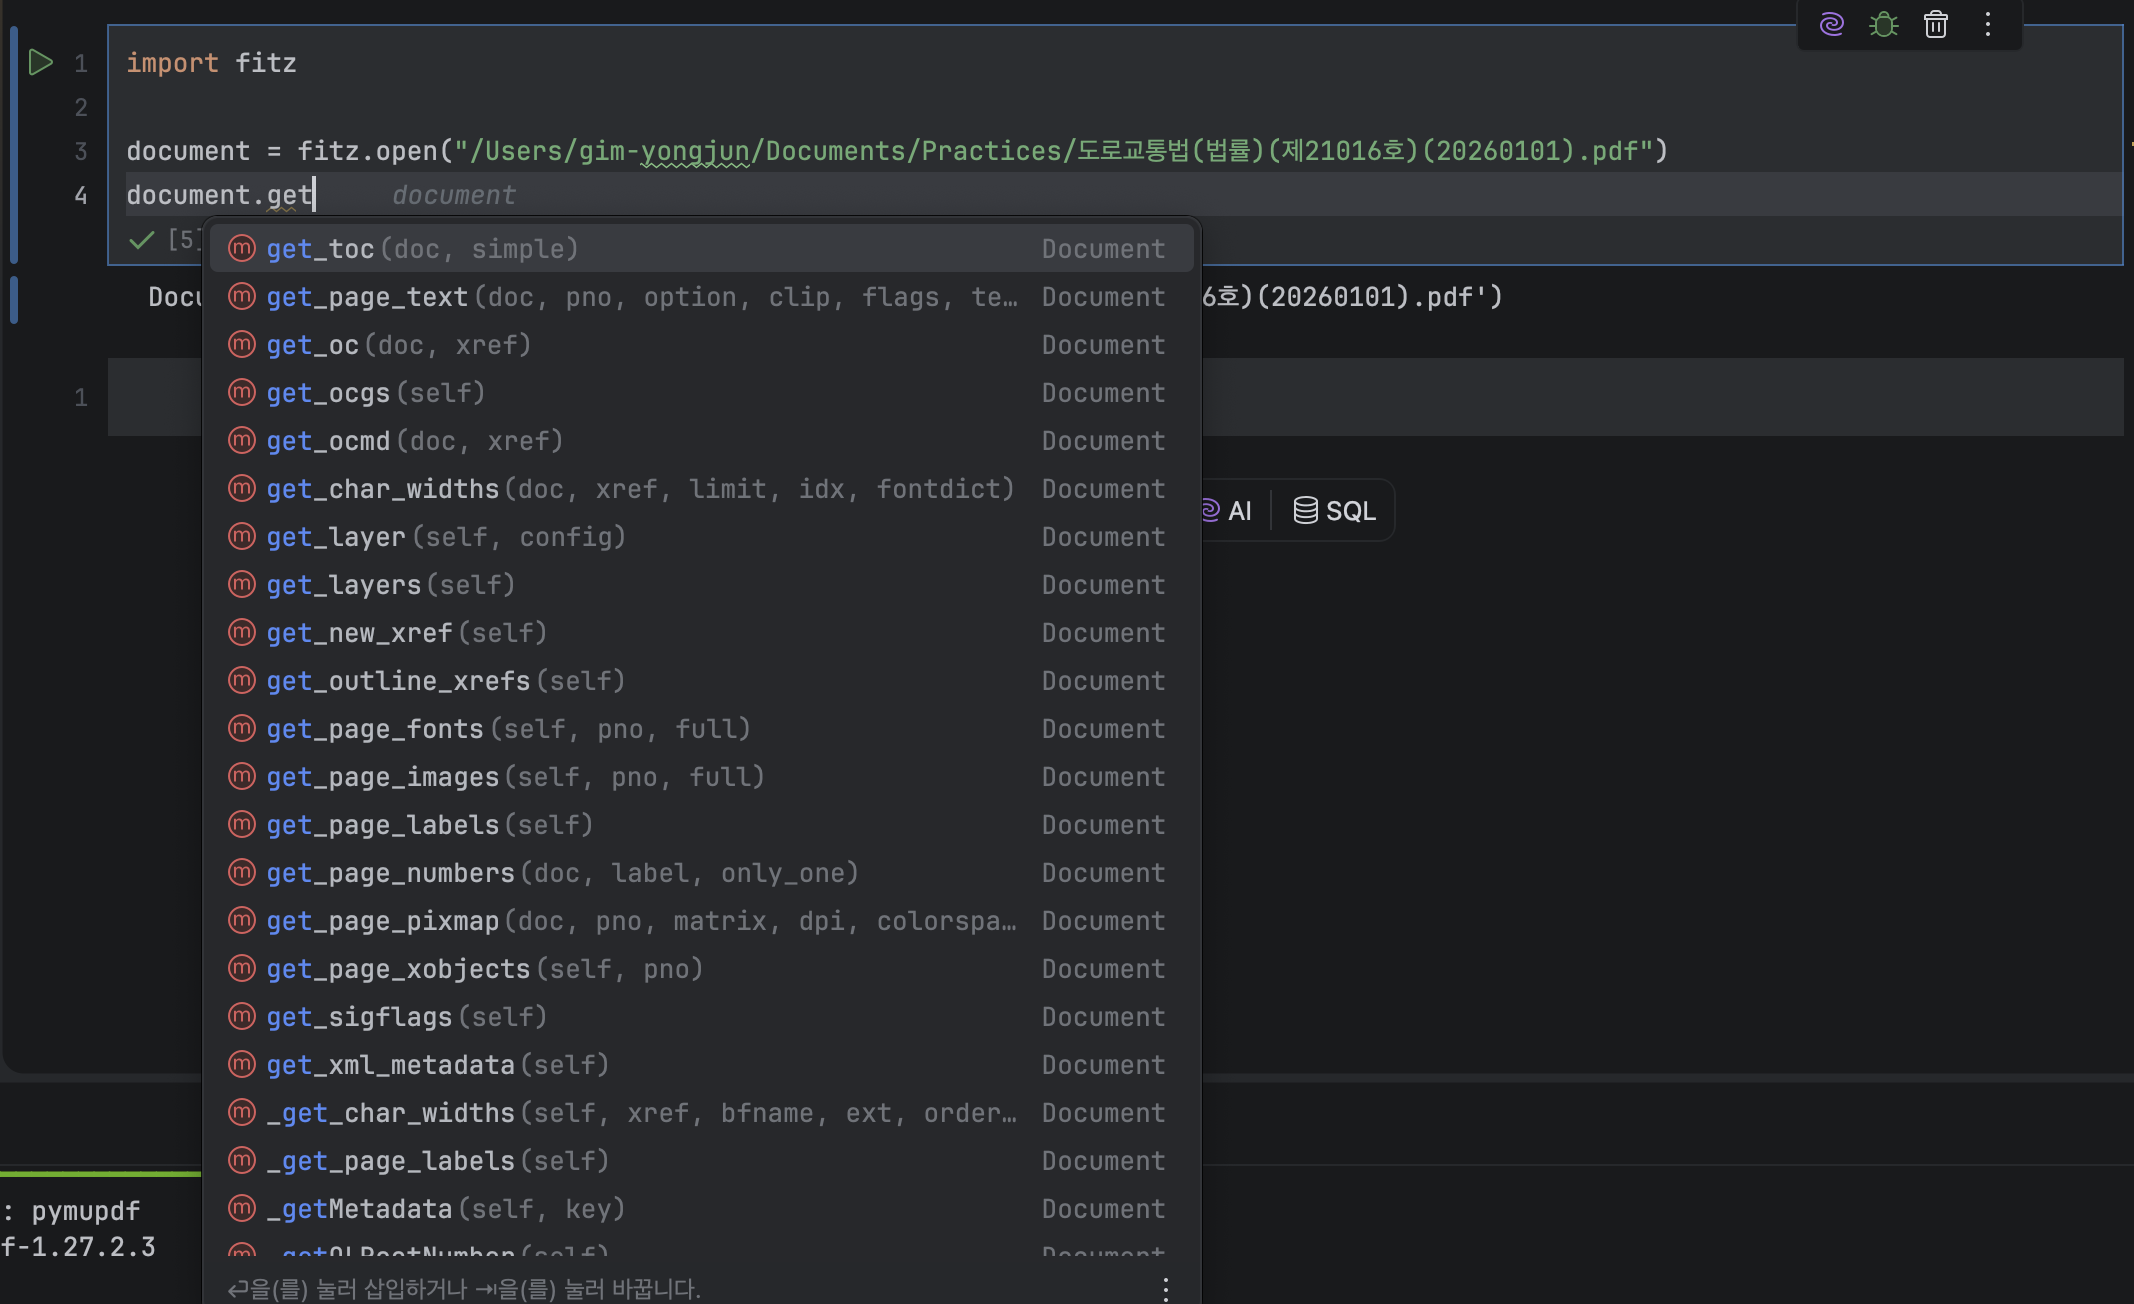
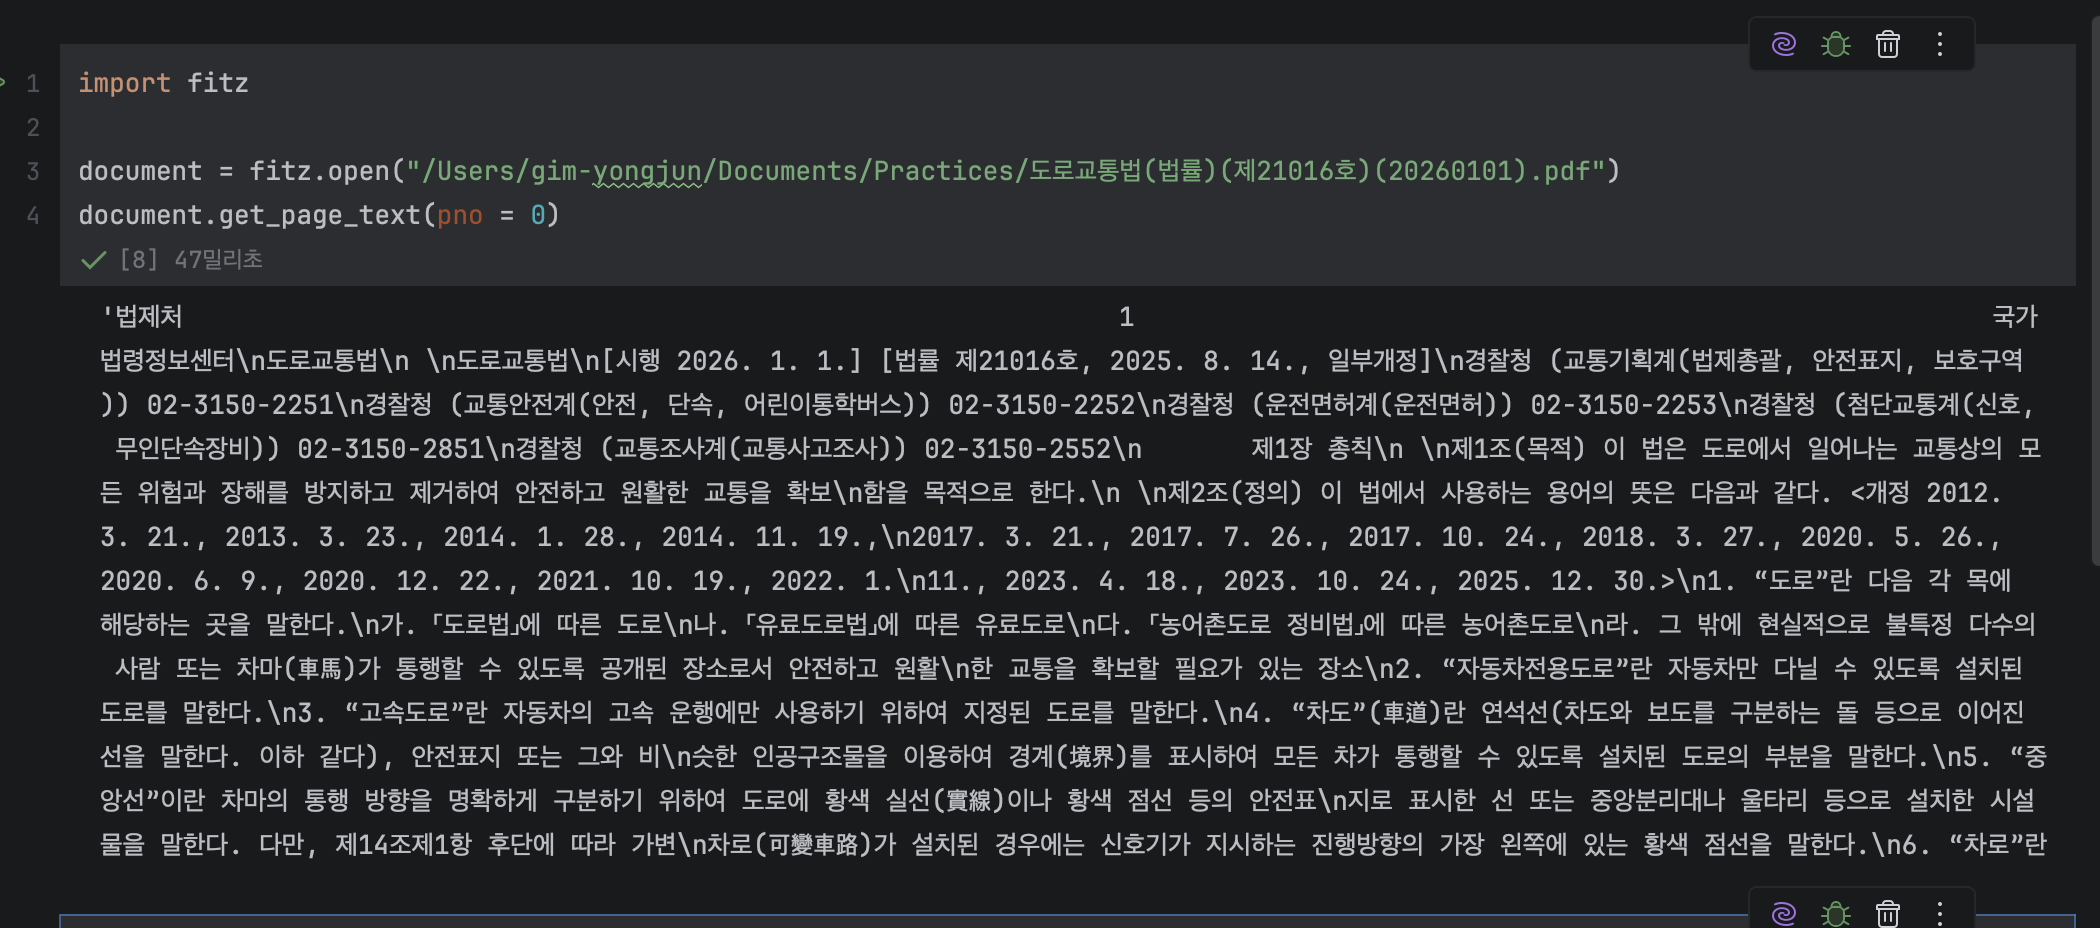
위 예시는 Pymupdf 라이브러리를 활용한 PDF 문서 파싱 과정입니다.
Pymupdf는 사진처럼 아주 다양한 모듈을 제공하며, 해당 모듈을 활용해서 페이지별로 Text를 추출하거나 메타데이터 등을 가져올 수 있습니다.
위에서 소개한 라이브러리들은 대부분 문서 내부의 데이터를 바탕으로 파싱하는 방법들입니다.
이러한 방법들은 결국 rule 기반으로 동작하기에 모든 케이스에서 적절하게 동작하지 않습니다. 예외가 존재하죠. 이러한 문제점들을 해결하기 위해서는 딥러닝 모델 기반의 파서를 활용하는 것이 좋습니다.
딥러닝 모델 기반 문서 파싱
AI 모델을 활용해서 문서를 파싱하는 방법입니다.
최근 퀄리티 높은 RAG를 구성할 때 필수적으로 활용하는 파싱 방법입니다.
문서를 이미지로서 AI 모델에게 입력하여 구성 요소, 읽을 순서 등을 추출하여 활용합니다.
딥러닝 모델들은 오픈소스 모델들도 많이 존재하지만, 문서 처리를 전문으로 하는 기업의 경우 독자적인 모델을 개발하여 프로덕트로서 판매하기도 합니다.
업스테이지, 자유소프트, 악어디지털과 같은 기업들의 Document Parser가 그 예시입니다.
낱개 문서의 경우 일정 비용을 내고 API를 호출하여 활용하는 것이 가장 간편할 수 있습니다.
AI 모델 문서 파싱 과정
AI 모델을 활용한 문서 파싱에서는 다양한 모델들이 파이프라인으로 연결되어 하나의 결과물을 내보냅니다.
모델이 활용되는 부분은
- 레이아웃 분석(Layout Detecting)
- 텍스트/이미지 추출(OCR)
- 읽기 순서(Reading Order) 예측
- 테이블 복원(Table Former)
정도가 대표적입니다.
순서는 Layout Detecting -> OCR/Table Former -> Reading Order 순으로 진행됩니다.
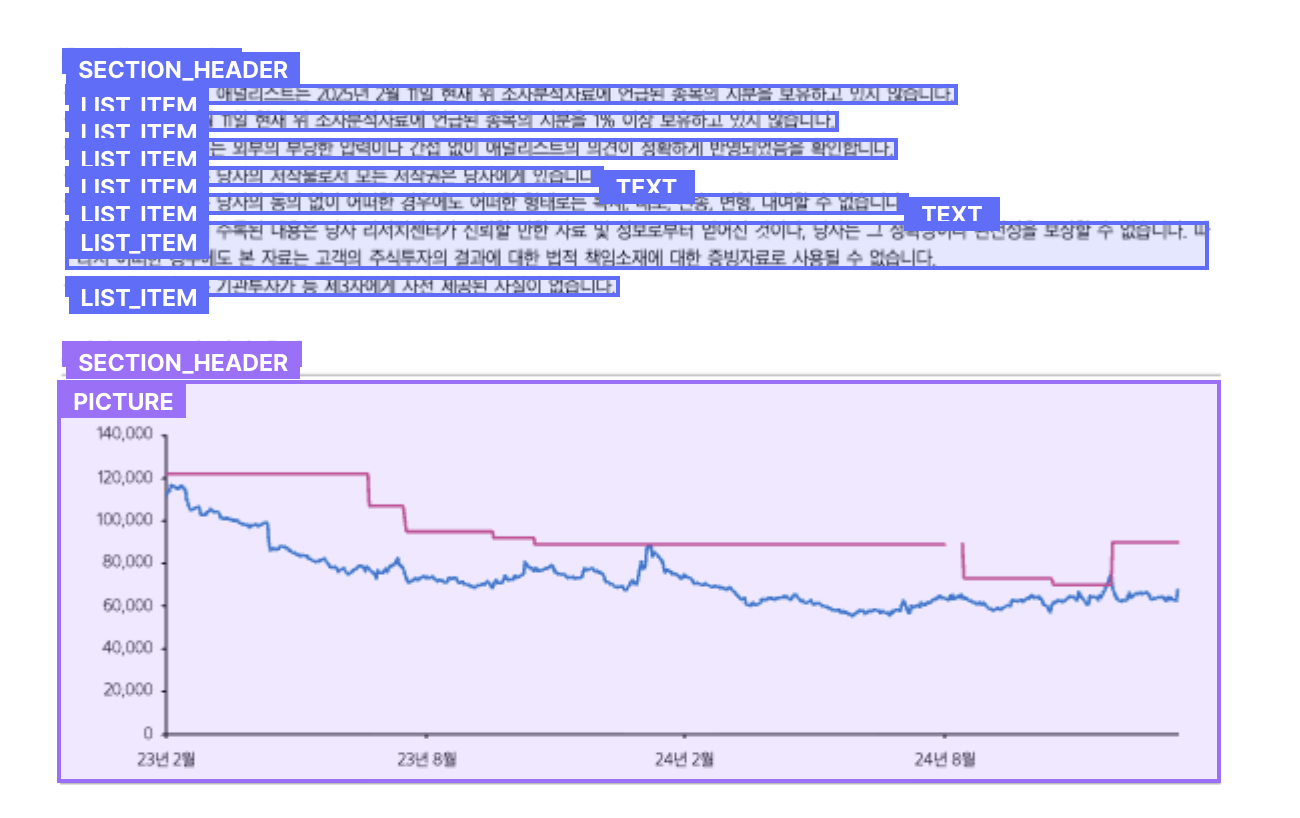
다음과 같이 문서의 각 부분이 어떤 구성요소인지 식별하는 과정을 거칩니다.
레이아웃 모델은 이미지를 입력받아 Classification을 수행합니다.
- Text
- Table
- Picture
- Equation
- Chart
등이 있습니다. (이보다 훨씬 많은 Tag가 존재합니다.)
문서의 구성 요소가 무엇인지 정확하게 추출한다면 이후 딥러닝 모델(OCR, Table Former)들을 통해 각 구성요소별로 Text, Table 데이터를 추출합니다.
이렇게 두가지의 과정을 거치면 파서마다 다르겠지만
Doc(tag="text", data="2년간 목표주가 변경 추이", "coordinate" : [(x1,y1),(x2,y2)..] ...)
Doc(tag="table", data="| 본부명 | 팀명 | 파트명 |\n| :--- | :--- | :--- |\n| AI Core | Part1 | Agent Engineer |", "coordinate" : [(x3,y3),(x4,y4)..] ...)
Doc(tag="image", data="data:image/png;base64,iVBOR ...", "coordinate" : [(x5,y5),(x6,y6)..] ...)
...
와 같은 데이터 구조로 가져올 수 있습니다. 이런 작은 문서 조각들은 이후 Chunking 과정에서 활용될 수 있습니다.
문서의 Layout을 파악하고 구성요소들의 의미를 잘 추출했다면, Reading Order(읽기 순서) 모델이 문서의 순서를 파악합니다.
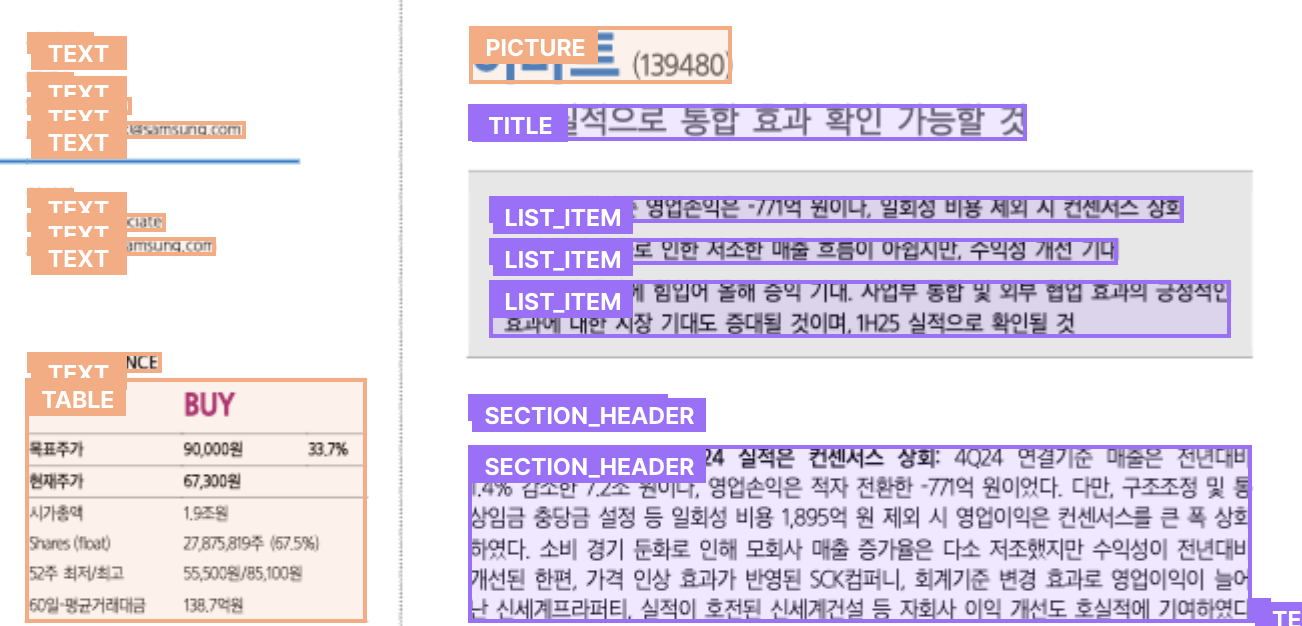
위 사진처럼 좌 우가 나뉘어져 있는 문서들은 어느 부분부터 읽는 것이 알맞는 순서인지 알아야 할 필요가 있습니다.
2단 문서 기준으로
1 2
3 4 로 읽어야 할지
1 3
2 4 로 읽어야 할지를 파악하여
1-2-3-4 / 1-3-2-4 처럼 한줄로 펼치는 작업을 수행합니다.
Reading Order는 아직까지도 완전하지 않은 경우가 많습니다. 왜냐하면 똑같은 구조의 2단 문서라도 어느 문서에서는 1-2-3-4로 읽고, 또 다른 문서에서는 1-3-2-4로 읽기도 하기 때문입니다. 그래서 어차피 완전하게 할 수 없다면 아예 모델을 통과시키지 않고 좌표 위치에 따라 휴리스틱하게 Reading Order를 계산하도록 하기도 합니다.
이렇게 Reading Order까지 수행했다면 AI 모델을 활용한 문서 파싱 과정이 전부 완료됩니다.
문서 파싱 후처리
경우에 따라 Layout Detector가 매핑한 테이블 / 수식 / 제목 / 차트 등에 추가적인 모델을 통과시키거나 개발한 로직을 적용시킬 수도 있습니다.
테이블의 경우 테이블 이미지를 입력받아 마크다운, HTML 형태로 내보내는 모델을 적용시키거나 LLM에게 전달하여 원하는 형태로 내보내도록 합니다.
마크다운은 직관적으로 알아볼 수 있고 내보내는 글자수가 적다는 장점이 있지만, 2단테이블, 3단테이블과 같은 어려운 테이블 형태에는 대처하기 어렵다는 단점이 존재합니다.
대처법으로는 행 안에 삽입되는 테이블을 밖으로 빼고, 그 자리에 표시를 하는 형태로 구현할 수 있습니다.
예시)
| 이름 | 직책 | 연차 | 조직 |
|---|---|---|---|
| 김용준 | AI 엔지니어 | 2년 | {table_1} |
{table_1}
| 본부명 | 팀명 | 파트명 |
|---|---|---|
| AI Core | Part1 | Agent Engineer |
테이블을 HTML로 내보낼 경우에는 다양한 테이블 형태를 표현할 수 있지만, 글자 수가 많아 Chunk Text에 추가할 경우 임베딩 과정에서 Chunk의 의미가 제대로 담기지 않을 수 있습니다.
LLM을 활용해 원하는 형태를 내보내도록 프롬프팅하여 결과를 받아볼 수도 있습니다.
테이블 내에서 매출 column이 존재하면 따로 표시하도록 한다던가, 개인정보는 표기하지 않도록 하는 등의 예시가 있겠네요.
이미지의 경우에는 VLM을 활용해 Image Description을 작성하도록 하여 이미지 검색을 가능하도록 할 수도 있으며, 차트의 경우 Image Description 뿐만 아니라 차트 내부의 데이터를 Text로 내보내도록 프롬프팅할 수도 있습니다. 이 경우에는 VLM의 성능이 좋을 수록 차트의 수치들을 더 잘 표현합니다.
AI 모델 기반 파싱 오픈소스는
Docling
Llama Index
가 대표적입니다.
제가 사용해본 건 Docling인데
from docling.document_converter import DocumentConverter

source = "https://arxiv.org/pdf/2408.09869"
converter = DocumentConverter()
doc = converter.convert(source).document
print(doc.export_to_markdown())
다음과 같은 간단한 코드로도 수준 높은 파싱 결과를 받아볼 수 있습니다.
위 결과는 Layout Detecting, OCR, Reading Order 등의 모델이 적용된 결과입니다.
Layout Detecting으로 감지된 이미지는 base64로 활용할 수 있으며 파싱 결과는 markdown, html 등으로 내보낼 수 있어 활용성이 높습니다.
원하는 모델(VLM 포함)을 사용하거나 파이프라인 과정을 추가 / 삭제할 수 있어 확장성도 높다고 볼 수 있겠네요.
다만 AI 모델로 파싱을 수행하다 보니 기존 rule 기반 라이브러리보다는 속도가 느릴 수 있습니다.
.
.
.
여기까지 RAG 파이프라인 개발과정 중 문서 파싱에 대해서 다뤄봤습니다.
오랜만에 글을 쓰다보니 잘 썼는지 모르겠네요.
혹시라도 글에서 틀린 부분이 있다면 편하게 말씀 부탁드립니다.
다음 글에서는 Semantic Chunking에 대해서 다뤄보겠습니다.
감사합니다 !