자바/파이썬 : Heap(우선 큐)/ 계수, 위상 정렬, 병합 정렬
Heap 정렬 : 자료 구조를 사용 (최대 및 최소값 -> 힙정렬)
주어진 데이터를 먼저 정렬해야 한다.
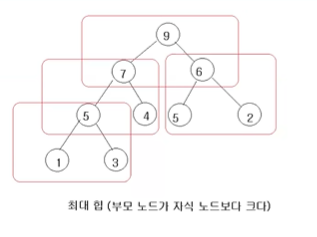
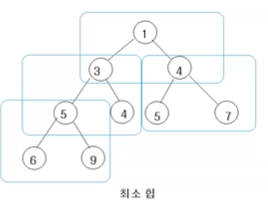
* 힙 => 특정 규칙이 있는 트리이다.
그러나 특정 값을 찾아야 하는 경우에는 그리드, 벨만, 프림을 사용한다.
최대힙과 최소힙은 노드의 트리의 기준 무조건 루트 노드이다
최대 힙 (부모 노드가 자식 노드보다 크다)
최소 힙 (부모 노드가 자식 노드보다 작다)
힙 구축하는 방법(최대 힙) => 트리를 이용하여 구축한다.
meaxHeap() , maxHeapify() 이러한 메서드를 이용한다고 가정
1 현재(부모) 노드와 자식 노드의 값을 비교
- 현재(부모) 노도의 값이 가장 크지 않으면 자식 노드 중 가장 큰 값과 현재 노드의 값을 바꿉니다.
- 만약에 자식 노드가 없거나 현재 노드의 값이 가장 크면 연산 종료
2 맞바꾼 자식 노드의 위치를 현재 노드로 하여 과정 1번을 반복한다.
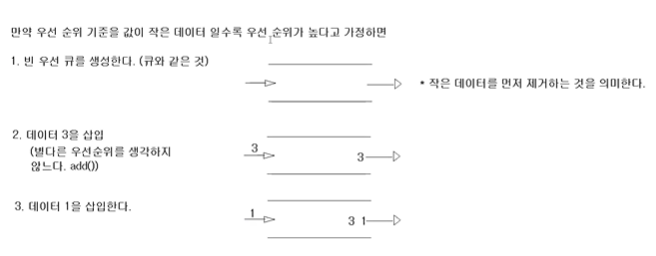
우선 큐 => 우선 순위가 높은 데이터 부터 처리하는 큐이다.
만약 우선 순위 기준을 값이 작은 데이터 일수록 우선 순위가 높다고 가정하면
1 빈 우선 큐를 생성한다. (큐와 같은 것)
2 데이터 3을 삽입
(별다른 우선순위를 생각히자 않는다 add())
트리에서 데이터가 중복 됐을 때, 완전 이진 탐색에서 배웠던
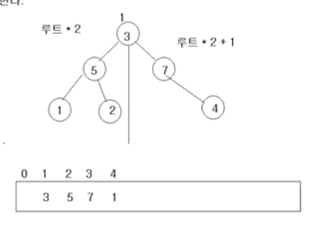
✅ 중복 데이터 처리 방법
1. 중복은 왼쪽(Left)에 저장
조건: if (data <= current.value) → 왼쪽 서브트리로
특징: 같은 값이 여러 개 있으면 트리 왼쪽에 계속 누적됨
정렬 시: 중복 값이 앞쪽에 위치함
- 중복은 오른쪽(Right)에 저장
조건: if (data < current.value) → 왼쪽, else → 오른쪽
특징: 중복 값이 트리 오른쪽으로 쌓임
정렬 시: 중복 값이 뒤쪽에 위치함
import java.uitl.PriontiyuQueue;

public class Soultion{
	public static void main(String[] arg) {
    	// 비어있는 우선 큐 생성 (객체 생성)
        PriorityQueue<Integer> pq = new PriorityQueue<>();
        // 값을 pq라는 우선 큐에 삽입

        pq.add(10);
        pq.add(5);
        pq.add(20);
        pq.add(1);

        // 우선 큐의 상태 출력
        Sysytem.out.println(pq);

        for(int i : pq){
        Sysytem.out.println(i+ " "); [1 5 10 20]
        }
        Sysytem.out.println();

        Sysytem.out.println(pq.poll());
        Sysytem.out.println(pq);
        Sysytem.out.println(pq.poll());
        Sysytem.out.println(pq);
    }
}
"Hello" => 오름 차순 'e','h','l','l','o'
문자열을 문자로 변환 해주는 메서드 charAt(), Comparator
짧고 강력하게!