1. 횡단 관심사라는 문제
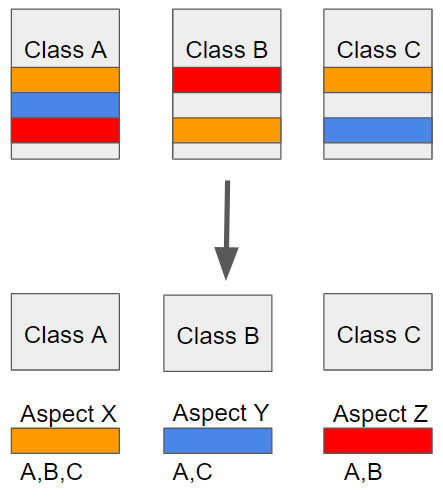
OrderService, PaymentService, MemberService가 있고, 셋 다 실행 시간을 로그로 남기고 싶다고 하자. 로깅이라는 요구사항 자체는 셋 모두에게 똑같이 적용되지만, 이 로깅 코드는 각 서비스의 "진짜 하는 일"(주문 처리, 결제, 회원 관리)과는 아무 상관이 없다.
class OrderService {
    void placeOrder(Order order) {
        long start = System.currentTimeMillis();
        // ... 주문 처리 로직
        log.info("placeOrder 소요시간: {}ms", System.currentTimeMillis() - start);
    }
}

class PaymentService {
    void pay(Order order) {
        long start = System.currentTimeMillis();
        // ... 결제 로직
        log.info("pay 소요시간: {}ms", System.currentTimeMillis() - start);
    }
}
이런 코드를 핵심 관심사(Core Concern)와 횡단 관심사(Cross-cutting Concern)로 나눠 부른다. "주문을 처리한다", "결제를 한다"는 각 클래스 고유의 핵심 관심사고, "실행 시간을 잰다"는 클래스 경계를 가로질러(cross-cutting) 여러 곳에 반복되는 부가 관심사다. 로깅, 트랜잭션, 보안, 캐싱이 전형적인 예다.
문제는 이 두 관심사가 코드 레벨에서는 물리적으로 뒤섞인다는(tangling) 점이다. placeOrder 메서드 하나를 열어보면 "주문 처리"와 "시간 측정"이 같은 메서드 본문에 나란히 앉아 있다. 그리고 이 로깅 코드는 대상 클래스 수만큼 반복된다(scattering).
JDK Dynamic Proxy/CGLIB는 "프록시 클래스를 반복해서 만드는" 문제는 풀었지만, "이 메서드엔 로깅을 걸고 저 메서드엔 안 건다"는 판단은 여전히 사람이 InvocationHandler 안에 조건문으로 써야 했다. AOP가 없애려는 게 바로 이 마지막 반복이다.
2. AOP의 핵심 개념
AOP는 횡단 관심사를 하나의 모듈(Aspect)로 뽑아내고, 그 모듈을 "어디에" "언제" 적용할지를 코드가 아니라 선언으로 지정한다. 용어가 여러 개 나오는데, 하나씩 정리하면 이렇다.
| 용어 | 의미 |
|---|---|
| Aspect | 횡단 관심사를 모듈화한 것. Advice + Pointcut의 묶음 |
| Advice | 실제로 실행되는 부가 기능 코드 자체. "언제"(Before/After/Around) 실행되는지에 따라 종류가 나뉜다 |
| Pointcut | Advice를 적용할 대상을 고르는 규칙. "어떤 메서드에 적용할지"를 표현식으로 지정 |
| JoinPoint | Advice가 적용될 수 있는 실행 지점. Spring AOP에서는 메서드 실행이 유일한 JoinPoint다 |
| Target | 실제 부가 기능이 적용되는 원본 객체. |
| Weaving | Aspect를 Target에 실제로 적용해서 프록시를 만드는 과정 |
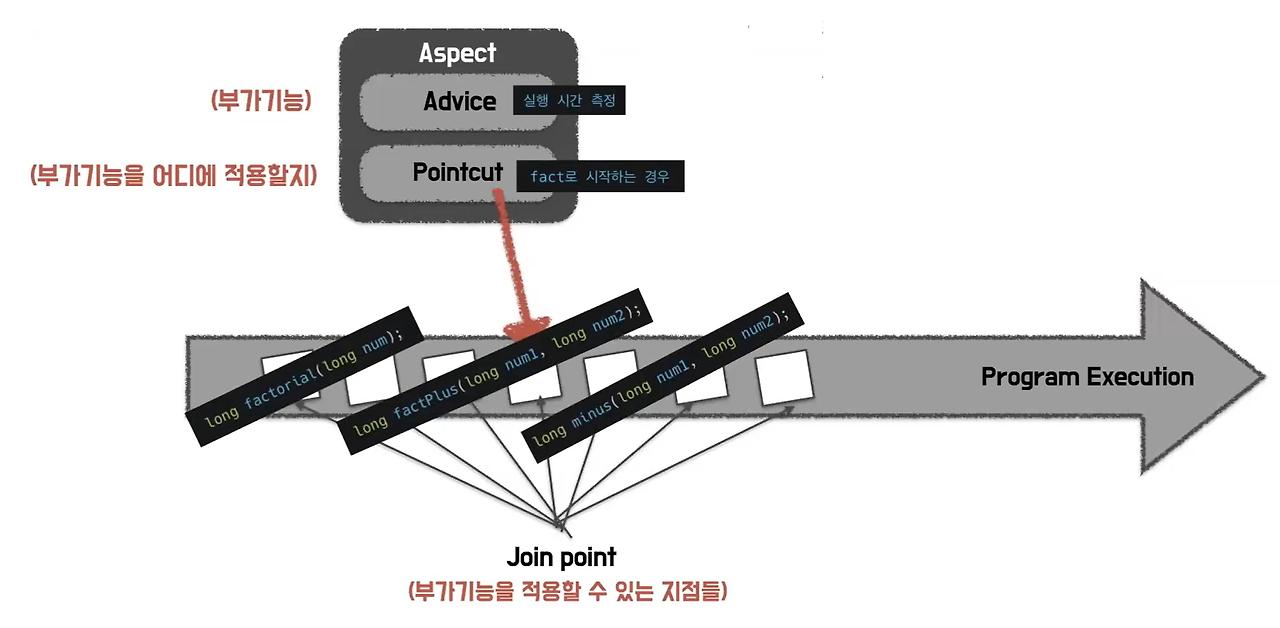
여기서 Spring AOP를 이해하는 데 제일 중요한 줄은 JoinPoint 항목이다. AOP의 원조 격인 AspectJ는 필드 접근, 객체 생성, 정적 초기화 블록까지 JoinPoint로 잡을 수 있다. 반면 Spring AOP는 프록시 기반이라 딱 하나, "스프링 빈의 메서드 실행"만 JoinPoint가 된다. 프록시는 결국 인터페이스(혹은 클래스)의 메서드 호출을 가로채는 구조이기 때문이다 — 필드 접근이나 new 호출은 애초에 프록시를 거치지 않으니 가로챌 방법이 없다.
3. Spring AOP도 결국 프록시다
Spring AOP는 이론만 보면 새로운 개념 같지만, 실체는 의외로 단순하다. 스프링이 빈을 등록하는 과정에서 BeanPostProcessor(정확히는 AnnotationAwareAspectJAutoProxyCreator)가 끼어들어, 등록하려는 빈이 어떤 Aspect의 Pointcut과 일치하면 원본 빈 대신 그 빈을 감싼 프록시를 컨테이너에 등록한다. 이때 대상 클래스가 인터페이스를 구현하고 있으면 JDK Dynamic Proxy(같은 인터페이스를 구현하는 프록시 객체를 런타임에 만드는 방식), 인터페이스가 없으면 CGLIB(대상 클래스를 상속한 서브클래스를 런타임에 만들어 메서드를 오버라이드하는 방식)로 프록시를 만든다. 즉 컨테이너에서 어떤 빈을 꺼내 쓰든, 거기에 Aspect가 적용돼 있다면 실제로 손에 쥐는 건 원본 객체가 아니라 이 프록시다.
이 과정을 조금 더 구체적으로 뜯어보면 이렇다.
- 컨테이너가 빈 정의를 읽고, 생성자를 호출해 객체를 인스턴스화한다. 이 시점의 객체는 아직 프록시가 아니라 순수한 원본(Target) 객체다.
- 필드·세터로 의존성을 주입한다.
@PostConstruct나InitializingBean.afterPropertiesSet()같은 초기화 콜백이 실행된다 — 이것도 여전히 원본 객체 위에서 일어난다.- 초기화가 끝난 직후
BeanPostProcessor.postProcessAfterInitialization()이 호출된다.AnnotationAwareAspectJAutoProxyCreator가 바로 이 인터페이스의 구현체다. - 여기서 등록된 모든 Aspect의 Pointcut을 훑어, 방금 초기화가 끝난 이 빈의 메서드 중 하나라도 매칭되는 게 있는지 확인한다.
- 매칭되면 원본 객체 대신 그 객체를 감싼 프록시를 반환하고, 매칭되는 게 하나도 없으면 원본 객체를 그대로 반환한다.
- 컨테이너는 이 반환값을 그 빈의 최종 싱글톤 인스턴스로 등록한다. 이후
@Autowired로 이 빈을 주입받는 모든 곳은 원본이 아니라 이 프록시를 받는다.
여기서 눈여겨볼 지점은 4번이다. 프록시로 바꿔치기되는 시점이 초기화가 다 끝난 뒤라는 것 — 즉 @PostConstruct가 실행되는 시점엔 아직 프록시가 존재하지 않는다. @PostConstruct 메서드 안에서 같은 빈의 다른(Advice가 걸린) 메서드를 this로 호출하면, 그 시점엔 프록시로 바꿔치기되기 전이라 예외 없이 원본 메서드가 그냥 실행된다 — 뒤에서 다룰 자기 호출(self-invocation) 문제가 @PostConstruct 안에서는 애초에 피할 방법도 없이 항상 일어나는 셈이다.
참고로 Spring Boot 2.0부터는 인터페이스가 있어도 기본적으로 CGLIB를 우선 사용한다(
spring.aop.proxy-target-class=true가 기본값). JDK Dynamic Proxy로 만들면 클라이언트가 인터페이스 타입으로만 빈을 주입받아야 하는데, 실무에서는 구체 클래스 타입으로 주입받는 경우가 흔해 혼란을 줄이기 위한 결정이다.
로깅을 남기는 Aspect를 하나 만들어보자.
@Aspect
@Component
class LoggingAspect {

    @Around("execution(* com.example.order..*Service.*(..))")
    public Object logExecutionTime(ProceedingJoinPoint joinPoint) throws Throwable {
        long start = System.currentTimeMillis();
        log.info("[로그] {} 호출 시작", joinPoint.getSignature().getName());

        Object result = joinPoint.proceed(); // 실제 대상 메서드로 넘어가는 지점

        long elapsed = System.currentTimeMillis() - start;
        log.info("[로그] {} 호출 종료 - {}ms", joinPoint.getSignature().getName(), elapsed);
        return result;
    }
}joinPoint.proceed()가 이 Advice에서 제일 중요한 한 줄이다. 프록시가 가로챈 호출을 실제 대상 메서드로 넘겨주는 지점으로, 이 호출을 기준으로 앞쪽 코드는 메서드 실행 "전"에, 뒤쪽 코드는 실행 "후"에 동작한다. proceed()를 호출하지 않으면 대상 메서드 자체가 아예 실행되지 않는다는 것도 함께 기억해두면 좋다.
여기서 눈여겨볼 건 "어떤 메서드에 적용할지"를 자바 코드로 하나하나 분기하지 않고 execution(...) 표현식 한 줄로 선언했다는 점이다. com.example.order 패키지 아래(..는 하위 패키지 포함) Service로 끝나는 클래스의 모든 메서드(*, 파라미터는 ..로 아무거나)에 이 Advice가 적용된다. OrderService, PaymentService, MemberService를 감싸는 클래스를 각각 따로 만들 필요가 없다 — Pointcut 표현식 하나가 대상 클래스 전체를 커버한다. 즉 로깅이라는 관심사 하나가 대상 클래스 수만큼 반복해서 흩어지던 문제가 여기서 완전히 사라진다.
4. execution 대신 커스텀 어노테이션으로 지정하기
execution(* com.example.order..*Service.*(..))는 편리해 보이지만 실무에서는 위험한 지점이 하나 있다. 패키지 이름이나 클래스 이름 규칙에 그대로 의존한다는 것. order 패키지 밑에 있고 이름이 Service로 끝나는 모든 메서드에 로깅이 걸리는데, 리팩터링하면서 패키지 구조를 바꾸거나 OrderService를 OrderFacade로 이름을 바꾸면 어떻게 될까? Pointcut 표현식은 에러 하나 없이 그냥 더 이상 매칭되지 않는다. 로깅이 조용히 사라지는 것이다.
더 근본적인 문제도 있다. 이 표현식은 "그 패키지, 그 이름 규칙에 해당하는 모든 메서드"를 통째로 대상으로 삼는데, 실제로 로깅이 필요한 메서드는 그중 일부뿐일 수 있다. 패키지 위치나 이름 규칙만으로는 "이 메서드는 대상이다/아니다"를 세밀하게 표현할 수 없다.
이 문제를 해결하는 방법이 커스텀 어노테이션이다. "이 메서드에 부가 기능을 붙이겠다"는 의사를 메서드 이름이나 패키지 위치가 아니라, 메서드 위에 직접 선언하는 것이다.
@Retention(RetentionPolicy.RUNTIME) // 런타임에 리플렉션으로 읽어야 하므로 필수
@Target(ElementType.METHOD)
public @interface LogExecutionTime {
}
@Aspect
@Component
class LoggingAspect {
@Around("@annotation(com.example.common.LogExecutionTime)")
public Object logExecutionTime(ProceedingJoinPoint joinPoint) throws Throwable {
long start = System.currentTimeMillis();
log.info("[로그] {} 호출 시작", joinPoint.getSignature().getName());
Object result = joinPoint.proceed();
long elapsed = System.currentTimeMillis() - start;
log.info("[로그] {} 호출 종료 - {}ms", joinPoint.getSignature().getName(), elapsed);
return result;
}
}class OrderService {
@LogExecutionTime // 이 메서드만 명시적으로 로깅 대상이 된다
void placeOrder(Order order) {
// ... 주문 처리
}
void cancelOrder(Order order) {
// 어노테이션이 없으니 로깅 대상이 아니다 — 패키지·이름 규칙과 무관
}
}@annotation(...)은 execution 표현식과 완전히 다른 기준으로 Pointcut을 판단한다. 패키지가 어디든, 클래스 이름이 뭐든 상관없다 — 메서드 위에 이 어노테이션이 붙어 있는가만 본다. OrderService를 OrderFacade로 리네이밍해도, order 패키지를 commerce로 옮겨도 @LogExecutionTime이 붙어 있는 한 로깅은 그대로 걸린다. 그리고 어노테이션이 메서드 위에 직접 보이니, "이 메서드엔 부가 기능이 붙어 있다"는 사실이 코드를 읽는 사람에게도 명시적으로 드러난다 — execution 표현식은 Aspect 클래스 안에 숨어 있어서 OrderService 코드만 봐서는 로깅이 걸려 있는지 알 방법이 없는 것과 대조적이다.
물론 트레이드오프도 있다. execution 표현식은 기존 코드를 한 줄도 건드리지 않고 Aspect 쪽 설정만으로 적용 범위를 조절할 수 있지만, 커스텀 어노테이션은 대상이 되는 메서드마다 하나씩 직접 붙여야 한다. 대상이 수십, 수백 개라면 이 작업 자체가 번거로울 수 있다. 그래서 실무에서는 흔히 이렇게 나눠 쓴다 — "거의 모든 곳에 무조건 적용해야 하는 관심사"(예: 전역 예외 로깅)는 execution으로 넓게 잡고, "일부 메서드에만 선택적으로 적용해야 하는 관심사"(예: 특정 API의 실행 시간 측정, 특정 메서드의 캐싱)는 어노테이션으로 명시적으로 표시한다.
실제로
@Transactional,@Cacheable,@Async같은 스프링 표준 애너테이션도 전부 이 방식이다 — 클래스나 메서드에 애너테이션을 붙이면, 스프링이 내부적으로@annotation(...)방식의 Pointcut으로 이를 인식해서 프록시를 통해 부가 기능을 적용한다. 지금까지 아무 생각 없이 붙여 쓰던@Transactional이 사실은 이 장에서 만든@LogExecutionTime과 똑같은 메커니즘으로 동작하고 있었던 셈이다.
5. Advice의 종류
@Around는 Target 메서드 실행 전후를 모두 감싸는 가장 강력한 Advice지만, 항상 이게 필요한 건 아니다.
| Advice | 실행 시점 |
|---|---|
@Before | Target 메서드 실행 전 |
@AfterReturning | Target 메서드가 정상 반환한 후 |
@AfterThrowing | Target 메서드가 예외를 던진 후 |
@After | 정상 반환이든 예외든 상관없이 항상 (finally와 같다) |
@Around | 실행 전후를 모두 감싸며, proceed() 호출 여부와 시점을 직접 제어 |
@Around만 있으면 나머지 넷을 전부 표현할 수 있다. 그런데도 종류를 나눠둔 이유는 의도를 명확히 드러내기 위해서다. "이 Advice는 Target을 감쌀 뿐 실행을 막거나 건너뛸 생각이 없다"는 걸 @Before로 선언하면, proceed()를 빼먹어서 Target이 아예 실행되지 않는 실수(@Around에서 흔히 나는 실수)를 애초에 만들 수 없다.
6. Pointcut을 재사용하기
같은 Pointcut 표현식을 여러 Advice에서 쓴다면 @Pointcut으로 이름을 붙여 분리할 수 있다.
@Aspect
@Component
class LoggingAspect {

    @Pointcut("execution(* com.example.order..*Service.*(..))")
    private void orderServiceLayer() {} // 이름만 있는 빈 메서드 — Pointcut의 이름표 역할

    @Before("orderServiceLayer()")
    public void logBefore(JoinPoint joinPoint) {
        log.info("[로그] {} 호출 시작", joinPoint.getSignature().getName());
    }

    @AfterThrowing(pointcut = "orderServiceLayer()", throwing = "ex")
    public void logException(JoinPoint joinPoint, Exception ex) {
        log.warn("[로그] {} 예외 발생: {}", joinPoint.getSignature().getName(), ex.getMessage());
    }
}
Pointcut을 이름으로 분리해두면 "이 Aspect가 어디에 적용되는가"라는 정보가 표현식 문자열 여러 곳에 중복되지 않고 한 곳에만 존재한다 — Aspect 안에서도 결국 관심사(적용 대상 vs 실행 로직)를 분리하는 셈이다.
7. 마치며 — 그런데 이것도 결국 프록시다
여기까지 보면 AOP는 "프록시를 대신 만들어주고, 어디에 적용할지도 대신 챙겨주는" 편리한 도구처럼 보인다. 실제로도 그렇다. 다만 "편리하게 자동화됐다"는 것과 "프록시라는 사실 자체가 사라졌다"는 건 다른 이야기다. Spring AOP가 아무리 선언적으로 보여도, 그 밑바닥은 여전히 JDK Dynamic Proxy 혹은 CGLIB로 만들어진 프록시일 뿐이다. 그리고 프록시는 "클라이언트가 프록시를 거쳐서 Target을 호출할 때만" 작동한다.
여기서 함정이 하나 생긴다. 만약 OrderService 안의 한 메서드가 같은 클래스의 다른 메서드를 this.otherMethod()로 직접 호출하면 어떻게 될까? 이 호출은 스프링 컨테이너가 등록해둔 프록시를 거치지 않는다 — this는 프록시가 아니라 프록시 뒤에 숨어 있는 원본 Target 객체이기 때문이다.
LoggingAspect(com.example.order 패키지의 모든 *Service 메서드에 적용)가 걸려 있는 상태에서, OrderService를 이렇게 짰다고 하자.
@Service
class OrderService {

    void placeOrder(Order order) {   // ① 컨트롤러가 외부에서 호출
        validate(order);             // ② 같은 클래스 내부 호출 — this.validate(order)와 같다
        // ... 주문 처리
    }

    void validate(Order order) {     // Pointcut엔 매칭되지만, 프록시를 거쳐서 불리지 않는다
        if (order.getItems().isEmpty()) {
            throw new IllegalArgumentException("상품이 없습니다");
        }
    }
}
// 컨트롤러 → orderService.placeOrder(order) 호출 결과
[로그] placeOrder 호출 시작
[로그] placeOrder 호출 종료 - 12ms
// validate()는 Pointcut 표현식엔 분명히 매칭되는데, 로그가 한 줄도 안 찍힌다placeOrder는 컨트롤러가 프록시를 통해 호출했으니 ①에서 Advice가 정상적으로 걸린다. 하지만 ②의 validate(order)는 사실 this.validate(order)다 — 이미 프록시를 통과해서 Target 내부로 들어와 있는 상태이므로, 이 호출은 프록시를 다시 거치지 않고 곧장 원본 메서드로 간다. validate가 아무리 Pointcut 표현식에 정확히 매칭돼도 Advice는 조용히 무시된다. 에러가 나는 것도 아니고 컴파일도 실행도 멀쩡히 되기 때문에, 원인을 찾기가 특히 까다롭다.
private 메서드는 이 문제가 한 단계 더 근본적인 형태로 나타나는 경우다. private 메서드는 애초에 클래스 바깥에서 호출할 수 없으니, 이 메서드로 들어오는 모든 호출은 구조적으로 this를 거치는 자기 호출일 수밖에 없다 — 프록시를 거칠 방법 자체가 존재하지 않는다. CGLIB 방식이라면 이유가 하나 더 붙는다. CGLIB는 Target 클래스를 상속한 서브클래스를 만들어 메서드를 오버라이드하는 방식인데, 자바에서 private 메서드는 애초에 상속되지 않으니 오버라이드도 불가능하다. 그래서 Pointcut 표현식으로 아무리 private 메서드를 정확히 지정해도, 프록시가 그 호출을 가로챌 물리적인 경로 자체가 없어 Advice는 항상 조용히 무시된다. AOP는 프록시가 대신 받아줄 수 있는 호출, 즉 외부에서 들어오는 public 메서드 호출에만 적용된다는 걸 보여주는 가장 분명한 사례다.
이 자기 호출(self-invocation) 문제가 제일 자주, 그리고 제일 조용히 사고로 이어지는 곳이 @Transactional이다. "분명히 @Transactional을 붙였는데 트랜잭션이 안 걸린다"는 흔한 버그의 상당수가 바로 이 지점에서 시작된다. 다음 글에서는 AOP가 트랜잭션 관리에 실제로 어떻게 쓰이는지, 그리고 이 프록시의 한계가 @Transactional에서 어떤 함정으로 나타나는지를 다룰 예정이다.
참고 문헌