제가 관심있는 AI 관련 분야에서 논문 어떻게 편하게 찾고 이용하지????
고민에서 찾아봤는데 다음과 같은게 있더라고요.
https://github.com/karpathy/arxiv-sanity-preserver

fork, star 수도 꽤 있어서 저도 한번 사용해 보겠습니다.
arxiv-sanity-preserver의 주요 기능
-
최신 논문 자동 수집 및 카테고리 필터링
원하는 arXiv 카테고리(예: cs.CV, cs.AI 등) 논문만 자동 수집해 관리할 수 있습니다. -
검색, 키워드 기반 탐색 및 태깅
논문 제목/저자/초록 등으로 빠른 검색이 가능하며, 맞춤형 키워드 설정·여러 태그별 관심 논문 분류도 지원합니다. -
인기도/유사도 기반 랭킹 및 추천
사용자가 논문을 별표(저장)하는 수, 본인/다수의 라이브러리 저장 횟수, 논문 간 TF-IDF 기반 내용 유사도로 인기 논문이나 유사 논문을 직관적으로 랭크 및 추천합니다. -
논문별 상세 정보 및 썸네일 제공
다운로드한 PDF에서 요약텍스트, 썸네일 이미지, 주요 메타데이터 등을 한 번에 확인할 수 있습니다. -
개인 라이브러리 구축 및 맞춤 추천
회원 가입 후 자신만의 논문 라이브러리(스크랩북) 생성, 해당 논문 기반의 맞춤형 유사 논문 추천, 정기 이메일 알림 등 개인화 기능이 강력합니다. -
빠른 논문 브라우징과 검색 속도
전처리 캐시, 텍스트 인덱싱, 내용 벡터화를 통해 바로바로 논문을 검색하고 유사 논문, 인기 논문을 볼 수 있어 논문 탐색 효율이 매우 높습니다.
주요 편의성
-
웹브라우저 기반의 간단한 인터페이스로 별도의 arXiv 계정 없이도 논문 탐색이 가능합니다.
-
오픈소스로 직접 서버를 띄우거나 arxiv-sanity.com(혹은 arxiv-sanity-lite.com) 같은 온라인 서비스를 활용할 수도 있어 접근성이 높습니다.
-
논문 추천, 인기순/최신순, 관심 키워드/카테고리 자동 필터링 등 덕분에 논문 리뷰·트렌드 파악 시간을 크게 줄여줍니다.
-
논문 PDF 다운로드/텍스트 변환, 썸네일 생성 등 논문 탐색에 꼭 필요한 부가 기능을 모두 지원합니다.
https://arxiv-sanity-lite.com/
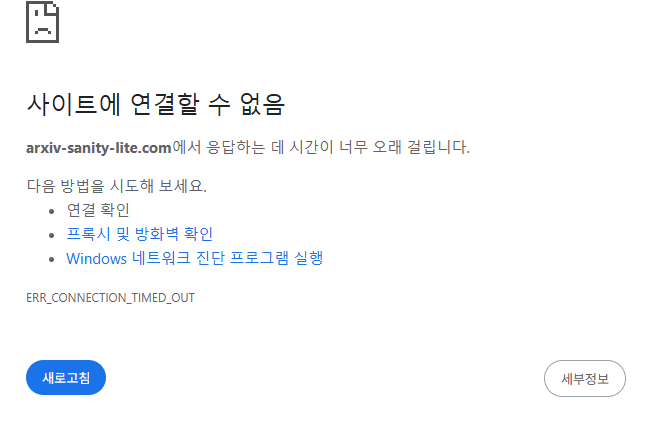
이용 해보려면 이미 자체 온라인 서비스도 있다고 하는데 현재 접속은 안되는 상황이네요.
원래도 직접 로컬에서 서버 켜서 사용해보려고 했는데 마침 잘 된것 같습니다.
github에 나와있는 README 참고해서 로컬에서 직접 구동해보겠습니다.
저는 fork 했기 때문에 제 github에 이용해서 설치 후 가동 해보겠습니다.
제 github을 clone 떠서 가상환경 만들고 필요한 requirements.txt 설치 하는 것 입니다.
https://github.com/본인계정/arxiv-sanity-preserver.git
python -m venv env
source env/Scripts/activate
pip install -r requirements.txt
이후에도 필요한 것들 설치 후 README 대로 실행 해보시면 됩니다.
추가 설치 필요한것들은 Chocolatey 라고 linux 아니고 window에서 설치할때 많이 사용하는 시스템 패키지 매니저 이용해서 설치 했습니다
choco install imagemagick
choco install poppler
choco install mongodb
(혹시나 따라 하시는 분이 있다가 안되는 부분 있다면 댓글 혹은 메일로 문의 남겨주세요..!)
설치 완료 후 동작
- 가상 환경 활성화
( 저는 가상환경 구성 후 설치 했기 때문에 이렇게 동작합니다. 혹시 가상 환경 안하시고 바로 하신분들은 이렇게 안하셔도 됩니다.)
.\env\Scripts\Activate- arXiv 데이터 수집 및 전처리
python fetch_papers.py           # arXiv 논문 메타데이터 다운로드
python download_pdfs.py          # PDF 파일 다운로드
python parse_pdf_to_text.py      # PDF → 텍스트로 변환
python thumb_pdf.py              # 논문 썸네일 이미지 생성
python analyze.py                # 논문 내용 분석 및 벡터화(TF-IDF 등)
python buildsvm.py               # SVM 기반 맞춤 추천 벡터 구축(옵션)
python make_cache.py             # 캐시 파일 생성
이 명령어들을 순서대로 입력해서 arXiv 데이터 수집 및 전처리 해줍니다.
각 명령어와 자세한 정보는 README 읽어 보시면 영어로 잘 설명 되어있습니다.
위의 명령어들을 모두 실행하는데 시간이 꽤 걸리네요. 저의 경우는 700개 논문에 대해서 전부 이 과정 거치게 되니까 1시간정도 걸렸어요.
순수 시간 외에도 역시 버전 맞추는 작업이랑 linux 관련 코드로 되어있어서 window에서 구동하려면 코드도 조금 바꾼 부분들도 있습니다.
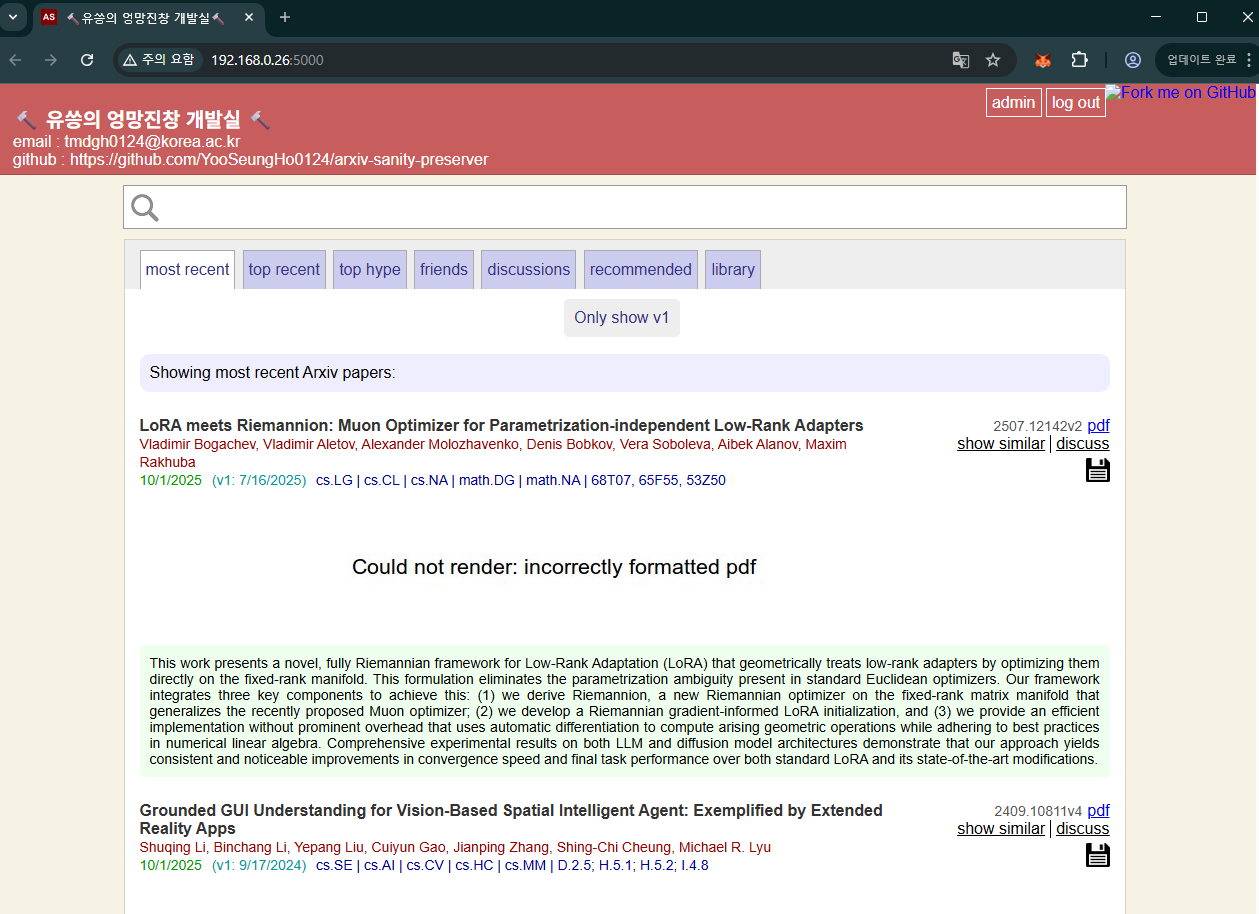
마침내 serve.py 구동 시키면 로컬에서 구동 되었네요!
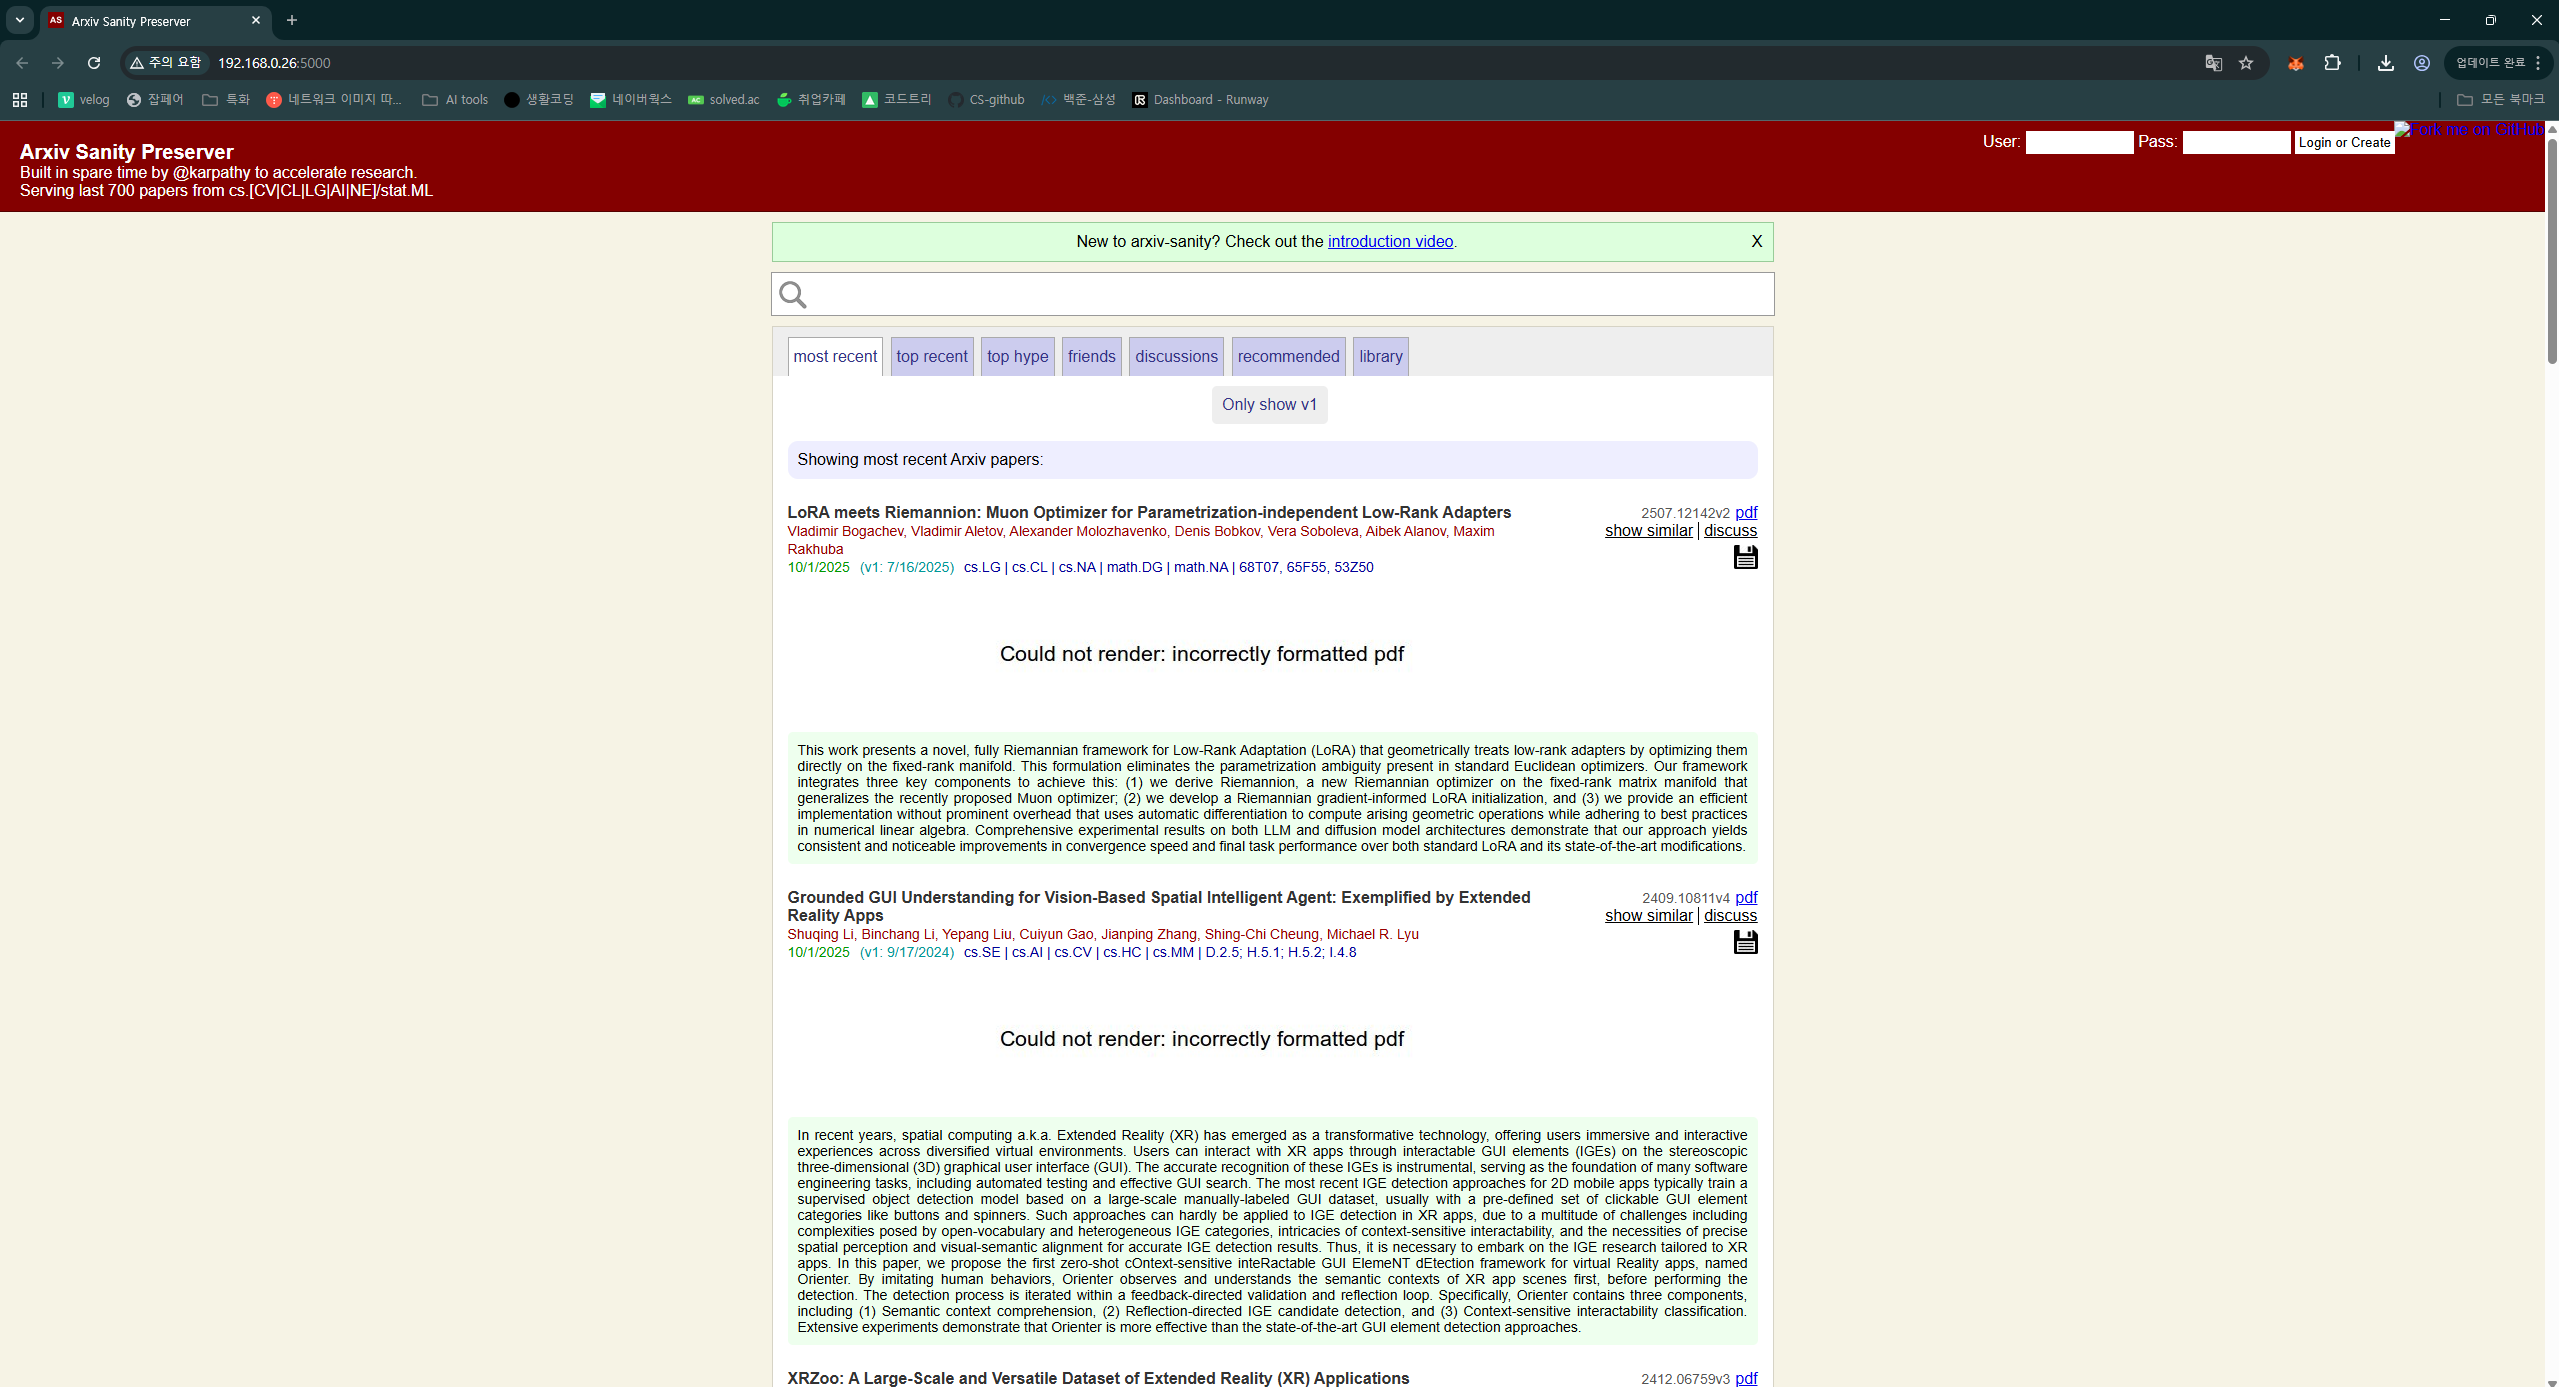
장점이라고 뽑아보자면 제가 여기서 자주 찾는 논문이나 정보들은 유튜브 알고리즘 처럼 추천에 떠서 나중에 보기 좋다는 점 정도와 개인화 정도 있을 수 있을 것 같습니다.
저는 개인적으로 인공지능 분야 논문을 좀 찾아볼때 구동해서 사용해 볼 것 같긴 합니다.
linux 기반 코드이기 때문에 제가 구동 위해서 window 용으로 좀 바꾼 것들이 있는데 이건 제가 fork 했던 제 저장공간에 따로 업데이트해서 올리겠습니다.
혹시나 필요하신분들은 아래 제 깃헙을 통해서 가져가서 구동해보시면 좋을 것 같습니다.
https://github.com/YooSeungHo0124/arxiv-sanity-preserver