[기초] 딥러닝 최적화와 초기화
1. 딥러닝 학습
1.1 학습의 수학적 정의
딥러닝 모델은 다음과 같은 최적화 문제로 정의된다.
여기서:
- ( ): 모델의 모든 파라미터 집합 (가중치, 바이어스)
- ( ): 신경망이 정의하는 비선형 함수
- ( ): 손실 함수
- ( ): 데이터 분포
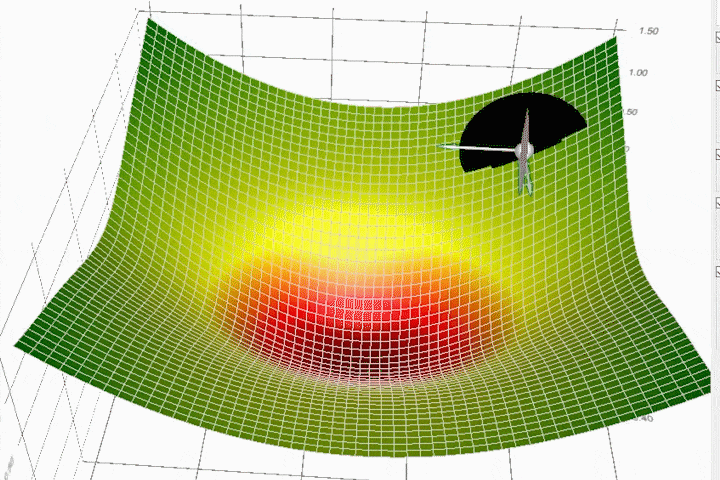
Convex(볼록) 함수는 하나의 완전한 최소점만 있지만, 딥러닝 손실 함수는 구불구불한 산과 계곡이 많아 여러 최소점이 존재합니다. 그래서 최적화가 훨씬 어렵다.
실제 학습은 비볼록(non-convex) 손실 공간에서의 수치적 최적화 과정이며, 이때 초기화와 최적화 알고리즘은 다음을 결정한다.
- 어떤 영역에서 탐색을 시작하는가 (initial point)
- 탐색 경로가 얼마나 안정적인가 (conditioning)
- 국소 최소/안장점(saddle point)을 얼마나 잘 탈출하는가
1.2 초기화와 최적화의 역할 분리
| 요소 | 담당 역할 |
|---|---|
| 가중치 초기화 | 신호 분산의 스케일 결정, 학습 가능성 확보 |
| 최적화 기법 | 손실 지형에서의 탐색 효율 및 수렴 속도 |
초기화는 학습이 가능한 상태를 만들고,
최적화는 그 상태에서 얼마나 잘 학습할 수 있는지를 결정한다.
2. 가중치 초기화 (Weight Initialization)
2.1 초기화 실패가 야기하는 구조적 문제
(1) Symmetry Breaking 실패
만약 각 뉴런의 가중치가 전부 같으면, 입력이 아무리 다르더라도 뉴런의 출력이 같아지고 결국 학습이 분쇄되지 않는다. 모든 가중치를 0으로 초기화할 경우, 같은 층의 모든 뉴런은 다음을 공유한다.
- 동일한 입력
- 동일한 출력
- 동일한 gradient
결과적으로:
→ 학습이 진행되어도 뉴런 간 역할 분화가 발생하지 않는다.
이는 표현력 붕괴(representational collapse)로 이어진다.
(2) Gradient Vanishing / Exploding의 근본 원인
은닉층 ( l )의 선형 변환을 다음과 같이 두자.
만약:
- ( ) → 분산 폭주
- ( ) → 분산 수축
이면, 깊이에 따라 다음 현상이 반복적으로 누적된다.
즉, 초기 분산 선택은 깊이 방향으로의 분산 전파를 제어하는 문제다.
활성화 함수의 출력이 특정 범위에 집중되면, 역전파될 때 그 기울기가 점점 작아져 신호가 사라지기도(=vanishing), 너무 커지기도(=exploding) 한다.
2.2 분산 보존 관점에서의 초기화 원리
이상적인 초기화 조건은 다음 두 가지를 동시에 만족해야 한다.
-
Forward pass
-
Backward pass
이는 초기화가 단순한 “시작값 설정”이 아니라,
네트워크 전체를 관통하는 신호 전달 시스템의 스케일링 문제임을 의미한다.
2.3 Xavier Initialization (Glorot Initialization)
(1) 이론적 가정
- 입력 ( )는 평균 0, 분산 ( )
- 가중치 ( )는 독립이고 평균 0
- 활성화 함수는 선형 또는 약한 비선형 (sigmoid, tanh)
이때,
이를 입력 분산과 동일하게 유지하려면:
(2) 수식적 정의
-
정규분포:
-
균등분포:
(3) 한계
- Sigmoid/Tanh의 포화 영역 문제는 완화하지만 제거하지는 못함
- ReLU 계열에서는 활성화 분산이 절반으로 감소
→ ReLU 기반 네트워크에서는 분산 손실 누적 발생
2.4 He Initialization
(1) ReLU 활성화의 통계적 특성
ReLU는 다음과 같이 정의된다.
입력이 대칭 분포일 경우:
- 출력의 약 50%가 0
- 분산이 약 절반으로 감소
이를 보정하기 위해:
(2) 정의
(3) 효과
- 깊은 ReLU 네트워크에서 학습 안정성 확보
- BatchNorm 없이도 초기 학습 가능
2.5 초기화 방법의 선택 기준
| 조건 | 선택 |
|---|---|
| 얕은 네트워크 + Sigmoid | Xavier |
| 깊은 네트워크 + ReLU | He |
| BatchNorm 사용 | 초기화 민감도 감소 |
| Transformer 계열 | Xavier + LayerNorm |
3. 최적화 (Optimization)
3.1 경사하강법의 기하학적 해석
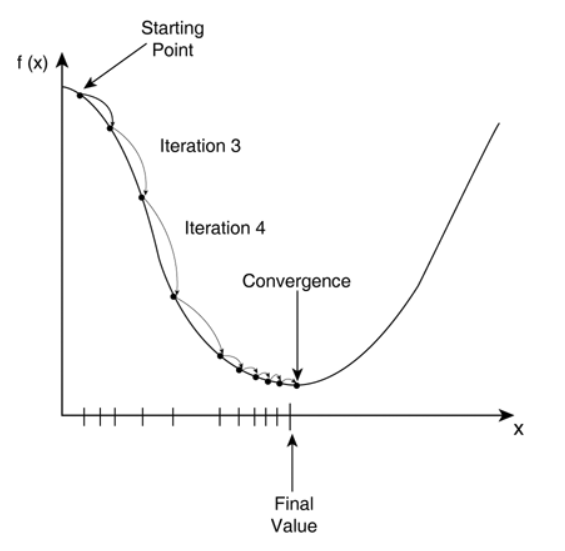
경사하강법은 다음을 반복한다.
이는:
- 손실 함수의 1차 테일러 근사에서
- 가장 빠르게 감소하는 방향(negative gradient)을 따라 이동
한다는 의미다.
3.2 학습률의 역할
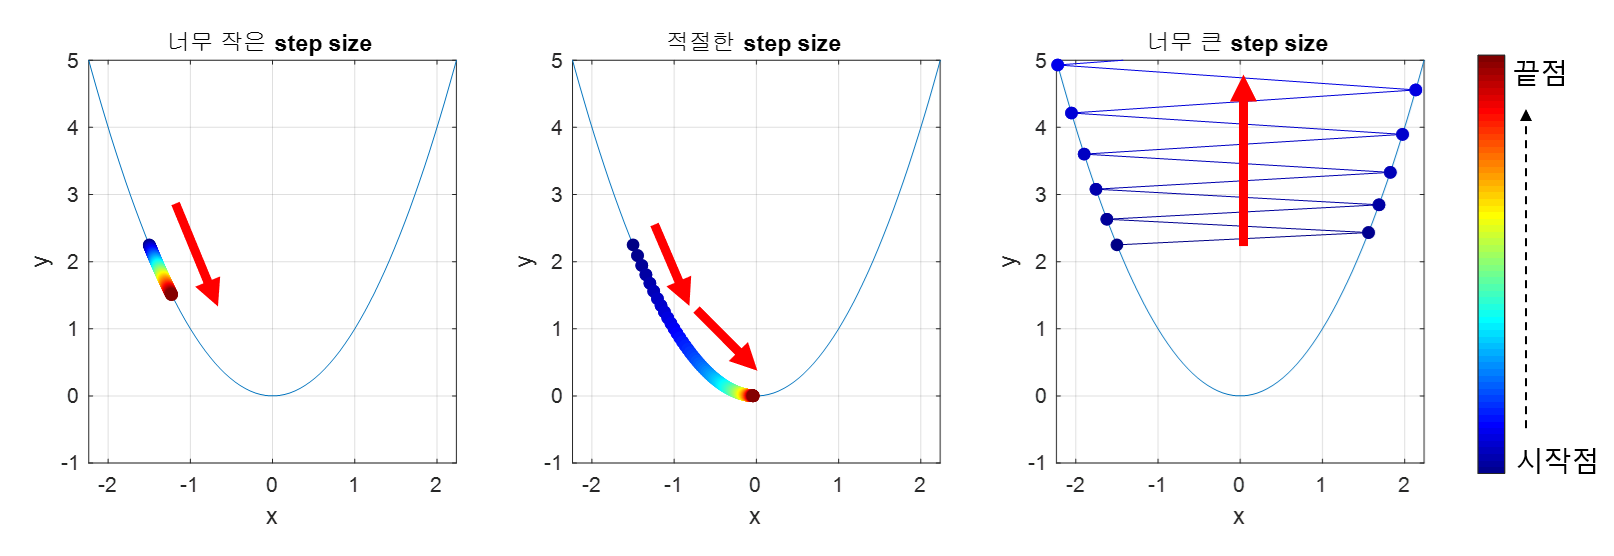
학습률(learning rate, ())은 경사 하강법에서 파라미터가 한 번의 업데이트에서 얼마나 이동할지를 결정하는 스케일 계수이다.
기본적인 파라미터 업데이트 식은 다음과 같다.
여기서 gradient ()는 손실을 가장 빠르게 감소시키는 방향을 제공하고,
학습률은 이 방향을 실제 파라미터 변화량으로 변환하는 크기를 결정한다.
손실 지형 관점에서의 학습률
손실 함수는 파라미터 공간에서 곡률(curvature)이 서로 다른 지형을 가진다.
학습률은 이러한 지형에 대해 다음과 같은 가정을 암묵적으로 포함한다.
현재 위치에서의 손실 지형은 이 정도 이동을 허용할 만큼 완만하다.
학습률이 이 가정과 맞지 않을 경우, 최적화는 불안정해진다.
학습률이 너무 큰 경우
학습률이 과도하게 크면 한 번의 업데이트가 최소점을 넘어가게 된다.
이로 인해 손실이 진동하거나 증가하며, 학습이 발산할 수 있다.
이는 손실 지형의 곡률에 비해 이동량이 지나치게 큰 경우에 발생한다.
학습률이 너무 작은 경우
학습률이 지나치게 작으면 파라미터가 매우 느리게 변화한다.
손실은 감소하지만, 평탄한 영역에서는 실질적인 학습이 거의 진행되지 않는다.
이 경우 이론적으로는 수렴 가능하더라도 실용적인 학습이 어렵다.
초기화 및 최적화와의 관계
학습률은 모델의 초기화 및 손실 지형의 conditioning과 밀접한 관련이 있다.
적절한 초기화는 파라미터 전반에 걸쳐 gradient의 스케일을 균형 있게 만들어,
하나의 학습률로 안정적인 학습이 가능하도록 한다.
반대로 초기화가 부적절하면,
일부 파라미터는 과도하게 업데이트되고 다른 일부는 거의 업데이트되지 않아
학습률 선택이 매우 어려워진다.
Local Minima (국소 최소점)
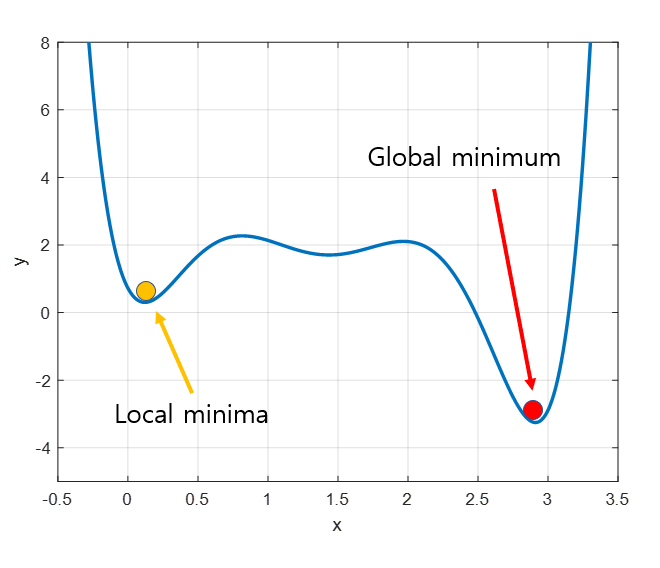
손실 함수 를 파라미터
𝜃 에 대해 최적화할 때, local minima(국소 최소점)란 다음 조건을 만족하는 지점을 의미한다.
어떤 작은 이웃 범위 내에서는 손실이 최소이지만,
전체 파라미터 공간에서의 최소값(global minimum)는 아닌 지점
즉, 주변으로는 더 낮은 방향이 없지만,
멀리 떨어진 곳에는 더 낮은 손실값이 존재할 수 있다.
Local minima와 Global minima의 차이
Global minimum: 손실 함수 전체에서 가장 작은 값
Local minimum: 국소 영역에서만 가장 작은 값
딥러닝에서의 최적화는 일반적으로
global minimum을 보장하지 않으며,
실제로는 local minimum 또는 그 근방에서 수렴하는 경우가 많다.
딥러닝에서 local minima의 실제 영향
고전적인 비선형 최적화 문제와 달리, 고차원 딥러닝 모델에서는 다음과 같은 특성이 있다.
- 파라미터 차원이 매우 큼
- 동일한 성능을 갖는 최소점이 다수 존재
- 성능이 크게 나쁘지 않은 local minimum이 많음
이로 인해 딥러닝에서는 local minimum 자체가 치명적인 문제인 경우는 드물다
실제 학습 성능을 크게 저해하는 요인은 local minimum보다 saddle point(안장점) 인 경우가 많다.
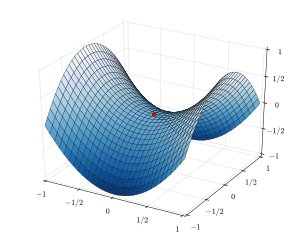
학습률 및 초기화와의 관계
학습률과 초기화는
어떤 local minimum으로 수렴하는지를 결정하는 중요한 요소이다.
초기화: 최적화가 시작되는 위치를 결정
학습률: 국소 지형을 탈출할 수 있는 이동 크기를 결정
학습률이 너무 작으면: 얕은 local minimum이나 평탄한 영역에 쉽게 머무름
학습률이 적절하면: 얕은 local minimum을 지나쳐 더 낮은 손실 영역으로 이동 가능
4. 확률적 경사하강법 (Stochastic Gradient Descent, SGD)
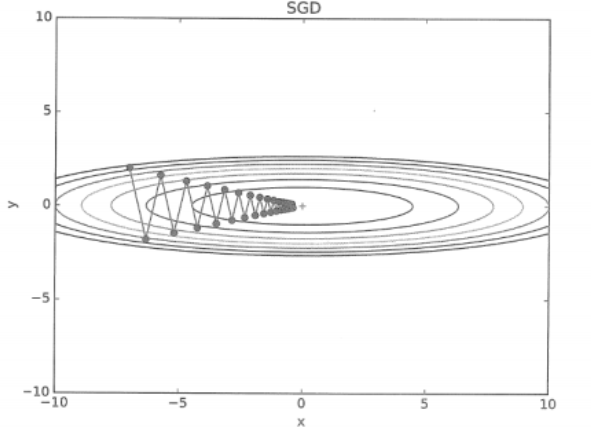
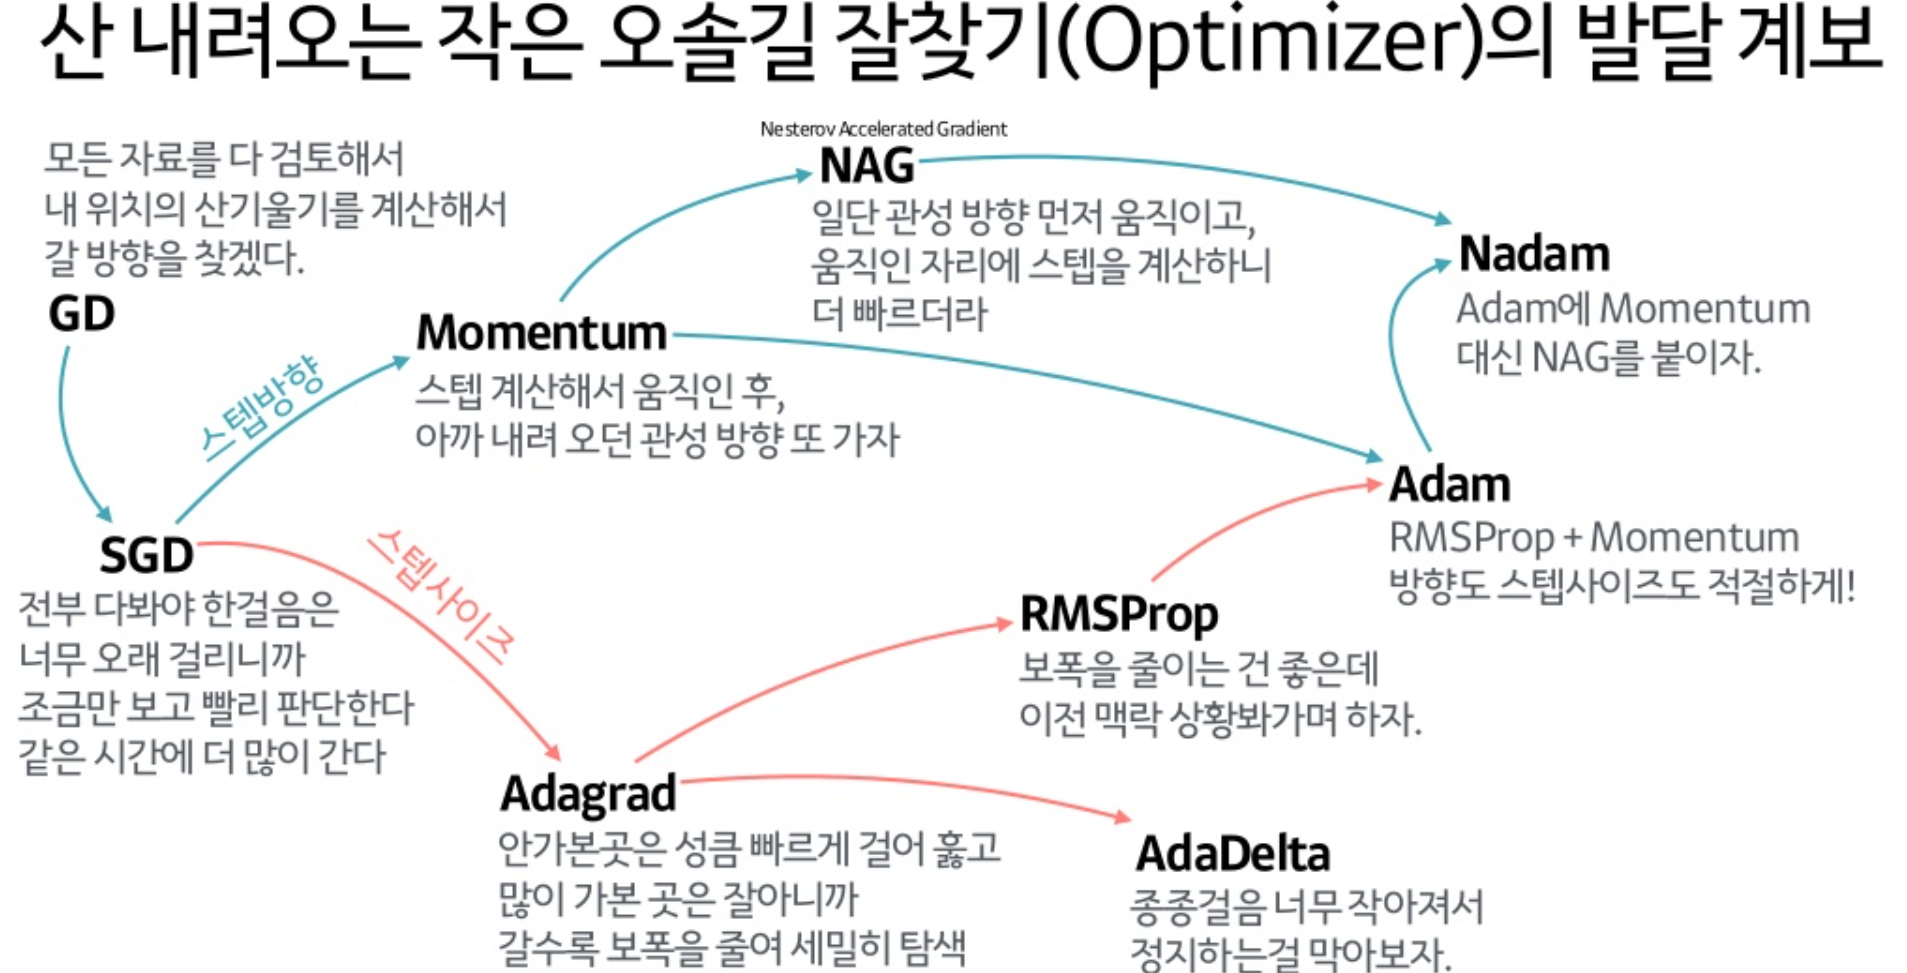
딥러닝 최적화 기법의 역사는 모두 SGD로부터 시작된다.
SGD는 가장 단순한 형태의 최적화 방법이지만, 이후 등장하는 Momentum, AdaGrad, RMSProp, Adam 등 모든 기법은 SGD가 가진 구조적 한계를 어떻게 극복할 것인가라는 문제의식에서 출발했다.
따라서 SGD는 단순한 “기본 방법”이 아니라, 최적화 기법 진화의 기준점(reference) 이다.
4.1 경사하강법의 기본 원리
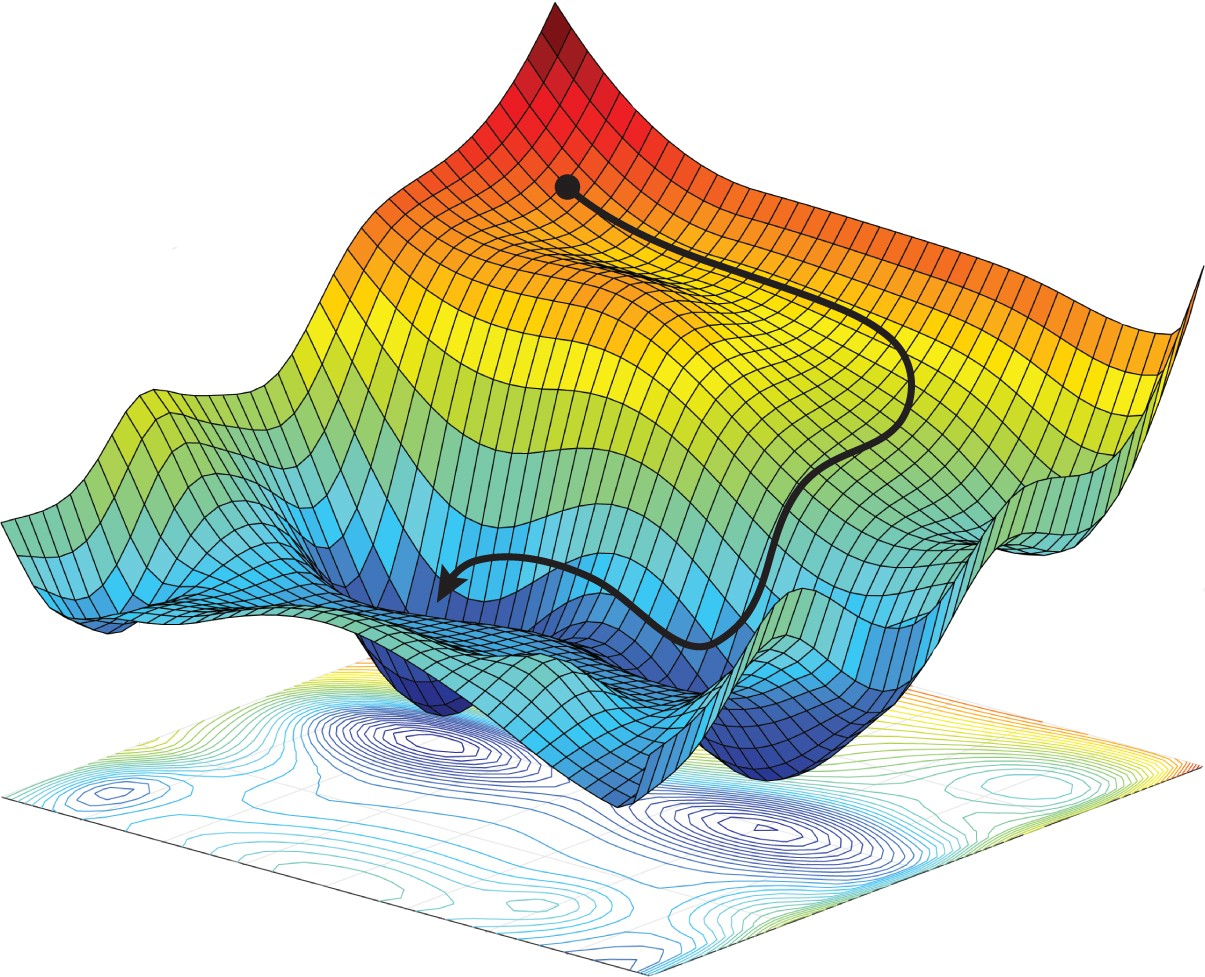
최적화의 목적은 손실 함수 ( L(W) )를 최소화하는 파라미터 ( W )를 찾는 것이다.
경사하강법은 현재 위치에서의 기울기(gradient)를 이용해 손실이 가장 빠르게 감소하는 방향으로 파라미터를 갱신한다.
여기서
- ( ) : 학습률(learning rate)
- ( ) : 손실 함수의 기울기
이 업데이트 식은 손실 함수를 현재 지점에서 1차 테일러 근사로 해석했을 때, 손실을 가장 빠르게 감소시키는 방향이 gradient의 반대 방향이라는 사실에 기반한다.
4.2 Batch, Stochastic, Mini-batch Gradient Descent
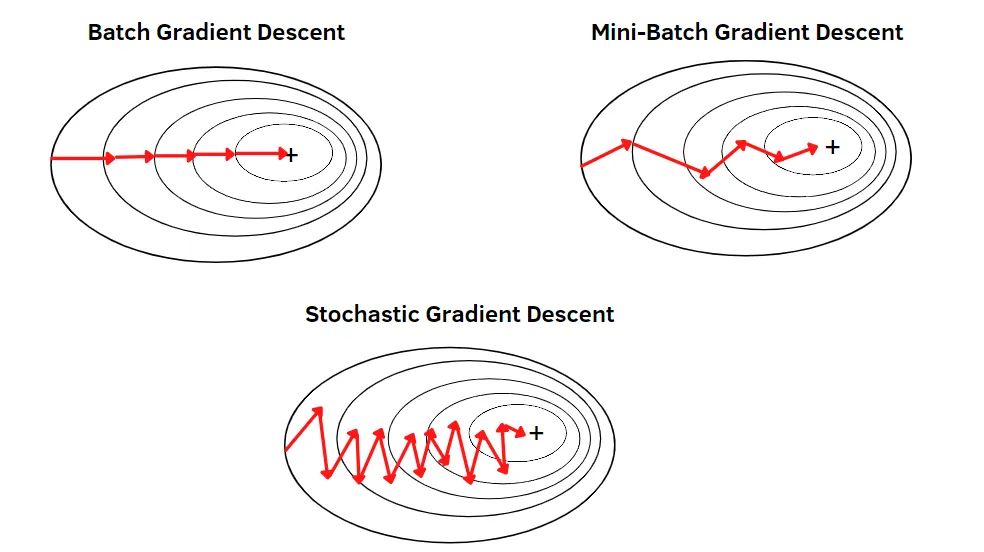
이론적으로는 전체 데이터에 대한 정확한 gradient를 계산하는 것이 이상적이다. 그러나 딥러닝에서는 데이터 수가 매우 크기 때문에, 다음과 같은 근사 방식이 사용된다.
- Batch Gradient Descent
전체 데이터 (N)개를 사용하므로 안정적이지만, 계산 비용이 매우 크다.
- Stochastic Gradient Descent (SGD)
데이터 한 개로 gradient를 근사한다. 계산은 빠르지만, 업데이트의 분산이 크다.
- Mini-batch Gradient Descent
계산 효율과 안정성 사이의 균형을 제공한다.
4.3 딥러닝 손실 함수의 기하적 특성
SGD의 한계를 이해하려면 딥러닝 손실 함수의 구조를 이해해야 한다.
딥러닝 손실 함수는 일반적으로 다음과 같은 특성을 가진다.
- 고차원 파라미터 공간
- Saddle point가 지역 최소점보다 훨씬 많음
- 방향마다 기울기 크기가 크게 다른 비등방성(non-isotropic) 구조
이러한 손실 지형은 SGD에 매우 불리하다.
4.4 SGD의 구조적 한계
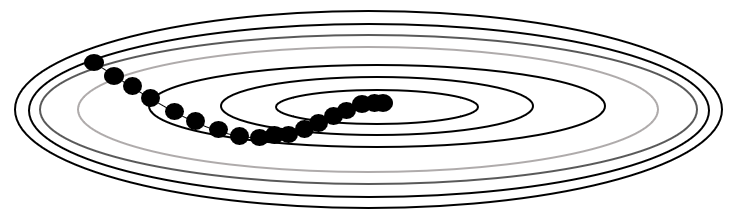
(1) 지그재그 현상
손실 함수가 좁고 긴 계곡 형태일 경우, 한 방향에서는 gradient가 크고 다른 방향에서는 매우 작다.
SGD는 큰 gradient 방향으로 과도하게 이동하고, 결과적으로 다음과 같은 비효율적인 경로를 따른다.
- 진동(oscillation)
- 불필요한 이동 거리 증가
(2) 느린 수렴
완만한 방향의 gradient는 매우 작기 때문에, 해당 방향으로의 이동은 극도로 느려진다.
이는 학습 초반뿐 아니라, 최소점 근처에서도 수렴 속도를 크게 저하시킨다.
(3) 전역 학습률의 한계
SGD는 모든 파라미터에 동일한 학습률 ( )를 적용한다. 그러나 실제로는:
- 어떤 파라미터는 큰 업데이트가 필요
- 어떤 파라미터는 매우 작은 업데이트가 필요
이로 인해 다음과 같은 딜레마가 발생한다.
- ( )가 크면: 발산 위험
- ( )가 작으면: 학습 속도 저하
SGD의 한계는 요약하면 다음 두 가지다.
- 방향 정보가 현재 gradient에만 의존
- 파라미터별 스케일 차이를 전혀 반영하지 못함
모던 최적화 기법들은 SGD가 가진 진동, 느린 수렴 문제를 보완하기 위해 등장했다.
이 문제를 해결하기 위한 첫 번째 시도가 바로 Momentum, 즉 과거 gradient의 누적이다.
5. Momentum
SGD의 가장 큰 문제는 현재 순간의 gradient에만 의존한다는 점이다.
Momentum은 이 한계를 인식하고, 최적화 과정에 시간적 누적 정보(time history) 를 처음으로 도입한 방법이다.
즉, Momentum은 단순한 “속도 트릭”이 아니라,
gradient의 1차 모멘트(평균 방향)를 추정하려는 시도로 이해할 수 있다.
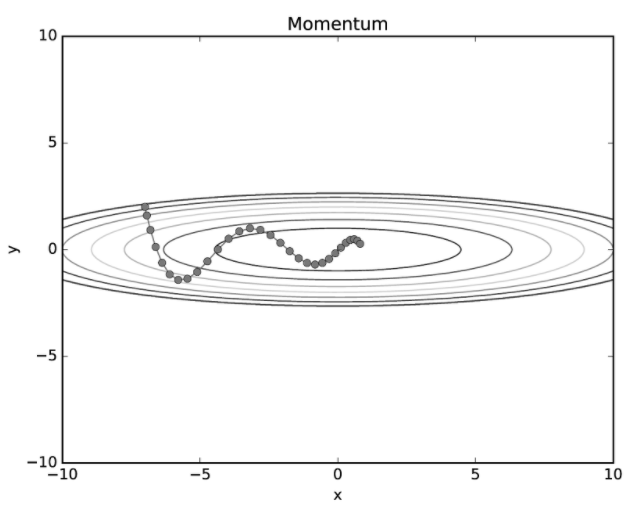
5.1 왜 Momentum이 필요한가
SGD는 다음과 같은 구조적 문제를 가진다.
- 비등방 손실 지형에서 지그재그 이동
- 완만한 방향으로의 매우 느린 수렴
- gradient 노이즈에 민감한 업데이트
이 문제들은 모두 gradient의 방향성이 불안정하다는 점에서 비롯된다.
Momentum은 이 문제를 “과거의 gradient를 기억하자”는 발상으로 해결하고자 한다.
5.2 Momentum의 핵심 아이디어
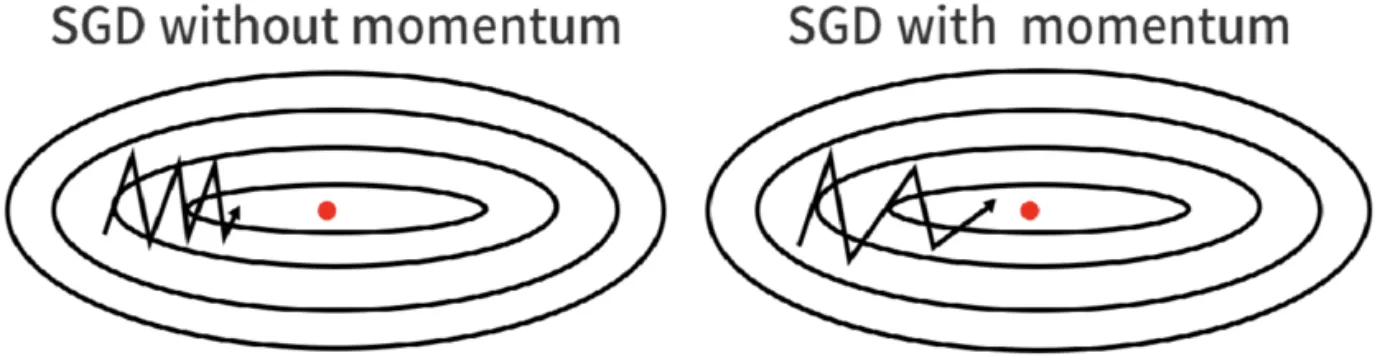
Momentum은 현재 gradient뿐만 아니라, 과거 gradient의 누적 방향을 함께 고려한다.
이를 위해 새로운 변수인 속도(velocity) 를 도입한다.
여기서
- ( ): 누적된 이동 방향 (velocity)
- ( ): 관성 계수 (보통 0.9)
5.3 수식적 해석
Momentum 업데이트를 전개해 보면 다음과 같다.
즉, Momentum은 과거 gradient들의 지수 이동 평균(EMA) 을 사용한다.
- 최근 gradient일수록 더 큰 가중치
- 오래된 gradient는 점점 영향 감소
이 관점에서 보면 Momentum은 다음을 수행한다.
“현재 gradient의 잡음을 줄이고, 일관된 하강 방향을 추정한다.”
5.4 기하학적 관점에서의 효과
Momentum은 손실 지형에서 다음과 같은 효과를 만든다.
- 진동이 심한 방향 → 상쇄됨
- 일관된 방향 → 가속됨
즉,
- 좁고 긴 계곡에서는 중심 방향으로 빠르게 이동
- 지그재그 경로가 완화됨
이는 SGD가 갖던 비효율적인 경로 문제를 크게 개선한다.
5.5 Momentum의 한계
Momentum은 분명한 진전이지만, 여전히 중요한 한계를 가진다.
(1) 현재 위치에서의 gradient만 사용
Momentum은 이동 방향을 누적하지만, gradient 계산 자체는 항상 현재 위치에서 수행된다.
이로 인해 다음 문제가 발생한다.
- 관성으로 인해 최소점을 지나쳐 버림 (overshooting)
- 최적점 근처에서 불안정한 진동
(2) 학습률 문제는 여전히 해결되지 않음
- 모든 파라미터에 동일한 ( ) 적용
- 파라미터별 스케일 차이 미반영
즉, Momentum은 방향성 문제는 완화했지만,
“지금 어디로 가고 있는가”를 미리 고려하지는 못한다.
Momentum의 한계는 다음 질문으로 이어진다.
“관성으로 이동할 것을 알고 있다면,
그 위치에서의 gradient를 미리 계산할 수는 없을까?”
이 질문에 대한 해답이 바로 Nesterov Accelerated Gradient (NAG) 이다.
6. Nesterov Accelerated Gradient (NAG)
Momentum은 SGD의 지그재그 문제를 효과적으로 완화했지만, 새로운 한계를 드러냈다.
바로 관성으로 인해 최소점을 지나쳐 버리는 현상(overshooting) 이다.
Nesterov Accelerated Gradient(NAG)는 이 문제를 다음과 같은 질문으로 재정의한다.
“어차피 관성으로 이동할 예정이라면,
그 이동한 위치에서의 gradient를 미리 계산하면 어떨까?”
이 질문이 Nesterov의 출발점이다.
6.1 Momentum의 근본적 한계 재해석
Momentum 업데이트는 다음과 같다.
이 식의 문제는 명확하다.
- 실제로는 ( )에서 gradient를 계산하지만
- 파라미터는 ( ) 방향으로 이동하게 됨
즉, gradient를 계산한 위치와 실제 이동 방향이 불일치한다.
이 불일치는 다음 현상을 유발한다.
- 최소점 근처에서 과도한 이동
- 불필요한 진동
- 수렴 지연
6.2 Nesterov의 핵심 아이디어: Look-ahead Gradient
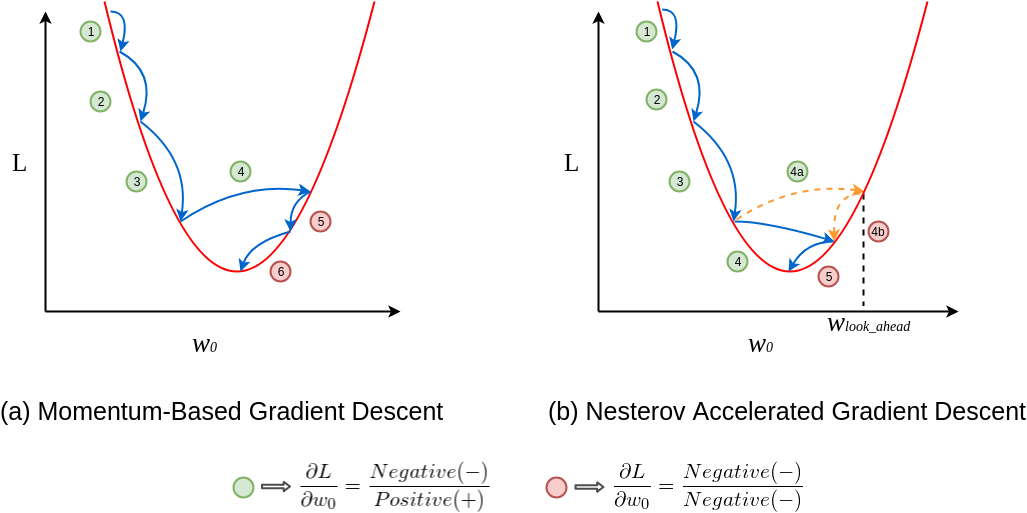
Nesterov는 gradient를 계산하기 전에 한 발 앞서 이동한다.
그리고 이 미래 위치에서 gradient를 계산한다.
즉,
“이동한 다음에 어떤 경사가 기다리고 있는지를 먼저 본다.”
이것이 Nesterov의 본질이다.
6.3 수식적 관점: 왜 overshooting이 줄어드는가
Nesterov는 관성으로 이동한 위치에서 gradient를 계산하므로 다음 효과가 발생한다.
-
만약 최소점에 가까워졌다면
→ gradient 크기가 작아짐
→ 업데이트가 자동으로 완화됨 -
만약 잘못된 방향으로 가고 있다면
→ 미래 위치에서 gradient가 즉시 이를 감지
→ 보정 방향으로 업데이트
즉, Nesterov는 사전 보정(pre-correction) 을 수행한다.
6.4 Momentum vs Nesterov: 구조적 비교
| 항목 | Momentum | Nesterov |
|---|---|---|
| Gradient 계산 위치 | 현재 위치 (W_t) | 미래 위치 (Wt + \alpha v{t-1}) |
| Overshooting | 발생 가능 | 크게 감소 |
| 수렴 안정성 | 중간 | 높음 |
| 계산 비용 | 낮음 | 거의 동일 |
중요한 점은, 계산 비용은 거의 증가하지 않으면서 수렴 특성이 개선된다는 것이다.
6.5 이론적 관점에서의 의의
Nesterov Accelerated Gradient는 단순한 휴리스틱이 아니다.
- 볼록 최적화(convex optimization) 이론에서
- 최적의 수렴률(optimal convergence rate) 을 가지는 방법으로 증명됨
이 때문에 “Accelerated”라는 이름이 붙었다.
6.6 여전히 남아 있는 문제
Nesterov는 Momentum의 방향성 문제를 상당 부분 해결했지만, 여전히 근본적인 한계를 가진다.
(1) 학습률은 여전히 전역적이다
- 모든 파라미터에 동일한 ( )
- 파라미터별 스케일 차이 미반영
(2) gradient 크기 정보는 직접적으로 사용하지 않는다
- 방향은 개선되었으나
- “얼마나 크게 가야 하는가”는 여전히 고정 규칙
이제 질문은 다음으로 넘어간다.
“방향만이 아니라,
파라미터마다 다른 학습률을 쓸 수는 없을까?”
7. AdaGrad
Momentum과 Nesterov는 SGD의 방향성 문제를 상당 부분 해결했다.
그러나 여전히 하나의 근본적인 가정이 남아 있었다.
“모든 파라미터는 같은 크기의 step으로 업데이트되어도 괜찮다.”
AdaGrad는 이 가정을 처음으로 명시적으로 부정한 방법이다.
즉, AdaGrad는 ‘방향’이 아니라 ‘스케일’ 문제를 해결하려는 시도다.
7.1 문제 인식: 왜 전역 학습률은 부적절한가
딥러닝 모델의 파라미터들은 동일한 성격을 가지지 않는다.
- 어떤 파라미터는 자주 업데이트됨
- 어떤 파라미터는 매우 드물게 업데이트됨 (희소 특징)
예를 들어:
- NLP에서의 희소 단어 벡터
- 추천 시스템에서의 희소 사용자/아이템 특성
이 경우 전역 학습률 ( )는 다음과 같은 문제를 만든다.
- 자주 등장하는 파라미터 → 과도한 업데이트
- 드물게 등장하는 파라미터 → 학습이 거의 되지 않음
AdaGrad는 다음 질문에서 출발한다.
“파라미터마다 다른 학습률을 쓸 수는 없을까?”
7.2 AdaGrad의 핵심 아이디어
AdaGrad는 각 파라미터에 대해 과거 gradient의 크기 정보를 누적한다.
각 파라미터 ( i )에 대해:
여기서
- ( )
- ( ): 해당 파라미터의 gradient 제곱 누적합
7.3 수식적 의미: 자동 학습률 감소
AdaGrad 업데이트를 해석하면 다음과 같다.
- ( )가 커질수록
→ 분모가 커짐
→ 해당 파라미터의 유효 학습률 감소
즉,
이 구조는 다음 효과를 만든다.
- 자주 업데이트되는 파라미터 → 학습률 자동 감소
- 드물게 업데이트되는 파라미터 → 상대적으로 큰 학습률 유지
이는 희소 특징 학습에 매우 유리하다.
7.4 기하학적 관점: 대각선 Hessian 근사
AdaGrad는 암묵적으로 다음을 수행한다.
- 손실 함수의 곡률(curvature)을 파라미터별로 추정
- Hessian의 대각 성분만 근사적으로 반영
즉, AdaGrad는 다음과 같이 해석할 수 있다.
“기울기가 자주 크던 방향은 조심스럽게,
거의 변하지 않던 방향은 과감하게 움직이자.”
이는 SGD + Momentum 계열과 명확히 다른 관점이다.
7.5 AdaGrad의 결정적 한계
AdaGrad는 개념적으로 매우 강력했지만, 실무에서는 치명적인 문제가 드러났다.
(1) 누적합의 비가역성
- 한 번 커진 ( )는 절대 줄어들지 않음
- 학습이 진행될수록 분모가 계속 증가
결과적으로:
- 학습률이 점점 0에 수렴
- 아직 수렴하지 않은 지점에서도 업데이트가 사실상 멈춤
(2) 비정상(non-stationary) 환경에 부적합
딥러닝 학습에서는:
- 초반과 후반의 gradient 특성이 크게 다름
AdaGrad는 아주 오래된 gradient까지 동일하게 기억하므로,
현재 상황을 제대로 반영하지 못한다.
AdaGrad의 실패는 다음 질문으로 이어진다.
“과거 gradient를 모두 기억할 필요가 있을까?”
“최근 gradient에 더 집중할 수는 없을까?”
이 질문에 대한 해답이 바로 RMSProp이다.
- 누적합 → 지수 이동 평균
- 학습률이 0으로 붕괴되는 문제 해결
8. RMSProp
AdaGrad는 파라미터별 학습률이라는 중요한 돌파구를 열었지만,
“과거 gradient를 모두 기억한다”는 설계 때문에 학습이 조기에 멈추는 치명적인 한계를 드러냈다.
RMSProp은 이 문제를 다음과 같이 재정의한다.
“과거 gradient가 중요하긴 한데,
모두 동일하게 중요할 필요는 있지 않다.”
즉, RMSProp은 비정상(non-stationary) 환경에서의 통계적 추정 문제로 최적화를 다시 바라본다.
8.1 AdaGrad 실패의 본질적 원인
AdaGrad의 누적 변수는 다음과 같다.
이 식은 다음 특성을 가진다.
- 시간 (t)가 증가할수록 단조 증가
- 초반의 gradient와 후반의 gradient를 동일하게 취급
- 현재 손실 지형의 변화 반영 불가
즉, AdaGrad는 시간에 따라 변하는 gradient 분포를 전혀 고려하지 않는다.
8.2 RMSProp의 핵심 아이디어
RMSProp은 AdaGrad의 누적합을 지수 이동 평균(Exponential Moving Average, EMA) 으로 대체한다.
여기서
- ( ): decay rate (보통 0.9 또는 0.99)
8.3 수식적 의미: EMA로서의 분산 추정
RMSProp의 ( h_{t,i} )는 다음과 같이 해석할 수 있다.
즉, RMSProp은 각 파라미터에 대해
- gradient 제곱의 이동 평균
- gradient 분산(scale)에 대한 추정치
를 유지한다.
이로 인해 다음 효과가 발생한다.
- 과거의 오래된 gradient 영향 감소
- 최근 손실 지형에 빠르게 적응
8.4 AdaGrad 대비 개선점
| 항목 | AdaGrad | RMSProp |
|---|---|---|
| 과거 gradient 처리 | 전부 누적 | 지수적으로 감쇠 |
| 학습률 붕괴 | 발생 | 방지 |
| 비정상 환경 적응 | 불가 | 가능 |
| 실무 안정성 | 낮음 | 높음 |
즉, RMSProp은 “너무 많은 기억”이 문제였음을 정확히 짚고 보완한 방법이다.
8.5 RMSProp의 한계
RMSProp은 스케일 문제를 상당히 잘 해결했지만, 여전히 중요한 정보가 빠져 있다.
(1) 방향성 정보의 부재
- RMSProp은 gradient 크기(scale)만 고려
- Momentum처럼 방향의 일관성은 반영하지 않음
즉, RMSProp은 다음 질문에 답하지 못한다.
“어디로 가야 하는지는 알겠는데,
그 방향이 일관된 방향인가?”
(2) 노이즈에 대한 취약성
- 분산은 조절하지만
- 방향 자체는 여전히 noisy한 gradient에 의존
- Momentum / Nesterov → 방향 문제 해결
- AdaGrad / RMSProp → 스케일 문제 해결
“방향과 스케일을 동시에 다룰 수는 없을까?”
9. Adam (Adaptive Moment Estimation)
Adam은 하나의 새로운 아이디어라기보다, 지금까지 등장한 최적화 기법들이 해결하려 했던 문제들을 하나의 수식 체계로 통합한 결과물이다. SGD가 가진 느린 수렴과 불안정성, Momentum 계열이 해결한 방향성 문제, AdaGrad와 RMSProp이 다룬 파라미터별 스케일 문제는 모두 Adam이라는 프레임 안에서 동시에 고려된다.
즉, Adam은 다음과 같은 질문에 대한 종합적인 해답이다.
“경사는 어느 방향으로 가야 하는가?”
“그 방향으로 얼마나 크게 이동해야 하는가?”
Adam은 이 두 질문을 gradient 자체가 아니라, gradient의 통계량을 추정하는 문제로 재정의한다.
9.1 모멘트 추정
Adam의 핵심은 각 파라미터에 대해 두 가지 통계량을 유지하는 것이다.
첫째는 1차 모멘트, 즉 gradient의 평균이다. 이는 Momentum이 하던 역할과 동일하며, 업데이트 방향의 일관성을 확보하는 역할을 한다.
둘째는 2차 모멘트, 즉 gradient 제곱의 평균이다. 이는 RMSProp에서 도입된 개념으로, 파라미터별 gradient 크기(스케일)를 추정한다.
이 두 모멘트는 모두 지수 이동 평균(Exponential Moving Average, EMA)으로 계산된다. 시간 ( t )에서 gradient를 ( )라 하면,
여기서 ( )은 보통 0.9, ( )는 0.999로 설정된다. 이 선택은 최근 gradient의 방향 정보는 비교적 빠르게 반영하고, 분산 정보는 더 안정적으로 추정하겠다는 의미를 담고 있다.
9.2 바이어스 보정이 필요한 이유
Adam의 모멘트 변수 ( )는 0으로 초기화된다. 이로 인해 학습 초반에는 EMA 특성상 추정치가 실제보다 작게 계산되는 초기 바이어스(bias) 가 발생한다.
이를 보정하지 않으면 초반 학습 단계에서 업데이트가 과도하게 작아지고, Adam의 장점이 충분히 발휘되지 않는다.
이를 해결하기 위해 Adam은 다음과 같은 바이어스 보정식을 적용한다.
이 보정은 단순한 트릭이 아니라, Adam이 통계적으로 의미 있는 모멘트 추정기임을 보여주는 중요한 요소다.
9.3 Adam의 최종 업데이트 식
바이어스가 보정된 모멘트를 이용한 Adam의 파라미터 업데이트 식은 다음과 같다.
이 수식 하나에는 지금까지의 최적화 기법이 해결해 온 핵심 문제가 모두 녹아 있다.
- Momentum을 통한 방향 안정성
- RMSProp을 통한 파라미터별 스케일 조절
- 비정상적인 손실 지형에 대한 적응
- 학습 초반의 불안정성 완화
이 때문에 Adam은 실무에서 “기본값(default optimizer)”으로 널리 사용된다.
9.4 Adam의 구조적 한계: Weight Decay 문제
Adam의 학습 속도와 안정성에도 불구하고, 실무에서는 한 가지 중요한 문제가 관찰된다.
바로 정규화(regularization)가 의도한 방식으로 동작하지 않을 수 있다는 점이다.
일반적으로 L2 정규화는 손실 함수에 다음 항을 추가하는 방식으로 구현된다.
이 경우 gradient는
가 된다.
SGD에서는 이 항이 모든 파라미터를 동일한 비율로 줄이는 균등한 수축(shrinkage) 으로 작동한다. 그러나 Adam에서는 gradient가 모멘트와 분산으로 변환되기 때문에, 이 정규화 항마저도 파라미터별로 서로 다른 스케일을 갖게 된다.
그 결과, Adam에서의 weight decay는
“모든 가중치를 일정 비율로 줄인다”는 원래의 의미를 잃고,
gradient 통계에 따라 왜곡된 형태로 적용된다.
이는 Adam이 훈련 데이터에서는 빠르게 수렴하지만, 테스트 성능에서는 불안정해지는 현상의 주요 원인 중 하나로 지목된다.
9.5 AdamW: 최적화와 정규화의 분리
AdamW는 이 문제를 매우 단순한 질문으로 환원한다.
“Weight decay는 최적화 문제가 아니라,
파라미터 크기를 제어하는 규칙 아닌가?”
이에 따라 AdamW는 gradient 기반 업데이트와 weight decay를 완전히 분리한다.
먼저 Adam 방식으로 파라미터를 업데이트하고,
그 다음, gradient와 무관하게 weight decay를 적용한다.
이렇게 함으로써 AdamW는
Adam의 빠른 수렴 특성과 SGD에서 의도한 정규화 효과를 동시에 유지한다.
10. 초기화와 최적화의 상호작용
딥러닝 학습은 흔히 “좋은 모델 구조 + 좋은 optimizer”의 문제로 단순화되곤 한다. 그러나 실제로 학습의 성패를 좌우하는 것은 초기화와 최적화가 함께 만들어내는 학습 동역학(dynamics) 이다.
이 챕터에서는 지금까지 다룬 내용을 바탕으로, 초기화와 최적화가 어떻게 상호작용하는지, 그리고 실무에서 어떤 기준으로 최적화 기법을 선택해야 하는지를 정리한다.
10.1 초기화와 최적화는 독립적인 문제가 아니다
가중치 초기화는 단순히 “시작점”을 정하는 문제가 아니다.
초기화는 학습 초반의 손실 지형과 gradient 분포를 결정하고, 이는 곧 optimizer가 어떤 정보를 보게 되는지를 결정한다.
예를 들어,
-
잘못된 초기화
→ 활성화 값 포화
→ gradient vanishing
→ 어떤 optimizer를 써도 학습 불가 -
Xavier / He 초기화
→ 층별 분산 안정
→ gradient 신호 유지
→ optimizer가 제 역할을 수행할 수 있는 환경 제공
즉, 초기화는 optimizer의 성능을 발휘 가능하게 만드는 전제 조건이다.
10.2 SGD 계열은 언제 사용하면 좋은가
SGD와 그 변형(Momentum, Nesterov)은 구조적으로 단순하다.
또는 방향성을 보완한 형태일 뿐이다. 이 단순함은 다음과 같은 상황에서 강점으로 작용한다.
SGD 계열이 유리한 경우
- 데이터가 충분히 많고
- 학습 시간이 상대적으로 길어도 괜찮으며
- 일반화 성능이 중요한 경우
SGD는 gradient의 노이즈를 그대로 유지한다. 이 노이즈는 단점처럼 보이지만, 실제로는 날카로운(local sharp) 최소점에 빠지는 것을 방지하고, 더 평평한(flat) 최소점으로 이동하게 만든다.
이 때문에 다음과 같은 경험적 관찰이 자주 성립한다.
“SGD는 느리게 학습되지만, 테스트 성능은 더 좋다.”
10.3 Adam 계열은 언제 사용하면 좋은가
Adam과 AdamW는 다음과 같은 환경에서 특히 강력하다.
- 학습 초반이 불안정한 경우
- gradient 스케일이 파라미터마다 크게 다른 경우
- 비정상(non-stationary) 손실 지형
- 빠른 수렴이 중요한 경우
Adam 계열은 파라미터별로 학습률을 자동 조절하고, 방향성과 스케일을 동시에 고려한다. 그 결과, 하이퍼파라미터 튜닝 부담이 낮고, “일단 잘 돌아가는 모델”을 빠르게 얻을 수 있다.
그래서 실무에서는 흔히 다음 전략을 취한다.
- 초기 실험 → Adam / AdamW
- 모델 검증 후 → SGD 계열로 전환 여부 검토
10.4 왜 AdamW가 기본값이 되었는가
앞 장에서 보았듯이, AdamW는 Adam의 구조적 문제였던 weight decay 왜곡을 해결한다. 이는 단순한 성능 개선이 아니라, 최적화와 정규화의 역할을 명확히 분리했다는 점에서 의미가 크다.
현재의 딥러닝 학습 환경은 다음과 같은 특성을 가진다.
- 매우 깊은 모델
- LayerNorm, Residual Connection 등으로 gradient 흐름이 복잡
- 대규모 데이터와 배치
이 환경에서는 AdamW의 다음 특성이 특히 중요하다.
- 안정적인 초기 학습
- 명확한 정규화 해석
- 큰 모델에서도 일관된 동작
이로 인해 AdamW는 현재 사실상의 표준(default optimizer)로 자리 잡았다.
10.5 선택 가이드
| 상황 | 권장 선택 |
|---|---|
| 빠른 프로토타이핑 | Adam / AdamW |
| 대규모 모델, Transformer | AdamW |
| 일반화 성능 최우선 | SGD + Momentum |
| 충분한 데이터, 긴 학습 | SGD 계열 |
| 하이퍼파라미터 튜닝 최소화 | Adam 계열 |