1. 상태(State)
Stateful vs Stateless
서버가 클라이언트의 이전 요청 정보를 기억하느냐의 차이다.
Stateful — 상대를 기억한다
서버가 클라이언트의 상태를 저장하고 유지한다. 이전 요청의 맥락을 알기 때문에 연속적인 흐름이 가능하다.
- 장점: 맞춤형 서비스 제공 가능, 복잡한 흐름 제어 가능
- 단점: 서버가 상태를 계속 기억해야 함, 사용자가 많아질수록 부담 증가, 특정 서버에 종속되어 수평 확장 어려움
- 사례: TCP 연결, 로그인 세션, 온라인 게임 서버
Stateless — 상대를 기억하지 않는다
모든 요청은 독립적이다. 서버는 이전 요청을 전혀 기억하지 않으며, 클라이언트가 매 요청마다 필요한 정보를 모두 담아 보내야 한다.
- 장점: 서버 부담 적음, 수평 확장 편리함(어느 서버가 처리해도 결과가 같으므로), 처리 속도 빠름
- 단점: 요청마다 보낼 정보가 많아짐, 사용자별 서비스 구현 어려움
- 보완책: Cookie, Session, JWT
- 사례: HTTP, REST API
HTTP는 Stateless + Connectionless다.
개발 초기 메모리 비용이 높았고, 수많은 요청을 처리해야 했기 때문에 상태를 저장하지 않고 연결도 유지하지 않는 구조를 채택했다.
2. 연결(Connection)
Connection-oriented vs Connectionless
| Connection-oriented | Connectionless | |
|---|---|---|
| 연결 유지 | O | X |
| 자원 사용 | 높음 | 낮음 |
| 여러 명 동시 처리 | 어려움 | 용이함 |
| 적합한 상황 | 실시간 통신 | 일반 웹 요청 |
Connectionless의 단점 보완
매번 연결을 새로 맺는 비용(TCP 3-way Handshake)이 발생한다. 이를 해결하기 위해:
- HTTP/1.1: Keep-Alive 도입 (연결을 일정 시간 유지)
- HTTP/2: 하나의 연결로 여러 요청을 동시에 처리
3. WebSocket
HTTP의 한계
HTTP는 Stateless + Connectionless이기 때문에 서버가 먼저 클라이언트에게 데이터를 보낼 수 없다.
이게 문제가 되는 상황:
- 카카오톡: 상대방이 메시지를 보냈을 때 서버가 즉시 알려줘야 함
- 주식 실시간 시세: 가격이 바뀔 때마다 서버가 클라이언트에 밀어줘야 함
- 온라인 게임: 양방향 실시간 데이터 교환
WebSocket이란?
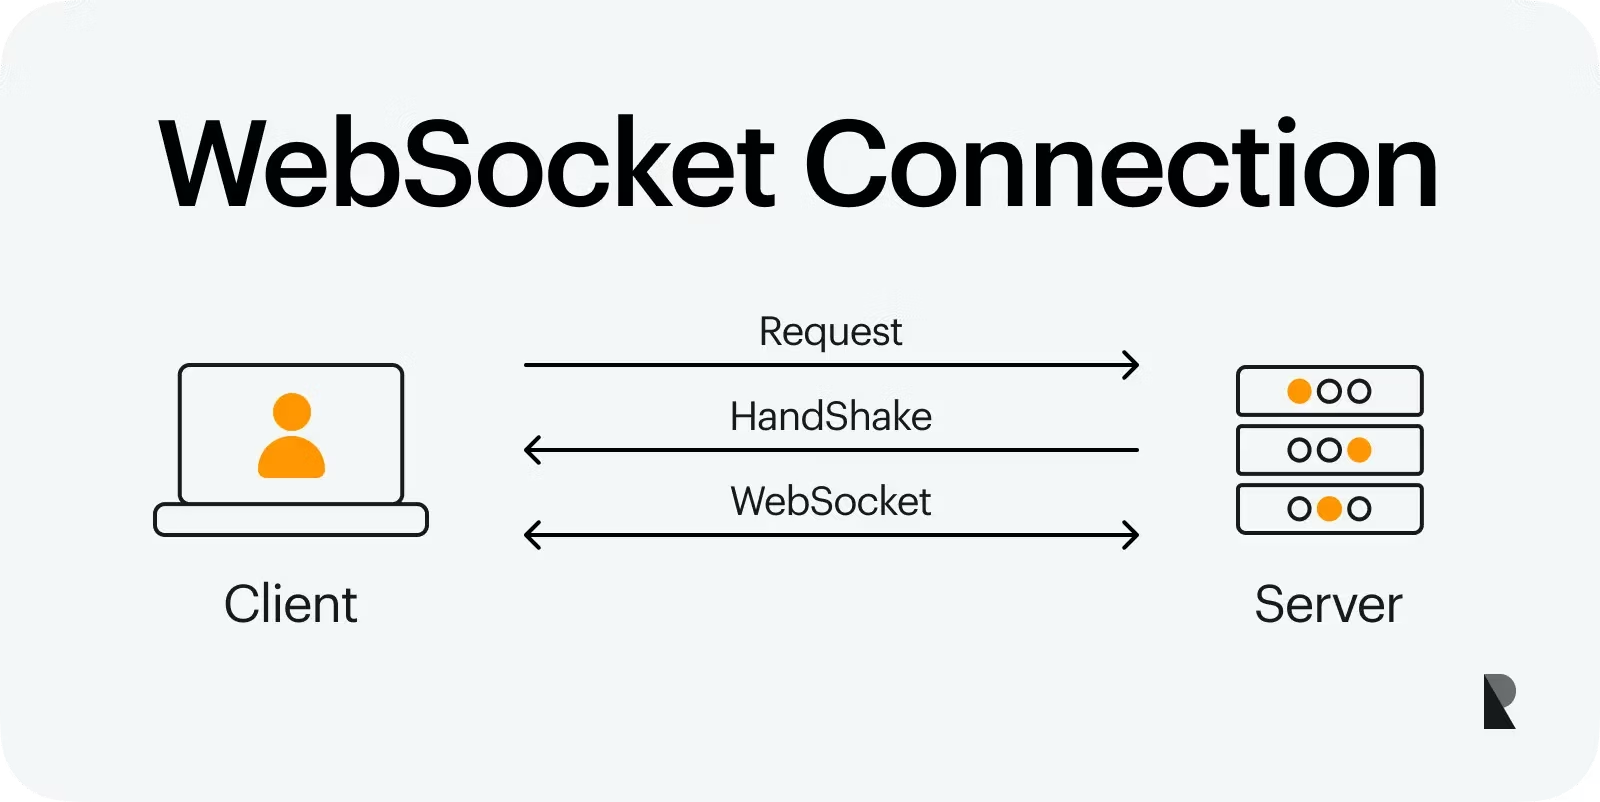
하나의 TCP 연결 위에서 양방향 통신을 가능하게 하는 프로토콜.
HTTP로 시작해 프로토콜을 갈아타는 방식(Handshake)으로 연결을 수립한다.
클라이언트 → 서버: Upgrade 요청 (HTTP)
서버 → 클라이언트: 101 Switching Protocols
이후: WebSocket 프레임으로 양방향 통신
HTTP vs WebSocket 비교
| HTTP | WebSocket | |
|---|---|---|
| 통신 방향 | 단방향 (클라이언트→서버) | 양방향 |
| 연결 | 요청마다 끊김 | 유지 |
| 상태 | Stateless | Stateful |
| 프로토콜 시작 | HTTP | HTTP → WS로 교체 |
| URL scheme | http:// https:// | ws:// wss:// |
| 오버헤드 | 매 요청마다 헤더 전송 | 헤더 없이 프레임만 |
| 용도 | 일반 웹 페이지, API | 실시간 통신 |
WebSocket 단점
- 연결 유지 비용 높음 (동시 접속자 수만큼 소켓 유지)
- 수평 확장 어려움 (특정 서버에 연결된 유저에게만 메시지 전달 가능 → Redis Pub/Sub 등 필요)
- 중간 장비 문제: 일부 프록시·방화벽이 오래된 연결을 강제로 끊음 → Ping/Pong으로 연결 유지
프록시(Proxy): 클라이언트와 서버 사이의 중간 서버. 캐싱, 보안 필터링, 로드밸런싱 역할을 한다.
4. 인증과 인가
개념 구분
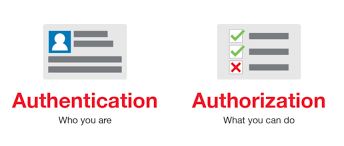
- 인증(Authentication): "너 누구야?" — 사용자의 신원을 확인하는 절차 (ex. 로그인)
- 인가(Authorization): "너 여기 들어와도 돼?" — 인증된 사용자에게 권한을 부여하는 것 (ex. 관리자만 유저 목록 조회 가능)
순서: 인증 → 인가. 누구인지 모르는데 권한을 줄 수 없다.
인증 구현 방식 3가지
| 방식 | 특징 | 문제점 |
|---|---|---|
| 매번 ID/PW 전송 | 구현 간단 | PW가 매번 네트워크를 타고 다님 → 보안 취약 |
| 세션 | 서버가 상태 관리 | 서버 확장 어려움 (Stateful) |
| JWT | 클라이언트가 토큰 보관 | 토큰 탈취 시 만료 전까지 막을 수 없음 |
쿠키(Cookie)
브라우저에 저장되는 작은 텍스트 파일. 서버가 발급하고, 이후 요청마다 브라우저가 자동으로 첨부한다.
1. 유저가 사이트 방문
2. 서버: "이 쿠키 들고 있어" → 브라우저에 저장
3. 이후 요청마다 브라우저가 쿠키를 자동 첨부
4. 서버: "아 이 사람이구나"- 저장 대상: 방문 기록, 장바구니, 언어 설정 등 노출되어도 되는 정보
- 개발자 도구에서 누구나 확인 가능 → 보안성 낮음
- 실무에서는
HttpOnly,Secure,SameSite옵션을 반드시 설정해야 한다
세션(Session)
민감한 정보를 서버가 저장하고, 클라이언트에게는 세션ID(열쇠)만 발급한다.
로그인 → 서버가 세션 생성
서버 저장소: { "abc123": { user: "홍길동", role: "admin" } }
클라이언트: 세션ID "abc123"만 보유

다음 요청:
클라이언트 ──[Cookie: sessionId=abc123]──▶ 서버
서버: abc123 조회 → "홍길동이네" → 인증 완료
세션 저장 방식
| 방식 | 특징 |
|---|---|
| In Memory | RAM에 저장. 빠르지만 서버 재시작 시 사라짐. 실무에서 단독 사용 안 함 |
| Redis (In Memory DB) | 빠르면서 서버 여러 대가 공유 가능. 실무 표준 |
| File Storage | 디스크에 저장. 느림 |
취약점: Session Hijacking
세션ID가 탈취되면 공격자가 정상 유저로 인증을 통과할 수 있다. HttpOnly, Secure 쿠키 옵션으로 완화할 수 있다.
5. 프레임워크와 라이브러리
핵심 차이: 제어권이 어디 있느냐
| 프레임워크 | 라이브러리 | |
|---|---|---|
| 제어권 | 프레임워크가 내 코드를 호출 | 내가 라이브러리를 호출 |
| 강제성 | 규칙을 따라야 함 | 필요한 것만 골라 씀 |
| 키워드 | 일관성 | 전문성 |
IoC(제어의 역전): 프레임워크의 핵심 특징. "내가 프레임워크를 쓰는 게 아니라, 프레임워크가 내 코드를 갖다 쓴다."
프레임워크
개발을 위한 구조와 규칙을 제공. 개발자는 그 안에서 비즈니스 로직만 채운다.
- 예시: Express.js (라우팅·미들웨어 구조), Spring (DI·MVC 구조)
- 팀 프로젝트에서 누가 짜도 같은 구조 → 유지보수 용이
라이브러리
특정 기능을 구현해둔 코드 모음. 필요할 때 꺼내 쓴다.
- 예시: axios (HTTP 요청), Chart.js (그래프), Socket.IO (실시간 통신)
- "누가 만들었든, 특정 기능을 재사용 가능하게 패키징한 것이면 라이브러리다"
실제 사례
| 이름 | 분류 | 이유 |
|---|---|---|
| Spring | 프레임워크 | 규제와 규약 제공, IoC 적용 |
| React | 라이브러리 | UI 렌더링만 담당, 자율성 보장 |
| Java Collection | 프레임워크 | 자료구조 구조·규칙 제공 |
| Socket.IO | 라이브러리 | 실시간 통신 기능만 제공 |
6. API
정의
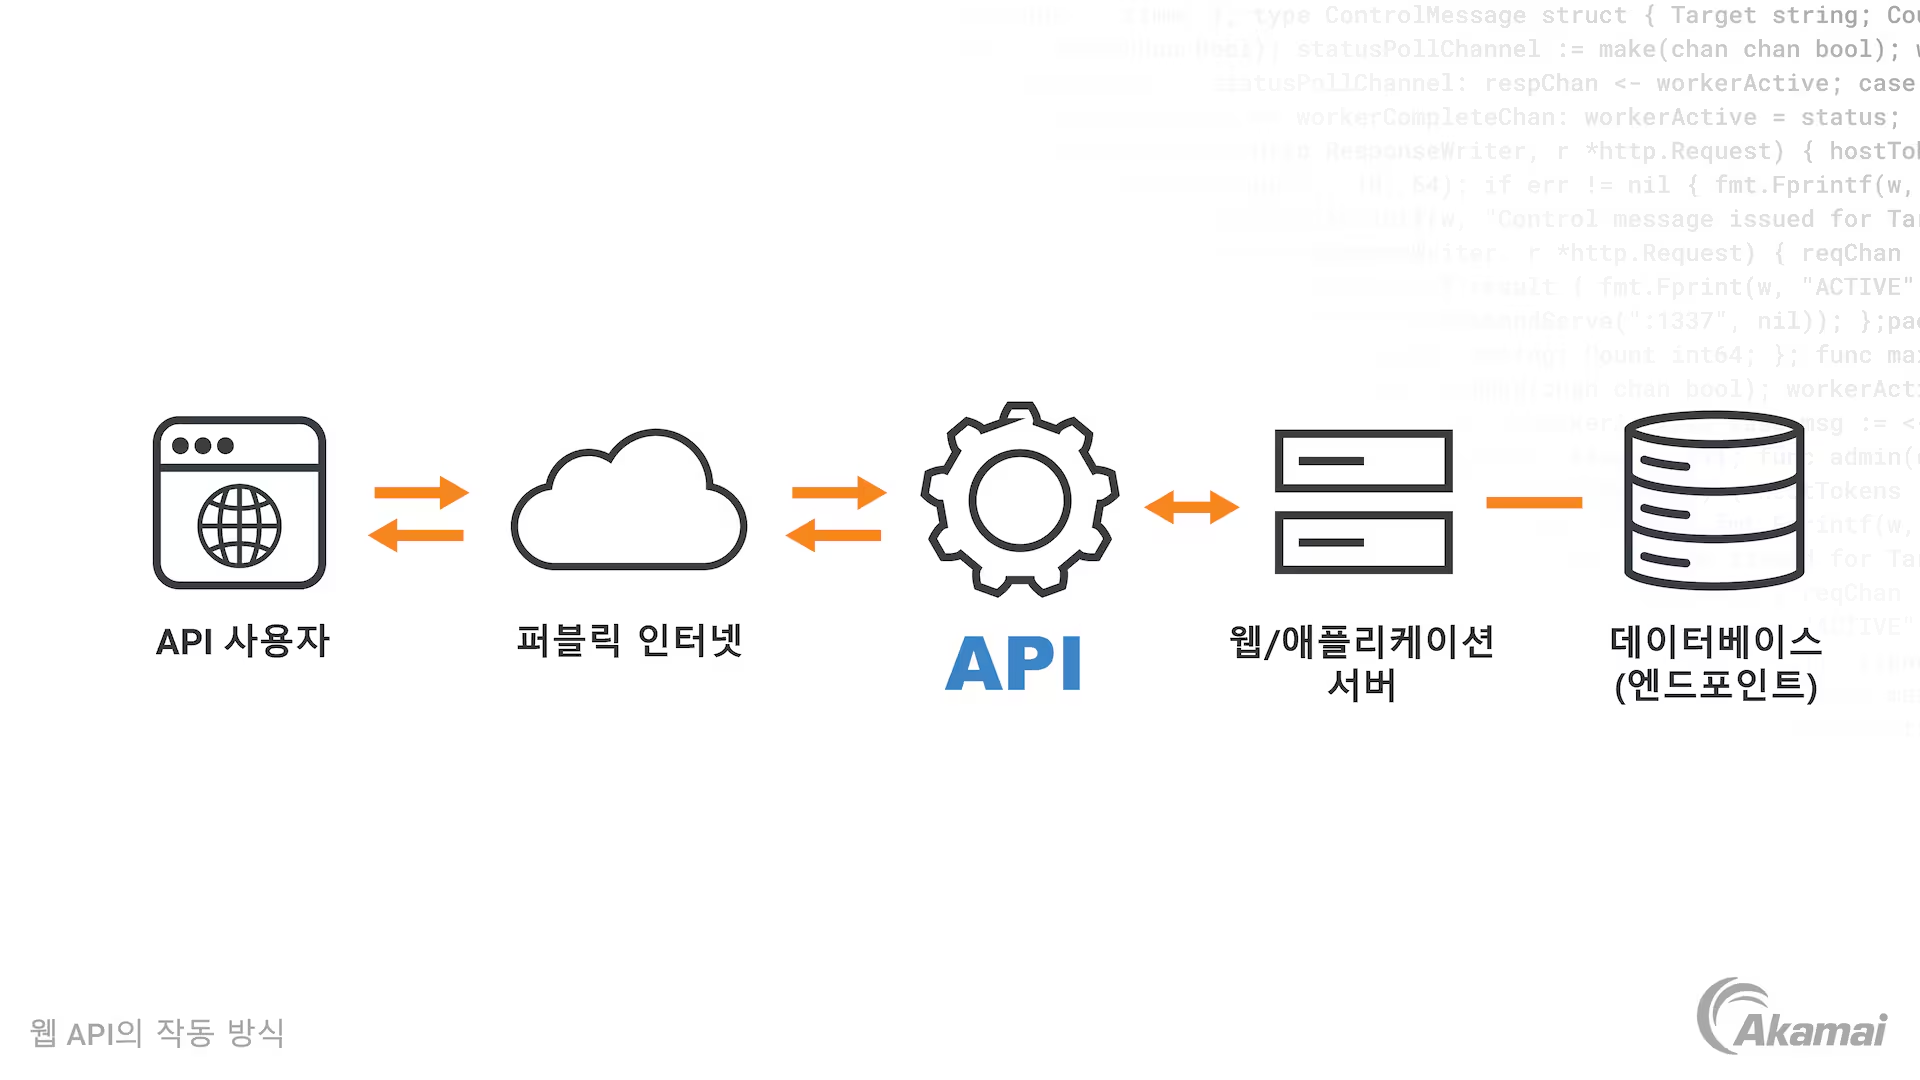
두 프로그램이 서로 통신하기 위해 정의한 규칙과 명세.
"이렇게 요청하면 이렇게 동작한다"는 약속이자 명세서
콘센트 비유: 전력망 내부 구조를 몰라도 규격(220V, 모양)만 맞추면 전기를 쓸 수 있다. API도 마찬가지로, 내부 구현을 몰라도 규칙만 맞추면 기능을 쓸 수 있다.
API Spec vs API Doc vs 라이브러리
| 레고 비유 | 실제 의미 | |
|---|---|---|
| API Spec | 블록의 크기·모양·색상 규격 | "이 URL로, 이 형식으로 요청해라" |
| API Doc | 레고 사용 설명서 | "이 API는 이런 기능이고, 이렇게 쓴다" |
| 라이브러리 | 레고 블록 그 자체 | API Spec대로 실제 구현된 코드 |
REST API
실무에서 "API 만들어"라고 하면 99%는 REST API를 말한다.
| 규칙 | 예시 |
|---|---|
| URL은 자원을 표현 | /users, /products/123 |
| 행위는 HTTP 메서드로 | GET(조회), POST(생성), PUT(수정), DELETE(삭제) |
| Stateless | 매 요청은 독립적 |
7. 페이징(Paging)
왜 필요한가?
데이터를 한 번에 전부 불러오면:
- 서버: DB 전체 조회 → 메모리 폭발
- 네트워크: 대용량 전송 → 느려짐
- 클라이언트: 대량 렌더링 → 브라우저 버벅임
- 사용자: 스크롤 끝도 없음
→ 필요한 만큼만 잘라서 가져오는 것이 페이징이다.
표현 방식
| 페이지네이션 | 인피니티 스크롤 | |
|---|---|---|
| UI | [1][2][3] 번호 클릭 | 스크롤 내리면 자동 로드 |
| 데이터 표시 | 현재 페이지로 교체 | 기존 데이터에 추가 |
| 적합한 곳 | 게시판, 검색결과 | 피드, 타임라인 |
| 대표 사례 | 구글 검색 | 인스타그램, 유튜브 |
구현 방식 5가지
1. Offset-based
SELECT * FROM posts LIMIT 10 OFFSET 20;
-- 20개 건너뛰고 10개 가져와- 구현 간단
- offset이 커질수록 앞에서부터 순서대로 세기 때문에 느려짐
- 데이터 추가·삭제 시 중복·누락 발생 가능
2. Page-based
offset = (page - 1) * limit- 클라이언트가 page 번호로 요청 → 서버가 offset으로 변환
- 내부 동작은 Offset-based와 동일 → 단점도 동일
3. Key-based
-- Offset-based (느림)
SELECT * FROM posts LIMIT 10 OFFSET 1000000;

-- Key-based (빠름)
SELECT * FROM posts WHERE id > 1000000 LIMIT 10;- 인덱스로 바로 접근 → 대용량에서도 빠름
- 데이터 추가·삭제에 안정적 (중복·누락 없음)
- 인피니티 스크롤에 적합
4. Cursor-based
- Key-based이지만 id를 직렬화(Base64 인코딩)해서 클라이언트에 전달
- 클라이언트는 내부 id 값을 알 수 없음 → 보안 강화
- 상태를 클라이언트가 cursor 안에 보관 → Stateless 유지
5. Token-based
- 서버가 마지막으로 본 위치를 저장하고, 클라이언트에게는 토큰만 발급
- 클라이언트는 토큰 내용을 알 수 없음 → 보안 최강
- 서버가 상태를 저장 → Stateful → 확장성 나쁨
방식별 비교
| 방식 | 속도 | 안정성 | 복잡도 | 적합한 상황 |
|---|---|---|---|---|
| Offset | 느림 | 낮음 | 낮음 | 소규모 게시판 |
| Page | 느림 | 낮음 | 낮음 | 페이지 네비게이션 UI |
| Key | 빠름 | 높음 | 중간 | 인피니티 스크롤 |
| Cursor | 빠름 | 높음 | 중간 | 보안이 필요한 피드 |
| Token | 빠름 | 높음 | 높음 | 보안 최우선 |
진화 흐름
Offset → "느리고 중복 생긴다"
    ↓
Key → "빠르고 안정적. 근데 내부 ID가 노출된다"
    ↓
Cursor → "ID를 숨겼다. 근데 Base64라 뚫릴 수 있다"
    ↓
Token → "서버가 저장. 완전히 불투명하다. 근데 Stateful이 됐다"
완벽한 방식은 없다. 각 방식은 이전 방식의 단점을 해결하면서 새로운 트레이드오프를 가져온다.