컴퓨터는 기본적으로 0과 1로만 모든 데이터를 처리한다. 이번 장에서는 0과 1로 여러 가지 타입의 데이터들을 처리하는 법에 대해 다룬다.
1. 핵심 개념 3개
- 컴퓨터는 숫자든 문자든 모든 신호를 이진수의 형태로 변환하여 받아들인다.
- 컴퓨터가 문자를 해석할 수 있게 푸는 과정을 encoding, 컴퓨터가 받아 들인 형태를 다시 인간이 읽을 수 있게 변환하는 과정을 decoding이라고 한다.
- 현대의 표준적인 IT 환경에서는 사실상 99.9% 유니코드(Unicode)를 기준으로 문자를 인식하고 처리한다.
2. 내 말로 개념 풀기
1. 컴퓨터가 숫자를 표현하는 방법
bit는 0과 1을 표현하는 가장 작은 정보 단위다.
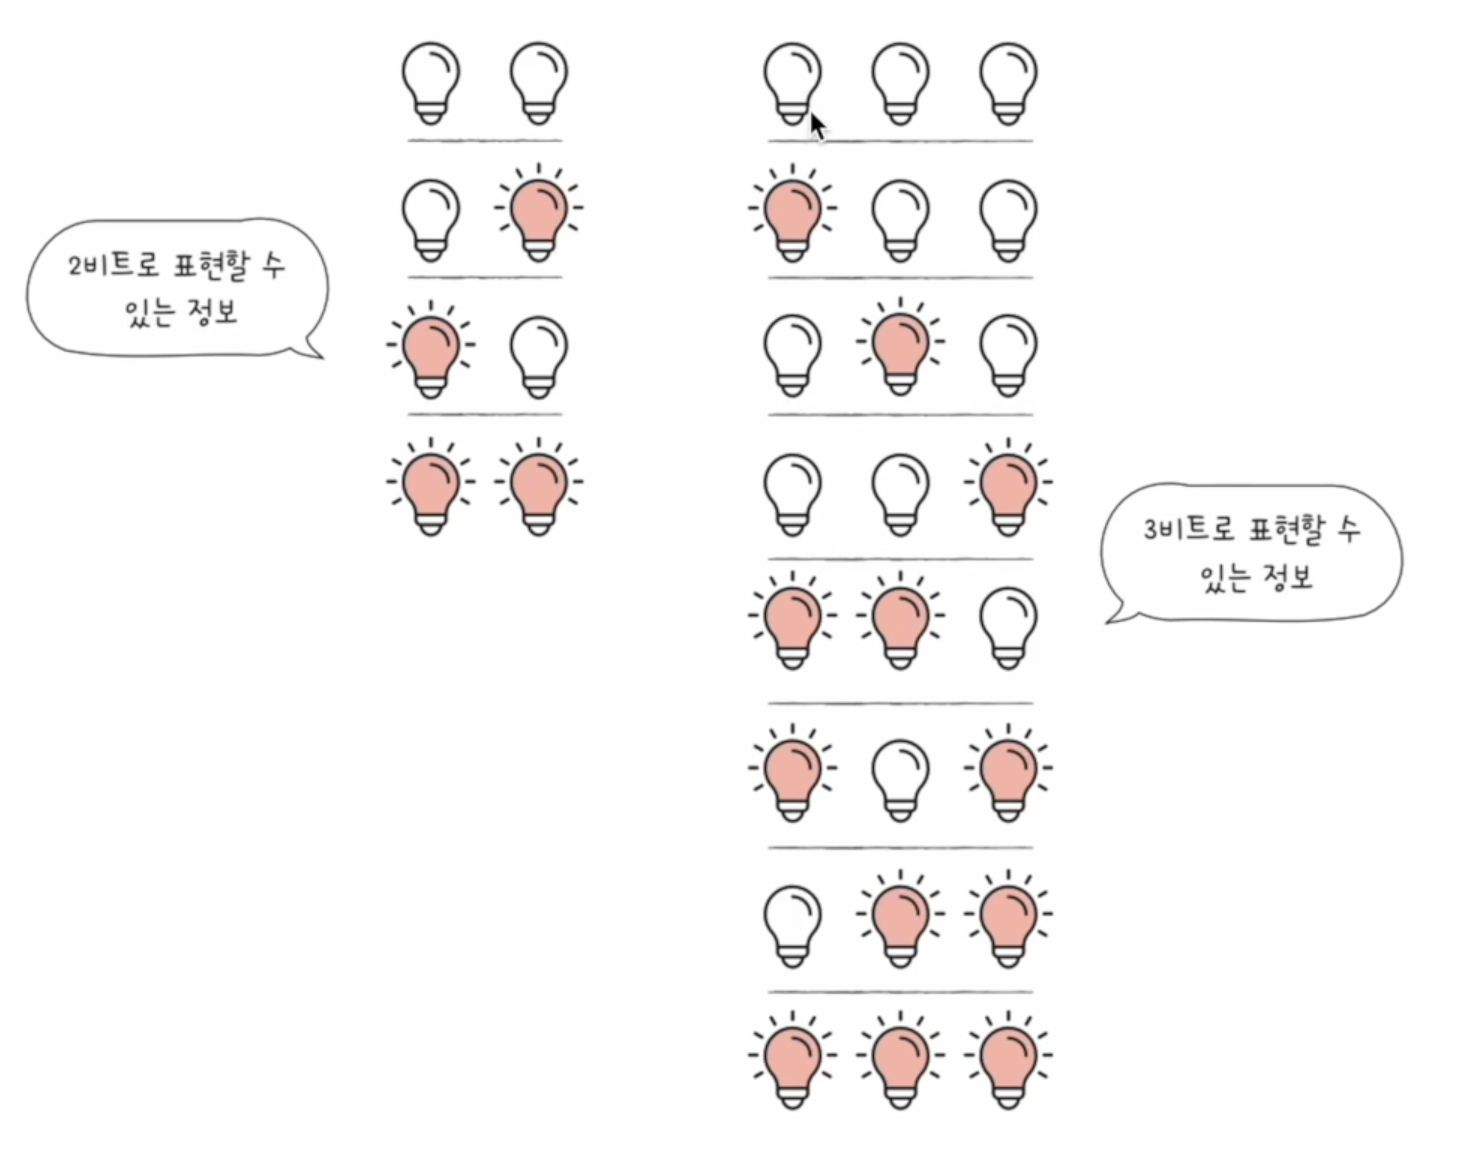
위 그림과 같이 n bit로 2^n가지의 정보 표현이 가능하다. bit가 가장 작은 기본 단위이며, bit 여러 개로 다양한 단위가 다음과 같이 있다.
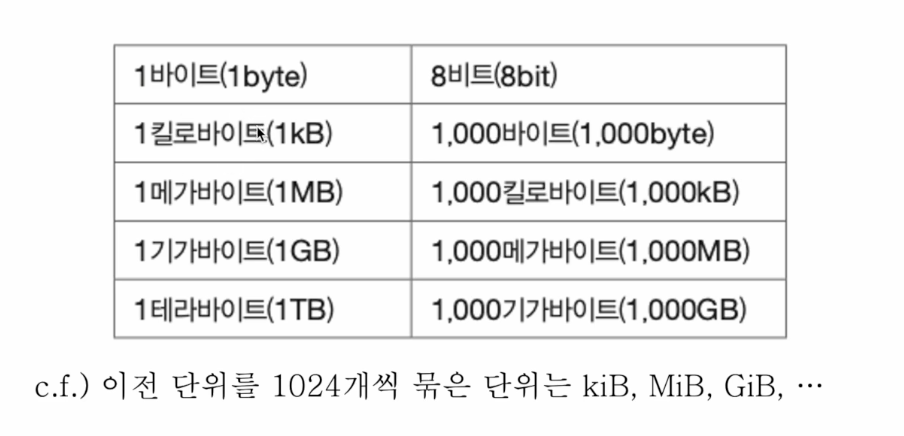
bit, byte, K, M, G, T, 이 순서대로 외우면 된다.
CPU가 한 번에 처리할 수 있는 정보의 크기 단위를 'word'라고 한다.
- Half Word: 워드의 절반 크기
- Full Word: 워드 크기
- Double Word: 워드의 두 배 크기
컴퓨터의 숫자 처리 방법을 이해하기 위해서는 이진법을 이해해야 한다.
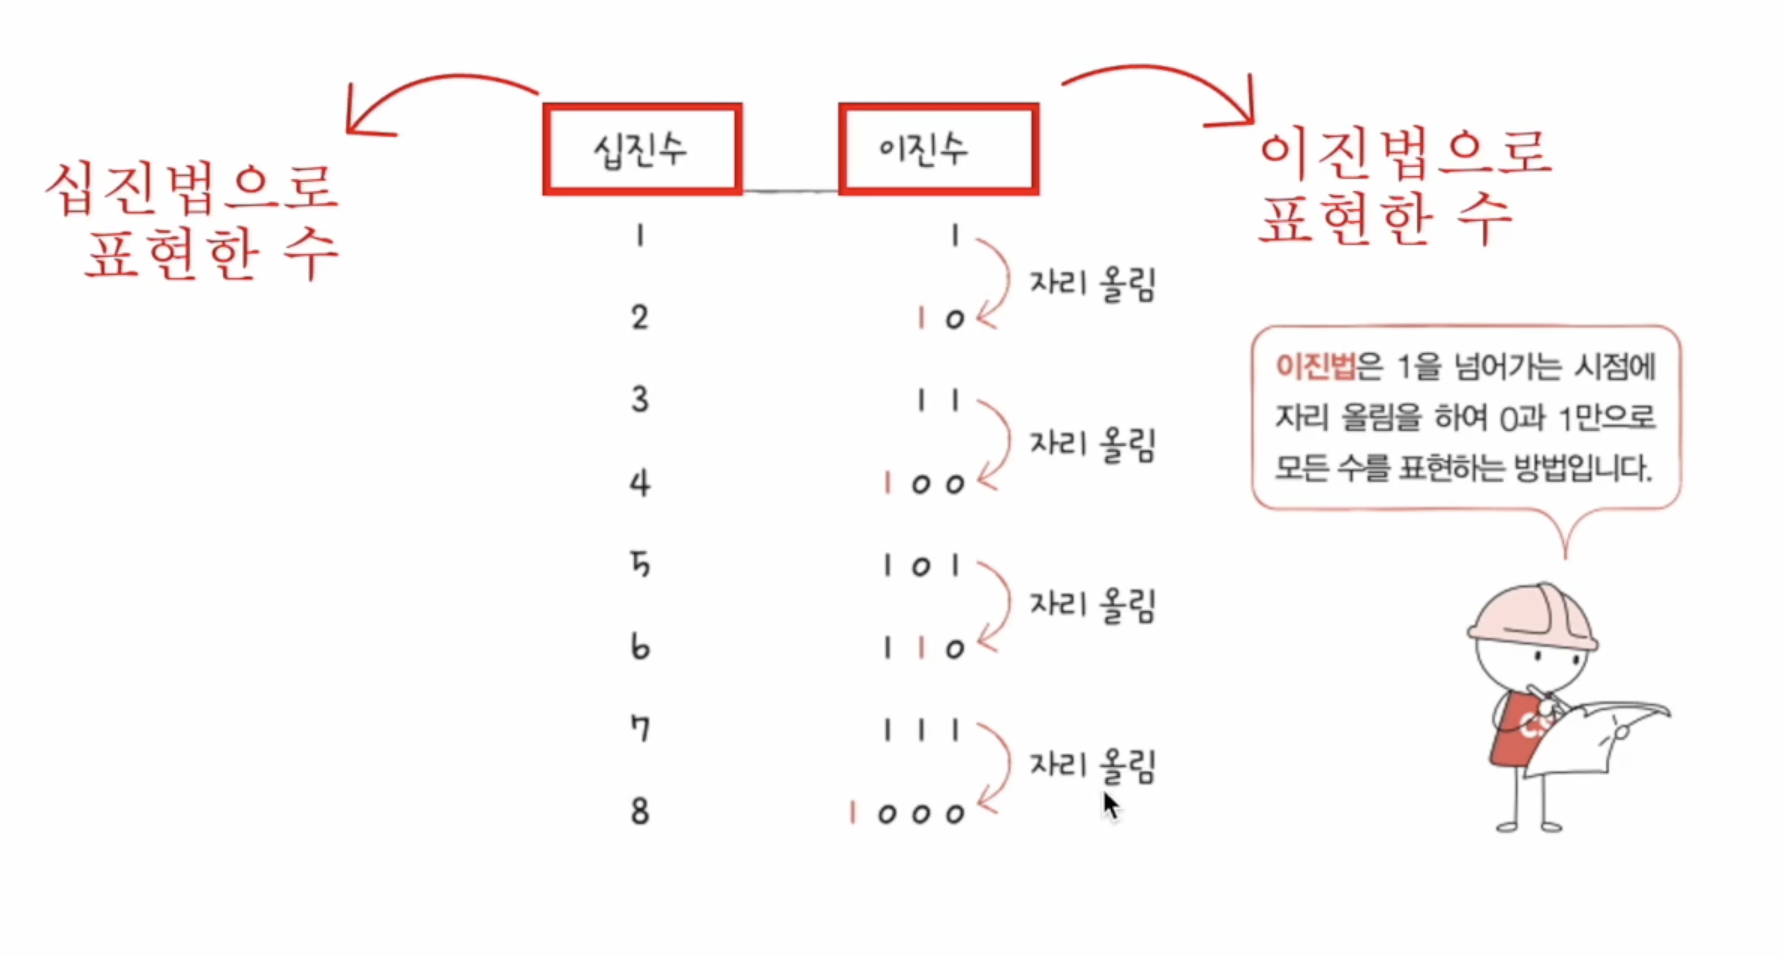
보통 2진법은 1000(2) 또는 0b1000 이런식으로 이진수라는 것을 나타낸다.
이진수로 음수를 표현하는 방법에는 2의 보수가 활용된다.
보수법 자체의 개념은 다소 헷갈리지만, 쉽게 그냥 원래 수의 모든 0과 1을 서로 바꾸고, 마지막에 1만 더해주면 된다.
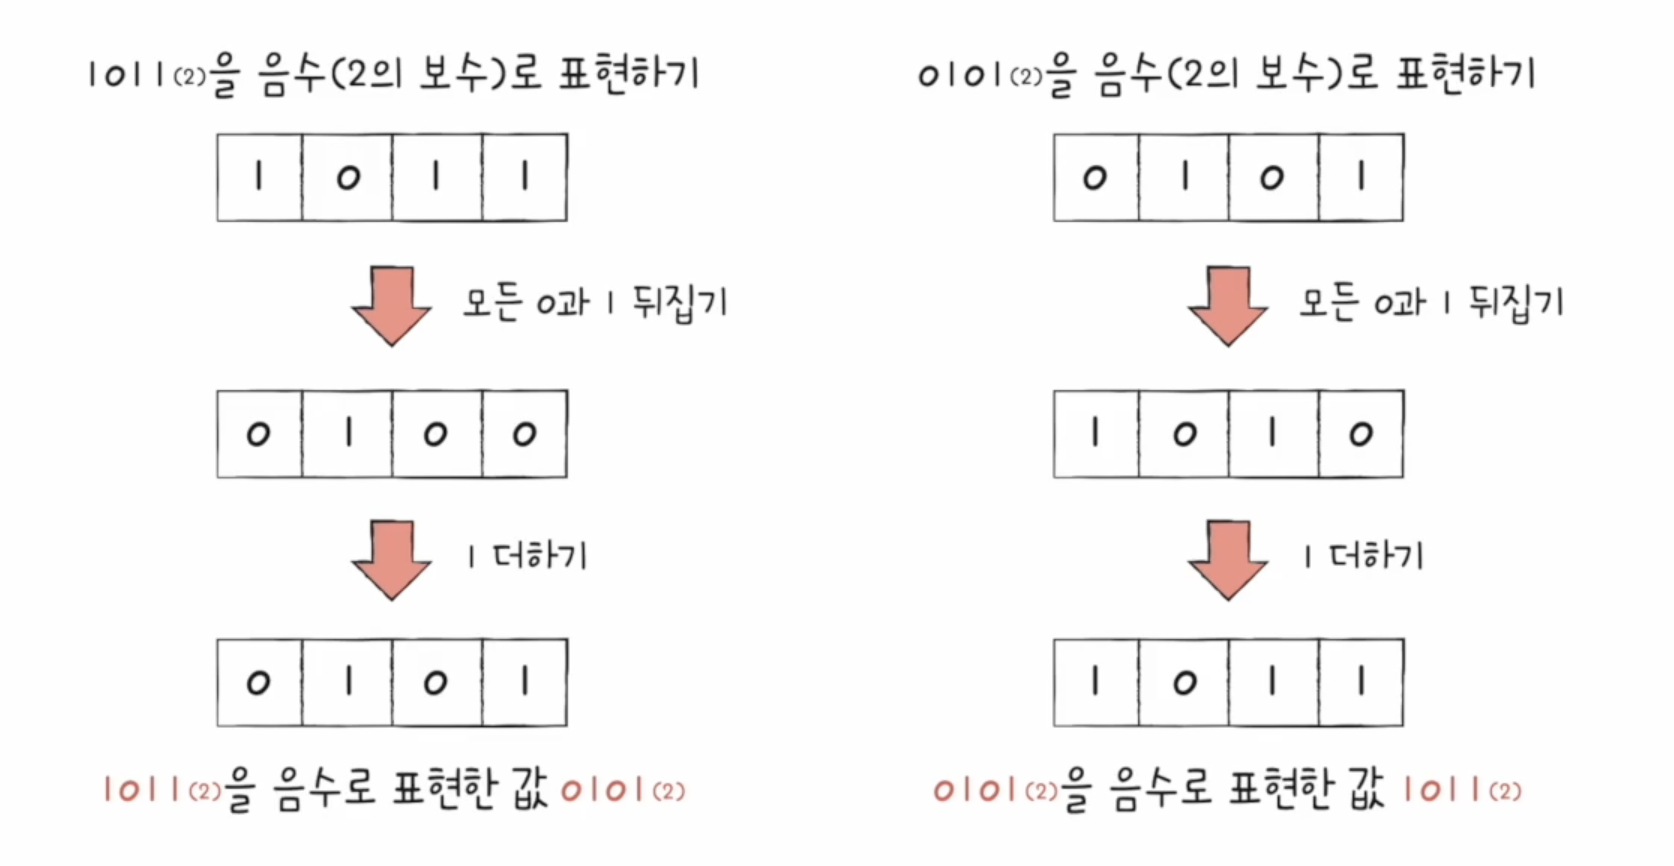
하지만 여기서 궁금증이 생기게 된다. 위 그림에서 1011(2)의 보수는 0101(2)이 되는데, 이를 십진수로 변환하면 5가 된다. 즉, 1011의 보수와 5를 이진법으로 표현한 이진수가 형태가 아예 똑같게 되서 구별이 안되는데, 이를 CPU 내부의 flag register(register의 한 종류)가 이 이진수를 읽어 양수인지 음수인지 판별한다.
이진법으로는 숫자의 길이가 너무 길어져서 16진법도 자주 활용한다.
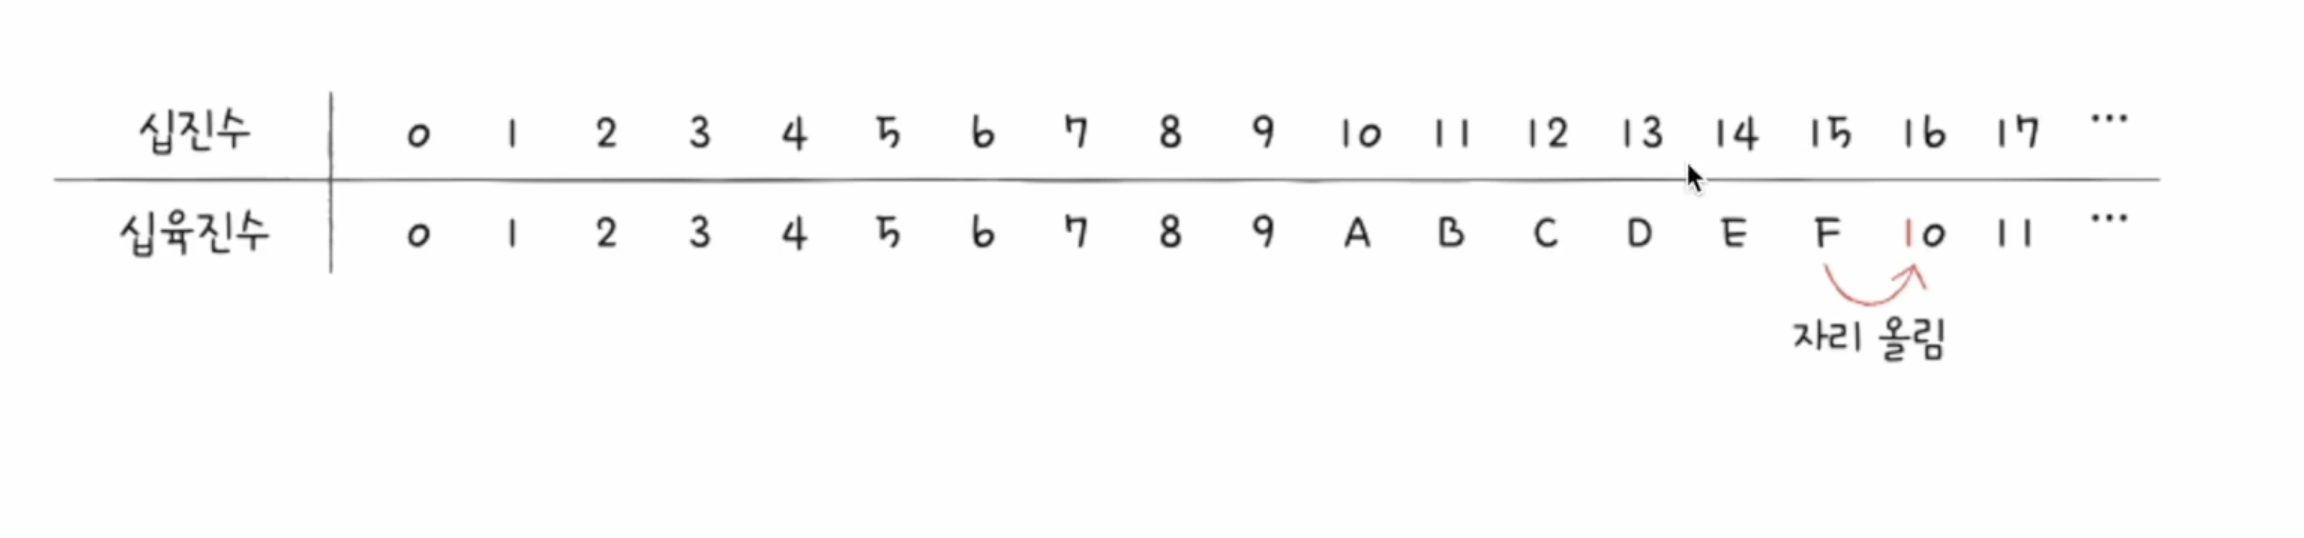
16진법도 15(16) 또는 0x15 이런식으로 표기한다.
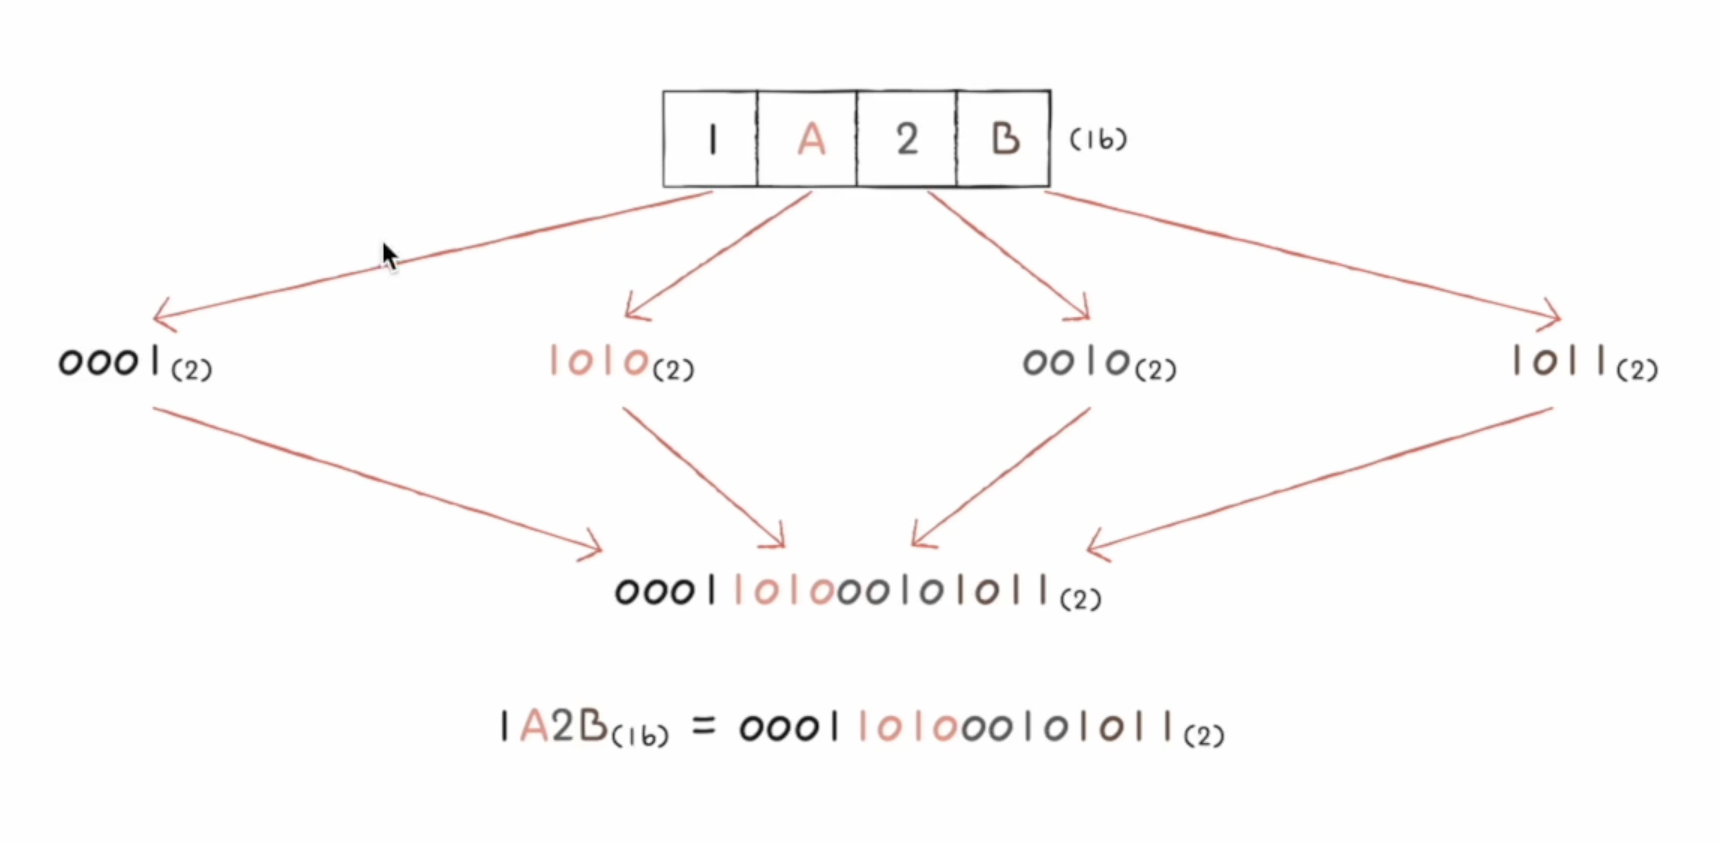
- 이진수를 16진수로 변환하기 위해서는 16진수 하나를 이진수로 변환후에 이어붙이면 된다.
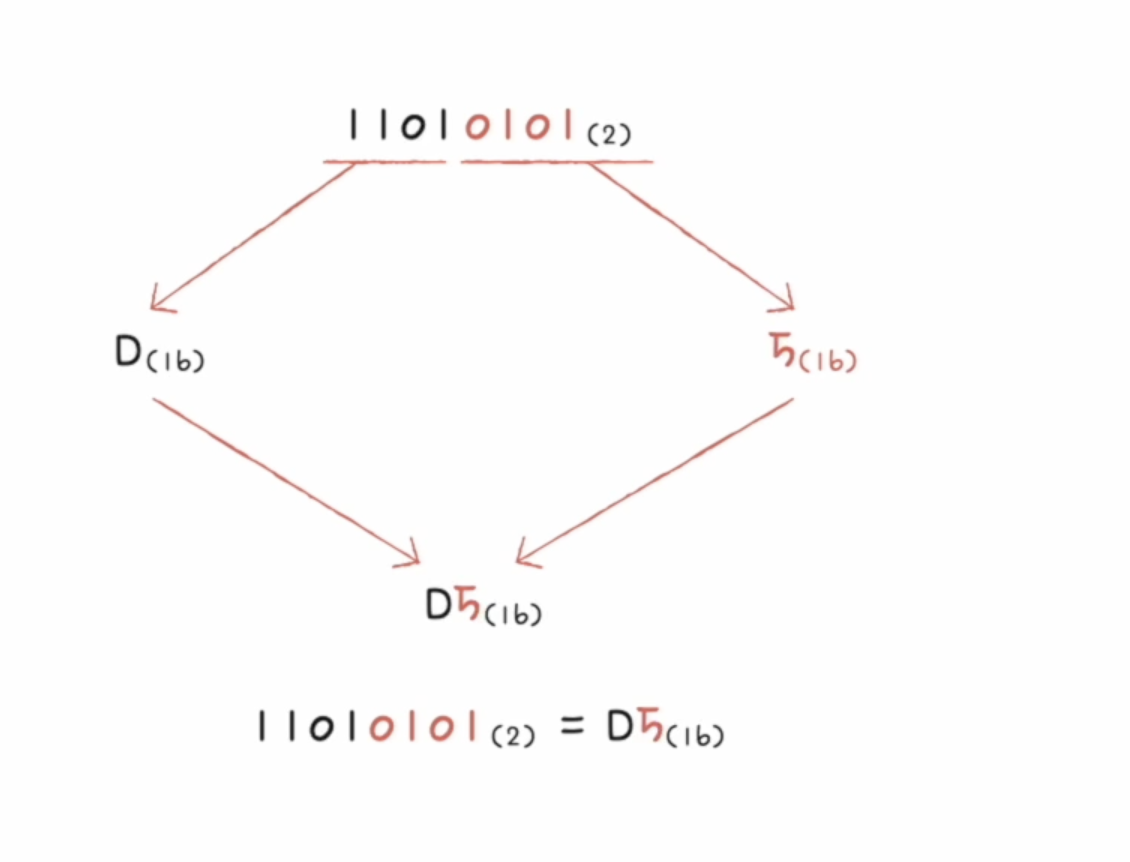
- 16진수를 이진수로 변환하는건 반대로 이진수 4개(4bit)를 16진수로 바로 변환 후 합쳐주면 된다.
2. 컴퓨터가 문자를 표현하는 방법
컴퓨터의 문자 표기를 이해하기 위해서는 문자 집합, encoding과 decoding을 이해해야 한다.
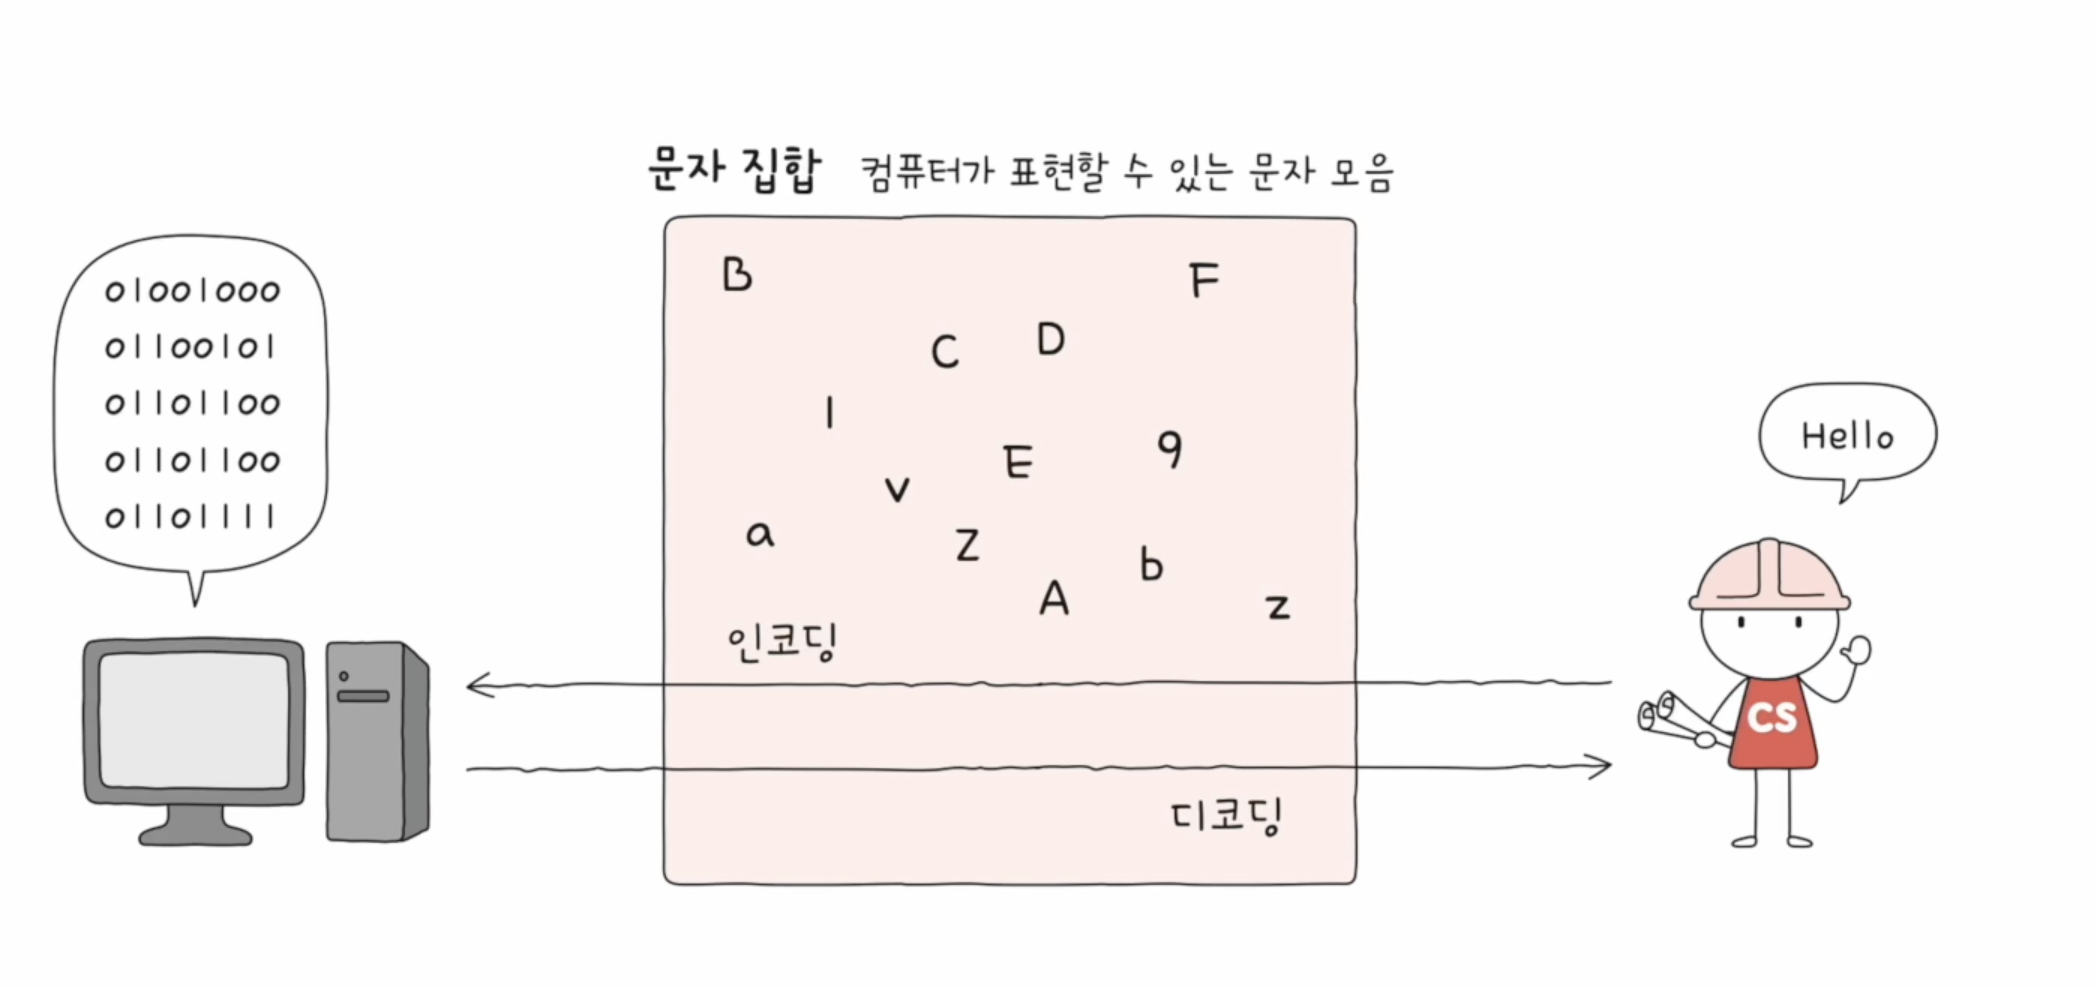
대표적인 문자 집합 중 하나로 ASCIII CODE가 있다.
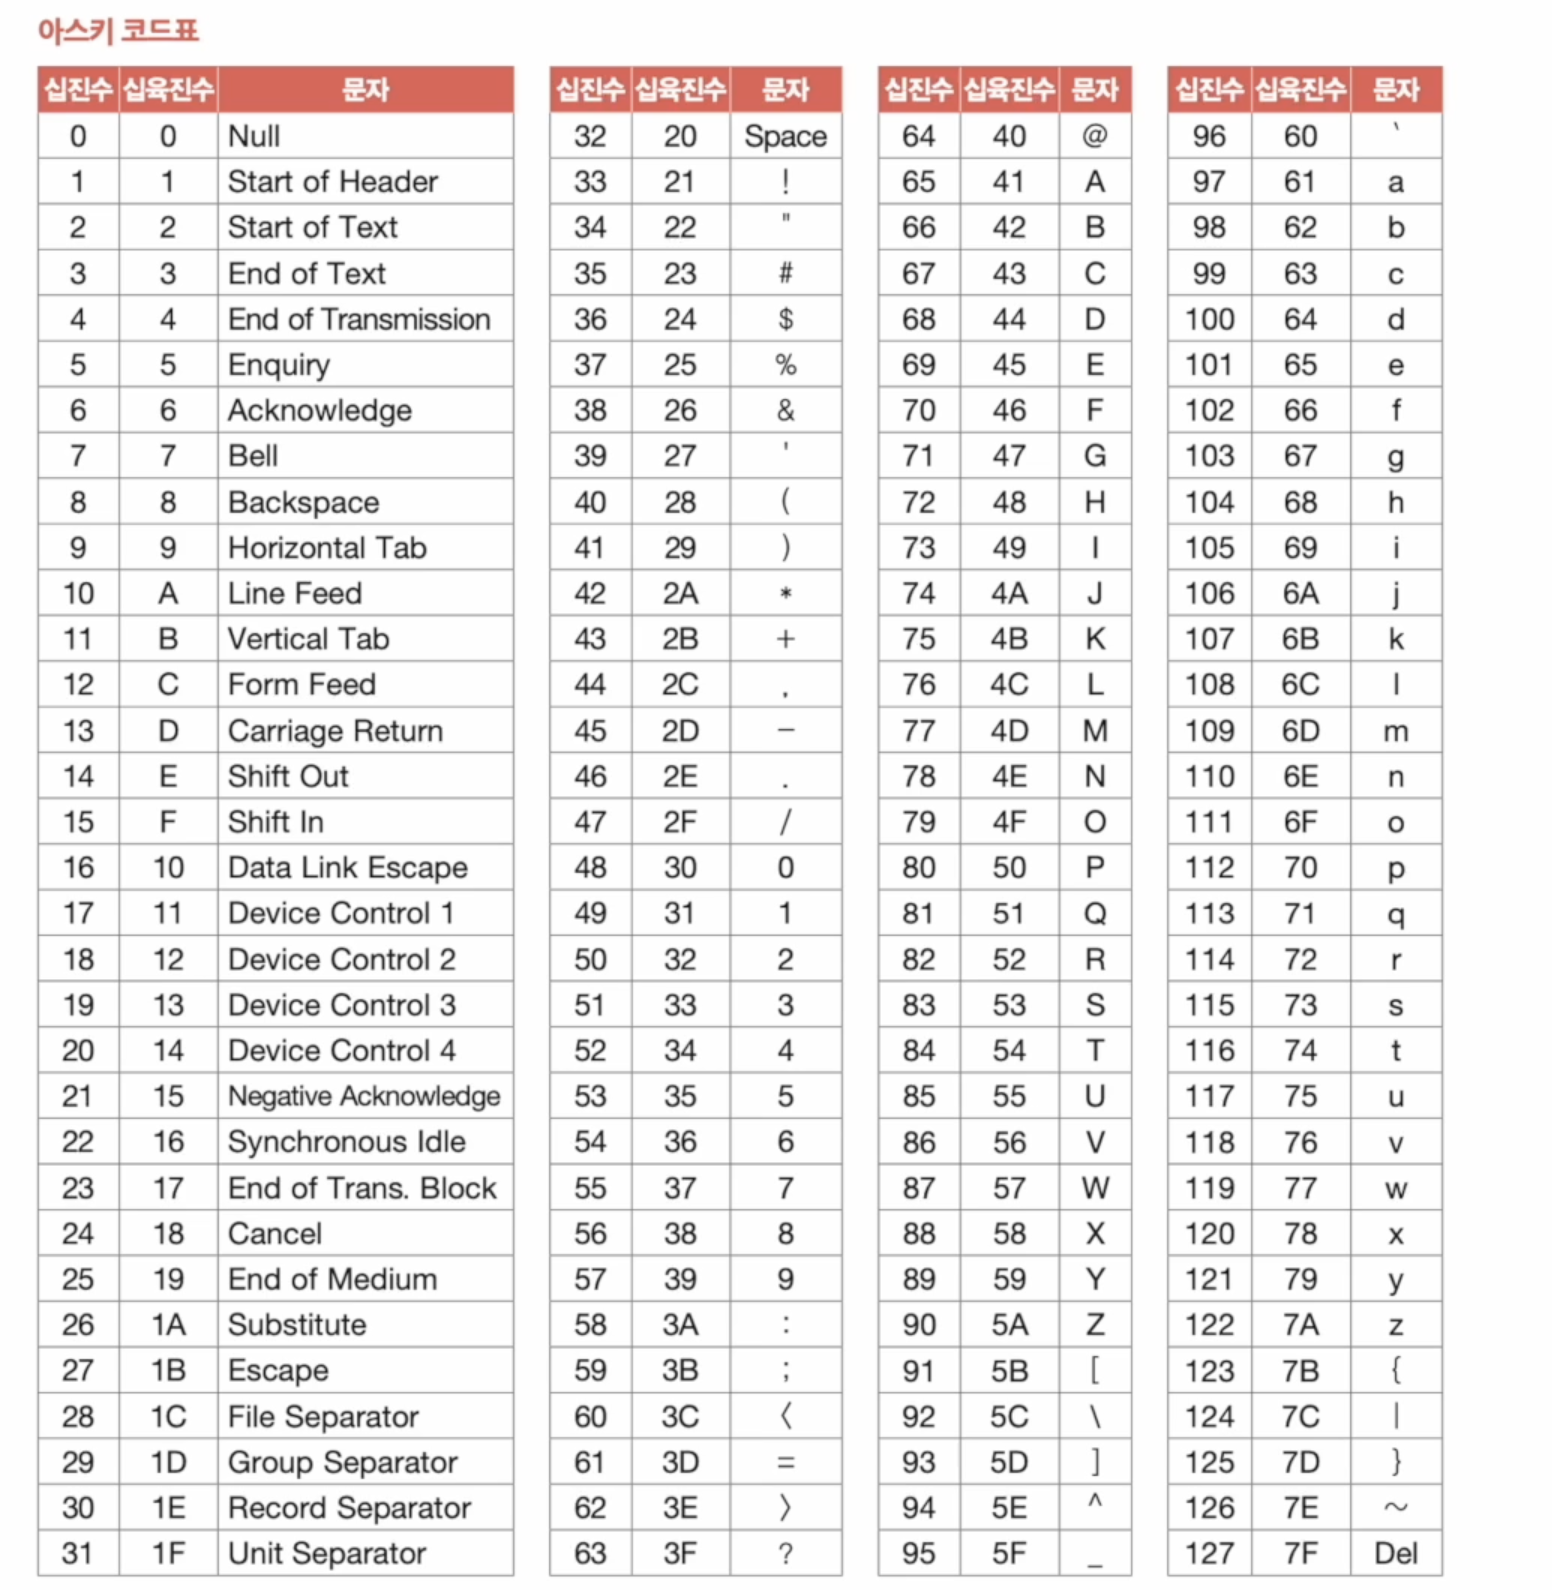
알파벳, 아라비아 숫자, 일부 특수 문자 및 제어 문자를 이용해 표현되고, 8bit 크기로 표현되는데, 실제로는 7bit로 '하나의 문자'를 표현하고 나머지 1bit는 오류 검출을 위해 사용되는 패리티 비트다. 위의 표의 이미지처럼 A는 65로, a는 97로 인코딩되어 컴퓨터는 이 두 가지 문자를 각각 65를 이진수로 변환한 수, 97을 이진수로 변환한 수로 표현한다.
아스키 코드는 인코딩 방식이 간단하지만, 7bit로 하나의 문자를 표현하기에 128개보다 많은 문자를 표현할 수 없어 영어만 표현 가능하고 한글을 포함한 다른 언어 문자나 특수 문자를 표현을 불가능하다. 따라서 각 언어별 인코딩 방식이 존재한다.
한글은 초성, 중성, 종성의 조합으로 이루어져 있기에, 완성형 인코딩 방식과 조합형 인코딩 방식이 존재한다.
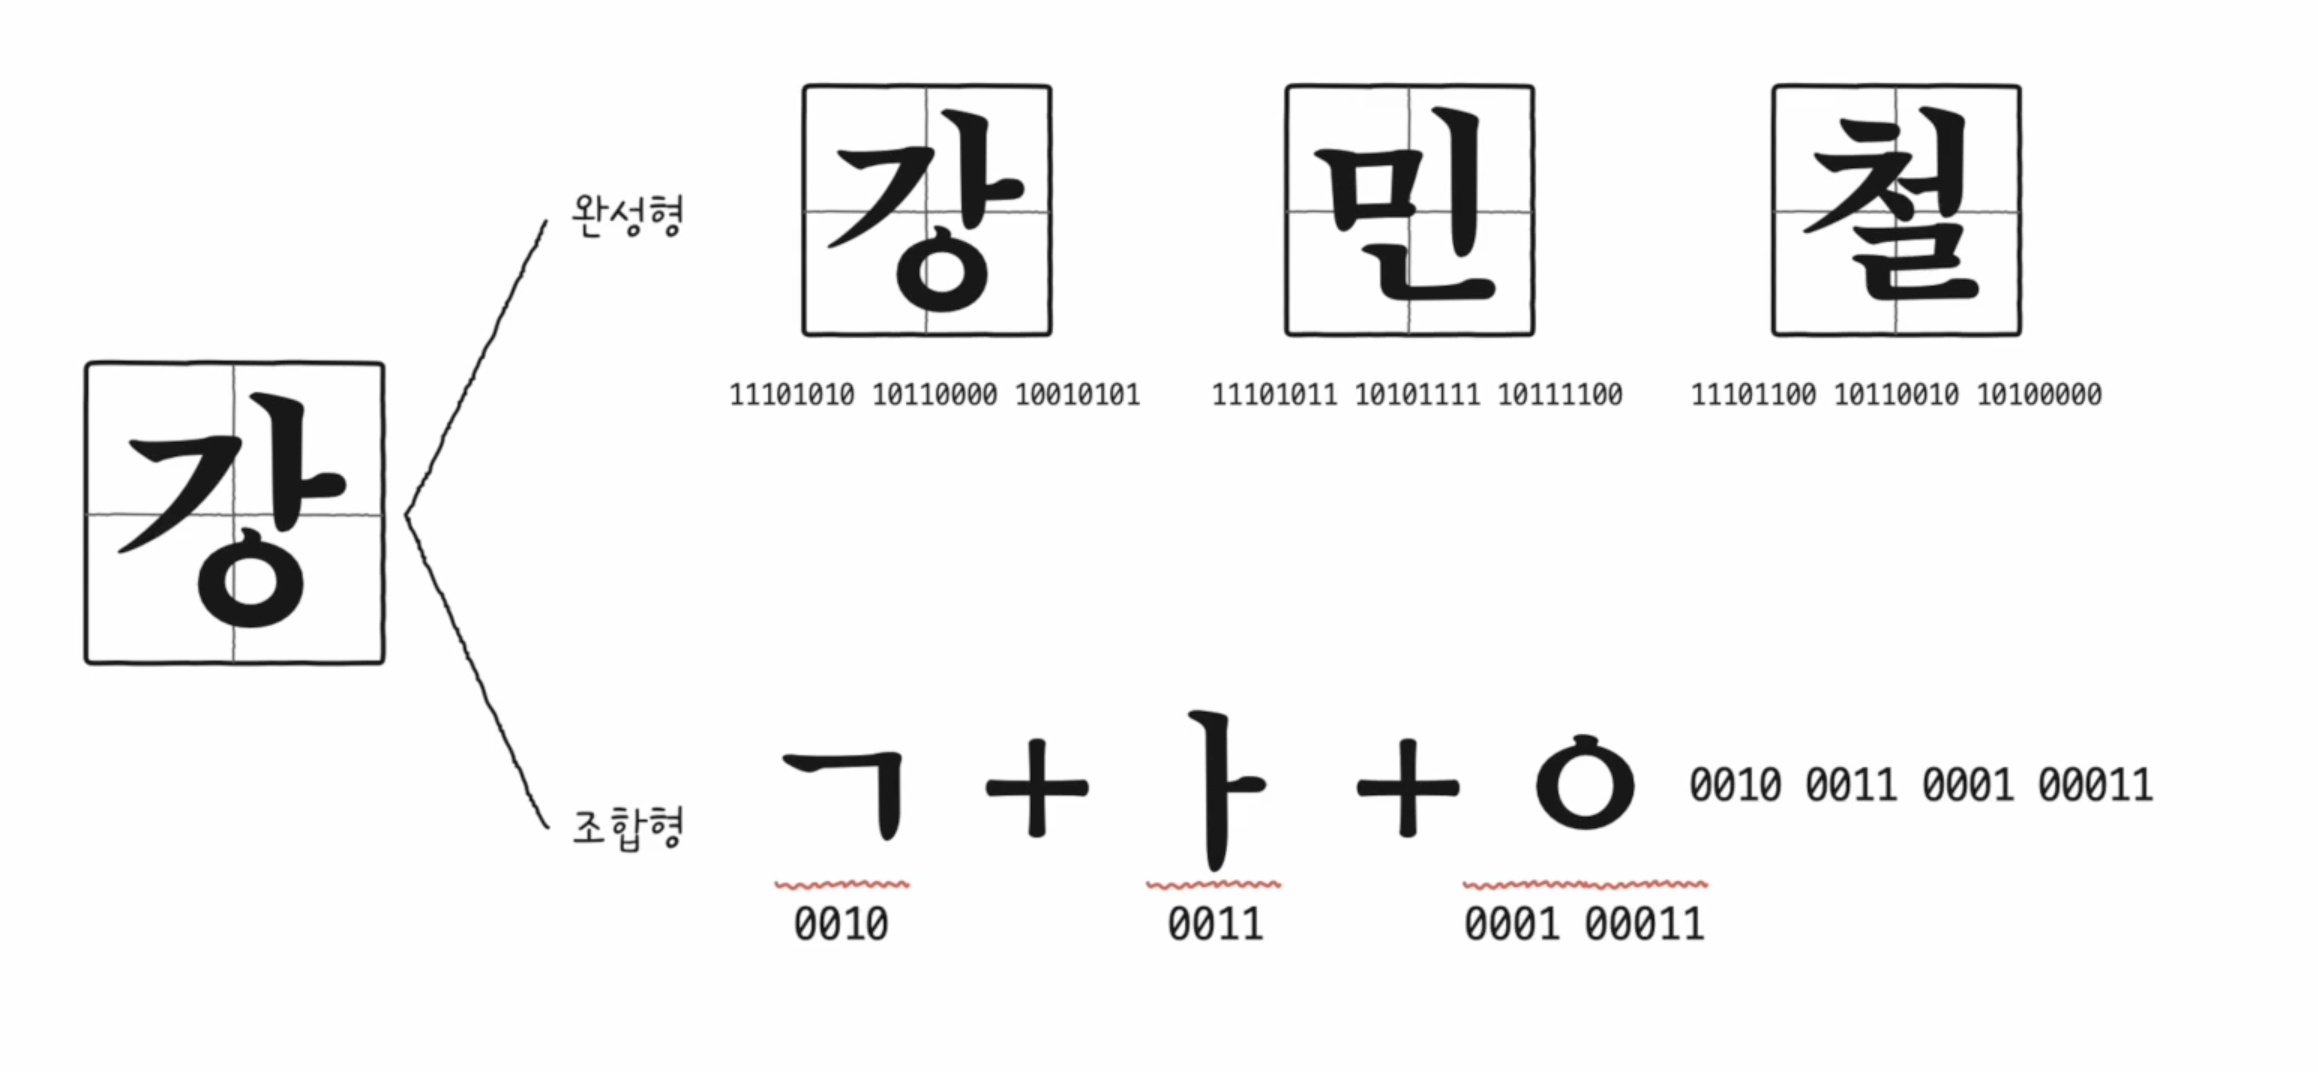
완성형은 글자 하나하나에 코드를 부여하는 방식이고, 조합형은 자음과 모음 하나하나에 코드를 부여해 조합하는 방식이다. 여러 인코딩 방식을 알아보자.
EUC-KR: 글자 하나 하나에 2byte 크기의 코드를 부여하는 완성형 인코딩 방식이다.
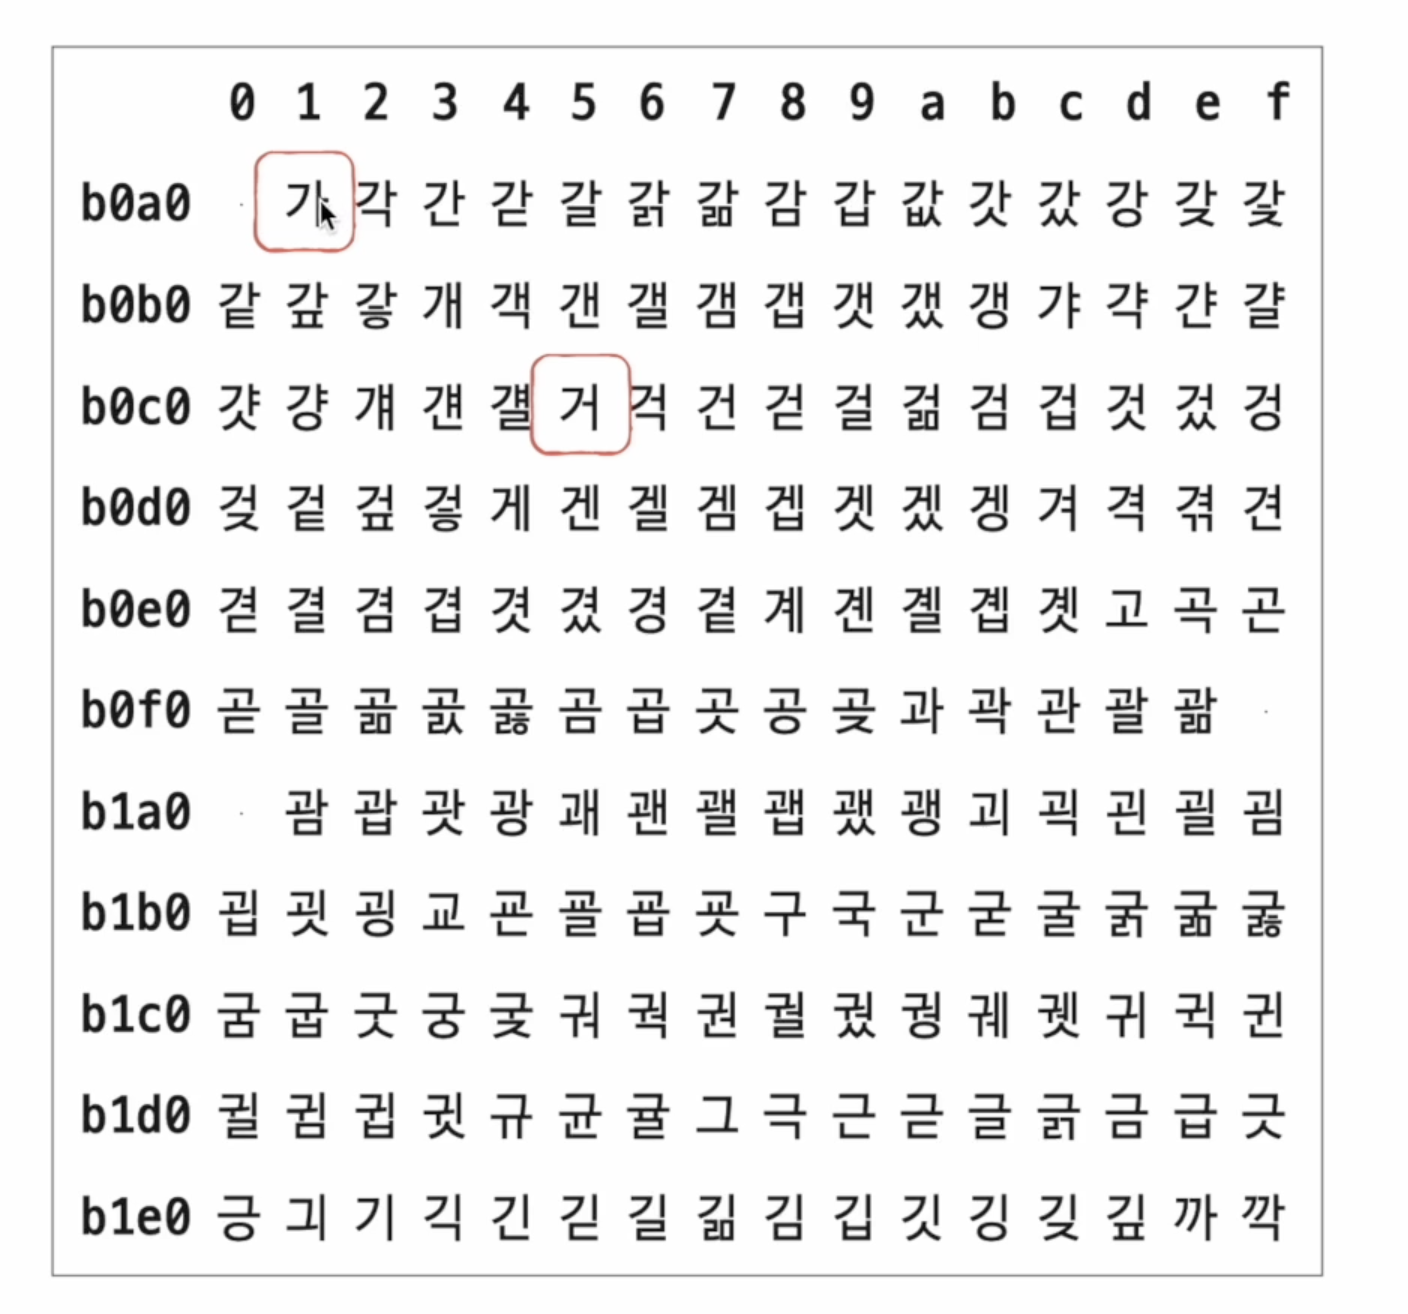
'가'는 b0a01로 인코딩되는 식이다. 16bit기에 16진수로 표현된다. 이 방식으로 2350개 정도의 한글 표현이 가능한데, 이것만으로는 인코딩되지 않는 한글 문자도 있긴 하다. 이런식으로 언어별 인코딩 방식을 쓰게 되면 다중 언어 시스템을 개발할 때 번거로움이 생길 수 있게 된다.
유니코드 문자 집합이라는 통일된 문자 집합이 이러한 문제를 해결한다.
유니코드는 통일된 문자 집합으로, 한글, 영어, 화살표와 같은 특수 문자, 이모티콘까지 표현 가능해서 현대 문자 표현에 있어 제일 많이 활용되는 방식이다. 유니코드의 인코딩 방식에 utf-8, utf-16, 등이 있다.
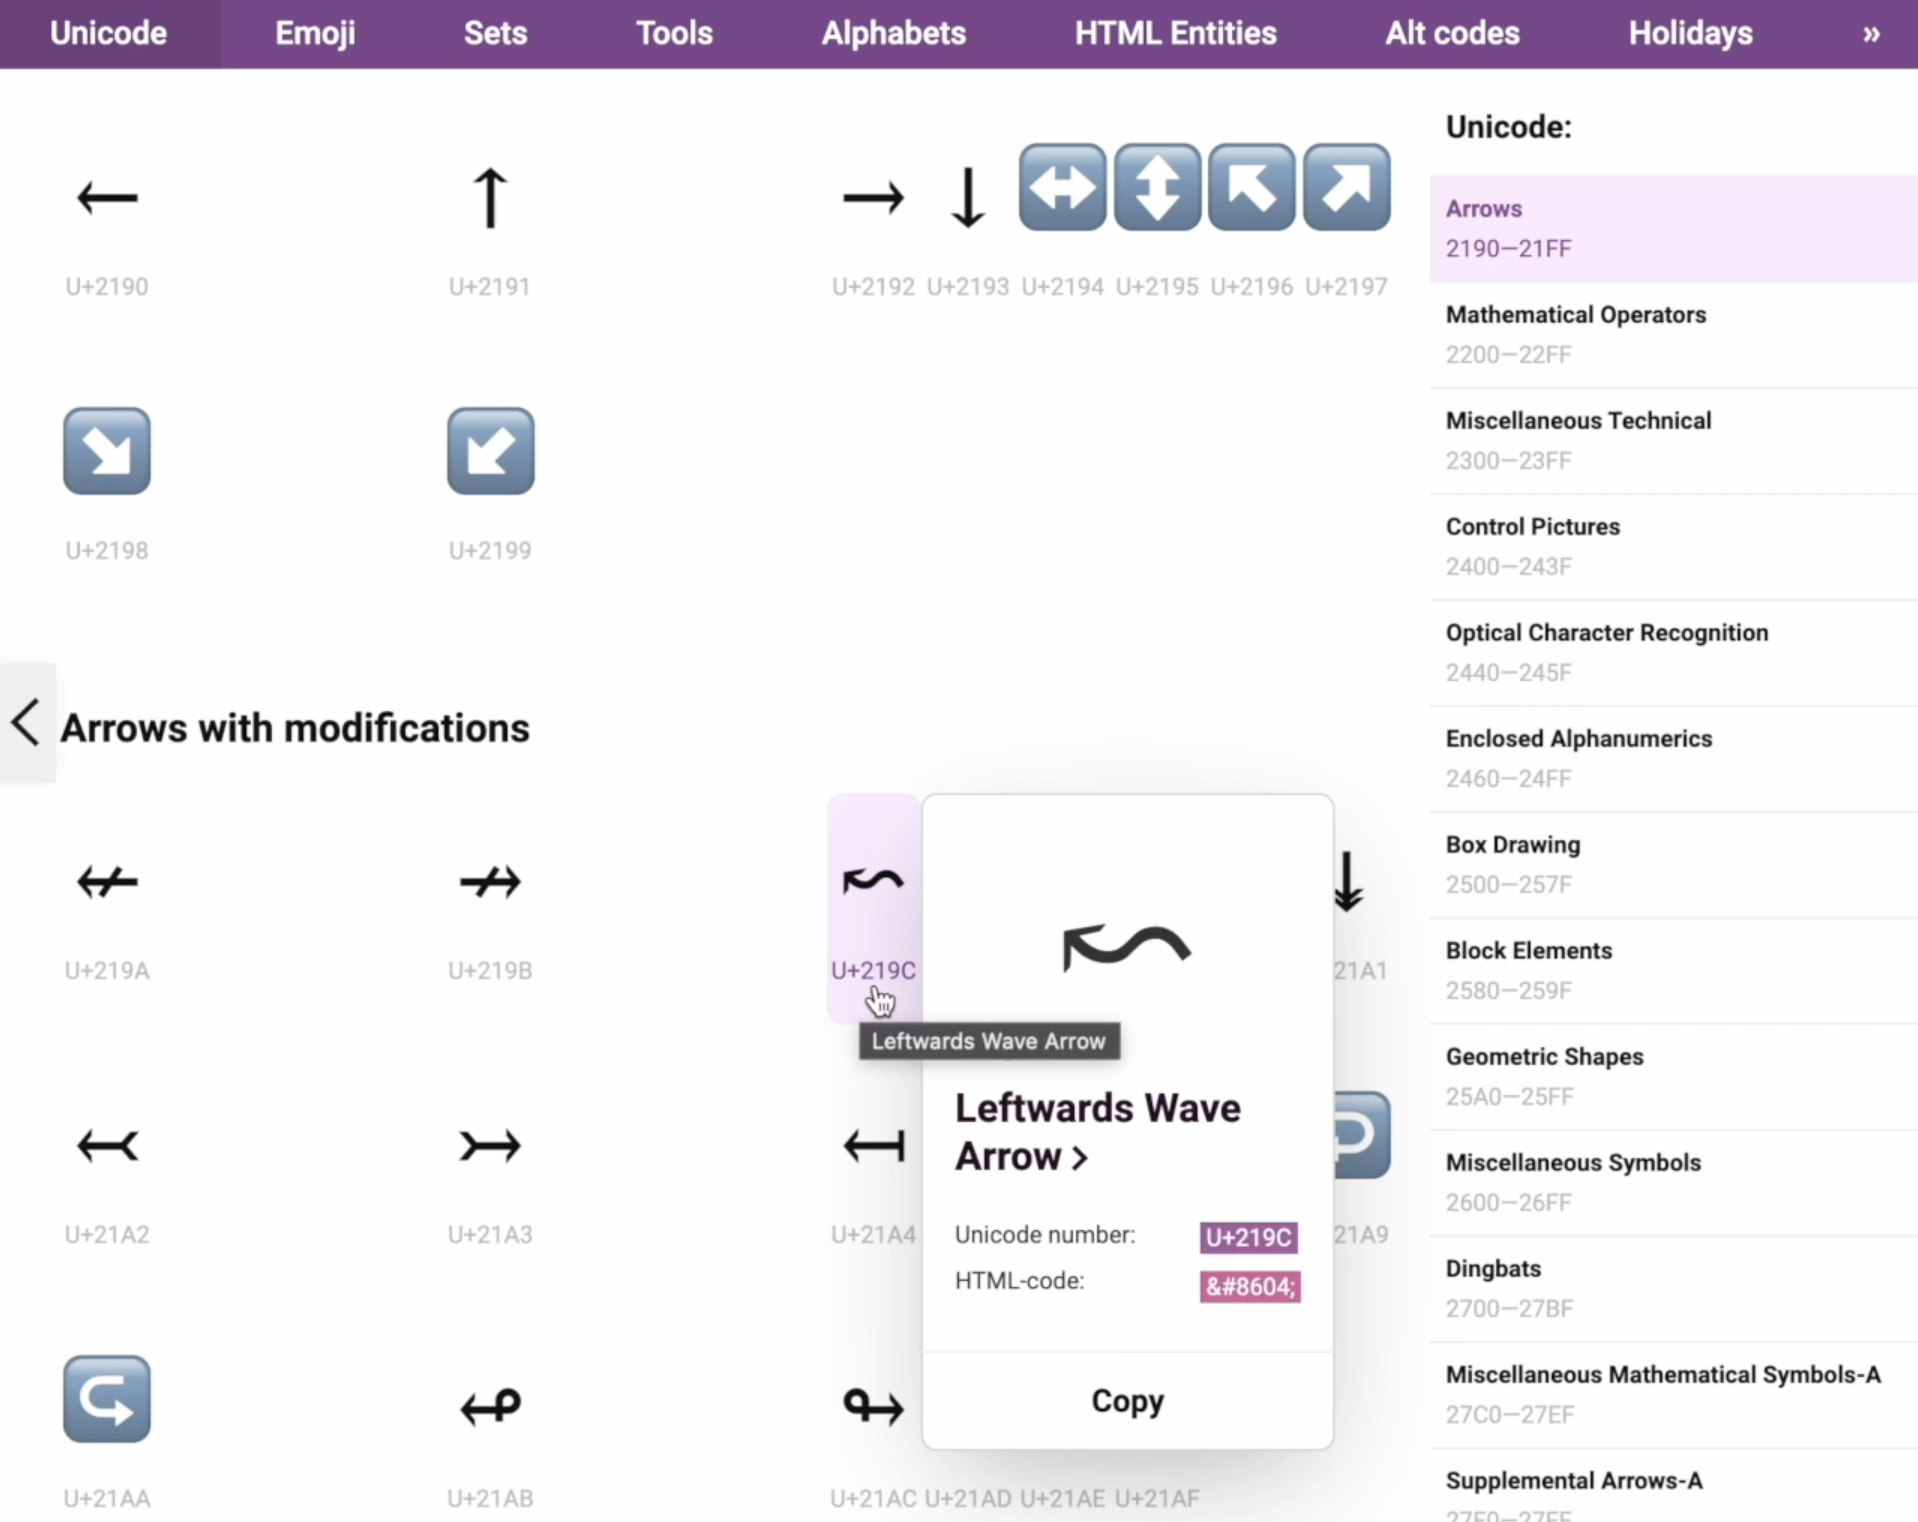
위의 이미지는 다양한 화살표 기호들의 유니코드를 보여주는데, U+ 뒤에 있는 코드들을 인코딩 하는 방식에 utf-8, 16등의 인코딩 방식이 있는 것이다.
utf는 Unicode Transformation Format의 약자로, 가변 길이 인코딩 방식이다. 인코딩 결과에 따라 1byte~4byte가 될 수 있다.
3. 헷갈려서 AI에게 확인한 부분
-
처음 헷갈렸던 내용: 현대의 모든 컴퓨터 환경에서는 그럼 문자는 무조건 unicode를 써서 문자를 받아들이는지가 궁금했고, 컴퓨터는 왜 무조건 0과 1로만 데이터를 받아들이는지, 단순히 전기 신호이기 때문에 그런것인지가 궁금해서 AI한테 물어보았다.
-
AI 답변:
CPU 내부에 Transistor라는 아주 작은 전기 스위치 수십억 개가 빽빽하게 들어있고, 이게 전기 신호를 on(1), off(0) 두 가지 상태만을 받아들여서 컴퓨터는 이진수만 받아들인다.
인류는 전압의 세기를 10가지로 나눠서 십진수를 표현할 수 있지 않을까 해서 시도도 해보았지만, 현실 세계의 아주 미세한 전기 신호들은 주변의 여러 노이즈들에 민감하게 반응하기 때문에, 확실하게 on, off로만 전기 신호를 처리하는게 데이터를 신뢰성있게 주고받기 위한 최선의 선택이라고 받아들인 것이다.
현대의 표준적인 IT 환경에서는 사실상 99.9% 유니코드(Unicode)를 기준으로 문자를 인식하고 처리한다.
위에서 언급했다 싶이 초기에는 영어 알파벳과 몇 가지의 숫자 정도면 받아들이면 됐기에 ASCII CODE를 활용했지만, 전 세계로 컴퓨터가 보급되면서 각 언어별 인코딩 방식들이 생겨났다. 이 과정에서 언어들이 변환되는 과정에서 글자들이 깨지기 때문에, 유니코드가 모든 문자에 부여되고, utf-8 또는 utf-16과 같이 유니코드를 인코딩하는 방식을 사용한다.
4. 개발 또는 일상과 연결해 본 예시
개발할 때 VSCode나 IntelliJ 터미널 창에서 원격에 commit, push 할 때 커밋 메시지를 주로 한글로 치는데, 영어보다 한글은 되게 버벅거리면서 입력된다는 느낌을 항상 받아서, 터미널은 유니코드를 활용한 인코딩 방식이 아닐까 해서 찾아보았다.
터미널도 유니코드를 이용해 인코딩하지만, 한글은 '조합형' 문자라는 특성을 가지고 있는 동시에 터미널이라는 옛날 환경의 특성이 결합된 결과이다.
영어는 알파벳의 나열이기 때문에 글자 하나하나가 즉시 컴퓨터로 전송되지만, 한글은 자음, 모음을 조합해야 한다. 추가로 터미널은 본질적으로 완성된 문자들의 흐름을 순차적으로 받아들이는데에 최적화되어 있어 복잡한 입력을 처리하는 능력 자체가 조금 일반 환경에 비해 부족하다. 따라서 한글은 자음과 모음이 결합되는 순간마다 터미널 화면을 지웠다 다시 그리는 렌더링 작업을 반복해야 하기 때문에 우리 눈에 글자가 씹혀보이는 것처럼 보이는 것이다.
전공자 선택 작성: 심화 질문
전공자는 가능하다면 아래 질문 중 하나 이상에 답해 주세요.
- 비전공자에게 설명한다면 어떤 순서로 설명할까?: '컴퓨터'는 하나의 기계이기 때문에, 전기 신호를 주어서 소통해야 한다. 따라서 전기 신호의 on, off를 각각 1과 0으로 표기하고, 1과 0만 쓰는 이진법을 활용해 컴퓨터라는 기계에 신호를 보내고, 받고 하는 과정에서 다양한 해석 방식이 존재한다는 말을 써서 컴퓨터와의 소통 방식을 설명해보고 싶다.