
INTRO
이번 주말! 공부한다고 얘기하고 저번 4주차 회고록을 마무리했었는데
아주 멋지게도 주말에 공부를 이어가고 있는 거 있죠 ㅎㅎ.
자랑할 겸, 다른 데이터셋을 맞이하는 저의 오늘 일과를 소개하도록 하겠습니다.
저는 올해 초, 학교 데이터 분석 학회에 지원해서 서류합격 후
사전과제를 받았었는데요,
물론 관련 수업을 들었었지만 이해하지 못했던 터라 결국 사전과제를 해결하지 못하고
면접 전 '꼭 더 성장해서 다시 지원하겠다'며 끝을 흐렸던 적이 있어요.
다른 중요한 활동 지원이 겹쳤기도 했었지만, 이 사전과제에 발을 딛는 것조차 못하는데
앞으로 학회 생활을 하더라도 잘 해낼 수 있을까 의구심이 들었습니다.
가서 배우면 되지 않냐! 하셔도,
잘 모르는 상태에서 갔다가 자존감만 낮아질 것 같기도 했네요.
그 학회는 대회에 나가는 게 목적이었지, 양성이 목적이 아니었으니까요.
나중에 분석을 공부하고나면 꼭 이 데이터 분석을 해 보고 싶었는데
이제 그럴 때가 된 것 같아서 반 년 동안 묵혀둔 파일을 열었습니다.
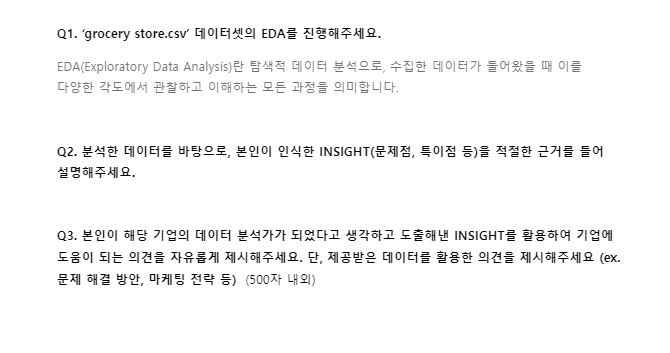
과제는 EDA를 통한 인사이트가 전부였어요.
과제 소개
'TITANIC'과 차이점이 있는 데이터셋이었어요.
#목적
SURVIVED == 0, 1로 나누어져 예측을 하거나 MODEL을 개발하는게 아니었습니다.
분류, 예측모델이 아니라 정말 EDA, insight 확보만을 위한 데이터셋이었어요.
구매한 사람들만을 대상으로 'BASKET_ID', 'EVENT_DATE', 'TRANS_TIME', 'STORE_ID', 'PRODUCT_ID','QUANTITY', 'RETAIL_DISC', 'COUPON_DISC', 'COUPON_MATCH_DISC', 'SALES_VALUE', 'product_price_per_unit', 'HOUSEHOLD_KEY', 'AGE', 'INCOME', 'HH_COMP', 'HOUSEHOLD_SIZE', 'KID_CATEGORY', 'DEPARTMENT', 'COMMODITY'라는 COLUMN들을 비교했습니다.
#답하고자 하는 질문을 직접 만들어야 함
우선 칼럼이 되게 많았어요.
목표에 따라 어떤 칼럼을 사용할지, 어떤 칼럼의 값으로 groupby 할 것인지 등
전체 설계가 되기 때문에 미리 구상을 할 필요가 있었습니다.
저는 참을성이 없는 편이라 얼른 결과를 보고 싶어서 이 시간이 지루하게만 느껴졌어요.
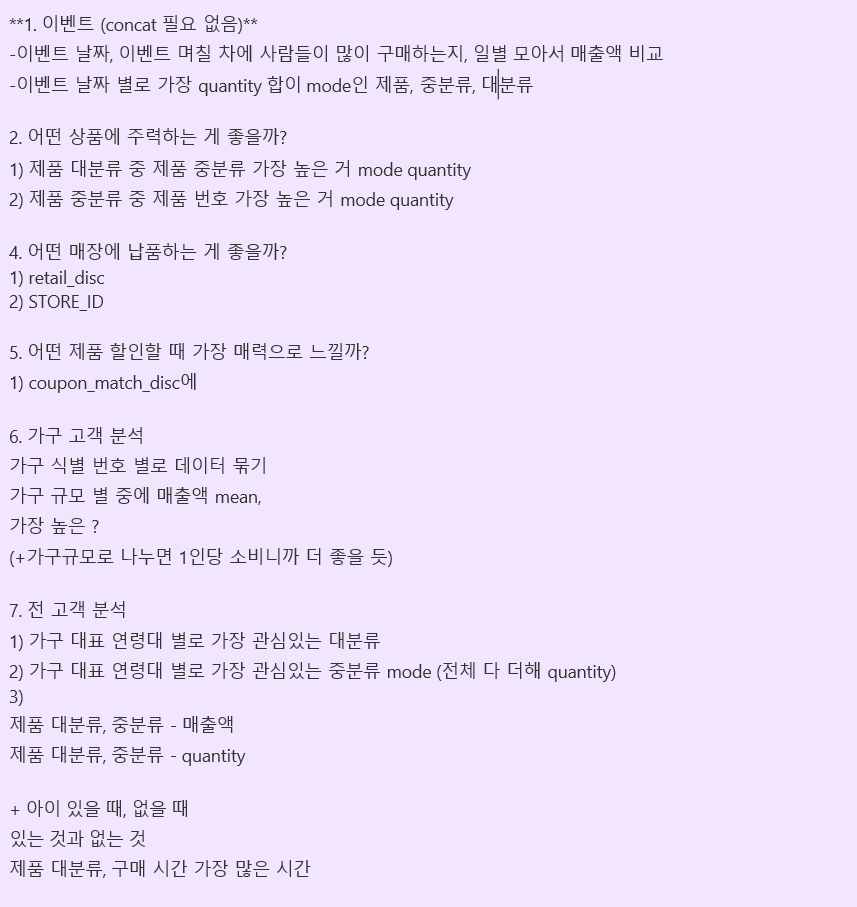
#모든 COLUMN이 동일선상에 있지 않음
사실 titanic 문제는 feature, target이 명확히 정해져있었기 때문에 feature들이 함께 survived 예측이라는 하나의 공통 목표를 공유했었죠. 그런데 위에서 언급한 바처럼 답하고자 하는 질문이 여러 개 만들어지다보니 문제마다 필요한 feature이 따로 있었습니다.
#date 데이터 사용
강사님께서 titanic 데이터에 없다고 아쉬워하셨던 시간 개념 데이터가 있었습니다.
#구간화된 데이터
AGE, INCOME 등 몇 칼럼들이 구간화되어 있었습니다.
본격! 데이터 분석
무결성 확인
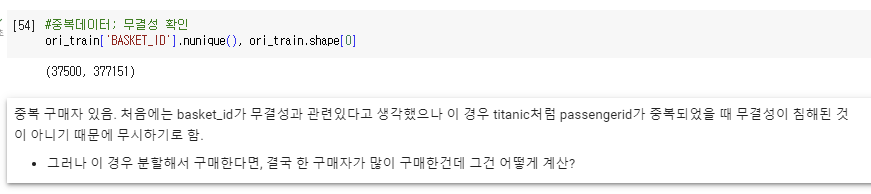
먼저, TITANIC의 PASSENGER_ID는 무결성 확인을 위해 사용했었는데,
여기 BASKET_ID는 충분히 동일 인물이 중복구매할 수 있다는 점을 고려해야겠어요.
그래서 DROP하지 않고 다음 절차로 이동했습니다.
데이터 확인
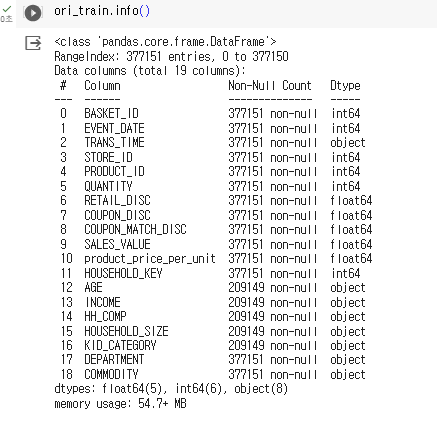
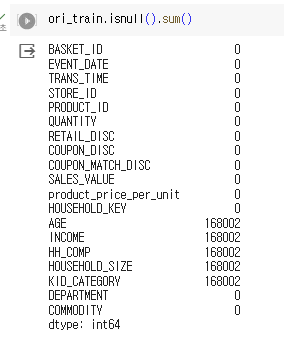
전체 칼럼명들과 결측치들을 확인해주었습니다.
AGE, INCOME, HH_COMP, HOUSEHOLD_SIZE, KID_CATEGORY 등, 구매와 관련되기보다
회원정보와 관련된 내용들은 공통 ROW에서 결측치가 발생해 있었습니다.
전체 37만개 데이터 중 16만개정도이니, 1/2 좀 안되는 정도가 결측치로 있었던 것입니다.
이 결측치를 어떻게 사용할 것인지는 각 질문에 따라 다르겠지만,
예측, 분류모델도 아니고 FACT를 기반으로 분류하는 것이 맞기에 따로 결측치를 채워주지 않았습니다.
EDA
EVENT DATE
먼저, EVENT를 며칠동안 유지하는 게 좋을지에 대한 고민입니다.
저는 이벤트 데이트가 이렇게 길 줄 몰랐는데, 1일부터 91일까지도 있더라구요.
QUANTITY를 기준으로 그래프를 그려줘봤습니다.
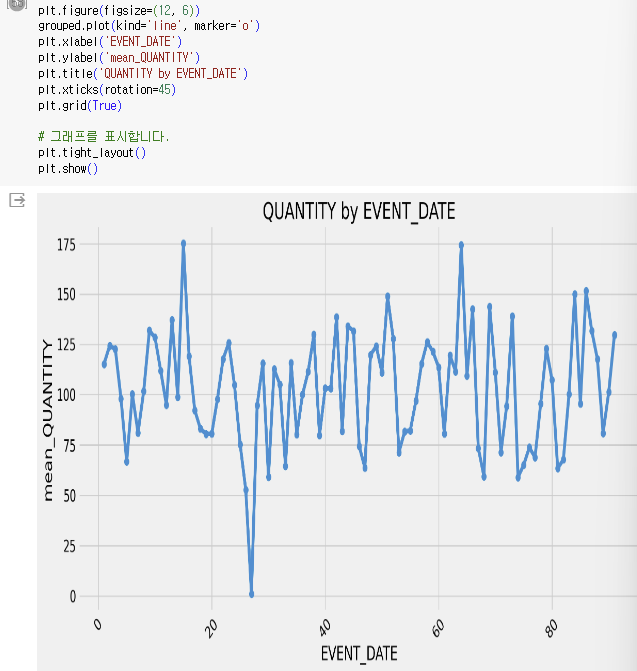
지금 봐서는 0~20일 중간에 솟은 타이밍을 이용하는 것이 좋아보이지만,
이벤트를 며칠동안 유지할지 추천할 목적으로 사용하는 건
PREVIOUS DATE의 값들도 ACCUMULATED 되는 그래프가 더 좋을 것 같다고 생각했습니다.
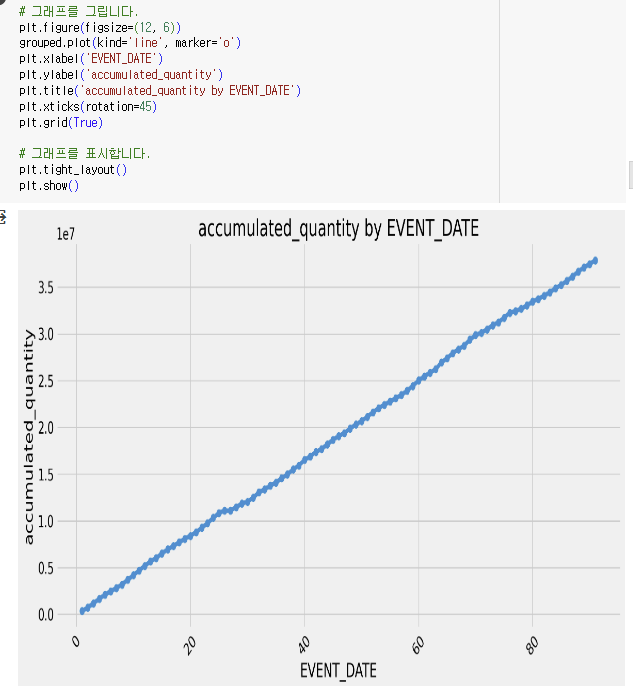
그려보았는데, 이 20과 30 사이에 솟아있는 구간이 기존 증가량보다 높으면서,
그때를 기점으로 해서 증가량이 낮은 지점이 있더라구요.
이 부분을 표현할 수 있는 방법으로 미분을 고려했습니다.
가장 큰 미분값(즉, 기울기)을 갖는 index를 찾고, 그 미분값을 출력하는 기울기를 표시했습니다.
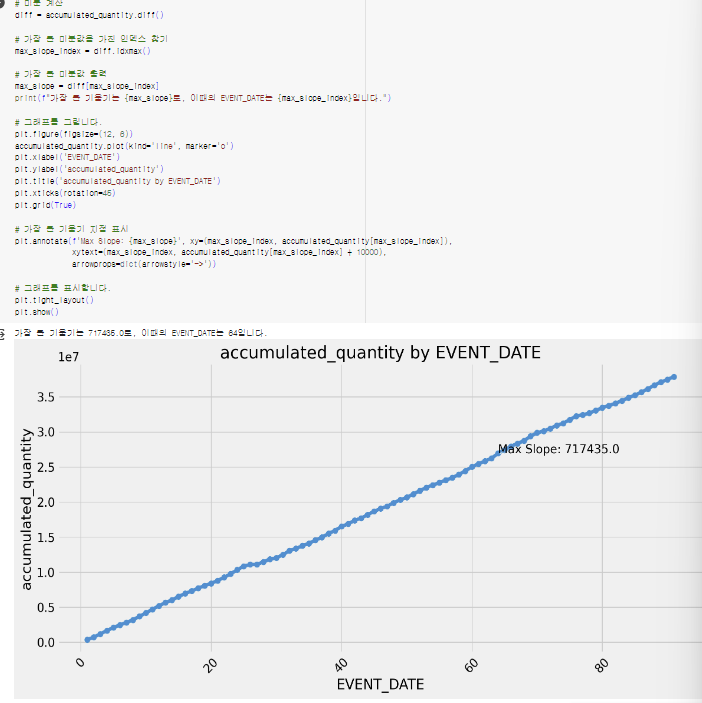
미리 정해둔 'accumulated_quantity' 변수에 .diff를 해서, idxmax()로 max인 index를 찾아줬지요. 그리고 그 index인 값의 diff 값을 출력했습니다.
그런데 아쉬웠던 점이, 딱 해당 시점의 기울기가 높다고 event를 6n일 동안 끌어야 하나?
직전 y값이 낮았다는 이유로도 slope 자체는 높은 거잖아요.
그럼 그건 이상적인 DATE를 알고자 하는 목적과 멀어지니까, 다른 방법을 생각해봤습니다.
현실도 고려해서, 절대적인 Y값 또한 고려해야겠다고 생각해서 사용한 방법이,
(y value / event_date)를 동시에 이용하는 방법입니다.
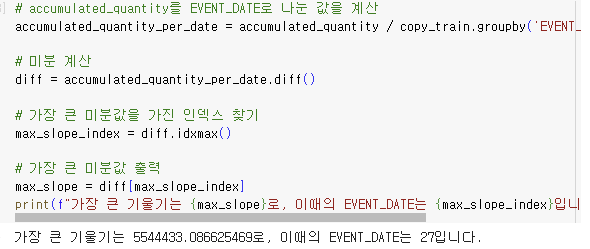
누적 평균값을 구하고, 누적 평균값 자체가 유의하게 높아지는 곳을 찾아본 것이죠.
accumulated_quantity_per_date라는 변수를 이때까지 y의 평균으로 정해주면서,
accumulated quantity_per_date 자체를 증가시키는 지점을 찾아주기 위해서 미분을 계산했습니다.
아까 그래프에서 보였던 그 위치와 유사해보이는 27일이 인덱스 답으로 나왔습니다.
만약 계속 기울기인 미분값만 찾고 있었다면 제가 원하는 값이 나오지 않았을 겁니다.
SLOPE가 높은 값들이 후반부에 있더라구요.
27일 부근은 SALES_VALUE가 지속적으로 증가하고 있어왔으므로 후반부와 달리 단기 증가율은 크지 않아서로 보입니다.
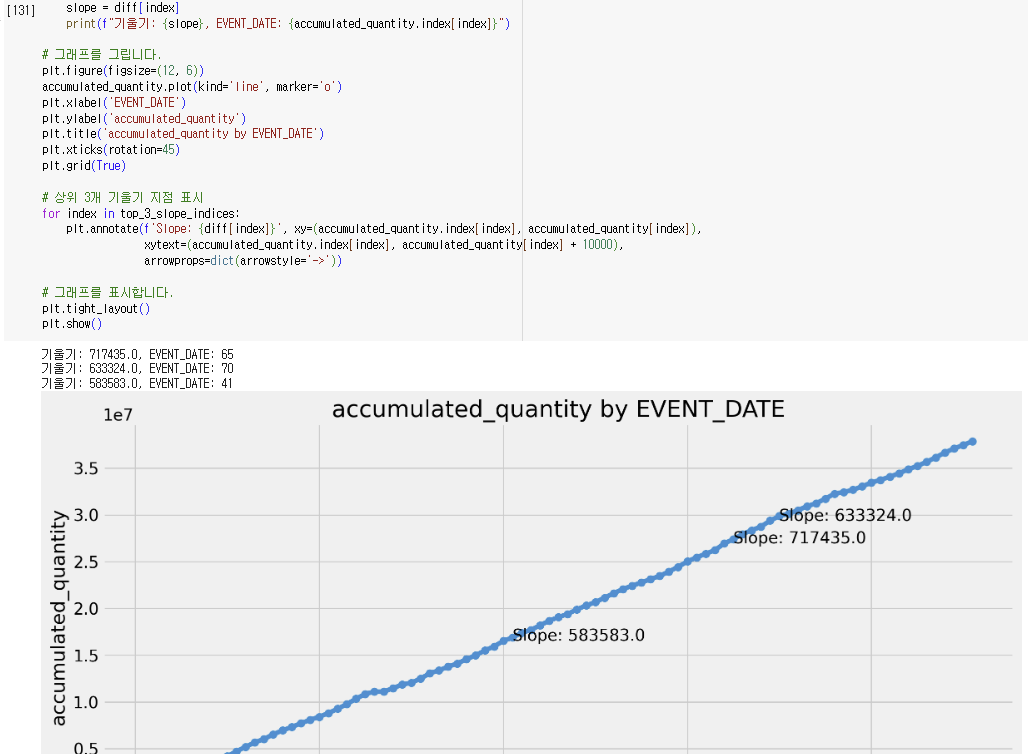
비슷한 맥락에서 EVENT_DATE를 계산하기 위하여 QUANTITY가 아닌 SALES_VALUE도 계산해보았는데요,
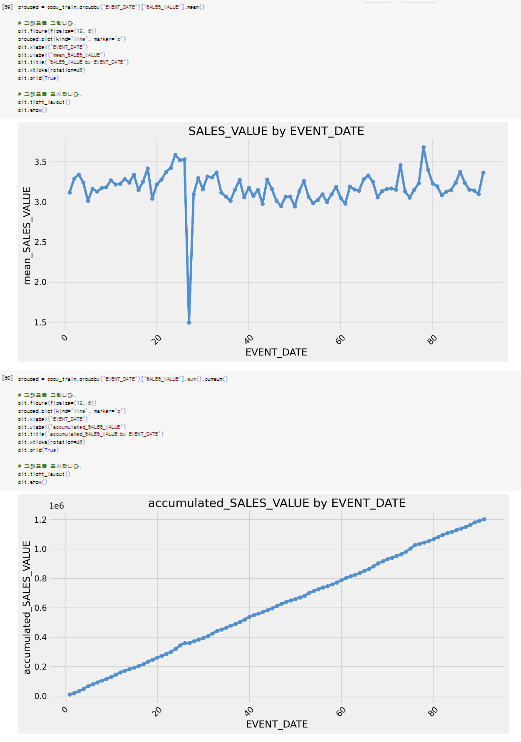
accumulated_SALES_VALUE는 QUANTITY와 비슷한 그래프를 보이네요.
EVENT COMMODITY
저는 올리브영에서 아르바이트를 하며, 한번에 모든 제품들을 동시에 할인하는 게 아니라
3달 정도 로테이션이 돌아가도록 한 상품에 세일과 비세일을 섞는 것이 영리하다고 생각했습니다.
사실 다들 할인이라고 해서 가서 구매하는거라 자기가 사는 상품들이 세일 들어가는지 아닌지 모르는 경우도 많은데, 아닌 경우도 많거든요.
그래서 그렇게 세일인 줄 알고 비세일인 상품 구매하면 좋은거죠. 섞어놔야 하는 이유입니다.
그럼 어떤 상품이 할인할 때 가치를 느끼는지를 계산해보았습니다.
RETAIL STORE
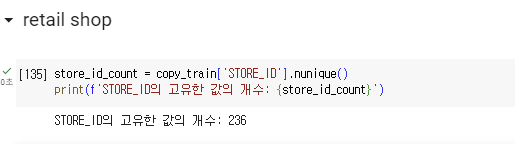
어떤 가게에 납품할 것인지도, 그 수량도 중요하겠죠. nunique() 함수를 통해서 STORE_ID 값 개수를 세려보니 236, 총 236개의 소매업체에 납품하고 있는 것 같습니다. 혹시 줄이는 것이 좋을까?싶어 구매 빈도수가 높은 STORE_ID와 낮은 STORE_ID들을 찍어보았습니다.
그래서 가장 구매 빈도수가 높은 STORE_ID를 검색해봤습니다. (QUANTITY, SALES 기준 X, INDEX 기준)
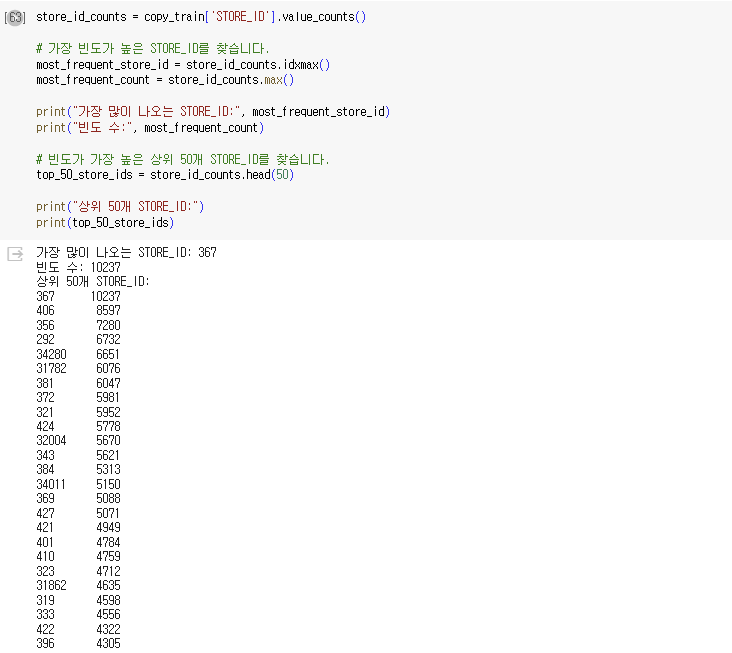
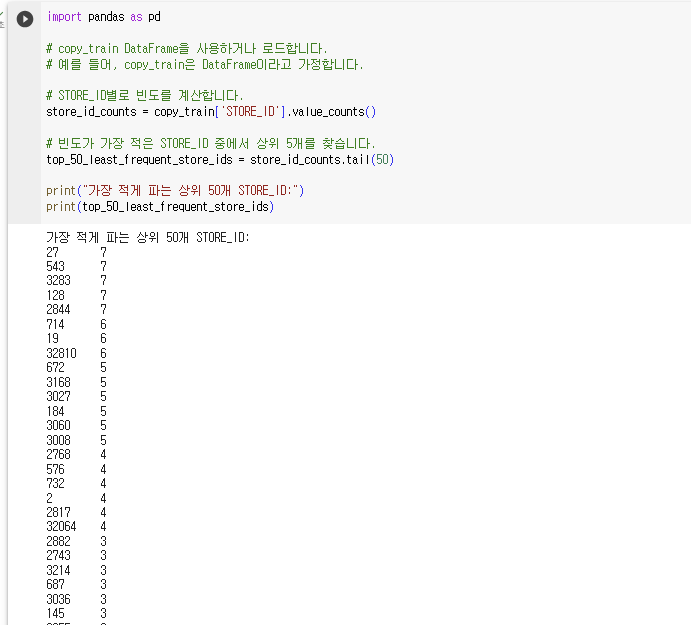
되게 큰 편차를 보이는 것을 알 수 있습니다.
여기서 어떤 건의를 할 수 있을까요?
1) 버리기
굳이 10개 미만 판매하는 RETAIL STORE과의 관계를 유지해야하나 ...
2) 높은 STORE들과 FEATURE 차이를 제시하기
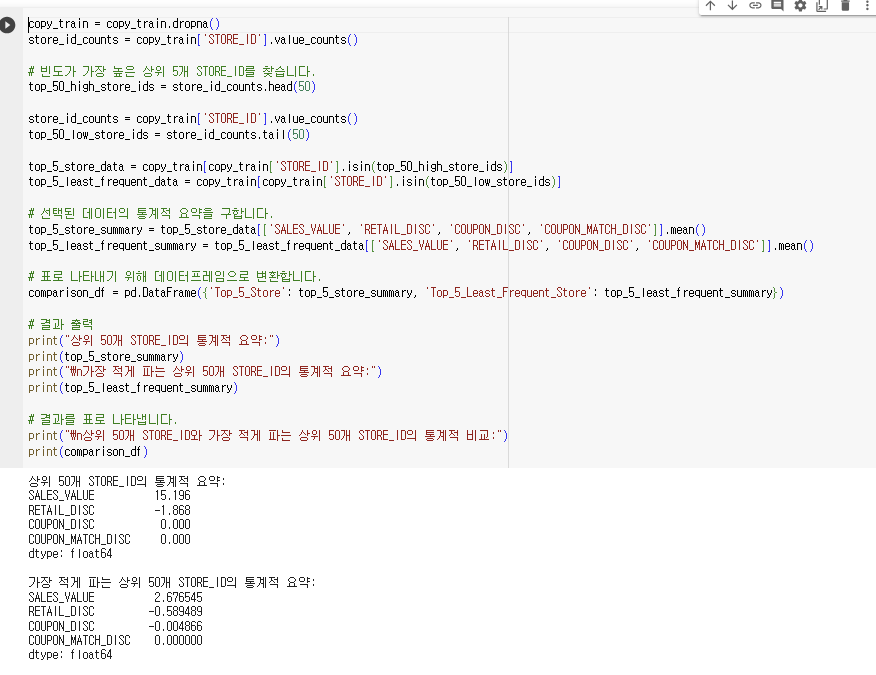
SALES_VALUE, RETAIL_DISC, COUPON_DISC, COUPON_MATCH_DISC 값을 비교하였는데,
상위 가게들이 하위 가게들보다 할인이 많이 적용되었다는 걸 확인할 수 있죠.
할인이 가게 인기의
또 궁금해지는 건 그 RETAIL STORE이 어떤 상품을 주로 파는지입니다.
특히 top 5 store들이 주로 판매하는 제품군을 확인하니, grocery, drug gm, meat, produce, kiosk-gas, meat-pckgd 6개가 올라와있었습니다.
KIOSK-GAS가 무엇인지 검색했는데 나오지 않고, 그럼 'commodity'에 해당하는 values들을 찾아보니 COUPON/MISC ITEMS가 속해있었습니다.
로또 등이 아닌가 싶네요...!
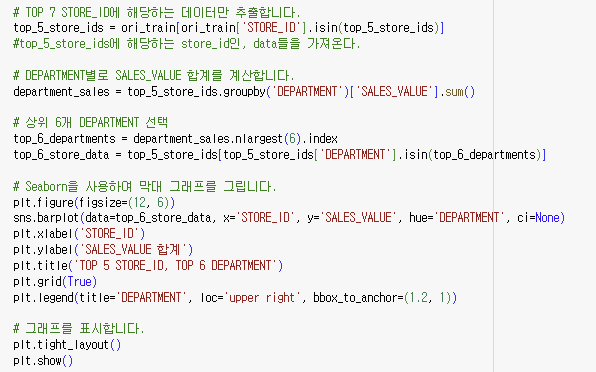
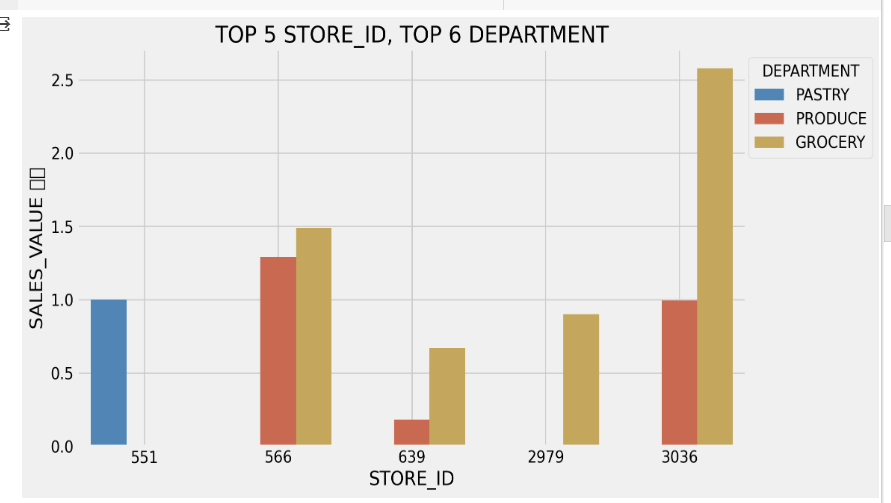
여기서 상위 5개, 하위 5개 가게들의 인기 상품군들을 보면 확실히 다름을 알 수 있습니다.
판매 주력 상품군을 추가하거나 수정하는 것도 함께 건의할 수 있겠습니다.
customer analysis
가구마다 가구 대표 나이대가 있었어요. 이에 따른 Sales_Value를 구해보았습니다.
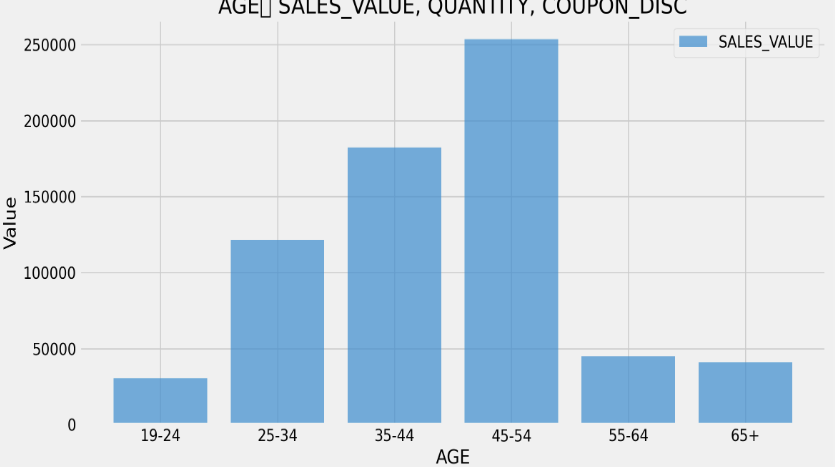
먼저, 가구대표 나이 구간을 X값으로, SALES_VALUE를 Y로 한 그래프입니다.
45-54의 가구대표 주문자가 가장 많았습니다.
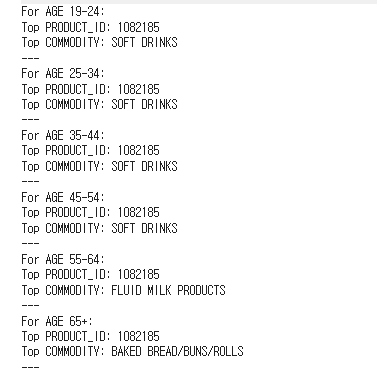
자주 구매하는 PRODUCT_ID와 COMMODITY(소분류)도 함께 구해보았습니다.
SALES가 나오면 QUANTITY도 같이 나와야겠죠.
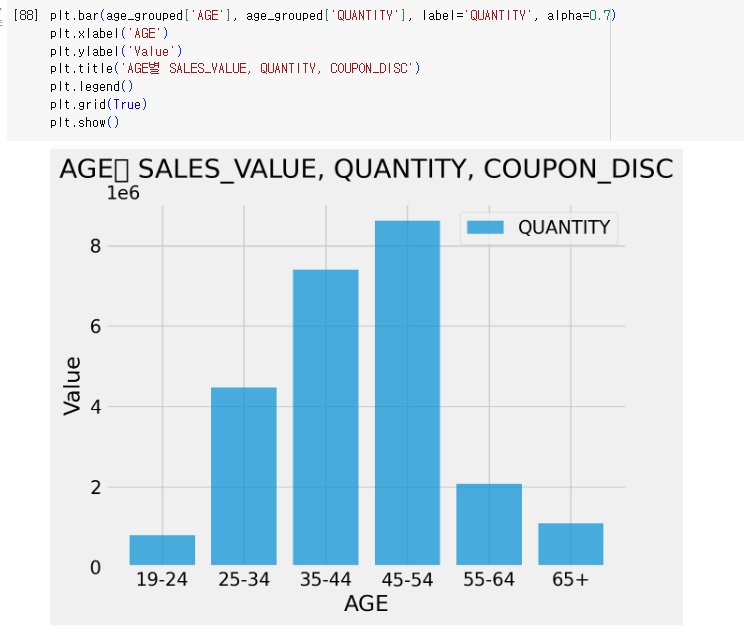
사실은 QUANTITY보다 SALES/QUANTITY를 나눈 값이 더 유의미합니다.
제품 당 가격이 높은 것에 개의치 않는 정도를 나타낼 수도 있으니까요.
다르게 얘기하면, 여기서 막대그래프가 낮은 축에 속할수록 낮은 가격에 더 현혹된다고 볼 수 있겠습니다.
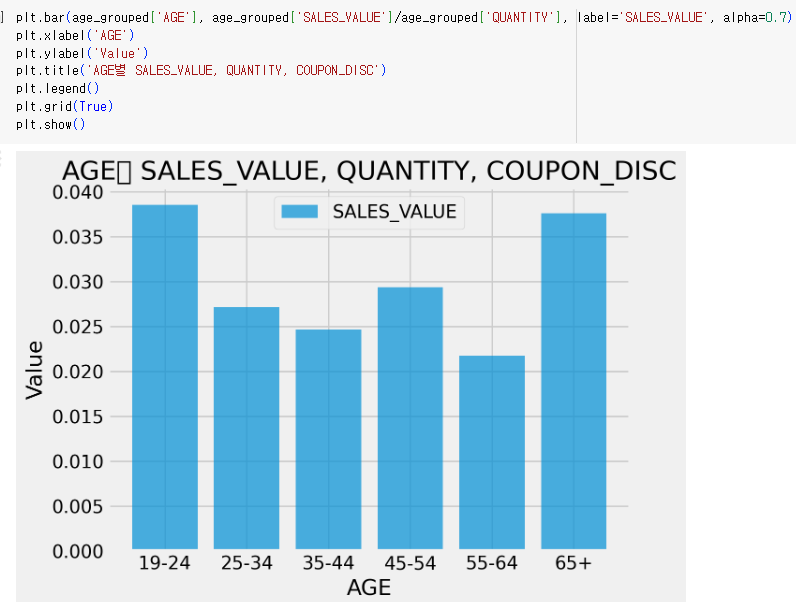
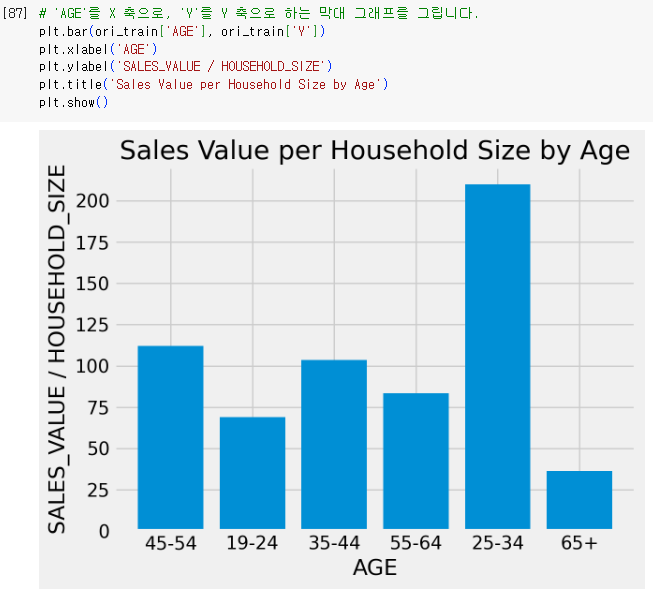
다음은 SALES_VALUE, 총 매출을 HOUSEHOLD_SIZE에 대해서 나누어보았습니다.
이는 4인 가구 구매를 45-54세가 맡았을 때 모든 매출이 그 쪽으로 카운트되는 오류를 수정하려는 시도였습니다.
1인 당 지출을 AGE별로 구분한 그래프로 볼 수 있을 것 같습니다.
45-54세로 나왔던 전과 다르게, 25-34세가 매출에 기여를 많이 하고 있었네요.
ADVERTISING HOUR
시간 데이터를 다루어보았는데, 함수를 사용하면 크게 특별할 건 아니었네요.
SALES_VALUE를 기준으로 사람들이 많이 구매하는 시간과 각 시간대별(HOUR 기준) MAX QUANTITY, PRODUCT_ID, DEPARTMENT, STORE_ID를 조사해봤습니다.
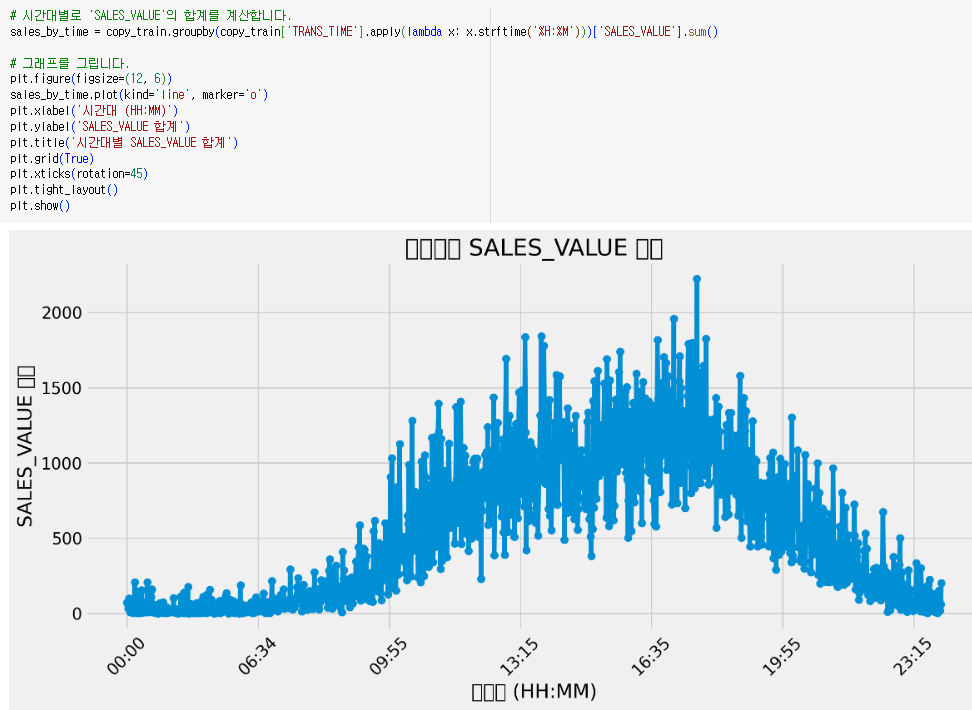
확실히 5시~6시 반 경에 구매율이 높은 것을 확인할 수 있었습니다.
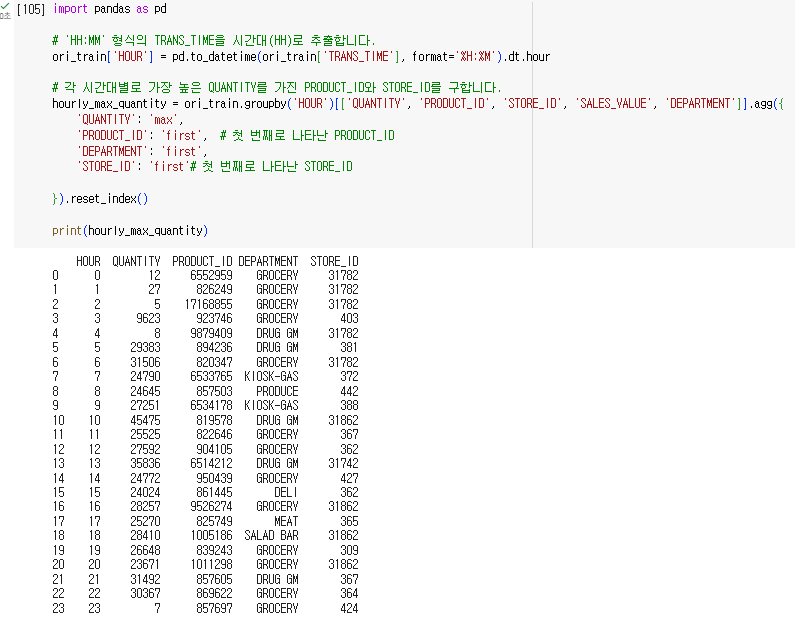
31782 STORE에서 새벽대에 구매율이 높다는 것도 특이해고, 31862 STORE에서는 DAYTIME에 높았네요.
추가 목표
또한 AGE별로 TRANS_TIME을 계산하는 것도 좋아보입니다.
더 하고 싶은 EDA들이 많지만, 10/23 분석은 이 정도로 마치도록 하겠습니당.
글 잘보고 있어요~ 화이팅 하세욥!! ^^