(OverView ands Tokenization)Language Modeling from Scratch lec1
lec1 OverView and Tokenization
기본 (Basics)
목표: 기본적인 pipeline 동작을 이해하는 것
여기서는 tokenization, model architecture, training 를 배움
Tokenization
string이나 sequences를 integers(tokens)로 바꾼다.

Architecture

위는 original Transformer 구조이다.

활성화 함수, 정규화 등등 여러 변수들이 있고, 그것들도 배울 것이다.
Training
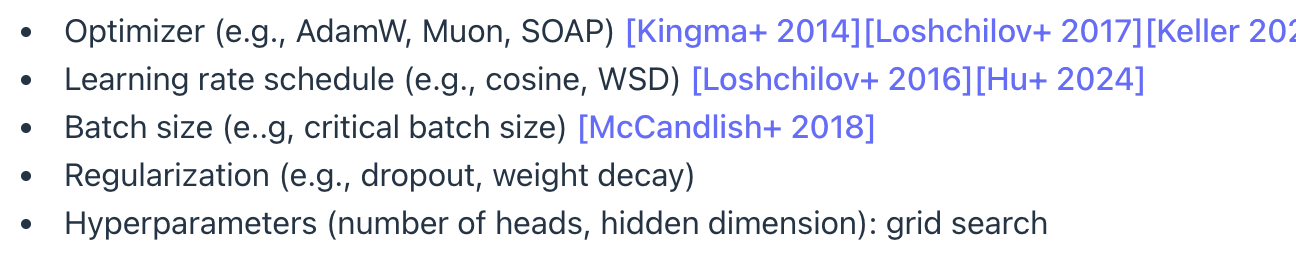
Optimizer, Learning Rate Schedule, Batch Size, Regularization, Hyperparameters등을 배울거다.
이건 좀 알던거라 주저리주저리 써보자면,
Optimizer (최적화 알고리즘)은 모델의 가중치를 업데이트 하는 것으로
SDG (확률적 경사하강법), AdamW AdamW랑 Adam 차이가 무엇일까?, SOAP같은 알고리즘을 사용해서 손실 함수(loss)를 최소화하기 위해 기울기를 조절하고 가중치를 조정하는 것
Learning Rate Schedule (학습률 스케줄)은 학습률을 시간(에폭)에 따라 조절하는 것이다. 고정 학습률, Cosine Decay, Warmup 등
Batch Size (배치 크기)는 한 번에 학습에 사용하는 샘플의 개수이다.
너무 작으면 불안정하고, 너무 크면 메모리 부족이나 일반화 문제가 생길 수 있다.
Regulation (정규화)는 오버피팅을 막기 위한 것으로 Dropout, L1/L2 정규화등이 있다.
HyperParameters (하이퍼파라미터)는 학습 전에 사용자가 설정하는 값들을 설정하는 단계이다. (학습률, 에폭 수 등)
시스템 (Systems)
하드웨어를 효율적으로 사용하는 데에 필요한 것.
여기서는 Kernels, Parallelism, Inference가 있다.
Kernals
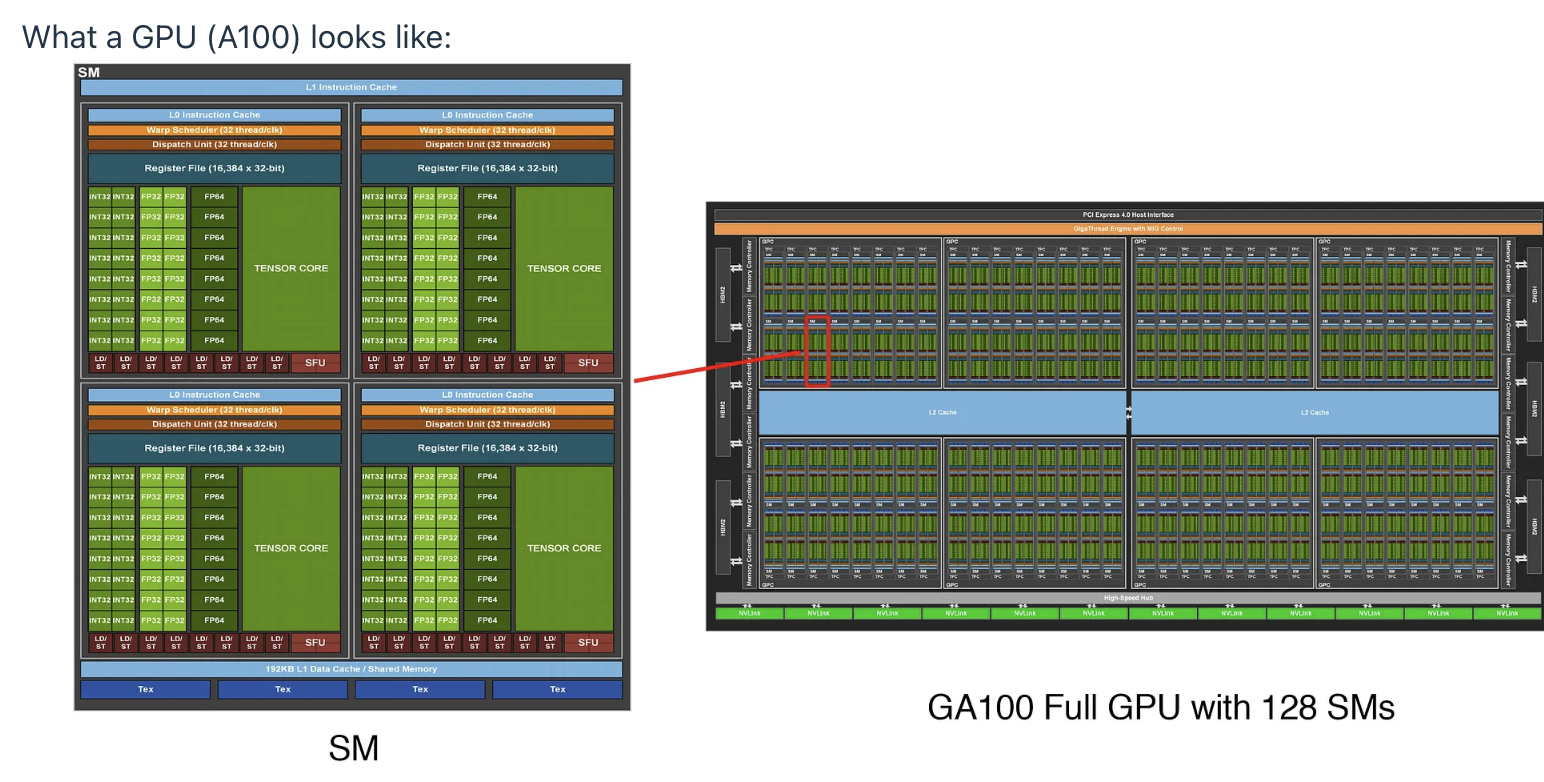
A100 GPU가 이렇게 생겼단다.
결국 DRAM(메모리) 랑 SRAM(보통 캐시)가 데이터를 옮길 때 드는 값을 Bandwidth Cost라고 하는데 이걸 줄이기 위해 뭐 여러 가지 최적화 방법들도 배울 거고 구현에는 Triton을 사용할 듯
Parallelism
A100이 8개가 있으면 어떻게 할 건가
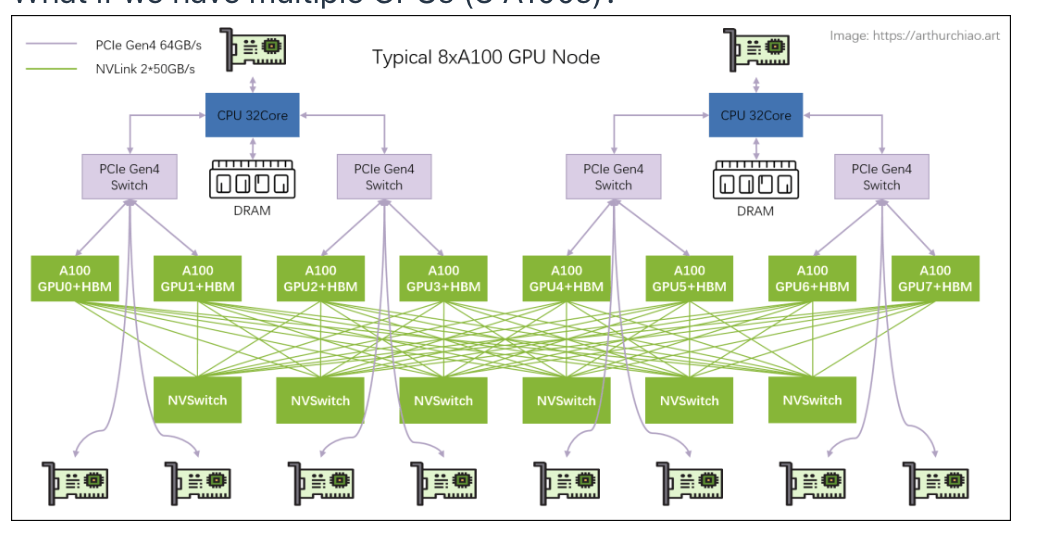
데이터 이동을 최소화하는 그 원칙은 똑같음.
Inference
목표: 프롬프트를 주고 토큰(단어/문장)을 생성하는 것
추론은 강화 학습, 테스트 시점 계산(test-time compute), 모델 평가(evaluation) 등에도 필요함.
학습은 한 번만 하지만, 추론은 모델이 돌 때마다 계속 사용되기에 중요하다.
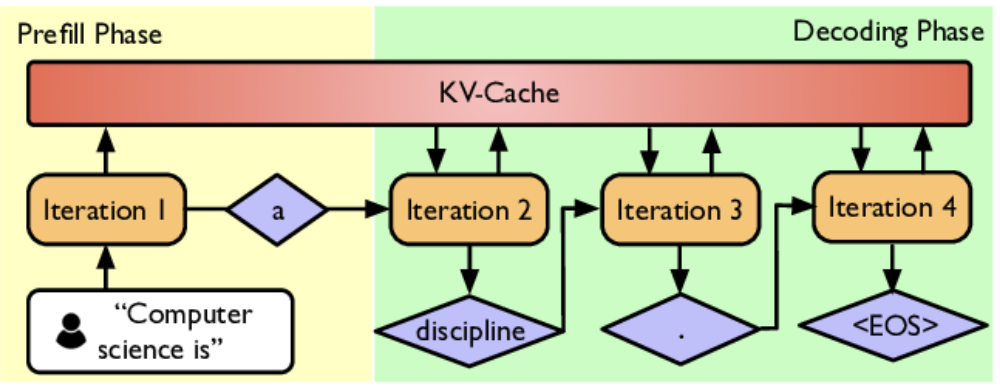
Prefill, Decode 단계가 존재한다.
Prefill은 학습이랑 비슷하다. 토큰(프롬프트)를 한번에 모두 넣고 처리하는 것으로 병렬 처리 기능 -> (compute-bound) 단계이다. 학습이랑 거의 비슷한 구조
Decode 단계는 하나의 토큰을 생성하고, 다음 입력으로 넣고... 를 반복하는 거다. 순차적이라 속도가 느리고 memory-bound이다.
디코딩을 더 빠르게 하는 법으로는
1. 모델을 더 가볍게 하기 (via pruning, quantization, distillation)
2. Speculative Decoding (추측 기반 디코딩)
- 더 싼 초안(draft) 모델로 여러 토큰을 미리 생성하고 진짜 큰 모델로(병렬로) 검증 및 보정을 하는 것이다. 병렬로 처리되기 때문에 빠르면서 정확성 유지
- 시스템 최적화. KV caching, batching 등
Scaling laws
목적: 작은 규모에서의 실험 결과로, 큰 규모에서의 hyperparameters나 loss를 예측하려는 것.
FLOPS가 정해져 있을 때, 모델을 더 크게 만들까()? 아니면 더 많은 토큰으로 학습을 할까()?
라고 함 (e.g., 1.4B 파라미터 모델은 28B 토큰들로 학습되는게 최적) 그런데 이건 학습시의 최적 효율이고, 추론 비용도 있으니까 ~
Data
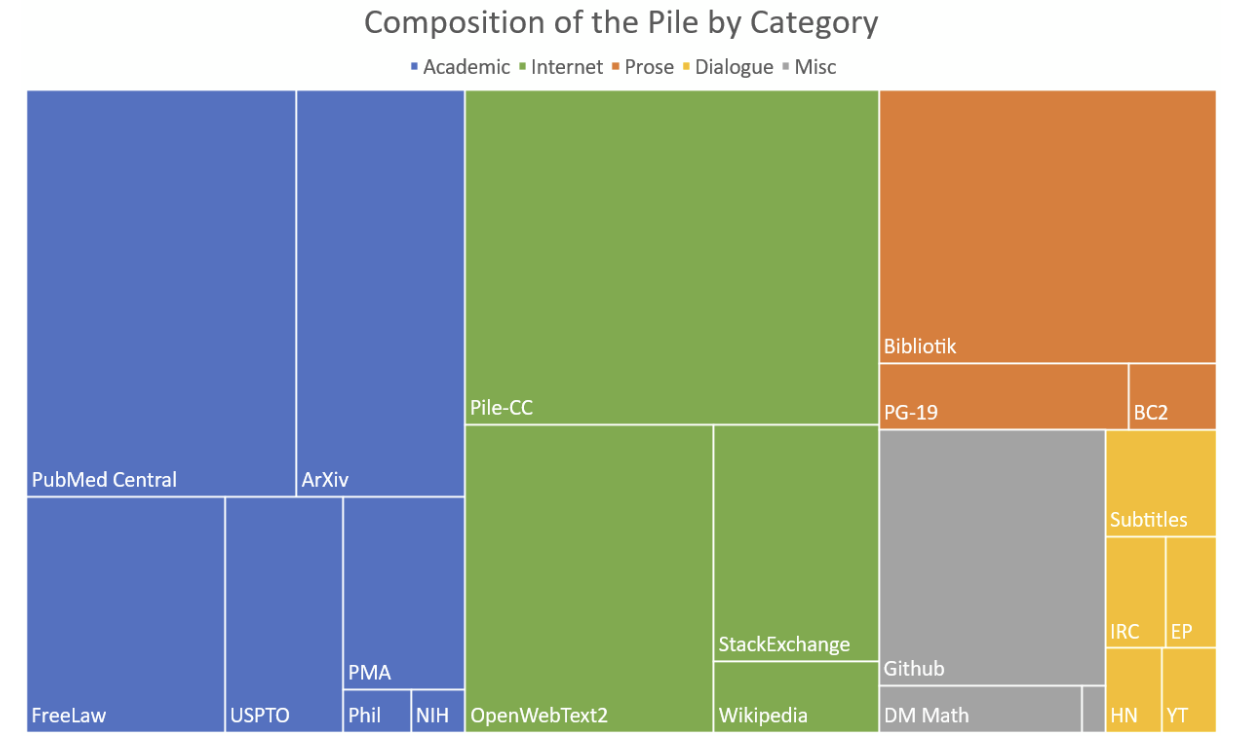
이 데이터로 인해서 모델이 어떤 능력을 가지게되는지가 그거임. 뭐 다국어, 코드, 수학 등
Eveluation (평가)
Perplexity (다음 단어 예측), Standardized testing(e.g., MMLU, HellaSwag, HSM8K) 등으로 뭐 대학, 고등학교, 초등학교 수준의 문제를 그거 함.
Instruction Following: 사용자 명령을 얼마나 잘 따르는지 (e.g., AlpacaEval, IFEval, WildBench)
Scaling test-time compute: chain-of-thought, ensembling
LM-as-a-judge: evaluate generative tasks
Full system: RAG, agents
등을 평가할 수 있음.
Data processing
-> 데이터 거르는거 뭐 변환, 필터링 등
alignment
베이스 모델은 원석이고, 뭐 이메일을 써달라 이런거를 동작할 수 있게 하는게 정렬이다. 뭐
supervised_finetuning() -> 사람이 만든 프롬프트-응답 쌍을 학습해서 모범답안을 주는거
learning_from_feedback() -> 선호도에 따라 랭킹을 매기고, 보상 모델 (Reward Model)을 학습한 뒤 강화학습(RL)으로 모델을 다시 튜닝하는 것. 이걸
RLHF(Reinforcement Learning from Human Feedback) 라고 부름
(PPO, DPO, GRPO 등의 알고리즘이 있다.)
Tokenization
말했다싶이 raw text 를 integer로 바꾸는 것.
string = "Hello, 🌍! 你好!"
-> [15496, 11, 995, 0]

뭐 띄어쓰기나 이런거는 알고리즘에 따라 다르게 될 수 있다.
character tokenizer
한 단어당 한 정수로 대응하는 것. 문제는 이렇게하면 대응되는 indices가 너무 많다. 150K(출처 위키피디아)개까지 있을 수 있으니까..
문제는 너무 이 indices가 너무 많고, 어떤 문자들은 희귀함. 🌍 이런거 ㅇㅇ 효율적이지 못함.
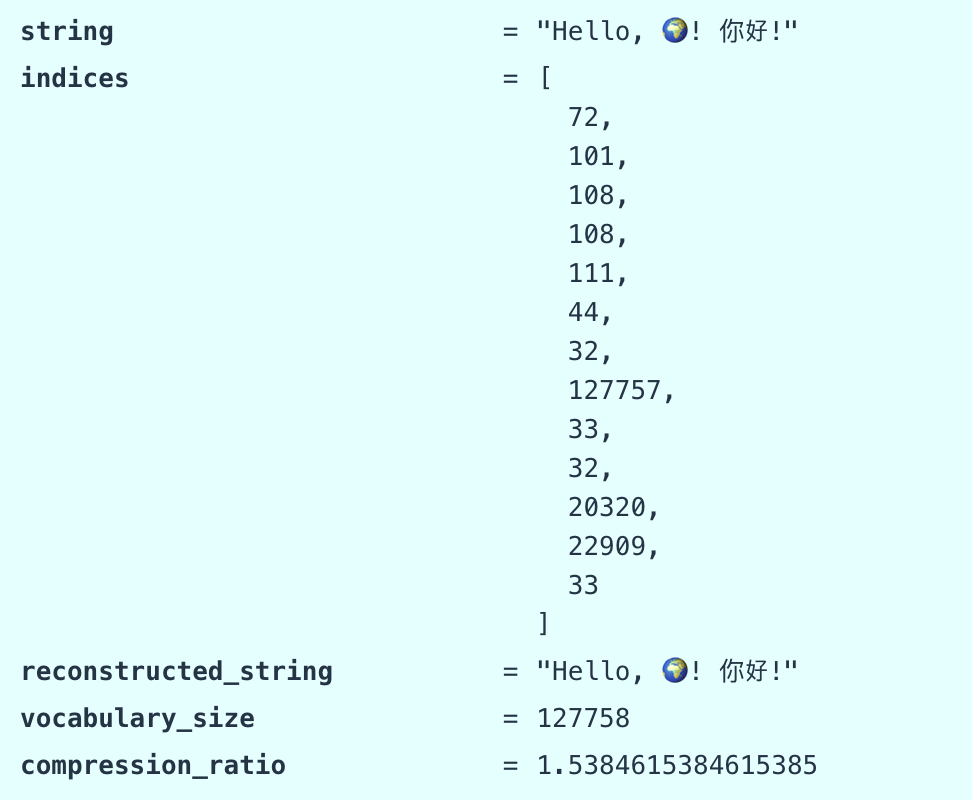
compression_ratio (길이 / 지수 개수) = 1.5가 나오는 걸 볼 수 있음
byte tokenizer
글자를 UTF-8로 바꿔서 한다~ -> UTF-8은 글자를 1~4바이트로 표현 가능함. (0~255)
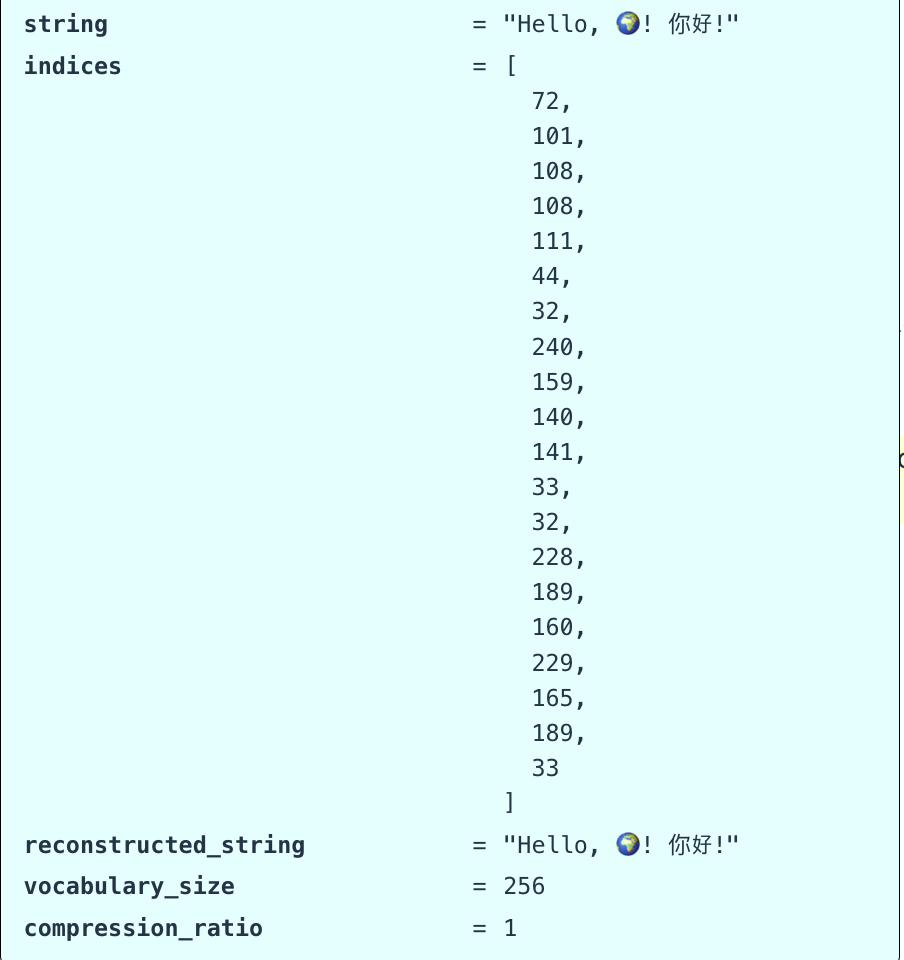
Ratio가 1이 나왔는데 이건 최악임. 압축률이 0퍼라는 거니까.
word tokenizer
뭐 새로운 단어가 나오면 다른거 해야하고, vocabulary size가 문제겠지~
bpe_tokenizer
-> 일단 다 나눈 다음에, 자주 나온 순서로 병합함. 그리고 최종 결과를 단어쌍(indices)에 추가함.
Summary
Tokenizer: strings <-> tokens (indices)
Character-based, byte-based, word-based tokenization highly suboptimal
BPE is an effective heuristic that looks at corpus statistics
Tokenization is a necessary evil, maybe one day we'll just do it from bytes...
과제: BPE 구현해보기~
다음시간에는 파이토치 해보기
