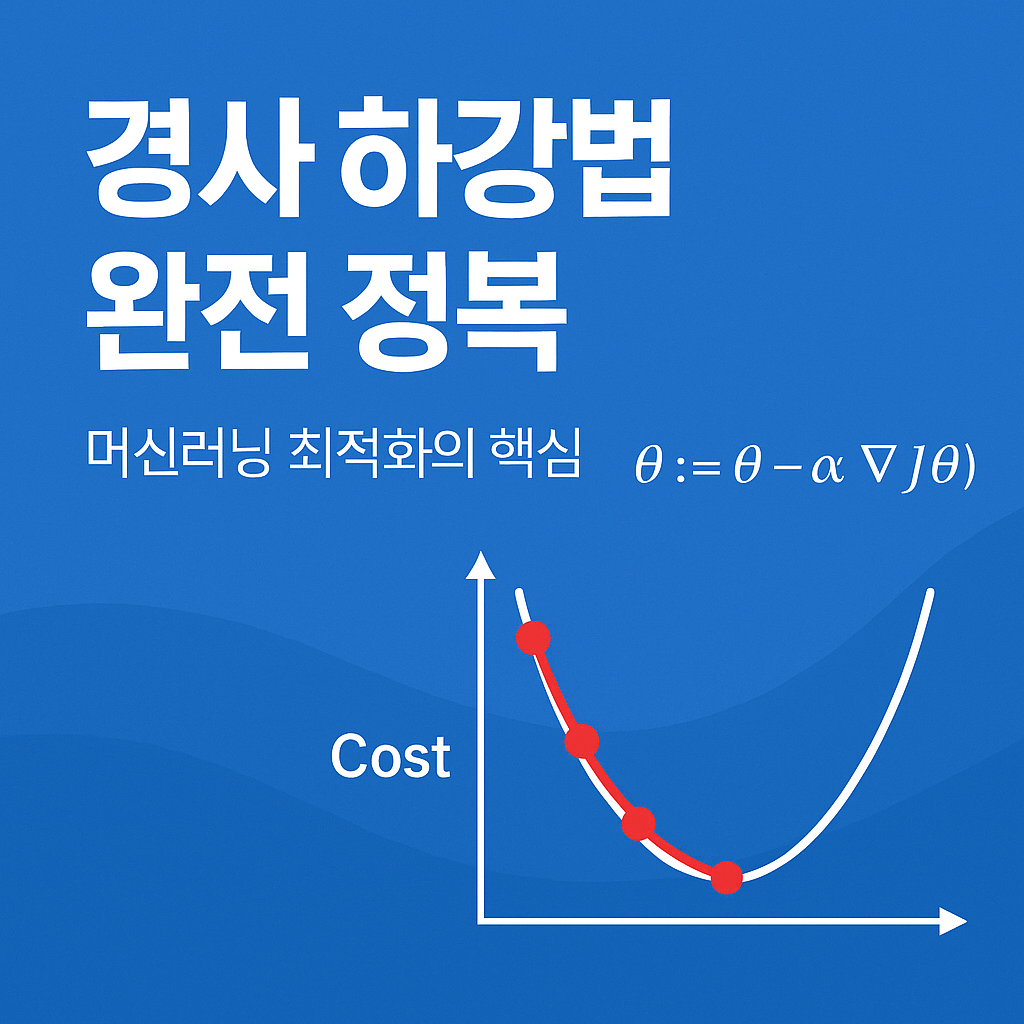
개요
경사하강법(Gradient Descent)은 머신러닝과 딥러닝에서 모델의 파라미터를 최적화하기 위해 널리 사용되는 반복적 최적화 알고리즘입니다.
모델의 예측값과 실제값 사이의 오차를 측정하는 비용 함수(Cost Function)를 최소화하는 방향으로 파라미터를 조정하여 모델의 성능을 향상시킵니다.
목표
비용 함수 를 최소화하는 파라미터 를 찾는 것입니다.
수학적 표현
- : 최적화할 파라미터 (예: 가중치, 편향)
- : 학습률 (Learning Rate)
- : 비용 함수에 대한 파라미터의 기울기
경사 하강법의 변형
1. 배치 경사 하강법 (Batch GD)
- 전체 데이터셋을 사용하여 한 번에 파라미터 업데이트
- 수렴 안정적이지만 계산 비용이 큼
2. 확률적 경사 하강법 (Stochastic GD, SGD)
- 각 샘플마다 파라미터 업데이트
- 빠르지만 노이즈로 수렴이 불안정
3. 미니배치 경사 하강법 (Mini-Batch GD)
- 소규모 배치 단위로 업데이트
- 속도와 안정성의 균형을 제공
확장 기법 및 고급 주제
1. 모멘텀 (Momentum)
- 과거 기울기를 누적해 관성을 부여
- 공식:
- 장점: 지그재그 수렴 완화, 빠른 수렴
2. 네스테로프 가속 경사 (NAG)
- 모멘텀 업데이트 전에 미리 기울기 계산
- 더 정확한 방향 제어
3. 학습률 스케줄링 (Learning Rate Scheduling)
- 학습이 진행됨에 따라 점진 감소
- 스텝 감소, 지수 감소, 사이클릭 LR 등
4. 적응형 최적화 기법
- AdaGrad: 학습률을 과거 제곱 기울기로 나누어 조정
- RMSProp: 지수이동평균으로 AdaGrad 과도한 감소 완화
- Adam: 모멘텀과 RMSProp 결합, 현재 가장 널리 사용
파이썬 예제: 단순 선형 회귀에서의 경사 하강법
import numpy as np

# 데이터 (y = 2x)
x = np.array([1, 2, 3, 4, 5])
y = 2 * x

# 초기 파라미터
w, b = 0.0, 0.0
alpha = 0.01
epochs = 500
costs = []

for epoch in range(epochs):
    y_pred = w * x + b
    error = y_pred - y
    cost = np.mean(error**2)
    costs.append(cost)

    # 기울기 계산
    grad_w = 2 * np.mean(error * x)
    grad_b = 2 * np.mean(error)

    # 파라미터 업데이트
    w -= alpha * grad_w
    b -= alpha * grad_b

print(f"w = {w:.4f}, b = {b:.4f}")
주의사항
- 학습률 (): 발산/느린 수렴 방지를 위해 적절히 조정
- 지역 최소값: 비볼록 함수 환경에서 발생
- 특성 스케일링: 표준화·정규화 필수
결론
경사 하강법과 그 확장 기법들은 머신러닝 최적화의 핵심입니다.
기본 GD부터 모멘텀, Adam까지 다양한 기법을 이해하고 적용해 보세요.
감사합니다.
AI와 함꼐 걸어가는 코딩 입문자 드림
능숙한 바이브코딩을 할 수 있게 됨을 꿈꾸며