구글 해킹이란?
Google Hacking(Dorking)은 구글의 고급 검색 연산자를 활용해 일반 검색으로 찾기 어려운 공개 정보나 잘못 노출된 파일이나 시스템을 찾아내는 정보수집 기법(OSINT)이다.
구글 검색의 원리
1단계 (크롤링): 크롤러(Googlebot)가 웹상의 링크를 따라다니며 웹 문서와 관련 데이터를 가져옵니다.
2단계 (색인/인덱싱): 인덱서가 가져온 문서를 파싱하여 URL, Title, 파일 확장자, 본문 등 속성별로 쪼개고 검색이 용이하도록 필드 단위의 색인 데이터베이스를 구축합니다.
3단계 (쿼리 처리): 쿼리 프로세서가 사용자의 검색어와 연산자(intitle:, inurl:, filetype: 등)를 해석하여 인덱서가 구축해 둔 해당 필드 DB 영역을 빠르게 조회합니다.
4단계 (랭킹 및 반환): 결과 랭커가 필터링된 후보군에 페이지순위 및 관련성 알고리즘을 적용하여 최적의 순서로 정렬한 뒤 사용자에게 보여줍니다.
전통적인 Active 스캐닝기법과 구글 해킹의 차이
Active Scanning
공격대상을 향해 정보수집도구(Nmap)로 직접 패킷을 날려서
정보를 수집하는 행위
- 대상 인프라나 서버를 스캐닝하여 직접적인 트래픽 유발
- IDS/IPS 시스템이 스캐닝을 차단하거나 기록할 가능성 높음
- 공격자의 IP가 기록될 가능성 높음
- 법적 리스크 높음
구글해킹
- 구글 서버를 향한 트래픽만 유발
- 공격대상의 IPS/IDS에 의해 발각될 가능성 낮음
- 대상 인프라에 로그가 남을 가능성 낮음
- 구글링 자체는 데이터가 공개적으로 노출된 것을 활용하기 때문에
법적리스크가 낮음
구글 해킹에 사용되는 고급 검색 연산자의 종류
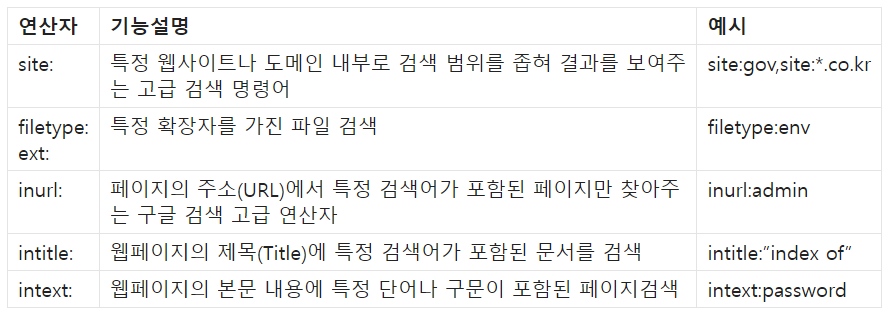
구글 검색을 통해 식별되는 주요 웹 취약점 및 정보 유출 유형
1.관리자 페이지 및 로그인 인터페이스 노출
외부망에 노출되지 않아야 하는 사내 내부 관리자 시스템, CMS 관리 콘솔, 데이터베이스 관리 도구(phpMyAdmin 등) 등 로그인 관문 페이지가 수집되어 색인화되는 위협이다.
공격자는 노출된 관리자 페이지에 접근하여 무차별 대입 공격(Brute Force Attack), 자격 증명 대입 공격(Credential Stuffing), 또는 기본 계정(Default Credentials) 접속을 시도한다.
intitle:"admin login", site:example.com, inurl:admin intitle:login, inurl:phpMyAdmin/index.php와 같은 검색 구문이 주로 활용된다.
2.백업 파일 및 환경 변수 파일 유출
웹 애플리케이션의 배포나 유지보수 과정에서 생성된 백업 파일(.bak, .old, .swp), 데이터베이스 덤프 파일(.sql), 인프라 설정 파일(.env, web.config)이 웹 루트(Web Root) 디렉토리에 방치될 경우 구글 크롤러에 의해 즉시 수집된다.
특히 .env 파일에 데이터베이스 접속 암호, AWS IAM Access Key, JWT Secret Key, 외부 API 비밀키 등 핵심 자격 증명이 평문으로 포함되어 있는 경우 단 한 번의 색인 노출만으로 인프라 전체가 침해되는 위험한 결과를 초래한다.
filetype:env "DB_PASSWORD", filetype:sql "mysql dump",
filetype:bak inurl:web.config 구문을 활용하여 이러한 설정 파일을 필터링한다.
3.시스템 로그 및 에러 메시지를 통한 구조 노출
애플리케이션 구동 중 발생하는 오류 메시지나 시스템 작업 로그 파일(.log)이 인덱싱되는 현상이다.
로그 파일 내부에는 시스템의 절대 파일 경로(Absolute Path), 서버 내부 IP 주소, API 호출 트랜잭션 데이터, 사용자 로그인 기록이 포함될 수 있다.
Stack Trace나 SQL 구문 에러 메시지는 백엔드 프레임워크의 상세 버전과 데이터베이스 구조를 명확히 노출하므로, 타겟형 익스플로잇을 설계하기 위한 정찰 정보로 악용된다.
filetype:log intext:password, inurl:error.log intitle:"index of", 또는 intext:"PHP Fatal error:" ext:log 로 해당 정보를 수집한다.
4.디렉토리 인덱싱(Directory Listing) 활성화
웹 서버(Apache, Nginx 등)의 설정 중 Indexes 옵션이 활성화되어 있고 해당 폴더 내에 기본 인덱스 파일(index.html, index.php 등)이 존재하지 않을 때
웹 서버는 폴더 내부의 전체 파일 목록을 브라우저에 그대로 출력한다.
이를 통해 비공개 소스 코드, 설정 파일, 내부 문서 등이 외부로 완전 노출되며 원클릭 다운로드가 가능해진다.
intitle:"index of" "parent directory", intitle:"index of /admin", intitle:"index of" "config.php" 등이 사용된다.
5.사내 공유 문서 및 개인정보(PII) 노출
사내 임직원이 업무 편의를 위해 웹 루트 디렉토리에 업로드한 엑셀, PDF, 워드 문서가 크롤링되는 케이스
문서 내부에는 사내 직원 계정 명단, 고객 개인정보, 급여 명세서, 보안 진단 결과서 등이 포함되어 있어 2차 사회공학적 공격이나 피싱으로 이어질 수 있다.
filetype:xls intext:password,
site:example.com filetype:pdf "confidential",
inurl:pastebin intitle:mastercard가 존재한다
6.IoT 장비 및 네트워크 인프라 제어 화면 노출
보안 인증 설정이 생략되어 있거나 기본 자격 증명(Default Credentials)이 변경되지 않은 IP 카메라, CCTV, 라우터, 웹 스위치, NAS 장비의 웹 인터페이스가 색인되어 노출되는 경우다
이를 통해 외부 공격자가 물리적 보안 카메라 영상을 실시간으로 관제하거나 네트워크 장비의 설정을 무단 변경할 수 있다.
inurl:view/view.shtml, intitle:"webcamXP 5",
inurl:8080 intitle:"web config"가 대표적이다.
7.클라우드 스토리지 및 프론트엔드 API 자격 증명 유출
React, Vue, Angular 등 현대적인 단일 페이지 애플리케이션(SPA) 환경에서는 프론트엔드 자바스크립트 빌드 파일 내에 API 엔드포인트와 API 키가 하드코딩되는 위험성이 높다.
소스 맵 파일(.map)이 서버에 방치되어 인덱싱되면 프론트엔드 원본 소스 코드가 완전히 복원되어 미공개 API 경로와 비즈니스 로직이 노출되며,
AWS S3 버킷이나 GCP 스토리지가 public 읽기 권한으로 잘못 설정된 경우 구글 색인에 포함되어 대규모 데이터 유출을 유발한다.
검색어 예시로는
site:s3.amazonaws.com "example", inurl:main.chunk.js.map, site:github.com "BEGIN RSA PRIVATE KEY"
등이 있다
구글 해킹 데이터베이스(GHDB)
구글 해킹 데이터베이스(Google Hacking Database, GHDB)
보안 연구원 조니 롱(Johnny Long)에 의해 최초로 고안되었으며,
현재는 오펜시브 보안(OffSec) 팀의 Exploit-DB 프로젝트를 통해
커뮤니티 주도로 통합 관리되고 있는 구글 검색어 저장소이다.
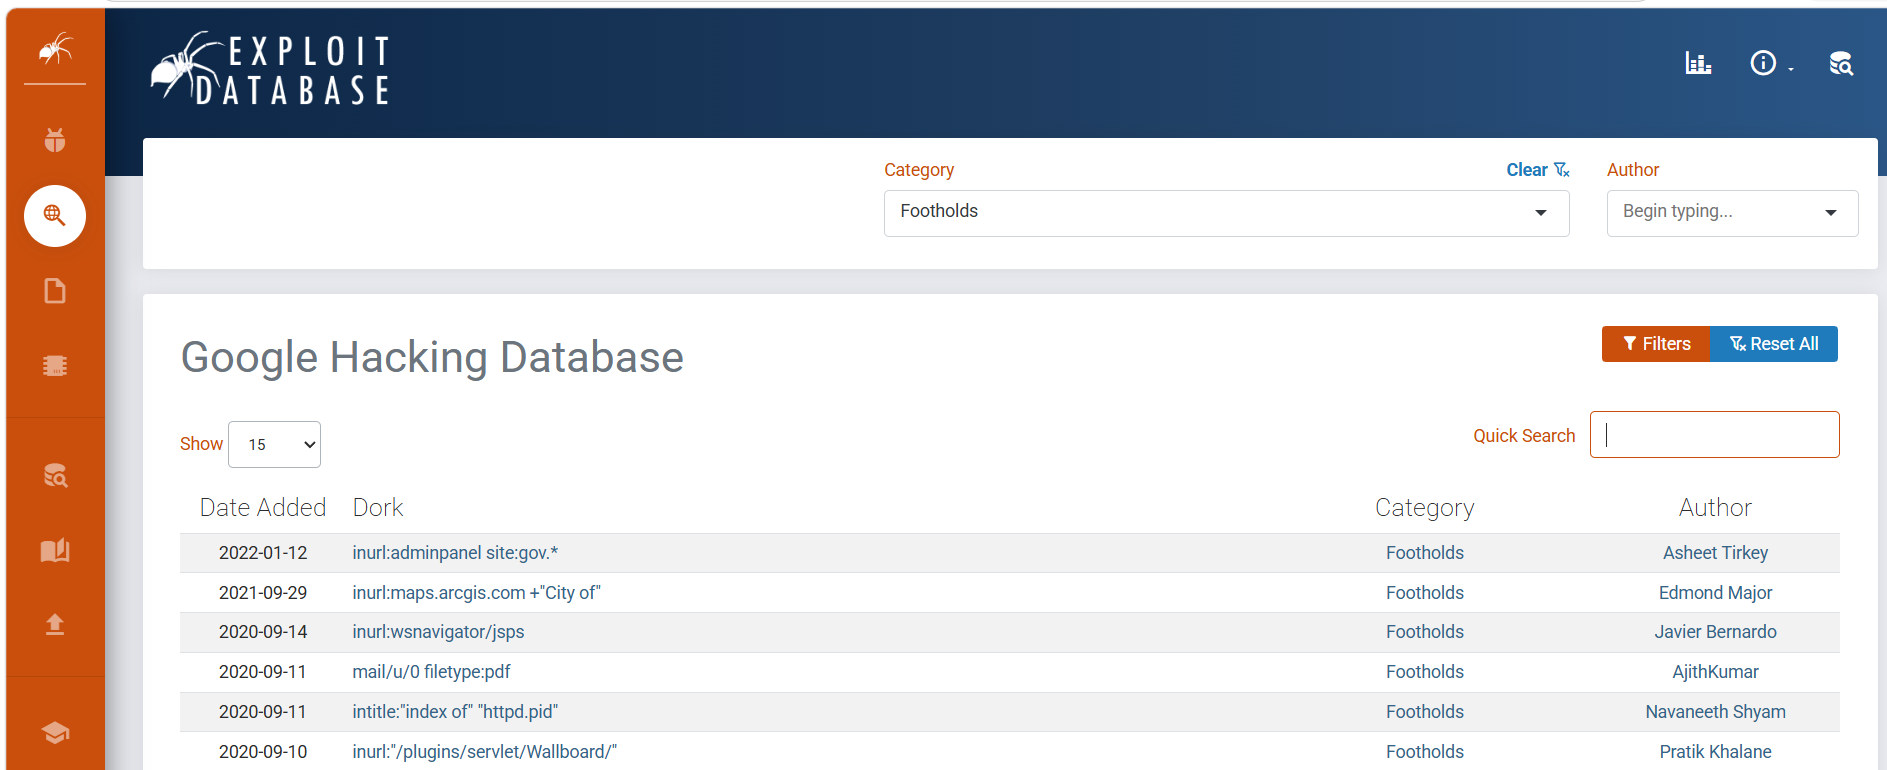
GHDB는 전 세계 보안 전문가들이 발견한 고도화된 고급 검색 질의어를
정제하여 수록하고 있으며, 타겟 시스템의 민감 정보 노출 및 웹 애플리케이션 취약점을 진단할 수 있는 도구를 제공한다.
GHDB는 수집된 검색어를 탐지 대상의 속성 및 보안 위협의 성격에 따라 약 12가지 정교한 카테고리로 분류하여 운영하고 있다
1.Footholds:서버 내부 침투점으로 활용 가능한 초기 접근 경로 및 테마/플러그인 구조 탐지
2.Files Containing Usernames:사용자 계정이나 이름 정보가 노출된 파일을 검색하는 용도
3.Files Containing Juicy Info:설정 파일이나 내부 문서 등 민감한 정보가 담긴 파일을 검색
4.Error Messages:디버깅 정보, SQL 오류 구문, PHP 스택 트레이스 등 내부 구조 노출 에러 탐지
5.Pages containing login portals: 시스템 관리자나 사용자의 로그인 페이지를 검색
6.Files containing passwords: 비밀번호나 암호화 키 등이 포함된 파일을 검색
7.Sensitive Directories:외부로 공개되면 안 되는 민감한 디렉토리 구조(Index of 등)를 검색
8.network or vulnerability data: 네트워크 구성도나 취약점 진단 결과가 포함된 페이지 탐색
9.Vulnerable Files: 보안 패치가 되지 않았거나 취약점이 존재하는 파일을 탐색
10.Vulnerable Servers: 특정 취약 버전의 웹 서버나 장비를 검색
11.Various Online Devices: 웹캠, 라우터 등 인터넷에 연결된 다양한 기기 검색
12.Advisories and Vulnerabilities: 보안 취약점 공지나 관련 권고문이 포함된 페이지를 검색
구글 해킹 방어 전략 및 보안 강화 방안
1. 웹 크롤러 통제 (접근 차단)
검색 엔진 로봇이 웹사이트의 민감한 디렉토리나 파일을 수집하지 못하도록 설정합니다
로봇 메타 태그 활용: 검색 결과에 노출되면 안 되는 특정 HTML 페이지 헤더에
<meta name="robots" content="noindex, nofollow">태그를 삽입하거나 웹 서버의 응답 헤더에
X-Robots-Tag: noindex, nofollow, noarchive를 포함시켜 크롤러가 색인 데이터베이스에 페이지를 저장하지 못하도록 강제해야 한다.
2.서버 및 애플리케이션 보안 설정 확인
- 디렉토리 리스팅(Directory Listing) 비활성화: 웹 서버(Apache, Nginx, IIS 등) 설정에서 디렉토리 인덱싱 기능 비활성화 필수
이 기능이 켜져 있으면 Index of /admin과 같이 폴더 내부 파일 목록이 크롤링된다. - 에러 메시지 숨김 처리: 데이터베이스 에러나 서버 내부 오류(PHP, ASP.NET 등)가 발생했을 때 상세한 디버깅 정보가 화면에 출력되지 않도록 공통 에러 페이지(404, 500 등)를 구성합니다.
- 인증 및 접근 제어: 관리자 페이지나 내부용 시스템은 사내 IP나 특정 VPN IP에서만 접속할 수 있도록 IP화이트리스트 설정한다.
3. 민감한 데이터 관리
- 민감한 파일 관리: 설정 파일(.env, .git, config.php), 백업 파일(.bak, .zip, .sql)이 웹 루트 경로에 방치되지 않도록 비공개거나 외부 저장소에 저장합니다.
- 클라우드 스토리지 권한 설정: AWS S3 버킷이나 Google Cloud Storage 등의 권한이 실수로 Public으로 설정되어 파일이 구글에 인덱싱되지 않도록 주기적으로 권한을 점검합니다.
4.이미 노출된 민감 정보의 긴급 조치
구글 검색 결과에 조직의 핵심 자격 증명이나 비공개 파일이 이미 노출된 것으로 확인된 경우, 웹 서버에서 노출된 파일의 접근 권한을
폐쇄하거나 즉시 삭제하고 노출된 파일에 포함되었던
데이터베이스 접속 암호, API 키, SSH 프라이빗 키 등
자격 증명을 즉시 재발급하여 기존 키의 유효성을 완전히 무력화한다.
마지막으로 구글 서치 콘솔(Google Search Console)의 URL 삭제 요청 도구를 활용하여 구글 서버에 저장되어 있는 색인 데이터 및 검색 결과 항목의 긴급 삭제를 신청한다
