패러다임 불일치란?
객체 지향 프로그래밍과 관계형 데이터베이스는 구조와 개념이 달라
데이터를 저장하고 조회하는 과정에서 발생하는 차이를 의미한다
객체는 참조를 통해 연결되지만, 관계형 DB는 외래키(FK)로 연결되며
상속, 객체 그래프 탐색 등의 개념도 직접적으로 지원하지 않는다
JPA는 이러한 패러다임 불일치를 해결하기 위해
객체와 DB 사이를 매핑해주는 ORM 기술이다
패러다임 불일치 문제 정리
| 구분 | 객체 지향 (Java) | 관계형 DB | 문제 (불일치) | JPA 해결 방법 |
|---|---|---|---|---|
| 1. 상속 | 클래스 상속 가능 (extends) | 상속 개념 없음 | 객체 구조를 그대로 DB에 표현 불가 | Hibernate |
| 2. 연관관계 | 객체 참조로 연결 (order.getCustomer()) | 외래키(FK)로 연결 | 참조 vs FK 구조 차이 | @ManyToOne, @OneToMany |
| 3. 객체 그래프 탐색 | 객체를 계속 타고 탐색 가능 | 매번 JOIN 필요 | 자유로운 탐색 불가능 | LAZY/EAGER 로딩 |
| 4. 객체 비교 | 동일 객체 비교 (==) | 같은 row라도 다른 객체 | 동일성 보장 안됨 | 영속성 컨텍스트 (1차 캐시) |
JPA
JPA의 사용 목적은 SQL 중심적인 개발에서 객체 중심으로 개발하기 위함에 있다
JPA는 객체 지향 프로그래밍과 관계형 데이터베이스 간의 차이를 해결하고,
개발 생산성과 유지보수성을 향상시키기 위해 사용된다.
1. 생산성
SQL을 직접 작성하지 않고도 CRUD 작업이 가능하여 개발 속도가 향상된다
// 저장
jpa.persist(tutor);
// 조회
Tutor tutor = jpa.find(Tutor.class, tutorId);
// 수정
tutor.setName("수정할 이름");
// 삭제
jpa.remove(tutor);
2. 유지보수성
데이터베이스 변경 시 엔티티만 수정하면 되므로 코드 수정 범위가 줄어든다
3. 패러다임 불일치 해결
객체의 참조, 상속, 그래프 탐색 구조를 관계형 데이터베이스에 맞게 매핑해준다 위표에 참조
4. 성능
1차 캐시, 쓰기 지연, 변경 감지 등의 기능을 통해 데이터베이스 접근을 최소화하고 성능을 최적화한다.
1차캐시, 쓰기지연?
JPA는 성능 최적화를 위해 영속성 컨텍스트 내부에
1차 캐시와 쓰기 지연 저장소를 분리하여 관리한다
처음에 수업을들었을때 두공간이 같은공간의 메모리를 가지는줄 생각하고있었다
근데 튜터님께 질문과 개인적으로 조금더 공부해본 결과
1차 캐시는 조회한 엔티티를 저장하는 메모리 공간으로
같은 데이터를 반복 조회할 때 DB 접근을 줄이고 동일성을 보장한다.
쓰기 지연은 INSERT, UPDATE, DELETE 쿼리를 바로 실행하지 않고
임시 저장소에 모아두었다가 트랜잭션 커밋 시 한 번에 실행하는 방식이다
이를 통해 네트워크 비용을 줄이고 데이터베이스 성능을 최적화할 수 있다
1차 캐시는 조회 성능을 최적화
쓰기 지연은 쓰기 성능을 최적화 시킨다
그래서 영속성 컨텍스트가 뭔데?
JPA를 사용하는 이유를 정리하다 보니
성능 최적화, 객체와 DB 사이 관리 라는 키워드가 계속 등장한다
그 중심에 있는 개념이 바로 영속성 컨텍스트(Persistence Context)이다
위에서 얘기한거처럼 처음에내가 오해했던 쓰기 지연공간 , 1차캐시 메모리저장공간
이런것들이 다 엔티티를 관리하고 DB와의 중간 역할을 수행하는 JPA의 핵심 메모리 공간이다
영속성 컨텍스트는 엔티티를 저장만하는 공간이 아니라 엔티티의 4가지 상태를 관리한다
1. 비영속
- 영속성 컨텍스트가 전혀 모르는 상태
- 단순히
new로 생성된 객체 - DB와 전혀 관계 없음
예시코드
Person youngbeom = new Person();
2. 영속
- 영속성 컨텍스트에 의해 관리되는 상태
- DB와 연결된 상태
- 변경 감지(Dirty Checking) 가능
예시코드
EntityManager em = emf.createEntityManager();

em.getTransaction().begin();

// 1. 비영속
Person youngbeom = new Person();

// 2. 영속
em.persist(youngbeom);

System.out.println(em.contains(youngbeom)); // true 영속 상태

em.getTransaction().commit();
3. 준영속
- 영속 상태였다가 영속성 컨텍스트에서 분리된 상태
- 더 이상 JPA가 관리하지 않음
- 변경 감지 안됨
1)em.detach()
- 특정 Entity만 준영속 상태로 변경한다.
2)em.clear()
- 영속성 컨텍스트를 초기화 한다.
3)em.close()
- 영속성 컨텍스트를 종료한다.
4. 삭제
- 삭제가 예약된 상태
- 트랜잭션 commit 시 DB에서 실제 삭제됨
em.remove(youngbeom);변경 감지(Dirty Checking) 와 flash
영속성 컨텍스트가 엔티티의 초기 상태를 저장하고 트랜잭션 커밋 시점에 현재 상태와 비교해 변경 사항이 있는지 확인하는 기능이다
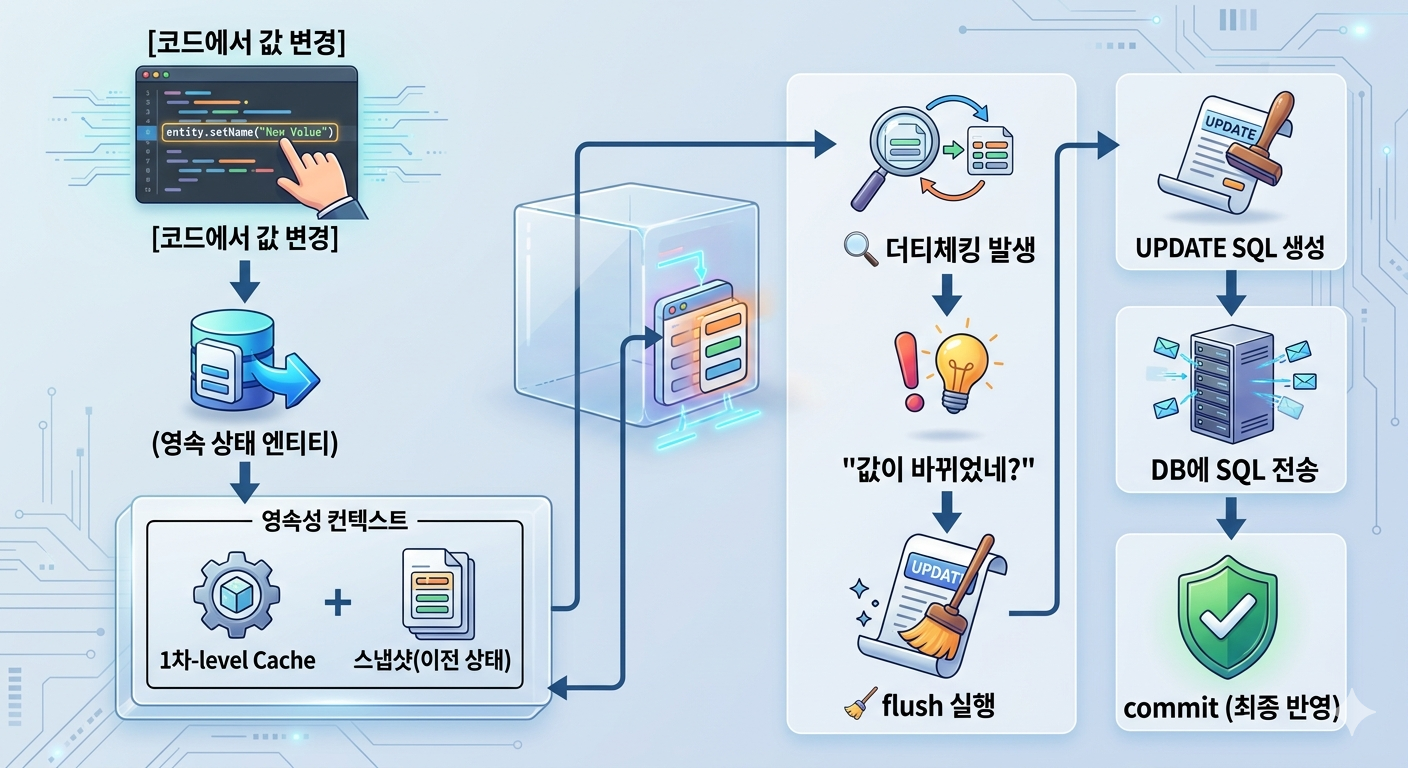
JPA에서는 엔티티를 조회하면 자동으로 영속 상태가 되며,
해당 객체의 값을 변경하면 별도의 update 쿼리 없이도 DB에 반영된다
이는 영속성 컨텍스트가 기존 상태를 저장하고 있다가
변경 여부를 감지(Dirty Checking)하고
트랜잭션 종료 시 flush를 통해 update 쿼리를 실행하기 때문이다
예를들어,
1) DB에서 사람 하나 가져옴
Student student = em.find(Student.class, 1L);JPA내에서는 지금 객체 내가 기억해둘게 라고 말한다
2) 값 바꿈
Student.setName("youngbeom");JPA 내부에서는
아까는 다른이름이였던거같은데 지금은 youngbeom이구나
바뀐걸 확인 -> 더티체킹
3) 메서드 끝남 (commit)
@Transactional 끝
JPA 에서는
바뀐 게 있으니까 DB에 반영하자
그래서 UPDATE 실행 -> Flush 진행
commit 반영
조금더 쉽게 설명하면
1. DB 내용 복사해서 메모장에 붙여넣음
2. 메모장에서 수정함 -> 더티체킹
3. 저장 버튼 누름 -> flash
결론
JPA는 조회한 객체를 기억하고 있다가 값이 변경되면
트랜잭션이 끝날 때 자동으로 JPA가 대신 Update를 DB에 반영한다
회고
튜터님의 수업을들으면서 1차캐시의 메모리공간과 쓰기지연의 메모리공간같은게
정확하게 이해가 되지않았고, JPA가 왜 update 쿼리를 직접 작성하지 않아도 되는지 잘 이해되지 않았다 오늘 TIL을 작성하면서 한번더 공부하게되었고 더티체킹과 flush 개념을 배우면서 값을 바꾸게 되면 내가 처리하지않아도 JPA가 알아서 처리해준다는걸 다시한번 느끼게되면 왜 TIL 주제로 영속성 컨텍스트를 주셨는지 알게되면서 JPA 는 단순히 쿼리작성을 위해 쓰는 repository가 아닌
객체와 DB를 효율적으로 연결하는 기술이라는 것을 느꼈다.
