2025 해군 AI 경진대회에서 LT Model팀으로 참가하여 최종 수행한 과제를 Velog 포스팅으로 정리하였습니다. 주어진 문제별로, 문제정의·데이터셋 소개·데이터 전처리·Feature Engineering·모델링 전략·결과·소감 및 한계점을 본 포스팅을 통해 함께 공유합니다.
문제 정의
본선에서 주어진 문제는 총 2개였으며, 문제별로 각각 데이터셋이 별도로 주어졌고 주어진 데이터셋을 활용하여 각 문제별로 최적의 모델을 학습 및 평가하였습니다.
저작권 문제로 주어진 데이터셋은 비공개합니다.
AIS상 의심선박 탐지 문제(#1)
◦ 데이터 : 해수부 AIS 정보(2023.06.01. ~ 2024.05.31./1년) 제공 / 총 366개 파일(.csv)
◦ 주어진 의심선박 기준은 아래 조건과 같음.
- 정박지 이외 해역에서 1시간 이상 항적 변화 없음
- 5kts 이하로 저속 항해하는 선박(한국선박 제외)
- 특정금지수역이나 해군훈련구역에서 체류한 누적 시간이 1시간 이상 머무는 선박
- 정박지 이외의 해역에서 급변침(90도 이상) 선박
- 해저케이블 매설지역 인근에서 5kts 이하로 저속항해 또는 반복적 왕복 항해하는 선박
- 진입금지 구역에 진입한 선박
◦ 평가방식 : 정확도(F1 Score) / TRUE(의심선박), FALSE(정상선박)
데이터 분석 및 전처리
결측치 및 이상치는 아래 기준으로 다음과 같이 처리하였습니다.
결과적으로 선박 데이터 정보의 정상 값 수준으로 결측치에 대해 데이터 전처리를 수행 후,
| 대상 열 | 규칙 | 처리 로직 |
|---|---|---|
| MMSI | 선박 고유 식별자 | 결측/중복 → 행 삭제 |
| 속력(SOG) | SOG > 50 kn → 비현실적 | NaN → 구간 평균값으로 대체 |
| 위·경도(lat, lon) | 육지·0,0 등 없는 좌표 | 해당 레코드 제거 |
| 신호 공백 | 평균 간격 ≥ 3 600 s(1 h) | 해당 구간 통째로 삭제 |
💻 전처리 함수 구현 코드
def preprocess(raw: pd.DataFrame) -> pd.DataFrame:
    df = raw.copy()

    # 1) MMSI 무결성
    df = df.dropna(subset=["MMSI"]).drop_duplicates()

    # 2) 이상 속도 → 보간
    df.loc[df["sog"] > 50, "sog"] = np.nan
    df["sog"] = df["sog"].interpolate(limit_direction="both")

    # 3) 비정상 좌표 제거
    valid = (-90 <= df["lat"]) & (df["lat"] <= 90) & \
            (-180 <= df["lon"]) & (df["lon"] <= 180) & \
            ~((df["lat"] == 0) & (df["lon"] == 0))
    df = df.loc[valid]

    # 4) 장기 공백 신호 삭제
    df["timestamp"] = pd.to_datetime(df["timestamp"])
    df = df.sort_values("timestamp")
    gap = df["timestamp"].diff().dt.total_seconds()
    df = df.loc[(gap < 3600) | gap.isna()]

    return features
평균·최대 속력, 제한구역 접근, 선회수 등 주어진 데이터셋으로부터 파생 변수를 생성하여 AIS 원본 로그에 모델이 의심 행동 패턴을 다이렉트로 학습하도록 하였습니다.
💻 Feature Engineering 구현 코드
import numpy as np
import geopandas as gpd
from shapely.geometry import Point, LineString

def behavior_flags(df, special_poly, forbidden_poly):
    """
    df : 단일 MMSI 로그 (time-sorted DataFrame)
    special_poly / forbidden_poly : GeoPandas Polygon
    """
    # 1) 외국선박 여부
    is_kor = df["MMSI"].astype(str).str.startswith("440")  # KOR MMSI
    foreign = (~is_kor).any()

    # 2) 저속 구간 (≤5 kn) 연속 길이
    low = df["sog"] <= 5
    low_dur = (low.astype(int).groupby((low != low.shift()).cumsum())
               .transform("count")) * df["timestamp"].diff().dt.total_seconds().fillna(0)
    low_long = (low & (low_dur >= 1800)).any()

    # 3) AIS OFF (신호 공백 ≥ 30분) 카운트
    gap_cnt = (df["timestamp"].diff().dt.total_seconds() >= 1800).sum()

    # 4) 해역 진입 횟수
    gdf = gpd.GeoSeries([Point(xy) for xy in zip(df.lon, df.lat)], crs="EPSG:4326")
    enter_special = (gdf.within(special_poly)).sum() >= 2
    enter_forbid  = (gdf.within(forbidden_poly)).any()

    # 5) 급변침 이벤트
    heading_diff = np.abs(np.ediff1d(df["cog"].fillna(method="ffill"), to_begin=0))
    heading_diff[heading_diff > 180] = 360 - heading_diff[heading_diff > 180]
    hard_turn = (heading_diff >= 90).any()

    # 6) 왕복 패턴 (저속 + 방향 반전)
    traj = LineString(gdf.values)          # 전체 항적
    dist = traj.length                     # 단위: degree(≃NM 근사)
    slow_rt = low.any() and (dist >= 1)

    return {
        "foreign_low_speed":  int(foreign and low_long),
        "ais_off_3plus":      int(gap_cnt >= 3),
        "enter_special_multi":int(enter_special),
        "hard_turn":          int(hard_turn),
        "slow_round_trip":    int(slow_rt),
        "enter_prohibited":   int(enter_forbid),
    }
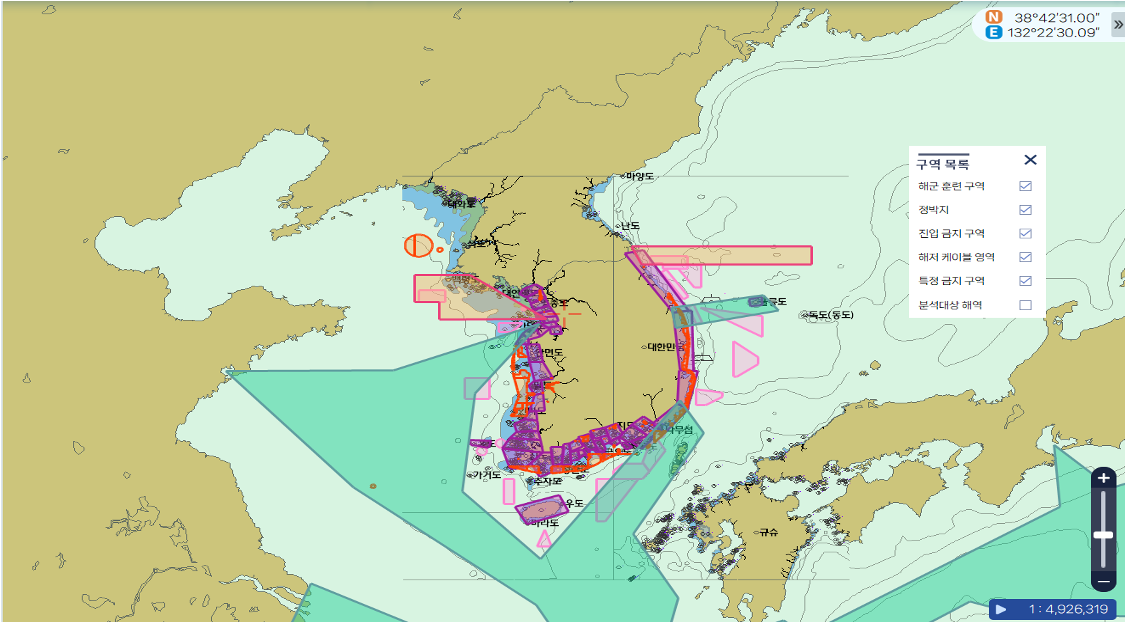
추가로 대회 주최 측에서 전자해도를 제공하여, 의심 선박으로 분류에 활용되는 6가지 구역(.json 파일) 정보도 모델 학습 간 활용할 수 있었습니다.
모델 선정 및 학습
모델의 안정적인 성능을 위해, LightGBM + CatBoost + XGBoost + TabNet 조합을 단일 프레임워크로 다룰 수 있는 AutoGluon 라이브러리를 활용하여 AutoML으로 앙상블 모델 학습을 진행하였습니다.
이를 통해 의심선박 규칙 기반(Rule Weighting) + AutoGluon 앙상블 = 고성능·고생산성·설명가능 모델을 학습시키는데 집중하도록 하였습니다.
최종 모델링 코드는 github에 업로드 하였습니다.
항적 데이터 기반 북한선박 탐지 문제(#2)
◦ 문 제 : 항적 데이터 셋을 기준으로 북한선박 식별
◦ 데이터 : 해수부 항적 데이터 파일(1,299개) 및 익명의 MMSI 라벨(1,200개 레코드) 제공
◦ 북한선박을 분류하는 별도의 기준 없음
◦ 평가방식 : 정확도(F1 Score) / TRUE(북한선박), FALSE(정상선박)
데이터 전처리 및 분석
- 데이터셋 구성(Sample)
| 필드 | 설명 | 예시 |
|---|---|---|
timestamp | UTC 시간 (30 ~ 180 s 간격) | 2023-06-01 12:00:08 |
sog | 속력(kn) | 2.6 |
cog | 침로(°) | 167.1 |
lat | 위도(°) | 34.24851 |
lon | 경도(°) | 127.8508 |
선박별 시퀀스 학습(LSTM)을 위해 주어진 항적정보 데이터셋의 원본 로그를 정상 값 수준으로 정제하고, 30 초 단위 시계열로 아래 규칙을 통해 재구성하였습니다.
| 항목 | 규칙 | 처리 방법 |
|---|---|---|
| 샘플링 간격 | 30 ~ 180 s | 30 s 기준으로 리샘플 + 선형 보간 |
| 속력(sog) | > 50 kn → 이상치 | 선박별 중간값(median) 대체 |
| 침로(cog) | 유효 범위 0 ≤ cog < 360 | 벗어나면 NaN → 최근값 ffill |
| 위·경도 | lat ∉ [-90,90] or lon ∉ [-180,180] | 행 삭제 |
| 신호 공백 | Δt ≥ 1 h | 해당 구간 제거 (시퀀스 분할) |
💻 전처리 구현 코드
import pandas as pd
import numpy as np

def clean_nk(df_raw: pd.DataFrame, freq="30S") -> pd.DataFrame:
    # 1) 타입 변환 & 정렬
    df = df_raw.copy()
    df["timestamp"] = pd.to_datetime(df["timestamp"])
    df = df.sort_values("timestamp").set_index("timestamp")

    # 2) 리샘플(30s) & 보간
    df = df.resample(freq).mean()
    df["sog"] = df["sog"].interpolate()
    df["cog"] = df["cog"].interpolate(method="nearest")

    # 3) 속력 이상치 -> median
    med = df["sog"].median()
    df.loc[df["sog"] > 50, "sog"] = med

    # 4) 침로 범위 보정
    df.loc[(df["cog"] < 0) | (df["cog"] >= 360), "cog"] = np.nan
    df["cog"] = df["cog"].fillna(method="ffill")

    # 5) 좌표 유효성
    valid = (-90 <= df["lat"]) & (df["lat"] <= 90) & \
            (-180 <= df["lon"]) & (df["lon"] <= 180)
    df = df.loc[valid]

    # 6) 1 h 이상 공백 구간 제거
    gap = df.index.to_series().diff().dt.total_seconds()
    df = df.loc[(gap < 3600) | gap.isna()]

    return df.reset_index()
추가적으로 1번 문제와 마찬가지로 주어진 전자해도를 통해 NLL 이북, 육지(비정상 위치), 진입금지 구역 접근 등 특이점을 시각적으로 확인해보았습니다.
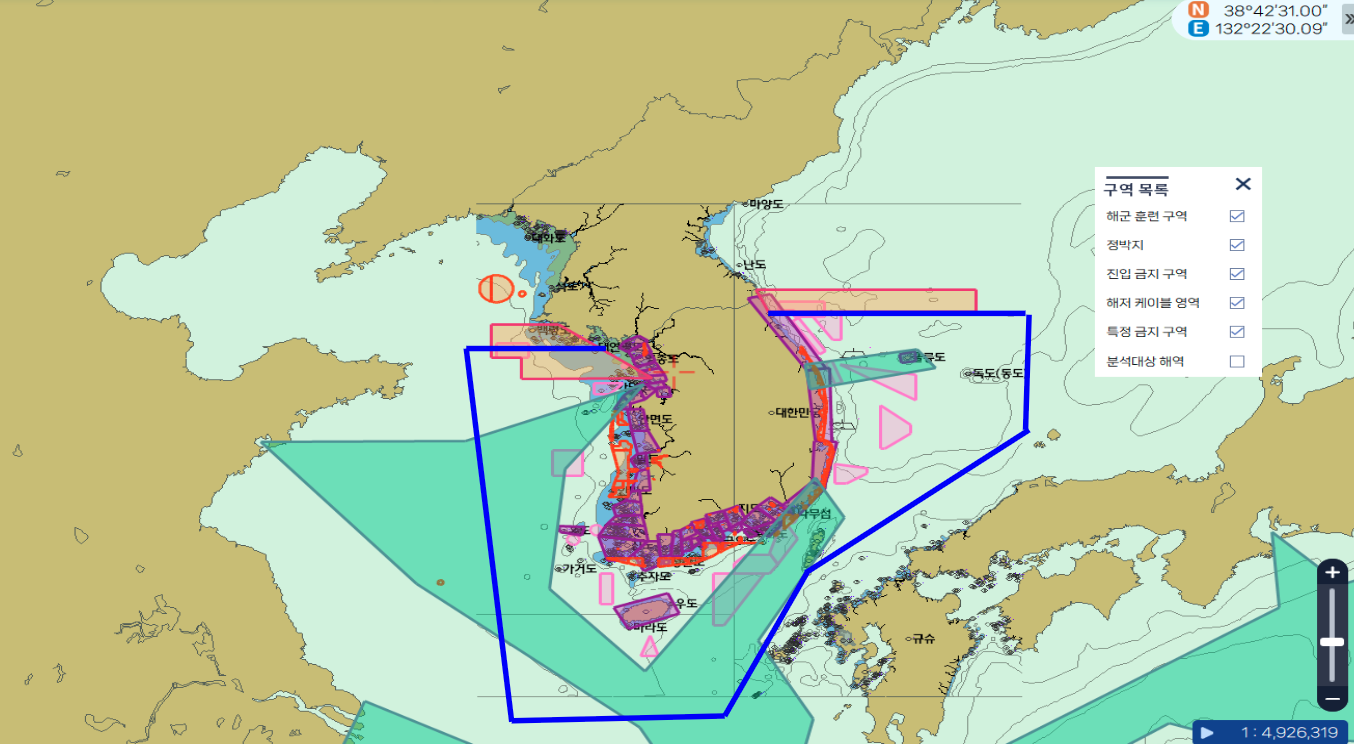
전자해도에서 확인한 시각화 구역을 바탕으로 5개 파생 변수를 그대로 코드화를 통해 아래와 같이 생성하였습니다. 이를 통해 "NLL(북방한계선)과의 상대 위치·이탈 패턴”을 정량화하여
한국 MMSI를 사용하지 않는 선박이 실제로 북한 해역을 왕래하는지 판별하고자 하였습니다.
| 파생 변수 | 기호 | 정의 / 계산식 | 의미 |
|---|---|---|---|
| NLL 이북 체류 비율 | nll_stay_ratio | 항적 중 얼마나 오래 북상해 있었는가 | |
| NLL 경계선 통과 횟수 | nll_cross_cnt | sign(lat − lat_NLL) 값의 부호 변화 카운트 | NLL을 왕복한 빈도 |
| 최대 북상 거리 | max_north_dist_km | max( Haversine(lat, lon, lat_NLL, lon) ) (단, lat > lat_NLL) | NLL에서 가장 멀리 북상한 거리 (km) |
| 활동범위(위도/경도) | lat_range, lon_range | lat.max − lat.min, lon.max − lon.min | 작전 해역 넓이 (δLat·δLon) |
| 정박 횟수(한국 제외) | anchor_cnt_foreign | 속력 < 0.5 kn 상태가 30 분 연속 발생할 때 +1, 단 한국 EEZ 밖에서만 카운트 | 북한·공해상 장기 정박 패턴 |
import numpy as np, pandas as pd
from geopy.distance import geodesic

LAT_NLL = 38.0        # 북방한계선 위도(°)
def nll_features(df):
    lat = df["lat"].values
    lon = df["lon"].values

    # 1) 체류 비율
    nll_mask = lat > LAT_NLL
    nll_stay_ratio = nll_mask.mean()

    # 2) 경계선 통과 횟수
    sign_change = np.diff(np.sign(lat - LAT_NLL) != 0).sum()
    nll_cross_cnt = max(sign_change, 0)

    # 3) 최대 북상 거리(km)
    if nll_mask.any():
        north_pts = np.column_stack([lat[nll_mask], lon[nll_mask]])
        nll_proj  = np.column_stack([np.full(north_pts.shape[0], LAT_NLL), lon[nll_mask]])
        dists = [geodesic(p, q).km for p, q in zip(north_pts, nll_proj)]
        max_north_dist_km = max(dists)
    else:
        max_north_dist_km = 0.0

    # 4) 활동 범위
    lat_range = lat.max() - lat.min()
    lon_range = lon.max() - lon.min()

    # 5) 정박 횟수(한국 EEZ 밖)
    speed = df["sog"].values
    anchor = speed < 0.5
    gap_sec = df["timestamp"].diff().dt.total_seconds().fillna(0)
    anchor_blk = (anchor & (gap_sec <= 180))           # 연속 구간
    anchor_cnt_foreign = (
        pd.Series(anchor_blk)
          .groupby((anchor_blk != anchor_blk.shift()).cumsum())
          .sum()
          .ge(60)   # 30 min = 60 × 30 s(Resample 기준)
          .sum()
    )

    return {
        "nll_stay_ratio":       nll_stay_ratio,
        "nll_cross_cnt":        nll_cross_cnt,
        "max_north_dist_km":    max_north_dist_km,
        "lat_range":            lat_range,
        "lon_range":            lon_range,
        "anchor_cnt_foreign":   anchor_cnt_foreign,
    }
결과적으로 데이터 전처리 및 분석을 통해 30초 간격 정규화·이상치 보정·1 시간 이상 공백 구간 제거로 LSTM 모델이 연속적 행동 패턴을 학습할 수 있는 고품질 시계열 데이터셋을 확보할 수 있었습니다.
모델 선정 및 학습
앞서 데이터셋 전처리 및 Feature Engineering 결과를 바탕으로 아래와 같은 전략으로 모델 선정 및 학습을 수행하고자 하였습니다.
1️⃣ LSTM 으로 시계열 항적을 임베딩
2️⃣ K-Fold(𝑘 = 5) 로 교차 검증
3️⃣ Fold별 앙상블(평균 + 메타러너) 로 일반화 성능 향상
4️⃣ 최종 TRUE(북한선박) / FALSE(정상선박) 이진 예측
최종 모델링 코드는 github에 업로드 하였습니다.
최종 평가결과
주어진 1,2번 문제의 Public / Private 데이터셋을 통한 최종 평가 결과는 아래 표와 같이 나타났으며 본선 진출 11팀 중 최종 7위를 기록하였습니다.
| Task | 검증 데이터 | 최종 F1 |
|---|---|---|
| 의심 선박 탐지(#1) | 6779 레코드 | 0.99 |
| 북한 선박 식별(#2) | 263 파일 | 0.83 |
결론 및 참가소감
- AIS 데이터 정보를 활용한 의심 및 북한 선박 탐지 가능성을 확인하였지만,
- 현행작전 활용을 위한 성능 고도화 필요시, 실제 데이터를 통해 다양한 데이터 기반의 추가 검증은 요구될 것으로 판단됩니다.
- 향후 IVIMS, C4I, R/D 센서 등 다른 정보와 결합하여 모델을 학습 및 개발한다면 실질적인 해군의 현행작전에 많은 도움이 될것으로 전망합니다.
무엇보다도 우수한 참가자들과 경쟁할 수 있어서 영광이었고 배울 것이 너무나 많다는 것을 이번 대회 참가를 통해 느낄 수 있었습니다!!