딥러닝 기초에서 RNN은 보통 가볍게 언급되고 넘어가는 경우가 잦다. "순차적이라 병렬화가 안 되고, Transformer에 밀렸다." 그런데 올해 ICLR에서 발표된 애플 논문이, RNN을 병렬로 학습시켜 70억 파라미터까지 키웠다고 한다. 요즘 AI 논문은 제목만 화려한 경우가 많아서 반신반의하며 읽었는데, 의외로 아이디어는 명확했고 논문의 주장도 절제되어 있었다. ParaRNN의 개념과, 지표의 해석까지 가볍게 소개한다.
TL;DR
RNN은 이전 은닉 상태가 있어야 다음 상태를 계산할 수 있어서 학습을 병렬화하지 못했다. Mamba 같은 State Space Model은 점화식을 선형으로 제한해 이 문제를 피했다. ParaRNN은 비선형을 그대로 두고, 모든 시점의 은닉 상태를 연립방정식의 해로 본 다음 뉴턴법으로 푼다. 뉴턴법 한 스텝은 선형 문제라 병렬로 풀리고, 세 번이면 수렴한다. 다만 결과는 "RNN이 Transformer를 이겼다"가 아니라 "병렬화 장벽은 넘을 수 있다"에 가깝다.
RNN 기본 개념
RNN이 하는 일은 식 하나다.
번째 은닉 상태를 구하려면 번째가 먼저 있어야 한다. 토큰이 1000개면 1000번을 차례로 계산해야 하고, GPU에 코어가 수천 개 있어도 한 줄로 서서 기다릴 수밖에 없다. 모든 토큰을 한꺼번에 처리하는 Transformer와는 학습 속도에서 상대가 안 됐다.
그래도 RNN에는 미련이 남을 만한 장점이 있다. 문맥이 아무리 길어져도 토큰 하나를 만드는 비용이 일정하다는 것이다.
Mamba
이 약점을 먼저 피해 간 게 Mamba와 같은 State Space Model(SSM, 상태 공간 모델)이다. 점화식을 은닉 상태에 대해 선형으로 제한했다.
선형이면 두 단계를 미리 합칠 수 있다. , 라면 값을 몰라도 로 묶어둘 수 있다. 이웃한 단계끼리 동시에 합치기를 반복하면 단계가 번 만에 끝난다. parallel scan이라는 오래된 알고리즘이다.
대신 표현력을 타협한 셈이다. 논문 표현 상, 선형은 좋아서 고른 게 아니라 어쩔 수 없어서 고른 제약이다.
ParaRNN
ParaRNN은 관점을 바꾼다. 을 차례로 계산할 값이 아니라, 방정식 개를 동시에 만족해야 하는 미지수로 본다. 비선형 연립방정식이니 뉴턴 방법으로 푼다. 답을 대충 찍고, 그 근처에서 를 직선으로 근사한 뒤, 근사한 문제를 풀어 답을 고치는 식이다. 고칠 양 에 대한 식은 이렇게 생겼다.
바로 위의 선형 RNN과 똑같은 모양이다. 의 기울기인 야코비안 행렬 이 자리에, 지금 답이 얼마나 틀렸는지를 나타내는 잔차 이 입력 자리에 들어갔을 뿐이다. 그러니 Mamba가 쓰는 parallel scan을 그대로 가져다 쓸 수 있다.
정리하면 비선형 RNN 한 번 = 선형 RNN 몇 번이다. 반복이 길어지면 병렬화한 의미가 없는데, 논문에서는 세 번이면 충분했다고 한다.
야코비안을 대각으로
은닉 차원이 면 야코비안은 행렬이라, 큰 모델에서는 저장하고 곱하는 비용을 감당할 수 없다. 그래서 논문은 GRU와 LSTM에서 은닉 상태에 곱해지는 가중치 행렬을 대각행렬로 제한했다. 그러면 야코비안도 대각 구조가 되어 비용이 에 비례하게 된다. (과정을 수식화 할 수도 있겠다만, 분량이 길어지므로 생략한다)
트레이드오프는 셀 안에서 은닉 차원끼리 섞이지 않는다는 것이다. 차원 RNN 하나가 사실상 1차원 RNN 개로 쪼개진 셈이고, 섞는 일은 뒤따르는 MLP 층이 맡는다. "RNN의 부활"이라고 보기엔 기존 GRU·LSTM과 꽤 다른 구조이다.
결과 지표
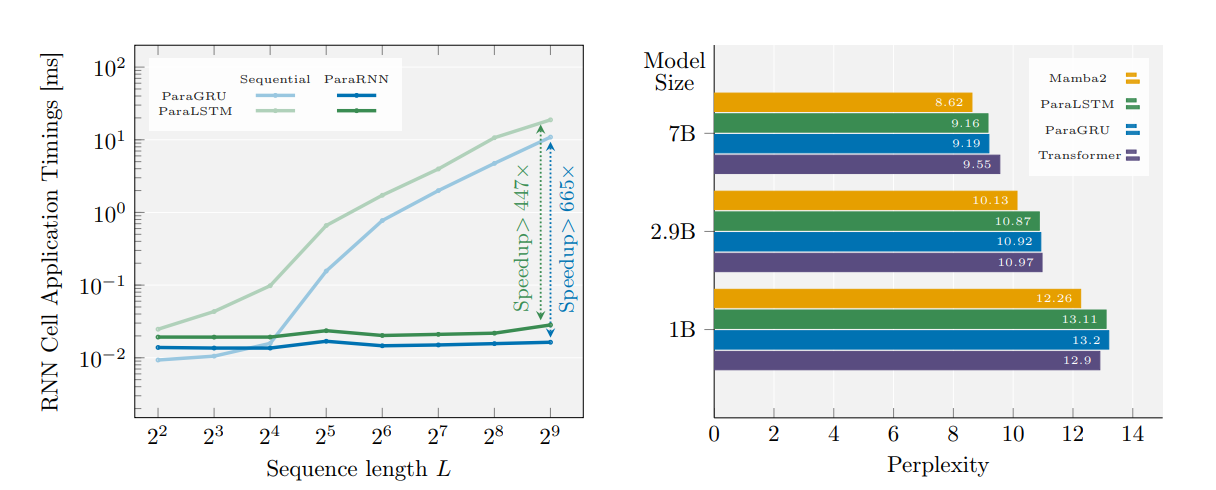
출처: https://arxiv.org/abs/2510.21450
논문이 내세우는 성과는 두 가지다. 665배 빨라졌다, 그리고 70억 파라미터 RNN이 Transformer와 경쟁한다. 둘 다 사실이지만 오해하기 쉬우니, 명확하게 짚고 넘어가자.
665배는 같은 RNN을 차례로 돌렸을 때와 비교한 값이다. Transformer보다 빠르다는 얘기가 아니고, 학습 스텝 하나에 걸리는 시간은 여전히 Transformer가 더 짧다.
성능도 마찬가지다. perplexity는 7B에서 RNN(9.16~9.19)이 Transformer(9.55)를 근소하게 앞서지만, 1B 이하에서는 뒤진다. 그리고 전 구간 1등은 선형인 Mamba2가 차지했다(7B에서 8.62). 비선형의 이점이 뚜렷했던 건 1의 개수가 홀수인지 짝수인지 맞히는 식의 합성 과제뿐이었다.
저자들의 목표도 더 좋은 RNN을 제안하는 게 아니라, 고전적인 비선형 RNN도 대규모로 학습시킬 수 있음을 보이는 것.
마무리
"RNN은 병렬화가 안 된다"는 말은 법칙처럼 들리지만, 정확히는 "차례로 푸는 방법밖에 몰랐다"에 가까웠다. 같은 계산을 연립방정식으로 다시 보니 직관적인 뉴턴법으로 풀리는 문제였다. 이 논문 하나로 Transformer의 입지가 위협받진 않겠지만, 의미는 충분하다. 기존 방법론을 새로운 시각으로 보려는 시도가 새 패러다임을 만드는 법이니까 말이다.
다음 문제는 이전 문제의 답을 알아야 풀 수 있는 문제인줄 알았는데,만약 전체 문제가 연결된 연립방정식이라면....?으로 해결한 느낌이네요. 잘봤습니다!