- 탐색적 데이터 분석(EDA)
- 정규분포
3.중심경향성 분석 (Central Tendency)- 분산성 분석 (Variability)
- 교차분석 (Crosstab)
- 그룹별 분석 ⭐⭐⭐⭐⭐
- 사분위간범위 (IQR)
- 빈도분석
1. 탐색적 데이터 분석(EDA)
- 데이터의 특성과 패턴을 이해하기 위해 다양한 통계적 기법과 시각화를 통해 데이터를 탐색하는 과정
- 데이터가 말하는 '패턴(Pattern)'을 발견하고 그것이 '진실(Fact)'인지 검증하는 단계
EDA가 데이터 분석에서 중요한 이유
- 숨겨진 패턴 발견: 데이터 속에 감춰진 의미 있는 관계와 트렌드 파악
- 문제 조기 발견: 결측치(NaN값), 이상치(100점 만점인데 1000점이 입력됐을 때), 데이터 품질 문제 사전 탐지
- 가설 생성 및 검증: 데이터 기반의 과학적 가설 수립
- 분석 방향 설정: 후속 분석과 모델링의 전략적 로드맵 구축
의료 분야에서는 환자 집단의 특성 파악, 질병 패턴 분석, 치료 효과 검증 등에 활용
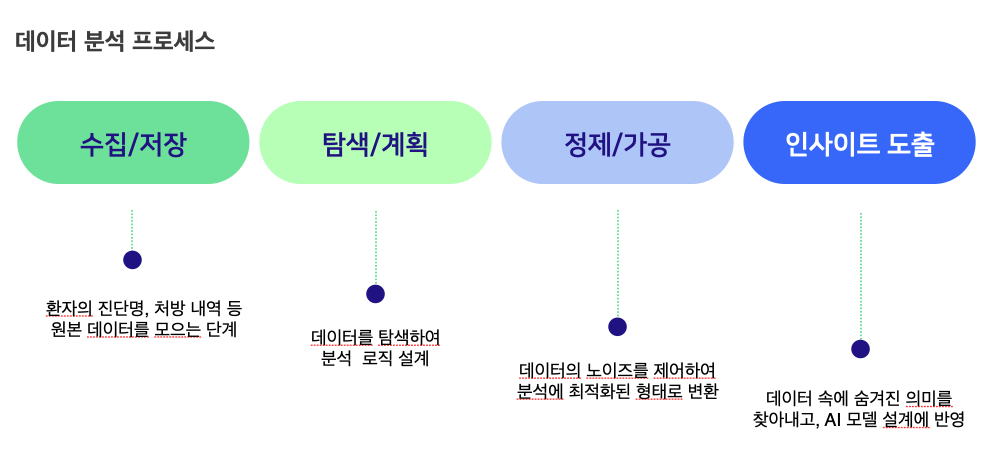
EDA 분석 로드맵
- 1단계 : 데이터 전체 파악 -> 데이터 전반적 특성 이해 (기술통계)
- 2단계 : 타겟별 차이 탐색 -> 당뇨병 환자와 정상인이 다를까? (그룹분석)
- 3단계 : 차이의 진위 검증 -> 관찰된 차이가 진짜일까? (통계검정)
- 4단계 : 변수간 관계 파악 -> 어떤 변수들이 함께 움직일까? (상관관계)
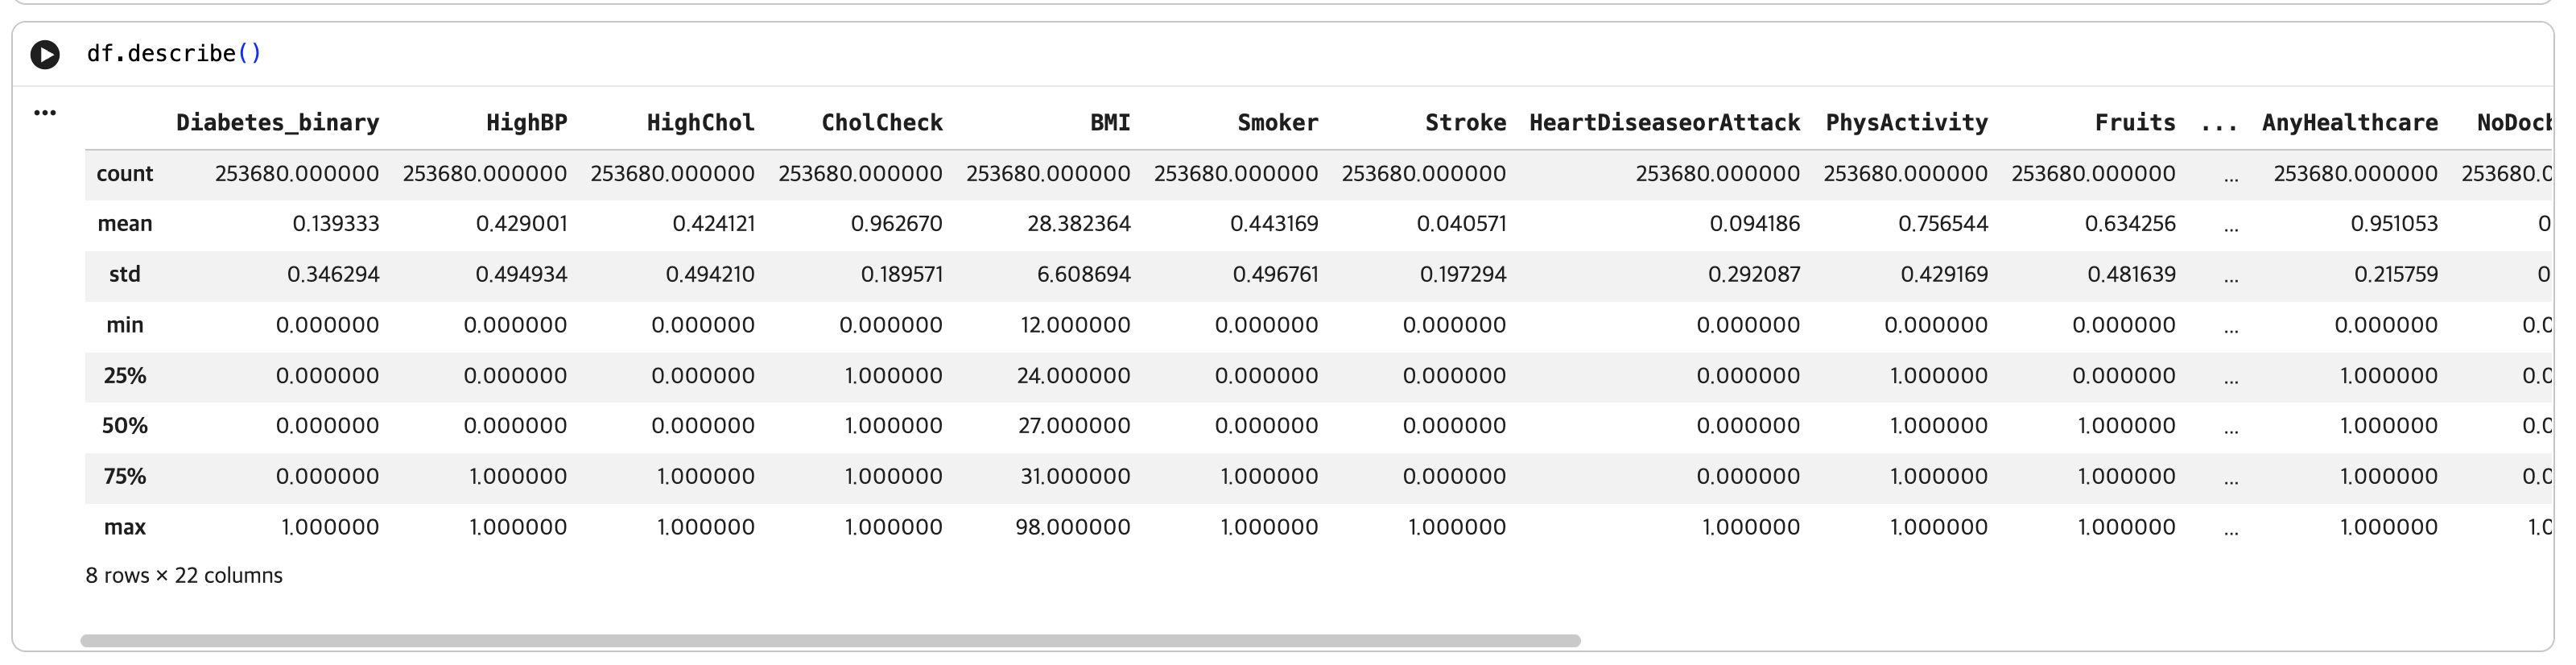
2. 정규분포
정규분포는 데이터 분석에서 가장 자주 만나는 분포 형태입니다.
많은 통계 기법과 머신러닝 알고리즘이 데이터가 정규분포를 따른다고 가정함
의료 데이터에서 BMI, 혈압 같은 생체 지표들이 종종 정규분포와 비슷한 형태를 보임

📚 핵심 개념 이해
- 정규분포: 평균을 중심으로 좌우 대칭인 종 모양 분포
- 평균 = 중앙값: 정규분포에서는 평균과 중앙값이 거의 같음
- 표준화: (값-평균)/표준편차로 변환하여 비교 가능
💡 활용 예시
- Age: 연령대별로 고르게 분포되어 있을 수 있음
- MentHlth: 0일이 많고 30일이 적은 오른쪽으로 꼬리가 긴(Right-Skewed) 분포일 가능성
3.중심경향성 분석 (Central Tendency)
- 중심경향성은 데이터가 어느 값 주변에 모여있는지 나타내는 대표값들
- 결측치 대체(imputation)에서 평균이나 중앙값으로 빈 데이터를 채울 때 사용
- 의료 데이터에서는 환자의 누락된 혈압, BMI 등을 채워 모든 환자 데이터를 모델 학습에 활용할 수 있게 함
대표값(3m)
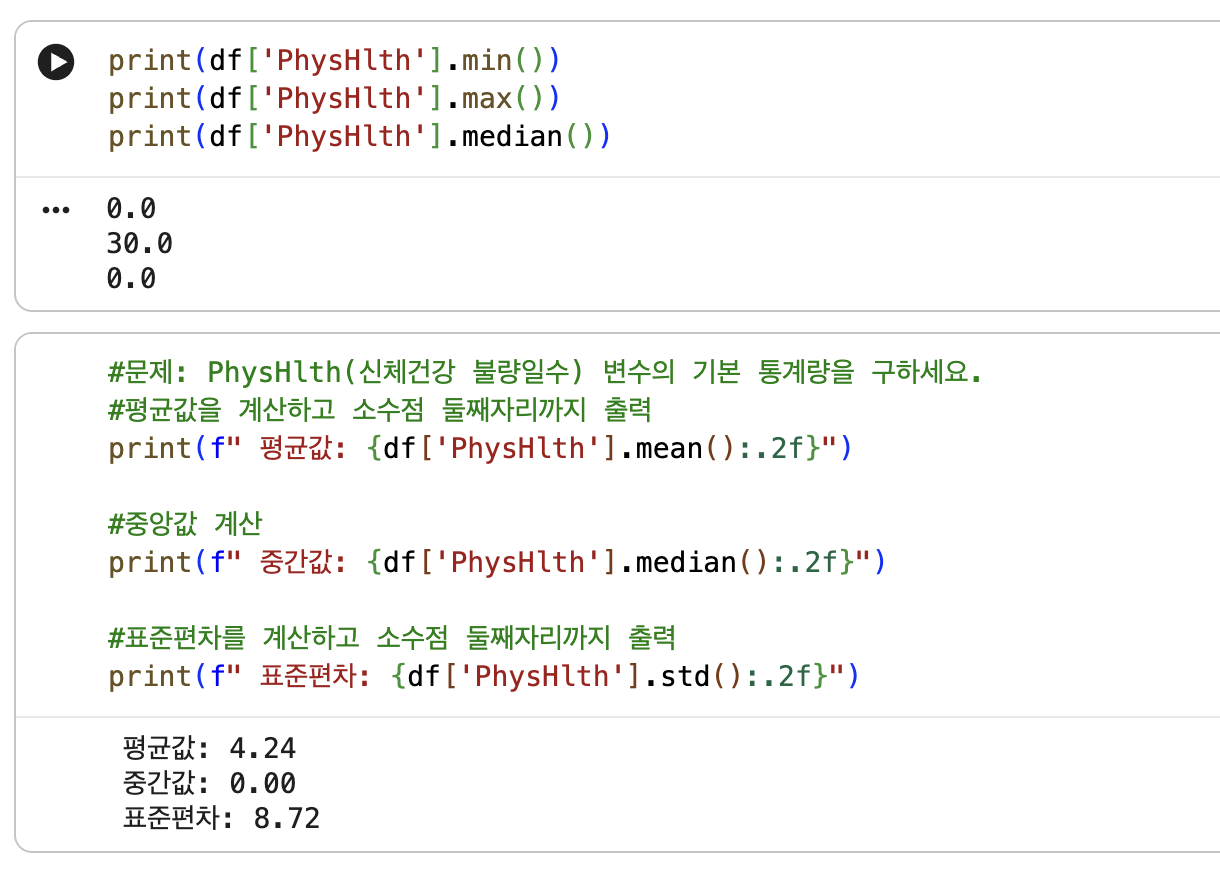
- 평균 (Mean): 모든 값을 더해 N으로 나눈 것으로 데이터의 무게 중심 (이상치에 취약함: 극단적인 값이 소수만 포함되어도 전체 대표값이 왜곡될 위험+) -> 데이터가 한쪽으로 치우치지 않고 고르게 분포(정규분포)할 때 가장 좋은 대표값

- 중앙값 (Median): 데이터를 줄 세웠을 때 정중앙에 위치한 값. (이상치에 강하기 때문에 평균의 왜곡을 보완하는 강건한(Robust) 대표값) (예)소득, 의료비, 재원 기간

- 최빈값 (Mode): 빈도수(Frequency)가 가장 높은 값을 의미. 범주형 데이터에서 주로 사용
의료데이터 활용
- MentHlth(정신건강 불량일수): 대부분 0일인데 일부가 30일이면 → 중앙값 사용
- Age(연령대): 1-13 범위의 고른 분포 → 평균 사용 가능
- GenHlth(건강상태): 1-5 점수, 3점이 가장 많다면 → 최빈값(3점) 의미있음
4. 분산성 분석 (Variability)
- 분산성은 데이터가 중심값 주변에서 얼마나 퍼져있는지를 나타냄
📚 핵심 개념 이해
- 분산 (Variance): 표준편차를 제곱한 값. 계산용이라 실제 해석은 표준편차 사용 -> 값이 커지면 퍼짐이 큼
- 범위 (Range): 최댓값 - 최솟값으로 데이터가 퍼져있는 전체 폭. 데이터 스케일 파악과 정규화에 활용하지만 극값 하나로 크게 왜곡됨
표준편차 (Standard Deviation)
- 데이터가 평균에서 얼마나 떨어져 있는지 보여주는 핵심 지표
- 분산 값에 루트를 씌운 값
- “평균에서 대략 이 정도 떨어져 있다”라고 이해 가능
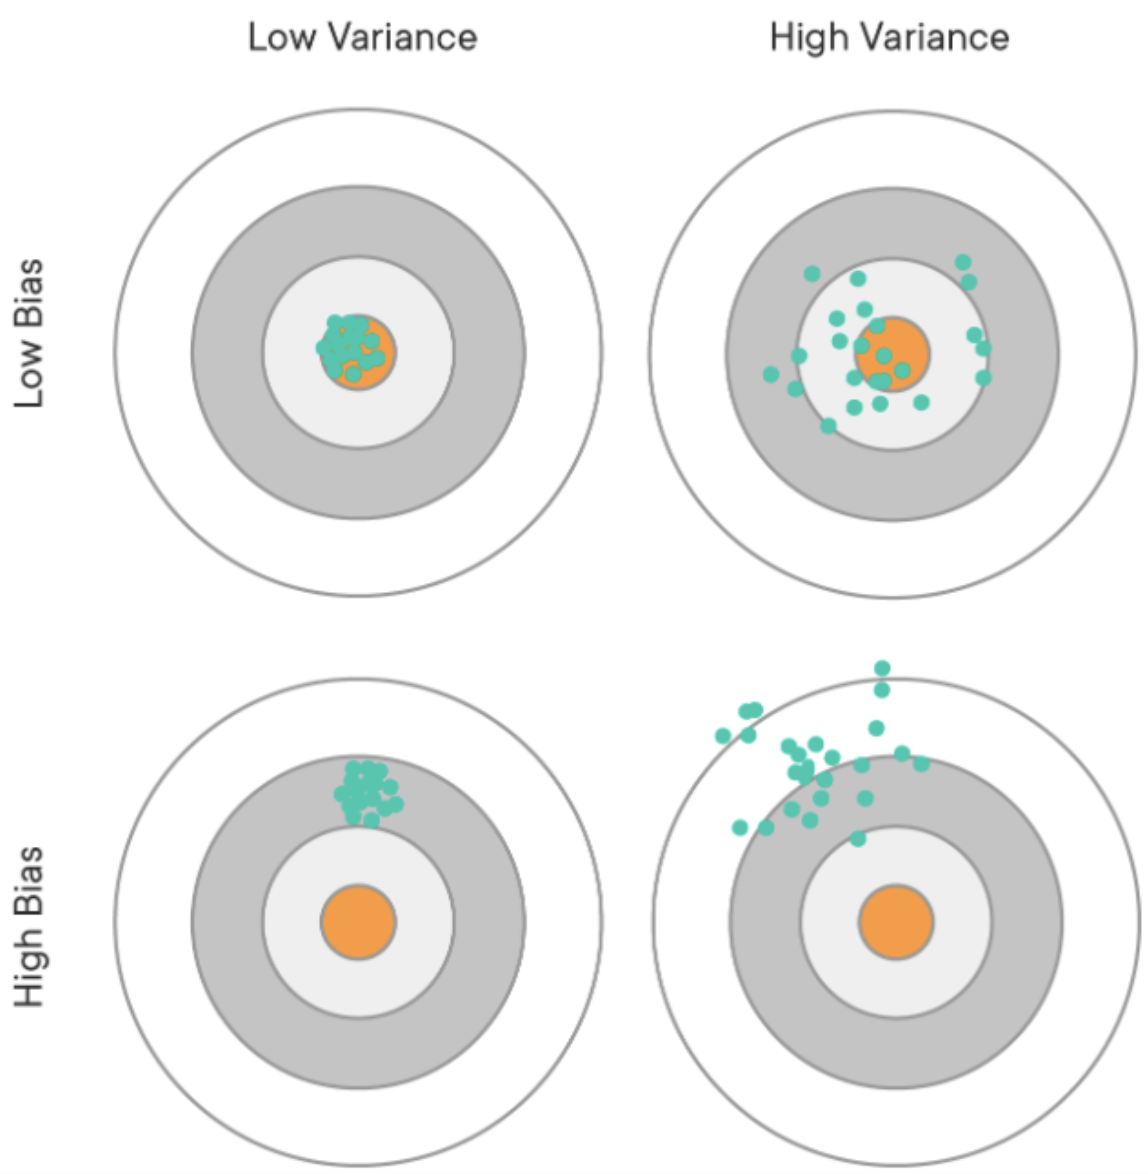 * 표준편차가 큰 환자는 **"예측이 어렵고 위험한 케이스"**로 분류됨
* 활용 예시: BMI 표준편차가 클수록 다양한 체형의 환자 포함
❗개념차이
- 분산: 👉 “얼마나 퍼졌는지 계산용 숫자”
- 표준편차: 👉 “평균에서 보통 이 정도 벗어난다” (실제 감각)
✔️ 한 줄 정리
- 👉 분산은 계산용, 표준편차는 해석용
5. 교차분석 (Crosstab)
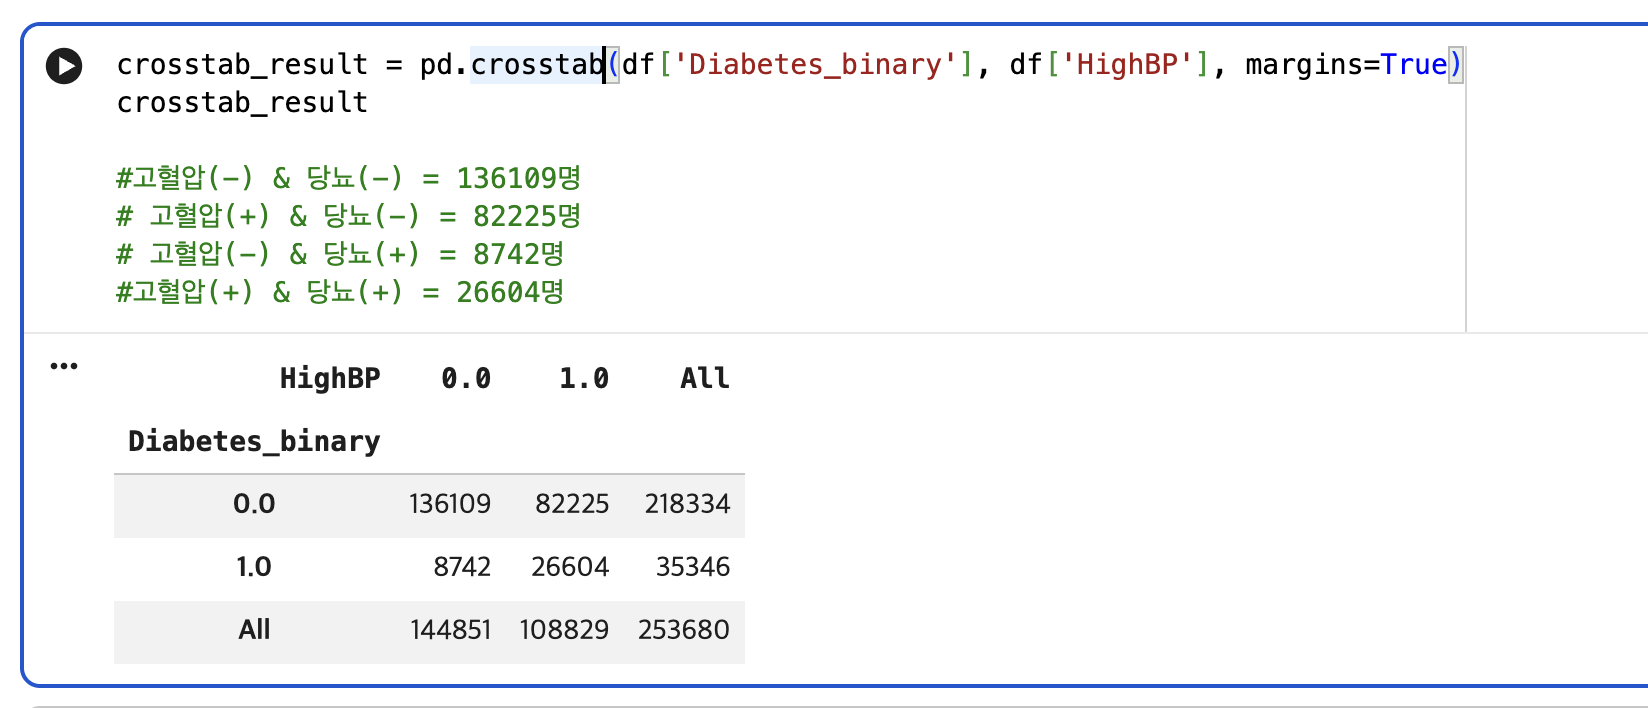
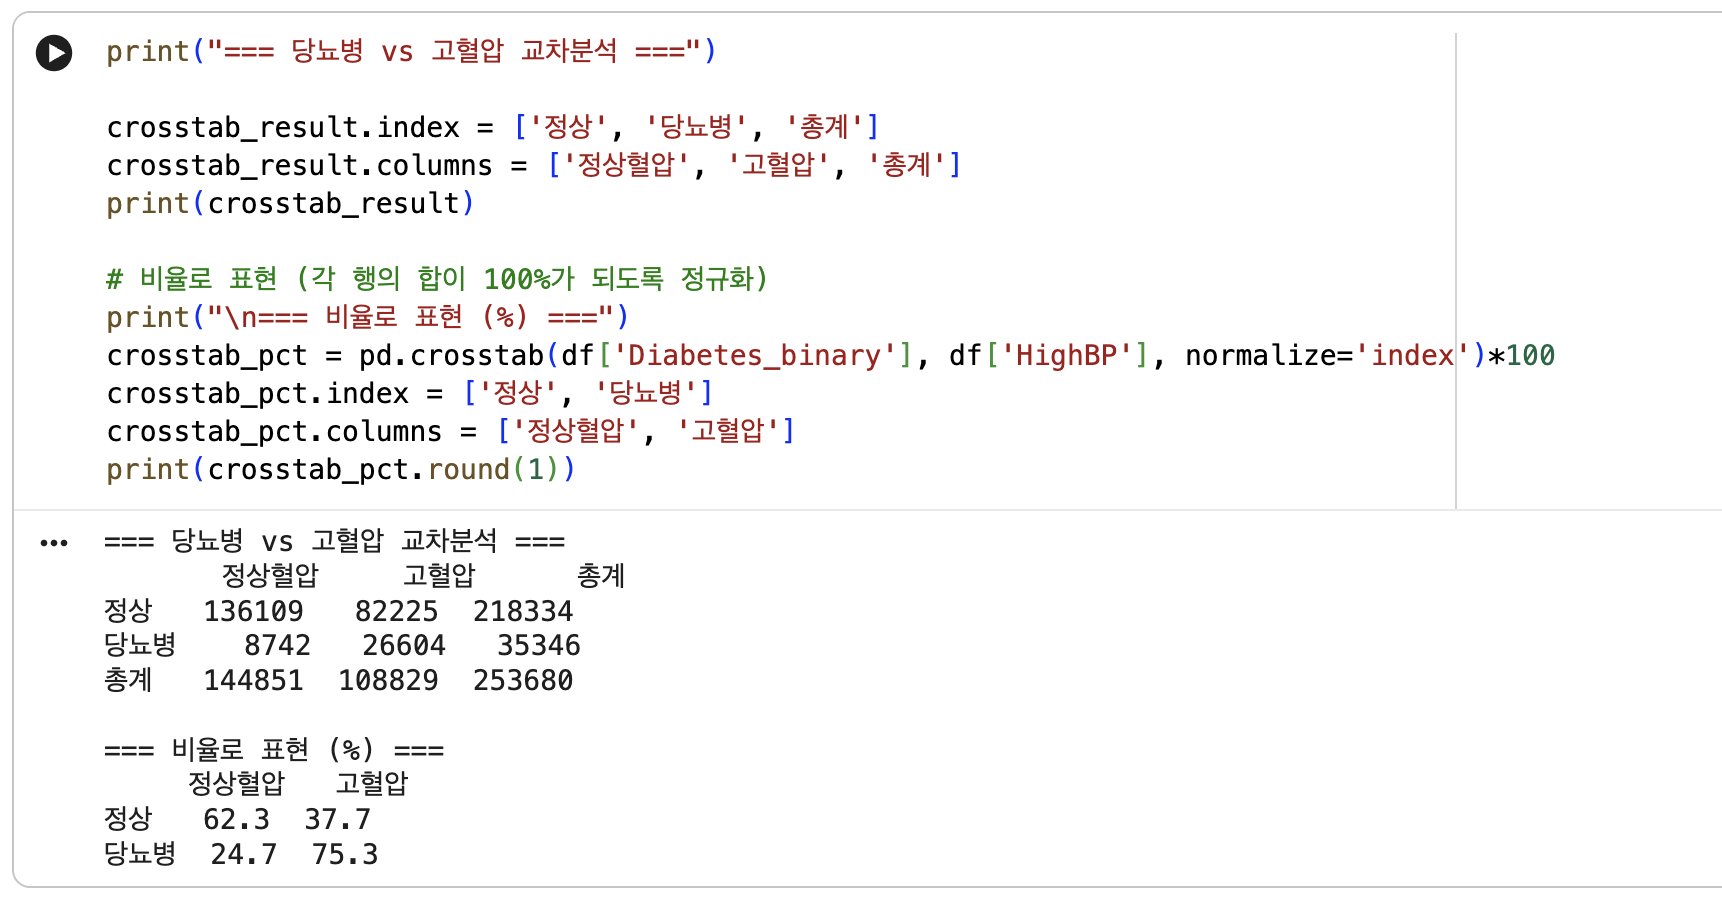
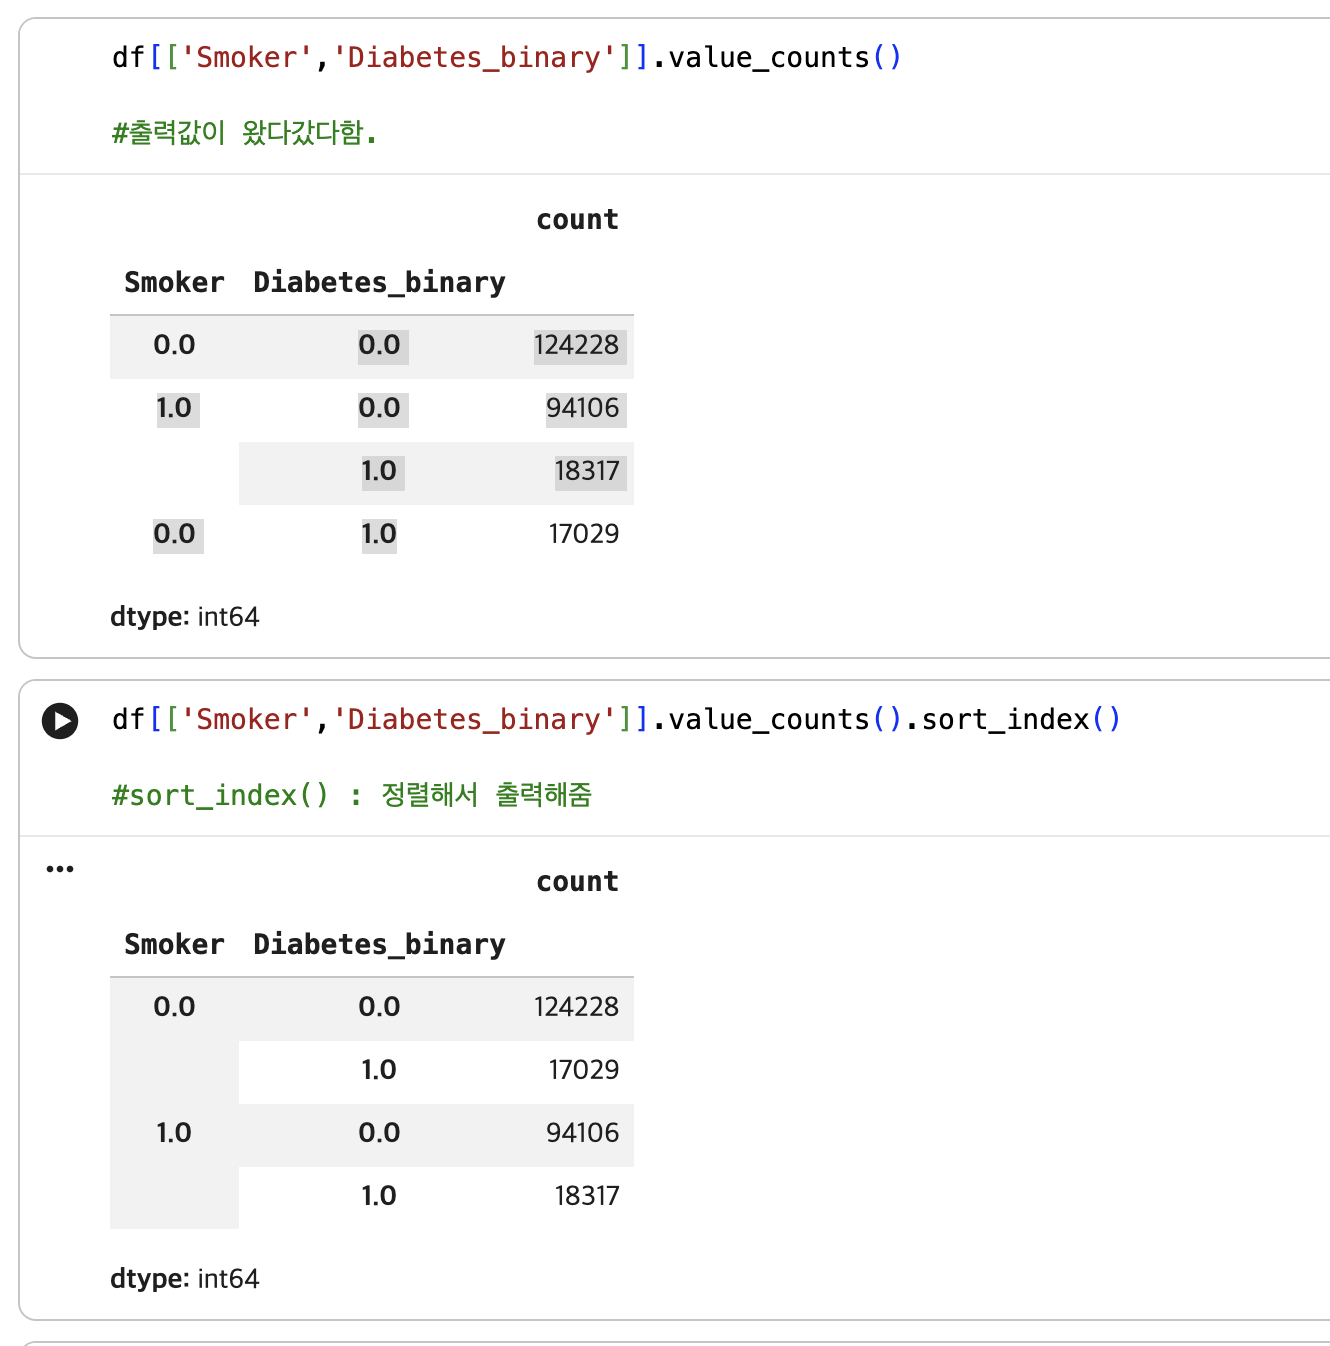
- 교차분석은 두 범주형 변수 간의 관계를 표 형태로 분석하는 기법
- 변수의 빈도(frequency)를 교차로 묶어 표(교차표, 분할표)로 만들고, 이를 통해 특정 범주 조합의 빈도가 우연히 발생한 것인지 통계적으로 유의미한지 확인
- pd.crosstab(): 두 범주형 변수 간의 빈도표 생성 (2x2 테이블)
- margins=True: 행/열 합계(총계) 자동 추가
- normalize='index': 행 기준으로 비율 계산 즉, 각 행의 합을 1로 만들어서 “그 그룹 안에서 비율”을 보는 것
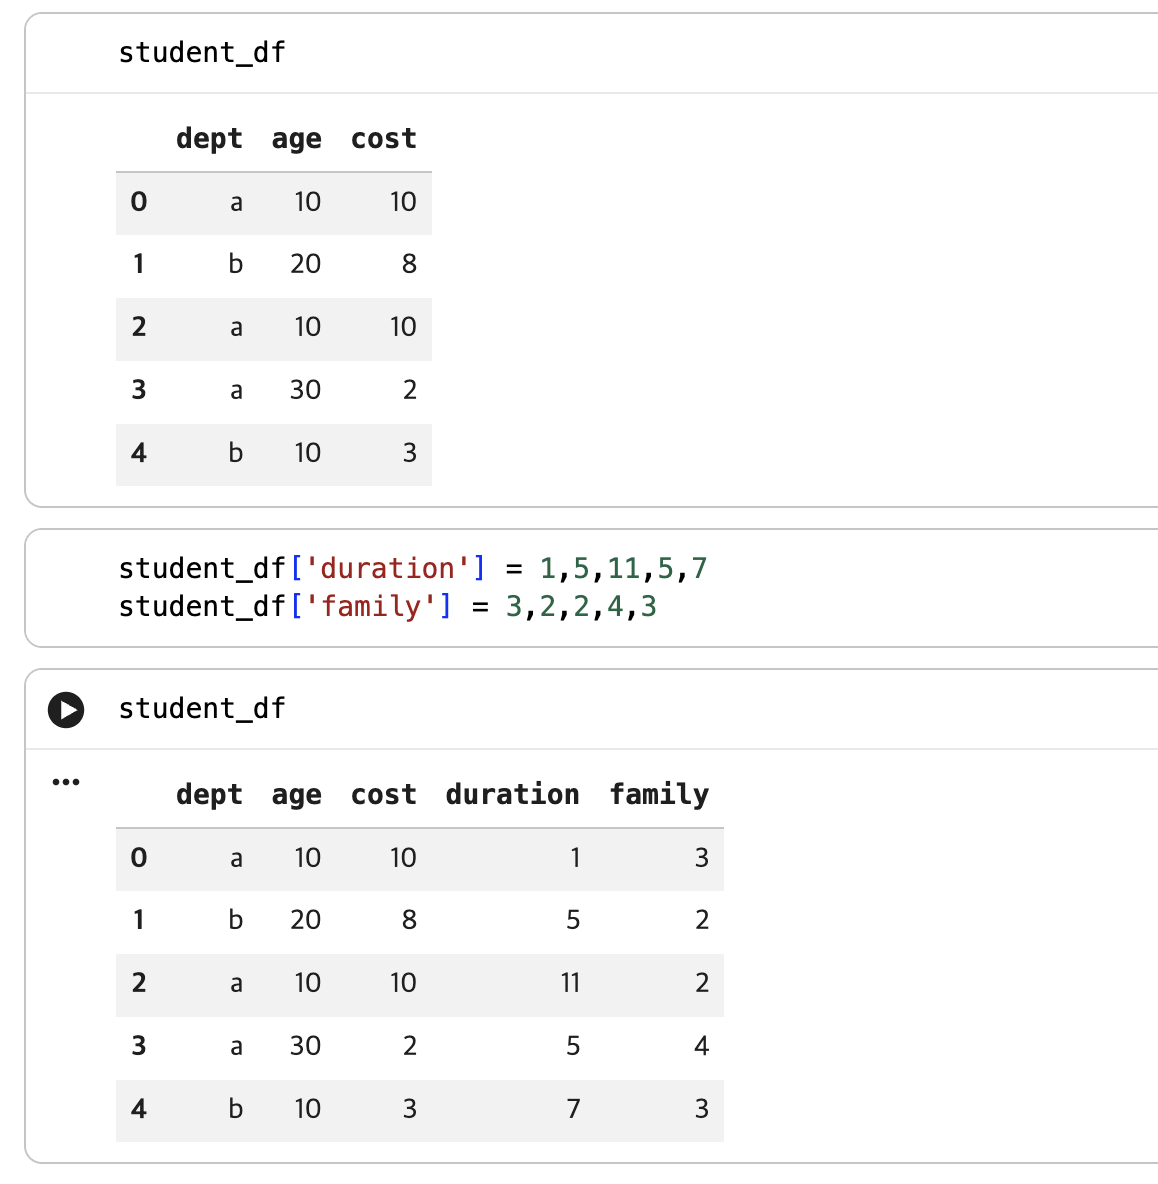
6. 그룹별 분석 ⭐⭐⭐⭐⭐
- 타겟 변수의 각 범주에서 다른 변수들이 어떻게 분포되는지 비교하는 핵심 EDA 기법
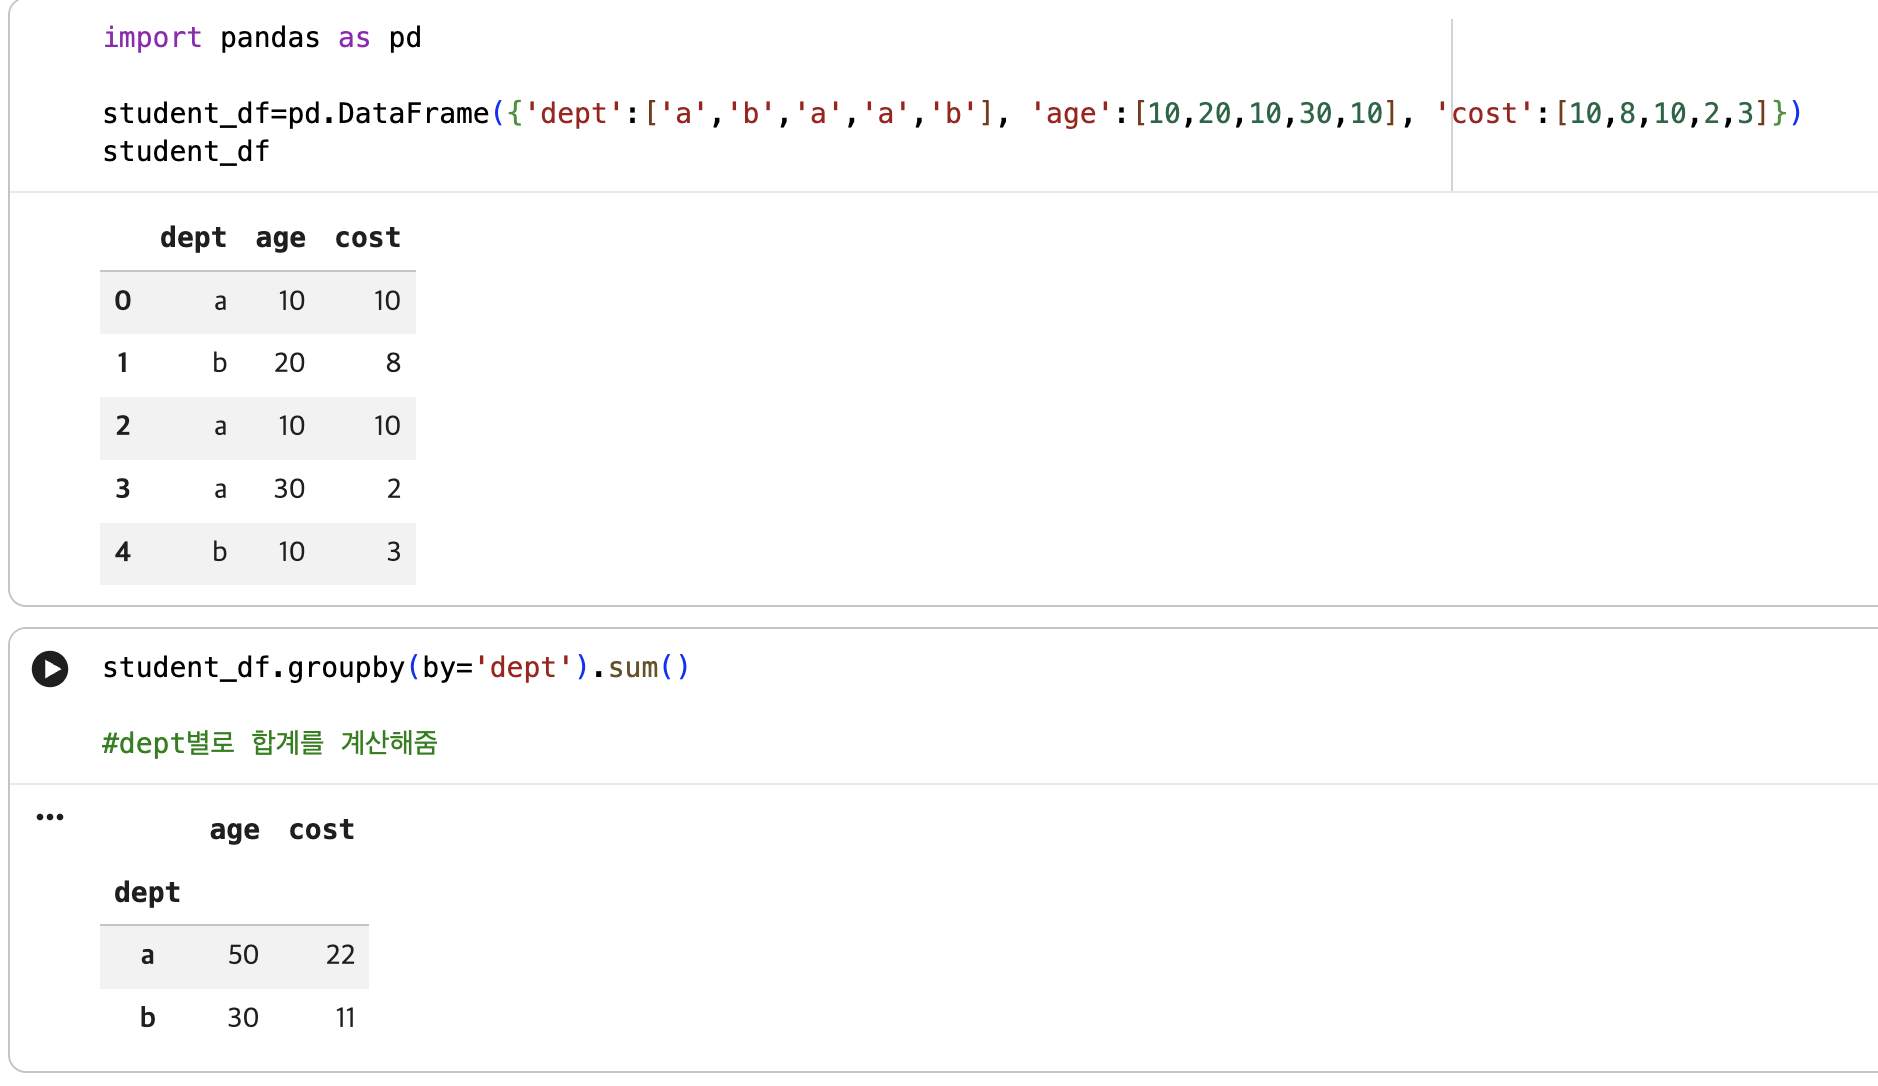
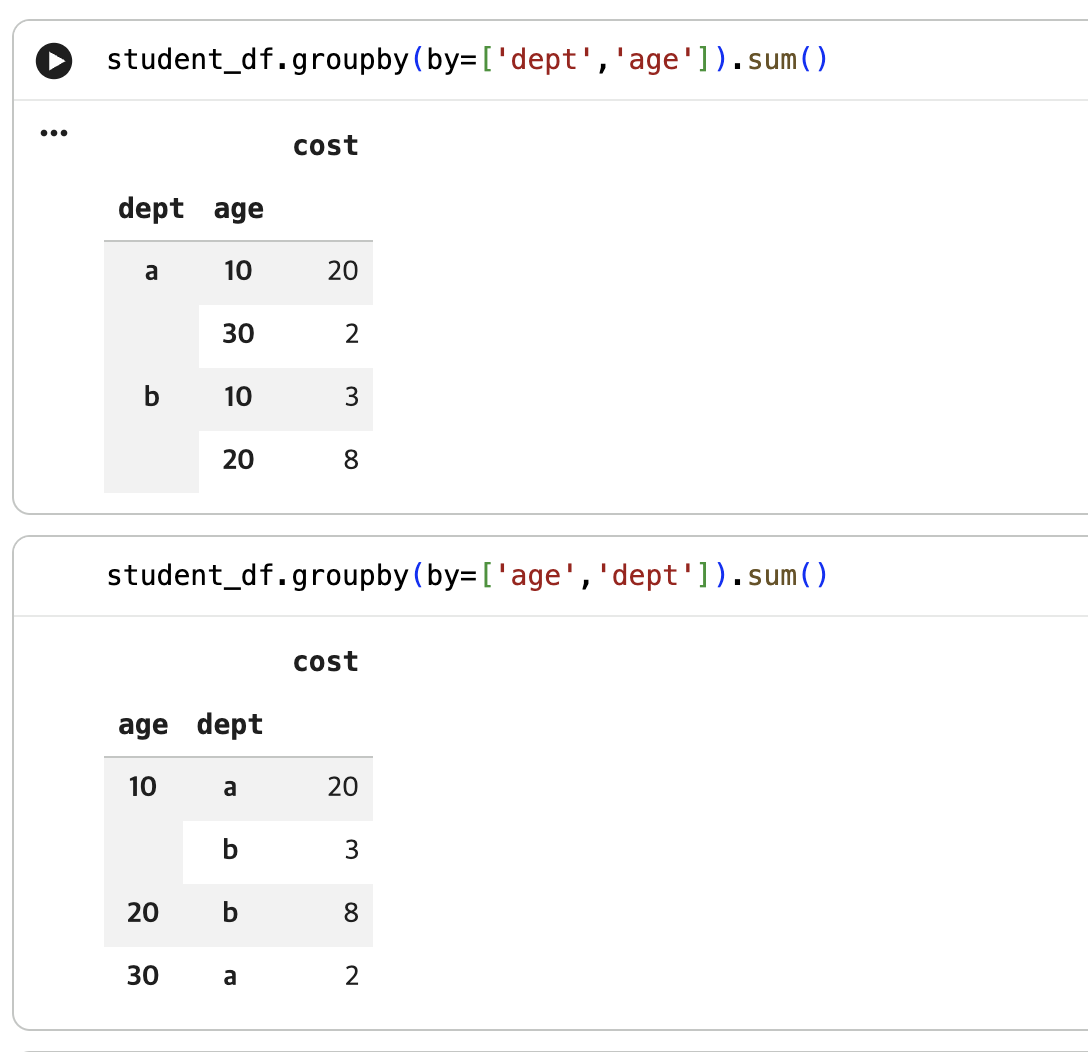
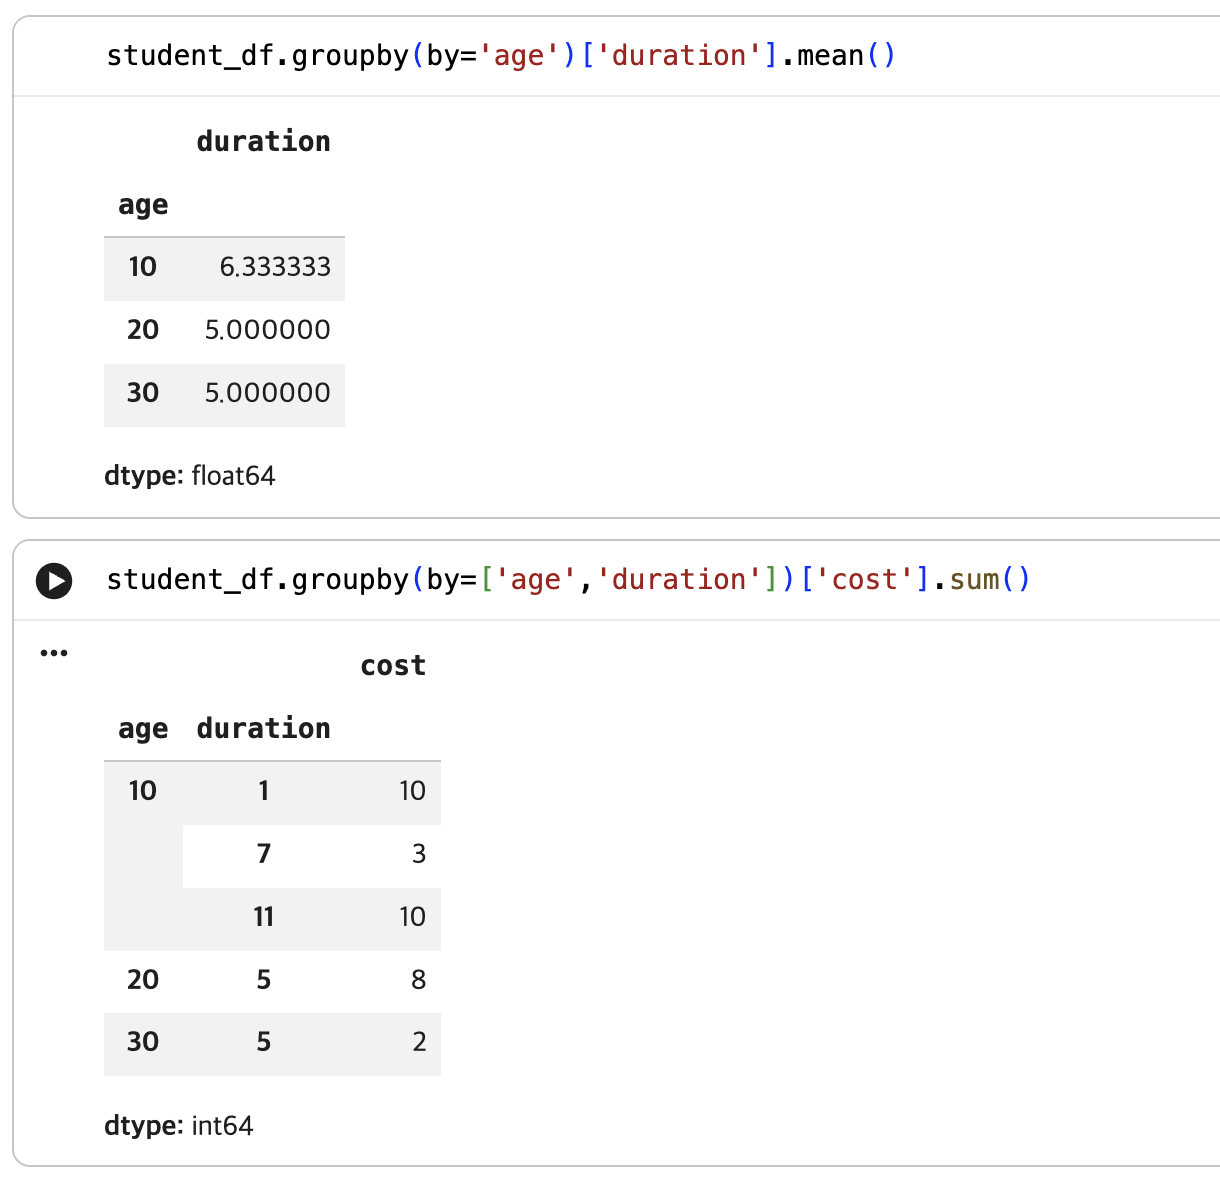
- .DataFrame.groupby(by=기준컬럼) 함수 -> by=는 생략 가능 (많이 헷갈림)
- 그룹 나누기
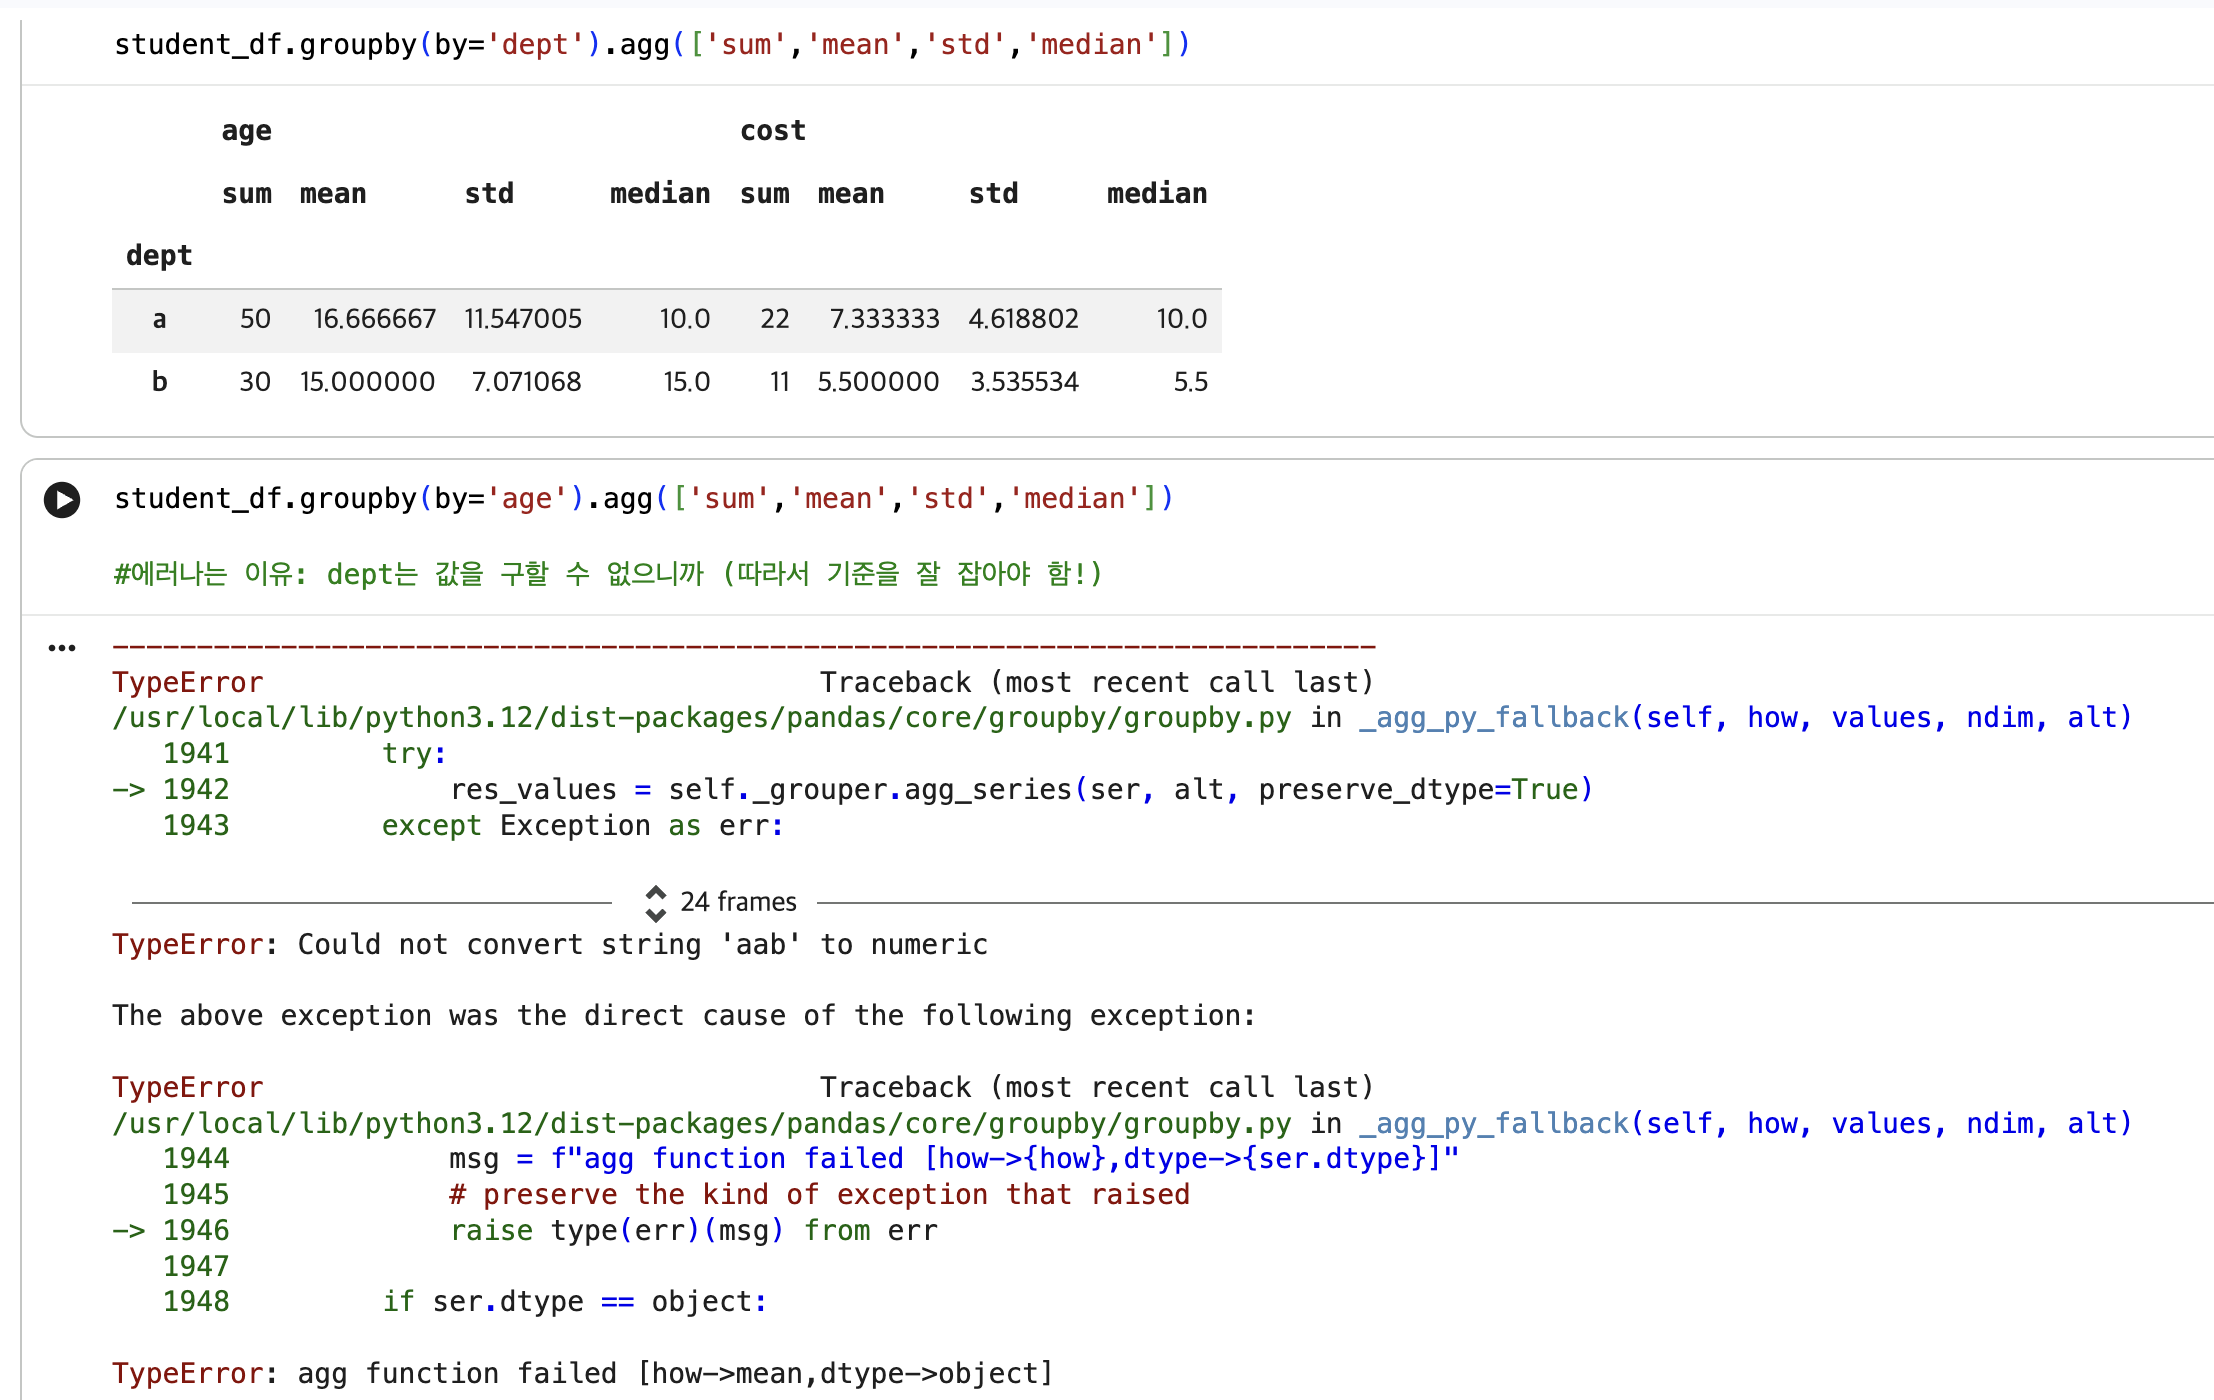
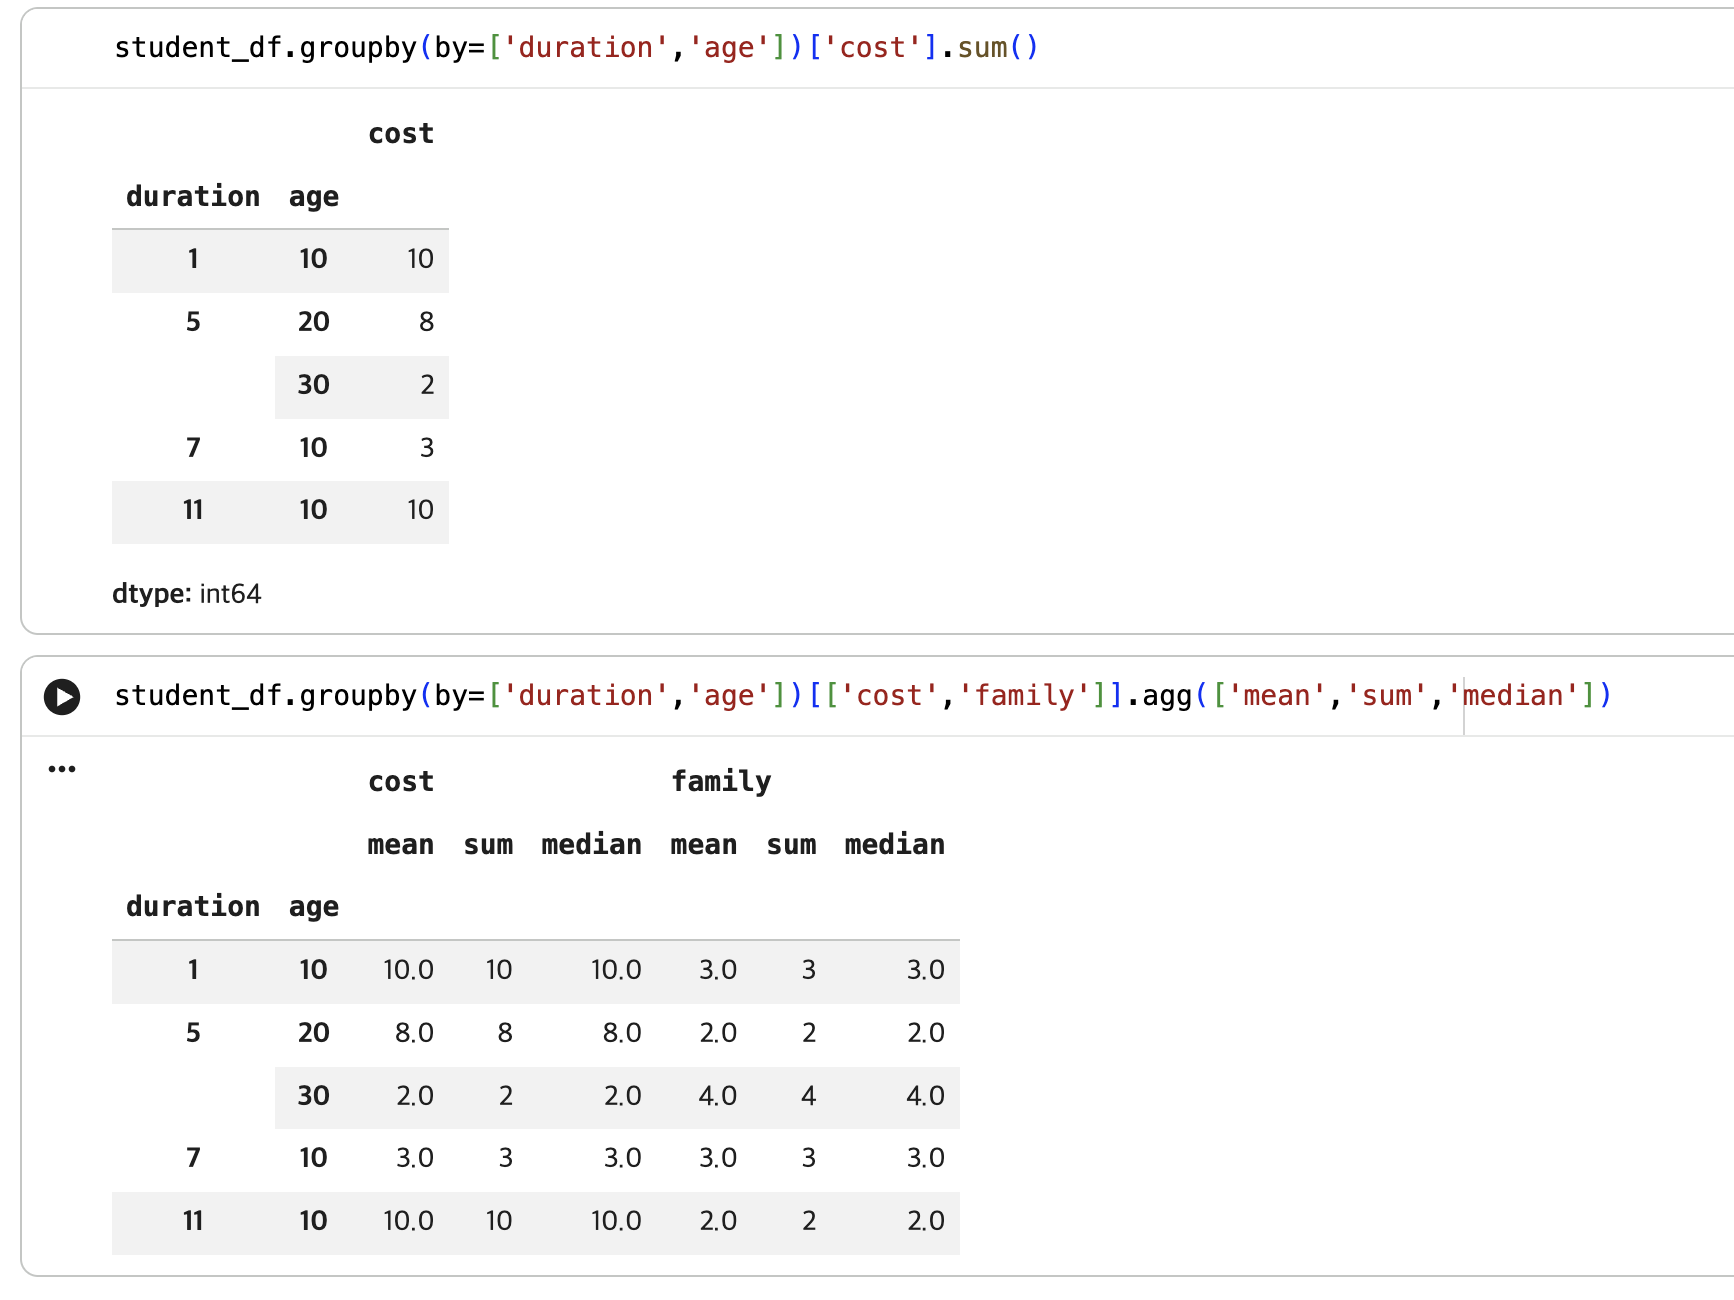
- 집계 함수 적용
❌ groupby()만 쓰고 끝냄 → 아무 일도 안 일어남
✔️ 반드시 .sum(), .mean() 같은 집계 함수 붙여야 함
- agg([]): aggregation (집계)의 줄임말로 묶은 그룹마다 여러 통계 계산 한 번에 하라는 명령어

-
분리(Split) 단계: groupby()에서 정의한 컬럼 조건에 따라 독립된 그룹으로 나눔
-
적용(Apply) 단계: 나뉘어진 독립된 그룹별 함수를 적용 -> 합계(sum) 혹은 평균(mean)함수를 적용하여 각 그룹별 연산을 적용
-
결합(Combine) 단계: 최종 단계이며, 각각의 함수가 적용된 결과를 종합하여 다시 하나의 테이블로 합침
7. 사분위간범위 (IQR)
- 상위 25%와 하위 25%를 제외한 중간 50% 구간의 폭으로, 극값에 영향받지 않는 안정적인 지표 (즉,중간 50%의 값)
- q1 = 25%, q2 = 50%, q3 = 75%, q4=100% ==> IQR=Q3-Q1
- IQR의 범위가 좁을수록 정보가 몰려있다는 의미
이상치
- 데이터 분포에서 너무 튀는 값 걸러내는 기준으로 생각하기
- Lower bound = Q1(하위 25%) -1.5xIQR
- Upper bound= Q3(상위 25%)+1.5xIQR
- 이 범위를 벗어나면 = 이상치
왜 1.5를 곱하냐?
- 완벽한 수학적 필연성은 없고 경험적으로 만든 “적당히 잘 걸러지는 기준”
- 너무 작은 값 → 정상 데이터까지 이상치 처리됨
- 너무 큰 값 → 진짜 이상치를 못 잡음
- 그래서 통계적으로 많이 쓰다 보니 “1.5가 현실적으로 적당하다”고 굳어짐
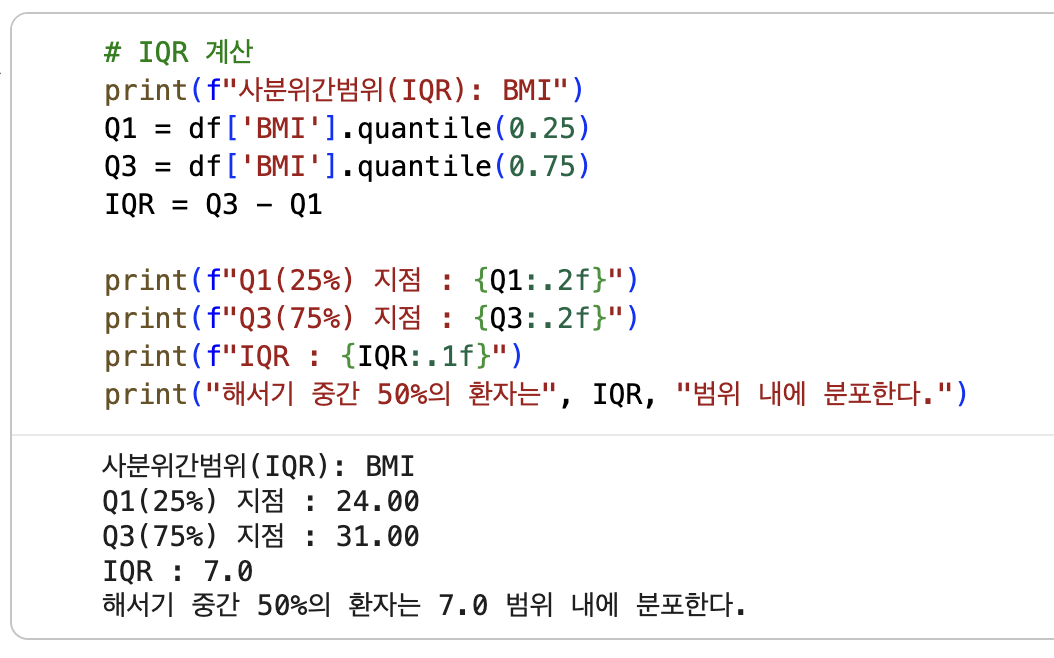
** .quantile() : 데이터에서 어디 위치에 있는 값인지 알려줌
- .quantile(0.25) : 하위 25%에 위치한 값(Q1)
- .quantile(0.5) : 중앙값 (median)
- .quantile(0.75) : 상위 25% 경계 값 (Q3)
즉 .quantile( )은 분위수 계산이지 곱하기가 아니다!
8. 빈도분석
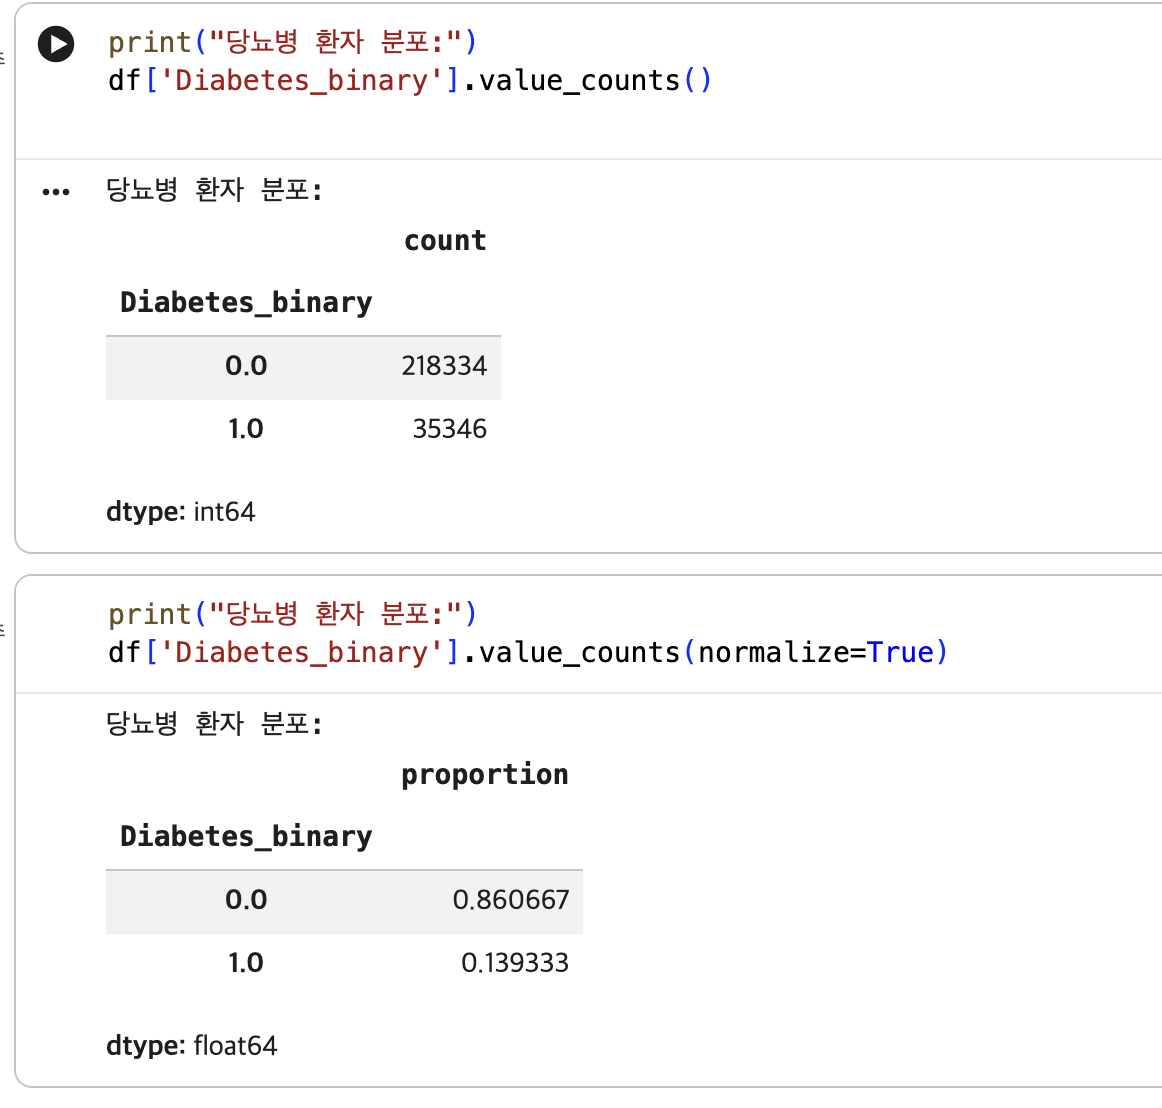
- 범주형 데이터에서 각 카테고리가 얼마나 자주 나타나는지 확인하는 기법
- 클래스 불균형(Class Imbalance) : 문제를 파악해서 모델 학습 전략을 결정할 때 사용
- 의료 데이터에서는 희귀질환 환자가 전체의 5%만 차지한다면 가중치 조정 등의 기법을 적용해야 모델이 소수 클래스도 잘 예측할 수 있음
핵심 개념 이해
- 빈도 (Frequency): 각 범주가 몇 번 나타나는지 세는 것
- 상대빈도 (Relative Frequency): 전체에서 차지하는 비율 (%)
AI 헬스케어 공부하는 간호사