https://youtu.be/mREGY3cM_P0?si=EpXSxph6AbJEcpIl&t=1990
전 동료분의 추천으로 AWS re:Invent 2025에서 카카오 세션을 봤는데 아주 흥미로웠다.
5천만 사용자 로그를 EKS 위에서 어떻게 처리하는지, 기존 시스템을 SigNoz + ClickHouse로 갈아탄 과정, 그리고 AI로 장애 원인 분석까지 하는 내용이었다.
개인적으로 인상깊었던 내용 위주로 간단하게 정리했다.
1. 기술 스택 변경
Before
- Loki
- ElasticSearch
- Kafka
After
- Clickhouse
- Opentelemetry
- Signoz
- Kafka
2. 전환 배경
- ElasticSearch : 쿼리 성능은 좋으나 필요한 인프라(노드) 비용이 너무 크다
- Loki : 상대적으로 가볍고 적은 인프라 필요하지만, 쿼리 성능이 너무 느리다

3. Clickhouse, Opentelemetry 선택한 이유
clickhouse
- 본래 OLAP 분석용 DB이지만, netflix 같은 곳에서도 하루 수 PB 크기 데이터를 처리할 정도로 성능이 좋다.
- Logs, Metrics, Traces 한 곳에 저장이 가능하다.
Opentelemetry
- 이제는 observability 수집기의 표준이 되었다.
4. 영상에서 인상적인 부분
개인적으로 인상적인 부분을 정리하고 보니 거의 데이터와 관련된 것이다.
나는 큰 데이터를 다룰 일이 전혀 없어서, 이런 비슷한 고민도 해본 적이 없었다.
데이터, 인프라 = 비용
최대한 적은 비용으로 많은 이득을 얻을 수 있는 것
즉, 비용 효과적인 문제 해결 방법이 현업에서 가장 요구되는 역량인 것 같다는 생각을 했다.
스토리지 종류와 목적
- Hot Storage : 3일 보관, 단기간 저장 -> AWS EBS
- Cold Storage : 장기간 저장 -> AWS S3
복제 대신 백업&복구
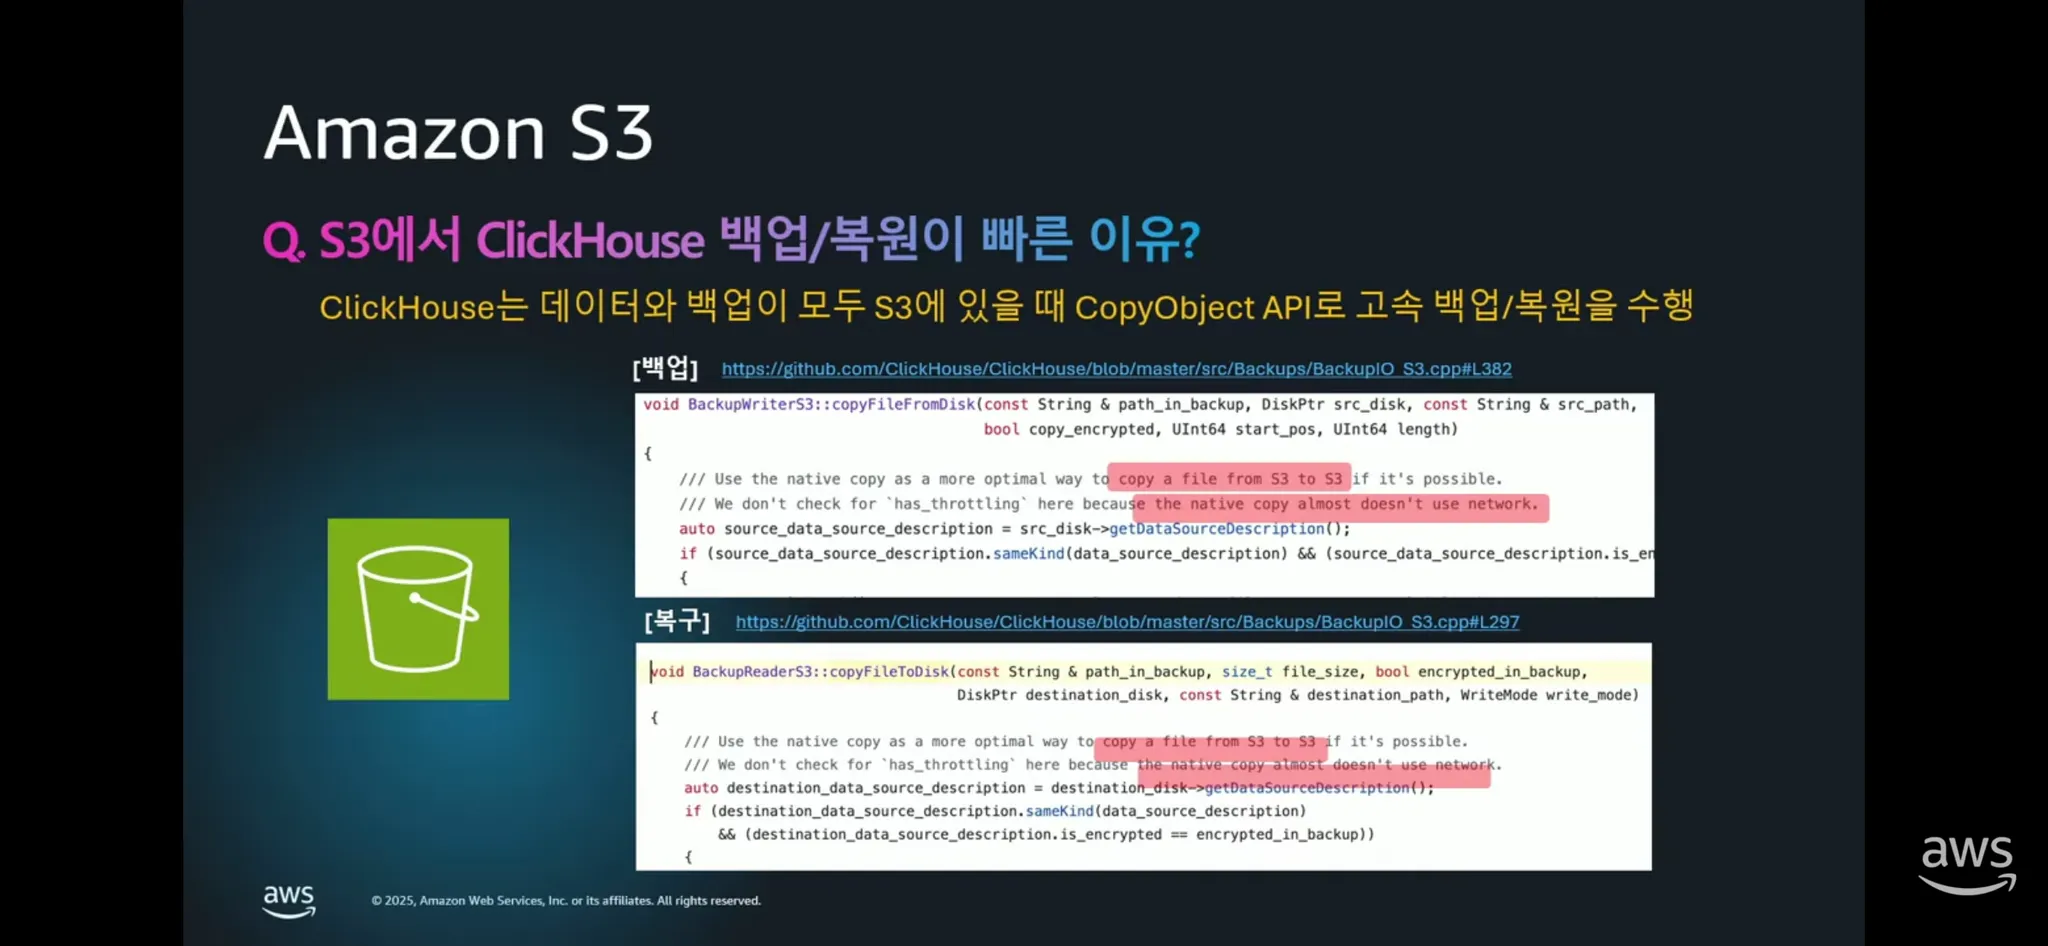
놀랍게도 복제(replica) 구성이 아니라, 백업/복구 시스템을 구성하여 장애 대응을 한다.
이 선택의 이유도 비용과 밀접한 관련이 있다.
- 로그 데이터 복제를 구성하면 스토리지 비용이 2배가 된다 → 엄청난 비용
- 기존 ES + Loki 스택에서는 백업/복구하는데 1~2일 소요
- Clickhouse로는 동일 크기 데이터 백업/복구하는데 약 2~3시간 소요
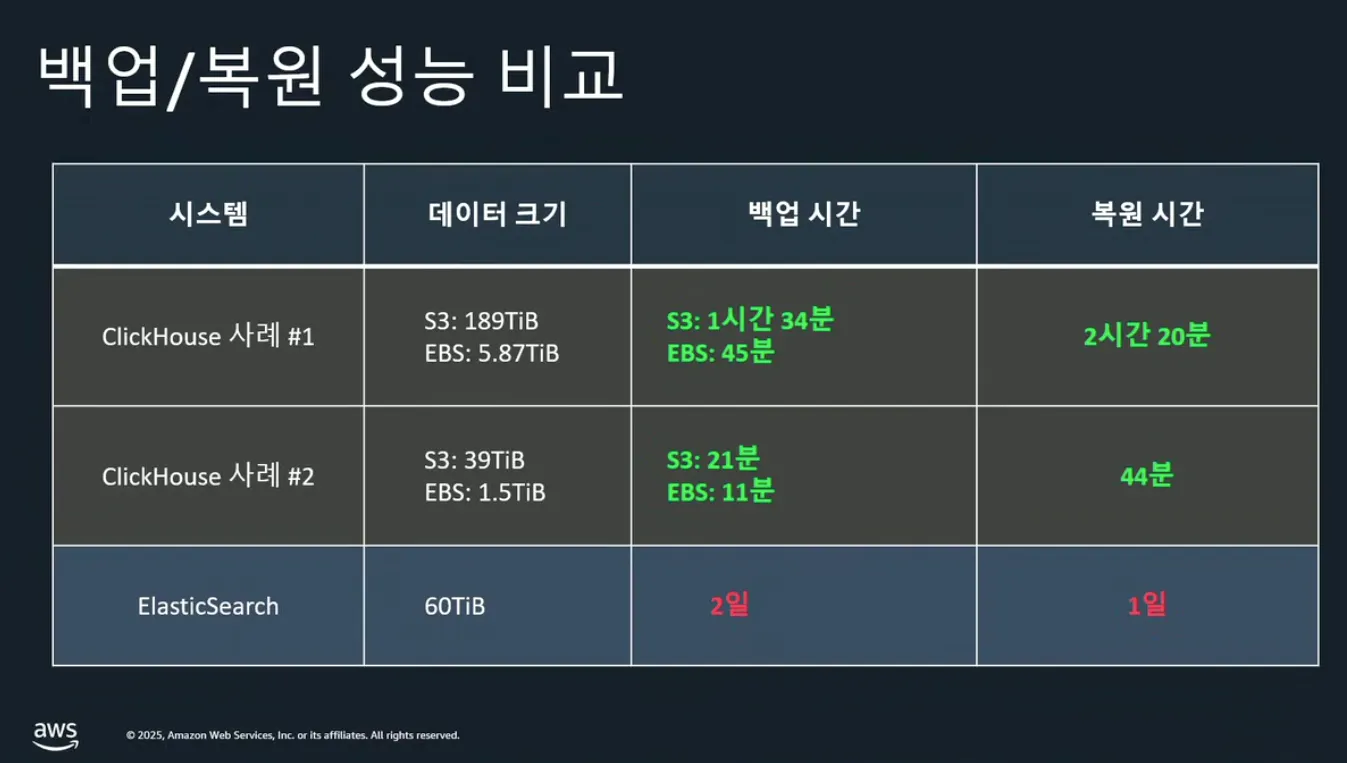
- 복제 스토리지 비용보다 장애시 백업/복구 시간, 비용이 더 저렴하다고 판단했다.
- 그리고 S3에서 Clickhouse 백업/복구 성능이 좋은 것도 이러한 결정을 내리는데 한 몫 했다.
AWS Graviton, Clickhouse 와 찰떡궁합
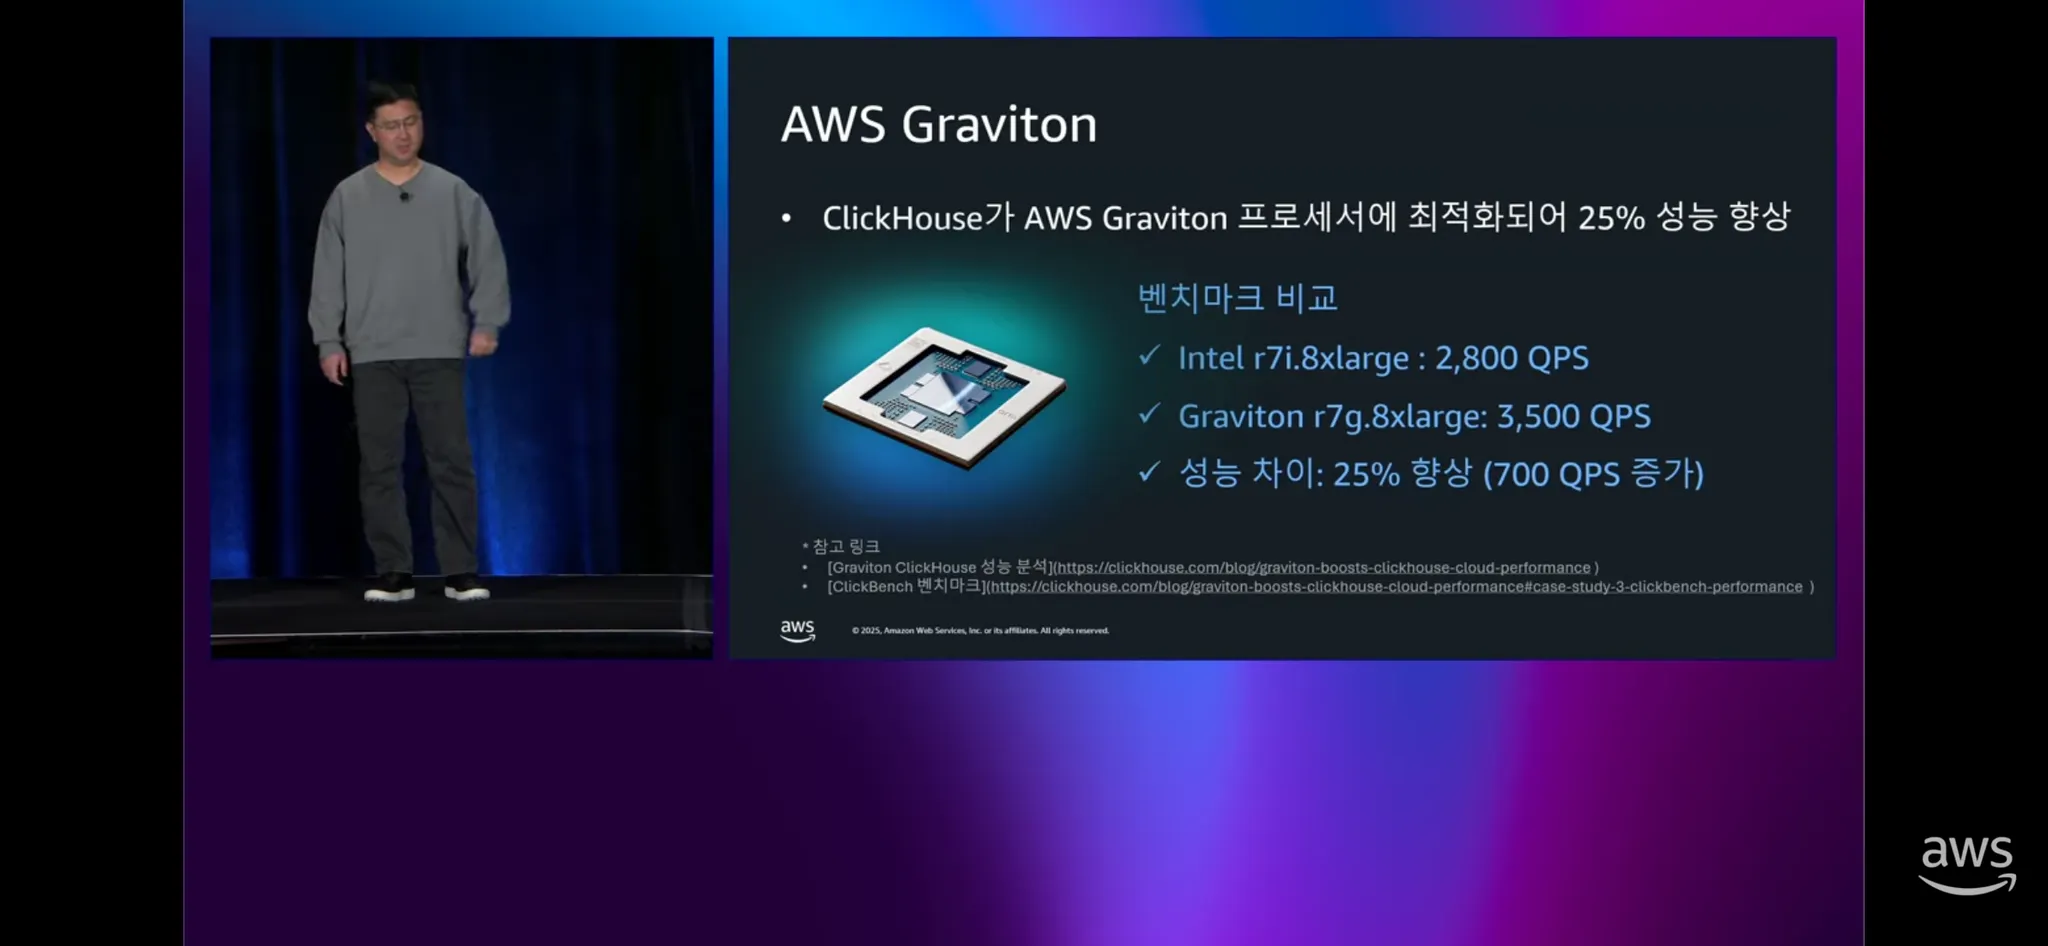
Clickhouse 호스팅할 때는 aws graviton EC2가 성능이 가장 좋다고 한다.
Graviton은 AWS가 자체 개발한 ARM 기반 CPU이다.
m6g, c7g, r7g 처럼 끝에 g가 붙는 인스턴스 타입이 graviton 프로세서가 탑재된 것이다.
알다시피 Clickhouse는 컬럼 기반 DB인데 벡터 연산/병렬 처리를 자주 수행한다.
그런데 graviton이 병렬처리에 특화되어 있어서 그렇다고 한다. (공식문서 벤치마크)
5. ES, loki vs Clickhouse
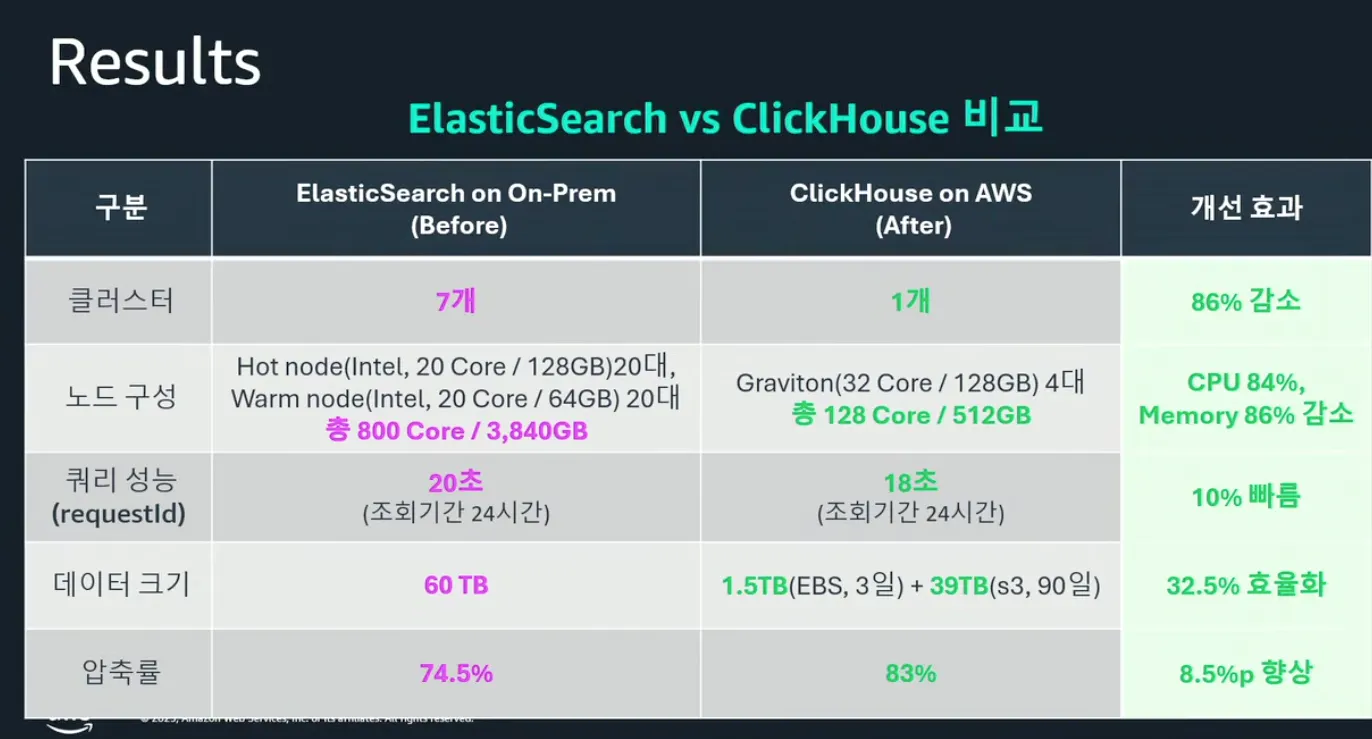
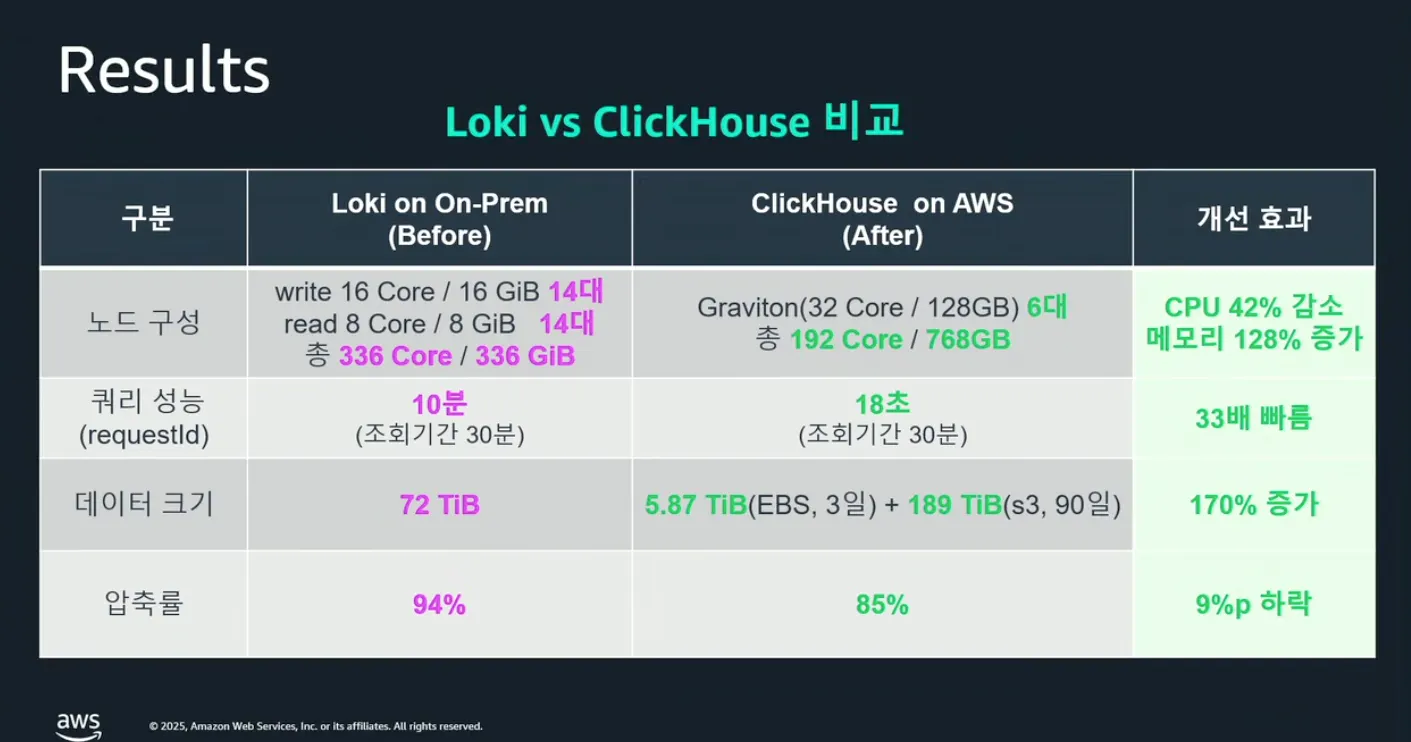
ES,Loki 대비 clickhouse 성능 비교한 장표를 공개했다.
확실히 인프라(노드) 비용이 눈에 띄게 감소하는 것을 확인할 수 있다.
반면에 줄어든 인프라에 비해 ES 대비 쿼리 성능이 좋다. 그리고 Loki 보다는 압도적으로 좋다.
ES 대비 데이터 압축률이 향상된다는 것도 확인할 수 있다.
6. 앞으로 로드맵
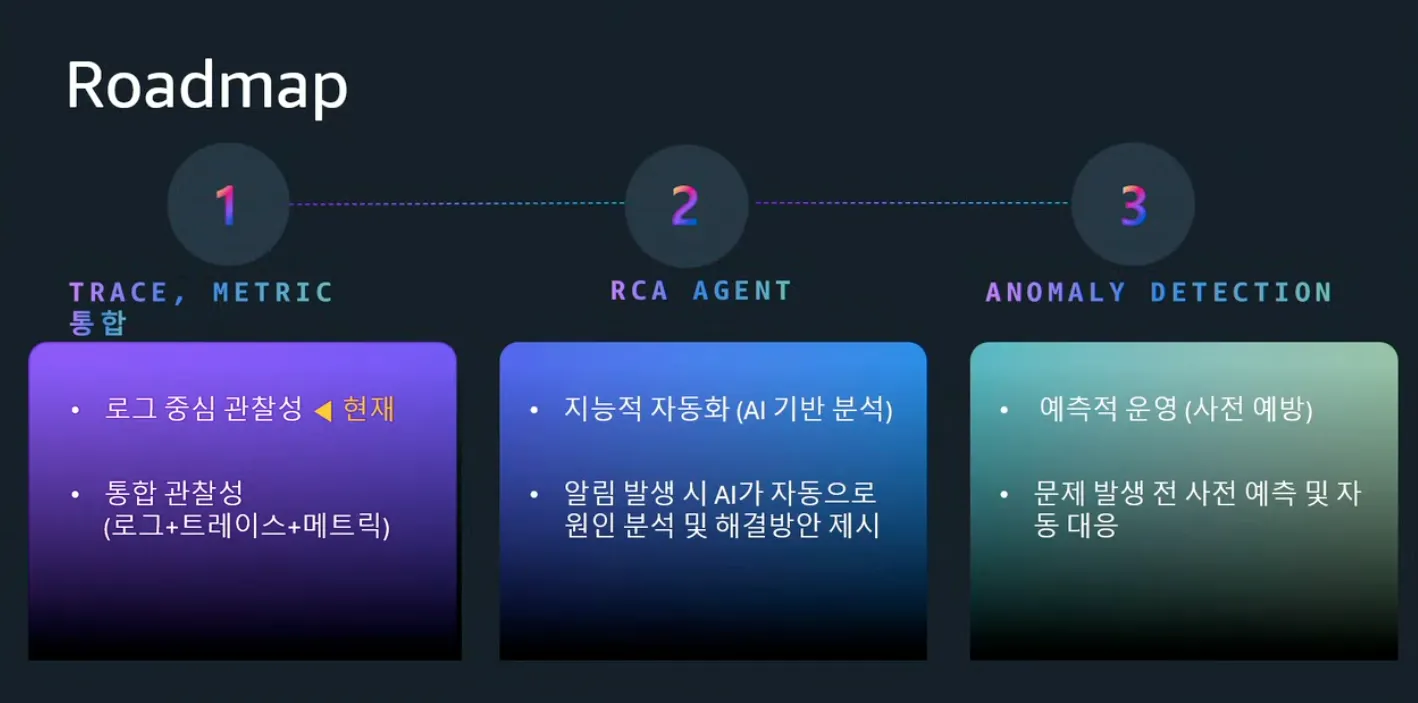
현재는 로그에 대해서만 Clickhouse, otel을 도입하고 있는 상황
하지만 곧 Trace, Metric도 수집하여 진정한 observability가 구현될 예정이다.
더 나아가서는 AI가 장애 원인을 분석해주고 해결 방안도 제시하게 되는 시스템
phase3까지 간다면, 아예 AI가 미리 예측해서 장애를 방지하는 시스템까지 구상하고 있다.
내 개인적으로는 observability가 AI 시대에서 AI와 공존할 수 있는 몇 안되는 분야 중 하나라는 생각을 한다.
이 로드맵을 보니 내가 앞으로 어떤 방향으로 커리어를 만들어 나가야할지 힌트를 얻은 느낌이 든다.
좋은 세션 잘 들었습니다.
