집합
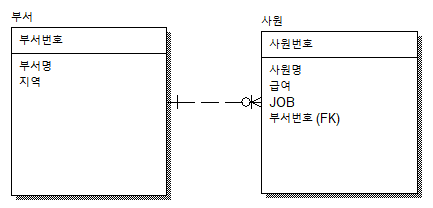
- RDBMS 제품이다
- 집합 사이에 관계가 있다: 부서집합과 사원집합
- 부서집합이 부모집합이다
- 부서집합의 deptno를 받아서 태어난 집합이 사원집합이다
- 부서집합과 사원집합은 1:n의 관계다
- 집합을 자바의 클래스로 설계할 수 있어야 JPA 기술을 누릴 수 있다
- 관계형태 1:1(회원과 포인트) / 1:n(회원-주문,학생-수강신청 교과목) / n:n(회원-상품 고객, 학생-교과목)
- 부서집합의 deptno가 사원집합으로 가게된 것은 관계때문이었다(외래키라고 한다)
- 관계형태 즉 1:n의 관계를 그려줄 때 relation이 생성되었다
index
- 1차 가공만으로 결과를 볼 수 있다
- 2차 가공을 해야 결과를 본다
- 일량의 차이가 있다
- 좀 전에 봤던 실행계획을 떠올려본다
- 인덱스를 스캔해서 값을 출력하였다
- 인덱스는 누가 만들어주나? -자동으로 제공된다
- 자동으로 만들 때 정렬이 오름차순인가보다 추측
(인덱스는 기본적으로 오름차순 정렬이 적용)
SELECT empno FROM emp;

--hint문 - 주석처럼 생긴 아이
SELECT/*+index_desc(emp pk_emp)*/empno FROM emp;

SELECT empno,ename FROM emp;- 실행계획이 인덱스를 읽어서 처리하는 것과 테이블을 억세스하는 쪽으로 변경되었다
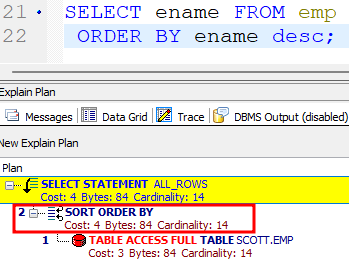
- 2차 정렬이 일어난다
조인
- Nested loop join: 하나씩 다 찍어서 비교해가는 것
- 해쉬조인방식: 두 테이블을 각각 통째로 읽어서 먼저 줄을 세운 뒤에 조건을 비교해 가면서 출력을 낸다
힌트문
--hint문 - 주석처럼 생긴 아이
SELECT/*+index_desc(emp pk_emp)*/empno FROM emp;

 -- 힌트문 적용
 SELECT /*+ rule */ *
  FROM emp,dept
WHERE emp.deptno = dept.deptno;- 힌트문을 통해서 옵티마이저에게 개발자가 생각하는 실행계획을 전달할 수 있다(만일 오타가 있으면 무시된다)
base 옵티마이저
- 실행계획을 세울 때 rule base 옵티마이저와 cost base 옵티마이저가 있다
- cost base 옵티마이저의 경우에는 현재 데이터의 분포가 반영되어 있어야 올바른 선택을 기대할 수 있다
- 분포도를 처리해주는 쿼리문이 있다: DBA가 권한을 가지고 있다
rowid
SELECT rowid rid,ename FROM emp;

SELECT rownum rno,ename FROM emp;

SELECT rownum rno,empno,ename
  FROM (
        SELECT empno,ename FROM emp
        ORDER BY hiredate desc
        )
그룹함수
그룹함수
: 전체범위 처리(속도가 느리다) ↔ 부분범위처리
: 인라인 뷰와 관계가 있다(인라인 뷰를 사용하면 일량을 줄여줄 수 있다)
SELECT sum(sal)
  FROM emp;

-- ename에 max를 붙인 건 문법적인 문제를 피하기 위함이다
SELECT sum(sal),max(ename)
  FROM emp;

-- null 제외하고 count
SELECT count(comm)
  FROM emp;
-- 이 문제를 해결하려면? -> GROUP BY
SELECT count(comm),ename
FROM emp;- 그룹함수와 일반 컬럼은 함께 쓸 수 없다
(하지만 이렇게 생각하면 응용(활용)이 어렵기 때문에 문제해결능력 의심받는다)
-- 이건 가능해
SELECT seq_vc
  FROM t_letitbe
 WHERE seq_vc > 3;

-- WHERE에는 mno를 쓸 수 없다
-- 왜? 집합에 있는 컬럼이 아니기 때문에 Alias명은 WHERE에 쓸 수 없다
SELECT MOD(seq_vc,2) mno
  FROM t_letitbe
 WHERE mno > 3;

-- 집합에서 제공하는 컬럼이 아닌 mno말고
-- MOD(seq_vc,2)로 써줘야 한다
SELECT MOD(seq_vc,2) mno
  FROM t_letitbe
 WHERE MOD(seq_vc,2)=1;

-- 이렇게는 가능하다
SELECT
        mno
  FROM (
       SELECT MOD(seq_vc,2) mno
         FROM t_letitbe
       )
WHERE mno = 1;- 문법적인 문제(max와 일반컬럼을 함께 사용하는 것)를 해결하는 두 가지 방법이 있다
1) 그룹함수를 씌워라
2) GROUP BY절에 쓰기 - 단,효과가 전혀 없었다
: 그럼 왜 썼을까?
SELECT deptno FROM emp;

-- 중복제거
SELECT distinct(deptno) FROM emp;

-- 중복제거 된 것처럼 결과가 같다
SELECT deptno FROM emp
 GROUP BY deptno;
-- 14명 사원이 이름이 다 다르다
SELECT ename FROM emp;
-- 14명 사원 이름이 다 다른데 중복제거 효과가 있나? -> 없다
SELECT distinct(ename) FROM emp;
-- 동일하게 효과가 없다(정렬만 되어있다)
SELECT ename FROM emp
GROUP BY ename;-- UNION ALL은 중복제거 하지 않기 때문에 34*2=68 출력
SELECT
*
FROM(
SELECT
seq_vc
,decode(MOD(seq_vc,2),1, words_vc)A
FROM t_letitbe
UNION ALL
SELECT
seq_vc
,decode(MOD(seq_vc,2),0, words_vc)A
FROM t_letitbe
);
-- t_letitbe를 두 번 읽어서 처리한다: 한 가지 문제제기
-- 왜 별칭을 A로 통일시켰나?
-- 그래서 밑에 GROUP BY seq_vc 추가
SELECT
*
FROM(
SELECT
seq_vc
,decode(MOD(seq_vc,2),1, words_vc)A
FROM t_letitbe
UNION ALL
SELECT
seq_vc
,decode(MOD(seq_vc,2),0, words_vc)A
FROM t_letitbe
)
GROUP BY seq_vc;-- 타입을 같게 하려면?
SELECT deptno FROM dept
UNION ALL
SELECT dname FROM dept;
-- loc로 변경
SELECT loc FROM dept
UNION ALL
SELECT dname FROM dept;SELECT count(comm),count(empno) FROM emp;
SELECT DECODE(job,'CLERK',sal,null) FROM emp;
-- null이 사라진다
SELECT SUM(DECODE(job,'CLERK',sal,null)) FROM emp;
-- 멀티컬럼에서도 가능하다
SELECT DECODE(job,'CLERK',sal,null)
,DECODE(job,'SALESMAN',sal,null)
,DECODE(job,'CLERK',null,'SALESMAN',null,sal)
FROM emp;-- 1개 로우에 여러가지 정보를 다 볼 수 있다
SELECT
deptno,sum(sal),count(sal),max(sal),min(sal),avg(sal)
FROM emp
GROUP BY deptno;DECODE
http://www.gurubee.net/lecture/1028
- SELECT..FROM절 사이에 조건문을 사용할 수 있다
1) decode: 크다, 작다는 비교할 수 없다
-- sign함수
SELECT DECODE(SIGN(1-2),1,'앞에 숫자가 크다',-1,'뒤에 숫자가 크다',0,'같다')
  FROM dual;
2) case문
SELECT deptno,
       CASE deptno
         WHEN 10 THEN 'ACCOUNTING'
         WHEN 20 THEN 'RESEARCH'
         WHEN 30 THEN 'SALES'
         ELSE 'OPERATIONS'
       END as "Dept Name"
  FROM dept;
연습문제1
(03-001,002)
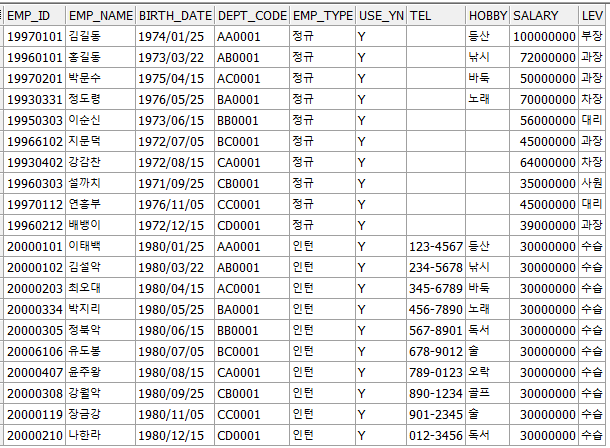
temp의 자료를 salary로 분류하여 30,000,000 이하는 'D' / 30,000,000 초과 50,000,000이하는 'C' / 50,000,000 초과 70,000,000이하는 'B' / 70,000,000 초과는 'A'라고 등급을 분류하여
등급별 인원수를 알고 싶다.
<정답>
SELECT
      COUNT(CASE WHEN salary > 70000000 THEN 'A' END)
     ,COUNT(CASE WHEN salary BETWEEN 50000001 AND 70000000 THEN 'B' END)
     ,COUNT(CASE WHEN salary BETWEEN 30000001 AND 50000000 THEN 'C' END)
     ,COUNT(CASE WHEN salary <= 30000000 THEN 'D' END)
 FROM temp;
-------------------------------------
SELECT
      CASE WHEN salary <= 30000000 THEN 'D'
      WHEN salary <= 50000000 THEN 'C'
      WHEN salary <= 50000000 THEN 'B'
      WHEN salary <= 50000000 THEN 'A'
      END
  FROM temp;
연습문제2
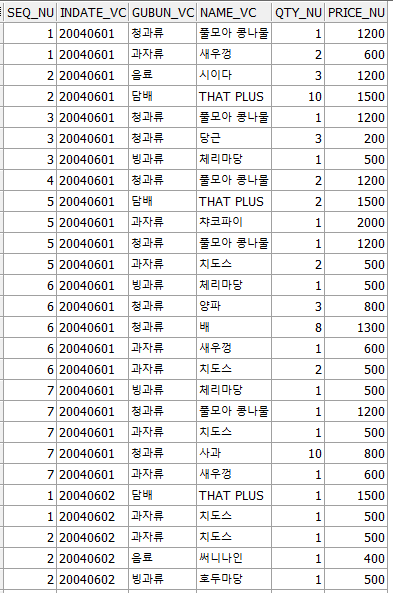
아래 테이블을 만드세요
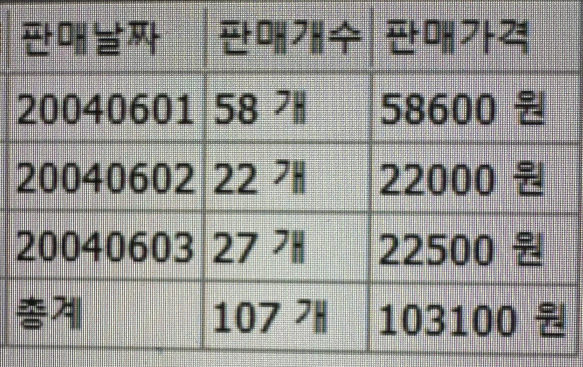
<1단계>
SELECT indate_vc
  FROM t_orderbasket
 GROUP BY indate_vc;

<2단계>
 SELECT indate_vc,sum(qty_nu),sum(qty_nu*price_nu)
  FROM t_orderbasket
 GROUP BY indate_vc;

<3단계>
SELECT
       SUM(a.tot)
  FROM(
       SELECT sum(qty_nu*price_nu) tot
         FROM t_orderbasket
        GROUP BY indate_vc
       )a;

-- 2개 로우를 추가한 이유
-- 1번일 때 날짜 별 계산에서 사용하고
-- 2번일 때는 계산 시 사용하겠다
SELECT decode(a.rno,1,indate_vc,2,'총계') FROM t_orderbasket,
(
SELECT 1 rno FROM dual
UNION ALL
SELECT 2 FROM dual
)a
 GROUP BY decode(a.rno,1,indate_vc,2,'총계')
 ORDER BY decode(a.rno,1,indate_vc,2,'총계');

<정답>
SELECT decode(a.rno,1,indate_vc,2,'총계'),sum(qty_nu),sum(qty_nu*price_nu)
 FROM t_orderbasket,
                    (
                    SELECT 1 rno FROM dual
                    UNION ALL
                    SELECT 2 FROM dual
                    )a
 GROUP BY decode(a.rno,1,indate_vc,2,'총계')
ORDER BY decode(a.rno,1,indate_vc,2,'총계');<참고>
SELECT indate_vc FROM t_orderbasket;
SELECT indate_vc FROM t_orderbasket
GROUP BY indate_vc;
SELECT indate_vc FROM t_orderbasket,
(SELECT rownum rno FROM dept WHERE rownum <3);
SELECT decode(b.rno,1,indate_vc,2,'총계') FROM t_orderbasket,
(SELECT rownum rno FROM dept WHERE rownum <3)b
GROUP BY decode(b.rno,1,indate_vc,2,'총계');<참고>
SELECT decode(job,'CLERK',sal),decode(job,'SALESMAN',sal)
,decode(job,'CLERK',null,'SALESMAN',null,sal)
FROM emp;연습문제3
(case..when 구문을 활용할 것)
member1 테이블을 이용하여 아이디가 존재하지 않으면 -1을 반환 / 아이디가 존재하면 비번까지 비교하여 같으면 1을 반환 / 다르면 0을 반환하는 select문
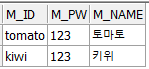
-- 토마토, 키위 정보 담기
INSERT INTO MEMBER1(M_ID, M_PW, M_NAME) VALUES('tomato','123','토마토');

--- 토마토, 키위 가져오기
SELECT m_name
  FROM member1
 WHERE m_id =:id
   AND m_pw =:pw;

-- id가 있으면 0, 없으면 -1
-- 집합이 2개인 테이블이기 때문에 결과값도 2개가 나온다(테이블 3개로 늘리면 결과값도 3개)
SELECT CASE WHEN m_id =:id THEN 0 ELSE -1 END FROM member1;

-- data grid에서 직접 편집도 가능하다(수정하고 commit하기)
edit member1;

-- 결과값이 1개만 나온다
-- rownum이 count stopkey 하기 때문에 최종결과 하나만 나온다
-- rownum: 조회된 결과에 대해 순서대로 숫자를 붙여준다
SELECT CASE WHEN m_id =:id THEN 0 ELSE -1 END FROM member1
WHERE rownum =1;

SELECT CASE WHEN m_id =:id THEN 0
              ELSE -1
              END
   FROM member1
WHERE rownum =1;

<정답>
SELECT
        result
  FROM (
        SELECT CASE WHEN m_id =:id THEN
                CASE WHEN m_pw =:pw THEN 1
                ELSE 0
                END
               ELSE -1
               END as result
          FROM member1
         ORDER BY result desc
        )
 WHERE rownum = 1;
SELECT CASE WHEN m_id =:id THEN 0 ELSE -1 END FROM member1;- 즉, 조건을 만족하지 않을 때 2건에 대해 모두 비교하고 결과를 반환하기 때문에 2건이 조회된다
SELECT CASE WHEN m_id =:id THEN 0 ELSE -1 END FROM member1
WHERE rownum =1;- 만일 회원수가 5만 명인 경우 5만 건을 조회한다는 것이니까 비효율적이다. 맨 위에 한 건만 사용해도 되는 거니까 첫 번째 로우만 출력하면 될 것이다
- 그래서 rownum이라는 예약어를 사용하였다. 이것이 stop key의 역할을 한다
rownum
- 사원번호를 채번하는데 최대값에서 1을 더한 값을 새로운 사원의 사번으로 채번하는 경우를 생각해 보면
SELECT /*+index_desc(emp pk_emp) */empno
  FROM emp;

SELECT /*+index_desc(emp pk_emp) */empno+1
  FROM emp;

SELECT /*+index_desc(emp pk_emp) */empno+1
  FROM emp
 WHERE rownum = 1;
연습문제4
컬럼레벨에 있는 학과별 정원수를 로우레벨로 내려서 출력하시오
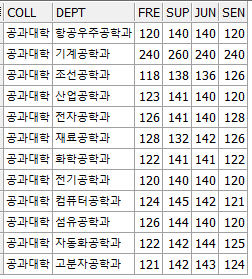
답안예시
SELECT * FROM test11;
----------------------------------------------
SELECT * FROM test11,
(
  SELECT rownum rno FROM dept WHERE rownum <= 4
);
----------------------------------------------
-- DECODE(rno,1,'1학년',2,'2학년',3,'3학년',4,'4학년')
----------------------------------------------
SELECT dept, DECODE(rno,1,'1학년',2,'2학년',3,'3학년',4,'4학년')
 FROM test11,
      (
       SELECT rownum rno FROM dept WHERE rownum <= 4
       );
----------------------------------------------
--DECODE(rno,1,fre,2,sup,3,jun,4,sen)
----------------------------------------------
<정답>
SELECT dept, DECODE(rno,1,'1학년',2,'2학년',3,'3학년',4,'4학년')
      ,DECODE(rno,1,fre,2,sup,3,jun,4,sen)
  FROM test11,
      (
       SELECT rownum rno FROM dept WHERE rownum <= 4
       )
 ORDER BY dept asc,DECODE(rno,1,'1학년',2,'2학년',3,'3학년',4,'4학년') asc;
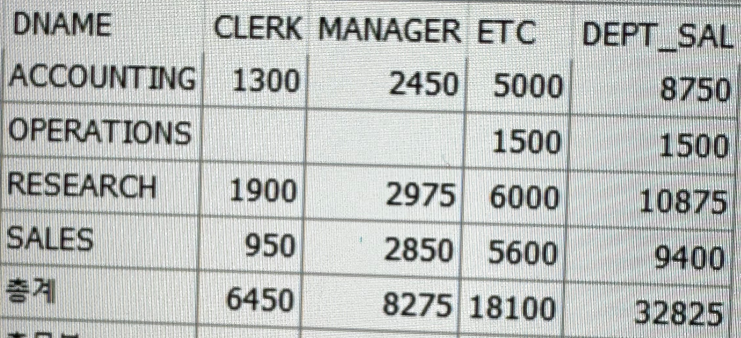
연습문제5
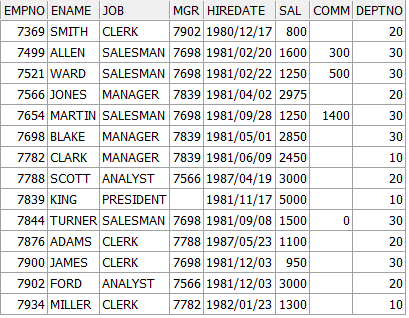
위에 테이블에서 다음 형식으로 출력
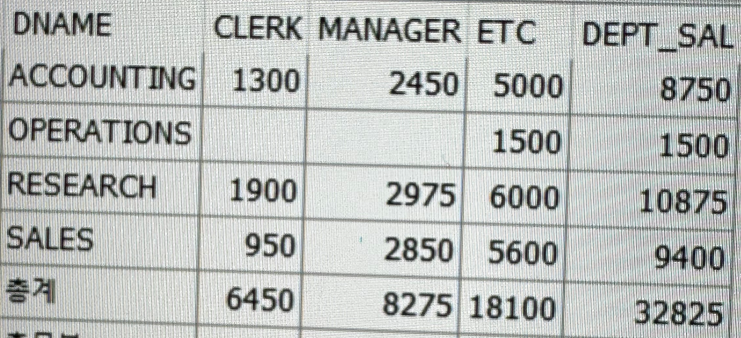
(1단계 - 조인없이 emp 집합만으로 할 수 있는 만큼만 해본다)
SELECT decode(job,'CLERK',sal)
      ,decode(job,'SALESMAN',sal)
      ,decode(job,'CLERK',null,'SALESMAN',null,sal)
  FROM emp;


SELECT sum(sal)
  FROM emp
 GROUP BY deptno;


SELECT sum(decode(job,'CLERK',sal))
      ,sum(decode(job,'SALESMAN',sal))
      ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal))
  FROM emp;


SELECT deptno
      ,sum(decode(job,'CLERK',sal))
      ,sum(decode(job,'SALESMAN',sal))
      ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal))
  FROM emp
 GROUP BY deptno;


SELECT deptno
      ,sum(decode(job,'CLERK',sal))
      ,sum(decode(job,'SALESMAN',sal))
      ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal))
      ,sum(sal)
  FROM emp
 GROUP BY deptno;

-- 부서 이름을 넣으려는데 FROM emp, dept: 카타시안의 곱 문제 발생. 어떻게 해결?
SELECT deptno
      ,sum(decode(job,'CLERK',sal))
      ,sum(decode(job,'SALESMAN',sal))
      ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal))
      ,sum(sal)
  FROM emp, dept
 GROUP BY deptno;

-- 해결
SELECT dname
      ,sum(decode(job,'CLERK',sal))
      ,sum(decode(job,'SALESMAN',sal))
      ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal))
      ,sum(sal)
  FROM emp, dept
 GROUP BY dept.dname;

SELECT '총계' FROM dual;
------------------------------------------
SELECT '총계'
      ,sum(decode(job,'CLERK',sal))
      ,sum(decode(job,'SALESMAN',sal))
      ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal))
  FROM emp;
------------------------------------------
SELECT dname
      ,sum(decode(job,'CLERK',sal))
      ,sum(decode(job,'SALESMAN',sal))
      ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal))
      ,sum(sal)
  FROM emp, dept
 WHERE emp.deptno = dept.deptno
 GROUP BY dept.dname
UNION ALL
SELECT '총계'
      ,sum(decode(job,'CLERK',sal))
      ,sum(decode(job,'SALESMAN',sal))
      ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal))
      ,sum(sal)
  FROM emp;
------------------------------------------
-- 문제제기: 테이블을 한 번만 읽고서 처리하는 방법은 없나?
-- 1.일단은 조인을 먼저 걸지 말고 부서별이니까 GROUP BY를 먼저 해볼까?

SELECT
       deptno,clerk_sum,salesman_sum,etc_sum
  FROM (
        SELECT deptno
              ,sum(decode(job,'CLERK',sal)) clerk_sum
              ,sum(decode(job,'SALESMAN',sal)) salesman_sum
              ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal)) etc_sum
              ,sum(sal)
          FROM emp
          GROUP BY deptno
       );
------------------------------------------
-- 조인인데 왜 12개가 나올까?
-- (못 들었음)*부서집합 4개 = 12, 카테시안의 곱

-- 서브쿼리에서 사용한 컬럼은 주쿼리에서 사용불가하지만
-- 인라인 뷰에서 사용한 컬럼은 테이블 위치이므로 사용이 가능하다
SELECT
       dname,E.CLERK_SUM,E.SALESMAN_SUM,E.ETC_SUM
  FROM(
       SELECT
              deptno,clerk_sum,salesman_sum,etc_sum
         FROM (
               SELECT deptno
                     ,sum(decode(job,'CLERK',sal)) clerk_sum
                     ,sum(decode(job,'SALESMAN',sal)) salesman_sum
                     ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal)) etc_sum
                     ,sum(sal)
                 FROM emp
                 GROUP BY deptno
              )
       )e,dept d
WHERE e.deptno = d.deptno;
------------------------------------------
SELECT
       *
  FROM(
        SELECT
               dname,E.CLERK_SUM,E.SALESMAN_SUM,E.ETC_SUM
          FROM(
               SELECT
                      deptno,clerk_sum,salesman_sum,etc_sum
                 FROM (
                       SELECT deptno
                             ,sum(decode(job,'CLERK',sal)) clerk_sum
                             ,sum(decode(job,'SALESMAN',sal)) salesman_sum
                             ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal)) etc_sum
                             ,sum(sal)
                         FROM emp
                         GROUP BY deptno
                      )
               )e,dept d
        WHERE e.deptno = d.deptno
       )a,
       (SELECT rownum rno FROM dept WHERE rownum < 3) b;
------------------------------------------
SELECT
       decode(b.rno,1,a.dname,2,'총계')
  FROM(
        SELECT
               dname,E.CLERK_SUM,E.SALESMAN_SUM,E.ETC_SUM
          FROM(
               SELECT
                      deptno,clerk_sum,salesman_sum,etc_sum
                 FROM (
                       SELECT deptno
                             ,sum(decode(job,'CLERK',sal)) clerk_sum
                             ,sum(decode(job,'SALESMAN',sal)) salesman_sum
                             ,sum(decode(job,'CLERK',null,'SALESMAN',null,sal)) etc_sum
                             ,sum(sal)
                         FROM emp
                         GROUP BY deptno
                      )
               )e,dept d
        WHERE e.deptno = d.deptno
       )a,
       (SELECT rownum rno FROM dept WHERE rownum < 3) b
GROUP BY decode(b.rno,1,a.dname,2,'총계');