SQL 문제
문제1. 사원번호가 7500번 이상인 사원들의 이름, 입사일자, 급여를 출력하시오.
--조건절: where,having(group by)

SELECT ename,hiredate,sal
  FROM emp
 WHERE empno >= 7500;
문제2. 입사년도가 1981년인 사원들의 사번을 출력하시오.
--hiredate는 날짜 타입
--DATE이(가) 필요하지만 1981타입은 NUMBER임
SELECT
       empno
  FROM emp
 WHERE hiredate = 1981;
-------------------------------------------
SELECT
       empno
  FROM emp
 WHERE hiredate = to_date(1981,'YYYY');
-------------------------------------------
SELECT
       hiredate,to_date(1981,'YYYY')
  FROM emp;

<정답>
SELECT
       empno,to_char(hiredate,'YYYY')
  FROM emp
 WHERE '1981' = to_char(hiredate,'YYYY');
문제3. 사원의 이름이 A로 시작되는 사원들의 사원번호를 출력하시오.
--선분조건 - range scan(구간 검색)

SELECT empno,ename
  FROM emp
 WHERE ename LIKE 'A%';

--A에 한해서가 아닌 변수 적용해서 사용 가능
SELECT empno,ename
  FROM emp
 WHERE ename LIKE :x||'%';
문제4. 입사일자가 1981년 2월1일에서 1981년 6월30일사이에 있는 사원들의 사번과 명단을 출력하시오.
SELECT empno,ename,hiredate
  FROM emp
 WHERE hiredate BETWEEN '1981-02-01' AND '1981-06-30';
문제5. 급여가 1000불보다 크거나 같고 3000불보다 작거나 같은 직원들의 이름과 급여를 출력하시오.
SELECT ename,sal
  FROM emp
 WHERE sal BETWEEN 1000 AND 3000;

--구간검색에서 크거나 같다(작거나 같다) → 둘다 만족
--교집합(INTERSECT)
SELECT ename,sal
  FROM emp
 WHERE sal >= 1000
   AND sal <= 3000;
--교집합(여기서는 Natural Join)
SELECT deptno FROM emp
INTERSECT
SELECT deptno FROM dept;문제6. 급여가 3000불이 아닌 사원들의 사번과 이름을 출력하시오.
- 아닌 걸 찾을 때도 색인을 사용할 수 있나? (하단 index 내용 확인)
SELECT empno,ename,sal
  FROM emp
 WHERE sal != 3000;
index
- PK가 아닌 일반 컬럼도 index를 가질 수 있다
(ex. 은행에서 날짜검색-중복값이 많으니까 pk는 아니지만, 검색조건에 많이 들어가니까 속도를 개선하고 싶을 때 날짜컬럼에 대해서도 index 생성할 수 있음) - 일반컬럼에 index를 생성할 때도 DDL 구문을 사용한다(데이터 정의어: CREATE,ALTER,RENAME,DROP)
- index가 있어도 조건에 사용되지 않으면 실행계획에 반영되지 않는다
-- 아닌 걸 찾을 때도 색인을 사용할 수 있나?

--인덱스만 읽고도 조회가 된다
--인덱스를 관리하는 테이블이 있다(검색 속도향상의 원리)
--그 테이블이 인덱스키+rowid를 쥐고 있다
SELECT empno
  FROM emp;

SELECT /*+index_desc(emp pk_emp)*/empno
  FROM emp;
----------------------------------------
--ename은 index테이블에 없어서 실행계획이 바뀌었다
SELECT empno,ename
  FROM emp;

--index를 사용했더니 실행계획에 반영되었음
SELECT empno,ename
  FROM emp
 WHERE empno = 7566;

--왜 실행계획이 달라질까?
--ename은 index가 없다(describe-indexes에서 확인 가능)
SELECT empno,ename
  FROM emp
WHERE ename = 'SMITH';- index 만들기
CREATE index i_ename ON emp(ename asc);
----------------------------------------
--index 생겼는데 왜 정렬이 되지 않았나?
--index가 생겼지만 index를 사용하지 않았다
--index가 있다고 사용되는 게 아니라,
--사용될 수 있는 조건이 주어졌을 때 사용할 수 있는 것이다
SELECT ename
  FROM emp;

--이렇게 조건이 주어졌을 때 index 사용
--의미있는 값이고 결과가 나오니까
SELECT ename
  FROM emp
 WHERE ename = 'SMITH';

--빈 문자열을 넣으니 사용하지 않는다
SELECT ename
  FROM emp
 WHERE ename = '';

--한 칸 공백을 넣으니 index를 사용한다
SELECT ename
  FROM emp
 WHERE ename = ' ';
----------------------------------------
--index 사용
SELECT empno,ename
  FROM emp
 WHERE empno = 7566;

--아닌 걸 찾으라고 하니까 index 사용을 하지 않는다
SELECT empno,ename
  FROM emp
 WHERE empno != 7566;
----------------------------------------
--index 쓴다
SELECT ename
  FROM emp
 WHERE ename != 'SMITH';

--index 쓰지 않는다
SELECT ename,hiredate
  FROM emp
 WHERE ename != 'SMITH';
----------------------------------------
--힌트문에 rule 쓰니 index를 쓴다
SELECT ename
  FROM emp
 WHERE ename = '';
문제7. 사원들의 부서별 급여 평균을 구하시오.
SELECT sum(sal),count(sal),count(comm),avg(sal)
  FROM emp;

--문법적인 문제만 해결(의미없는 max)
--그룹함수를 사용해서 문법적인 문제는 피할 수 있지만
--그 결과는 의미가 없다
SELECT max(deptno),avg(sal)
  FROM emp;

<정답>
SELECT deptno,avg(sal)
  FROM emp
 GROUP BY deptno;
힌트문
- RDBMS가 세운 실행계획보다 개발자가 세운 실행계획이 옳다고 판단될 때 옵티마이저에게 개발자의 생각을 전달할 수 있는 유일한 방법
- 힌트문에 오타가 있으면 무시된다(원래 실행계획대로 검색해준다)
서브쿼리
- 직접적인 조건이 아니라 간접조건을 주고 원하는 결과를 찾아달라고 할 때
- 위치
1) from절에 select문이면 인라인 뷰(테이블 자리)
2) 조건절에 select문이면 서브쿼리(값의 자리) - 어떤 차이가 있을까?
: 인라인 뷰에 사용한 컬럼명은 별칭이더라도 주쿼리에 사용이 가능함
SELECT words_vc
  FROM t_letitbe
 WHERE words_vc LIKE 'Let%';
----------------------------------------
SELECT DECODE(MOD(seq_vc,2),0,words_vc)A
  FROM t_letitbe;
----------------------------------------
--인라인 뷰일때는 쓸 수 있지만, 서브쿼리에서는 불가능
--부적합한 식별자
SELECT DECODE(MOD(seq_vc,2),0,words_vc)A
  FROM t_letitbe
 WHERE A LIKE 'Let%';

<정답>
SELECT
       A
  FROM(
        SELECT DECODE(MOD(seq_vc,2),1,words_vc)A
        FROM t_letitbe
       )
 WHERE A LIKE 'Let%';
문제1. temp에서 연봉이 가장 많은 직원의 row를 찾아서 이 금액과 동일한 금액을 받는 직원의 사번과 성명을 출력하시오.
SELECT max(salary)
  FROM temp;

SELECT emp_id,emp_name FROM temp
 WHERE salary = 100000000;

<정답>
SELECT emp_id,emp_name FROM temp
 WHERE salary = (SELECT max(salary) FROM temp);
문제2. temp의 자료를 이용하여 salary의 평균을 구하고, 이보다 큰 금액을 salary로 받는 직원의 사번, 성명, 연봉을 보여주시오.
SELECT avg(salary) FROM temp;

SELECT emp_id,emp_name,salary FROM temp
 WHERE salary > 43800000;

SELECT emp_id,emp_name,salary FROM temp
 WHERE salary > (SELECT avg(salary) FROM temp);
문제3. temp의 직원 중 인천에 근무하는 직원의 사번과 성명을 읽어오는 SQL을 서브쿼리를 이용해 만들어 보시오.
SELECT * FROM tdept;

SELECT dept_code FROM tdept WHERE area = '인천';

SELECT ename,deptno FROM emp
 WHERE deptno IN(10,20);

<정답>
SELECT emp_id,emp_name FROM temp
 WHERE dept_code IN(SELECT dept_code FROM tdept WHERE area = '인천');
문제4. tcom에 연봉 외에 커미션을 받는 직원의 사번이 보관되어 있다. 이 정보를 서브쿼리로 select하여 부서 명칭별로 커미션을 받는 인원수를 세는 문장을 만들어 보시오.
SELECT emp_id FROM temp
INTERSECT
SELECT emp_id FROM tcom;
-------------------------------------
SELECT
       b.dept_name
  FROM temp a,tdept b
 WHERE a.dept_code=b.dept_code;
-------------------------------------
SELECT
       b.dept_name
  FROM temp a,tdept b
 WHERE a.dept_code=b.dept_code
   AND a.emp_id IN(SELECT emp_id FROM tcom);

<정답>
SELECT
       b.dept_name,count(a.emp_id)
  FROM temp a,tdept b
 WHERE a.dept_code=b.dept_code
   AND a.emp_id IN(SELECT emp_id FROM tcom)
 GROUP BY b.dept_name;
연습문제
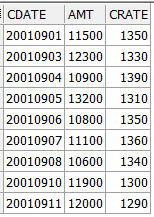
- 오늘 김대표가 결제해야 할 한화 금액은?(환율은 전날 값으로 계산한다) (8장(08-001) test02)
- CDATE:날짜 / AMT:결제달러 / CRATE:환율
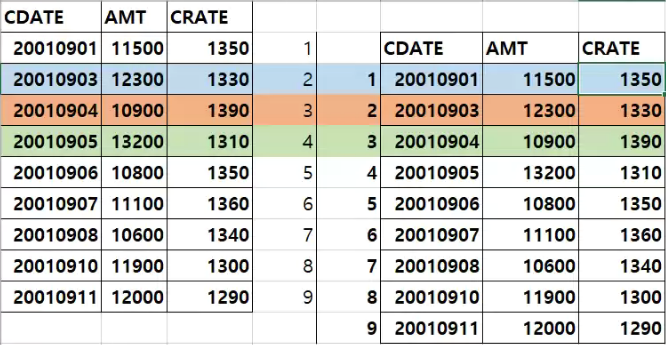
SELECT rownum org_no,cdate,crate,amt FROM test02;
SELECT rownum copy_no,cdate,crate,amt FROM test02;

<정답>
SELECT
       a.cdate,a.amt,b.crate
       ,to_char((a.AMT*b.crate),'9,999,999,999')||'원' as "한화금액"
  FROM(
       SELECT rownum org_no,cdate,crate,amt FROM test02
      )a,
      (
       SELECT rownum copy_no,cdate,crate,amt FROM test02
      )b
 WHERE a.org_no-1 = b.copy_no;
사용자정의 함수
--한 번 만든 다음 함수를 바꿀 수 있음
CREATE OR REPLACE FUNCTION func_crate(pdate varchar2)
RETURN number
IS
  tmp number;
BEGIN
  tmp :=0;
  SELECT crate INTO tmp
    FROM test02
   WHERE cdate = (SELECT max(cdate) FROM test02
                   WHERE cdate < pdate);
  return tmp;
END;
SELECT func_crate('20010906')
FROM dual;
--참고(이런 형식으로 함수 썼었잖아)
SELECT MOD(5,2) FROM dual;rownum
SELECT 1 rno FROM dual
UNION ALL
SELECT 2 FROM dual;

SELECT rownum rno FROM dept
WHERE rownum < 3;- rownum은 조회 결과에 대해서 순차적으로 번호를 매겨준다
- 크다(rownum > num) 비교 안 된다
→ (rownum <= num) (같은은 1까지만 된다) - 2배수든, 3배수든 같다는 1까지만 된다
- 1과 같다고 조건을 붙이면 하나만 읽어서 출력된다(stop key)
- 판정을 할 수 있는 경우일테니까 부분 범위 처리가 가능하다
ex. 아이디를 중복검사하는데 만 명 중에서 100번 째 아이디가 존재하는 걸 확인했다. 그렇다면 이 아이디는 사용이 불가하다 판정이 가능하다.
: 굳이 101번째 아이디와는 더 이상 비교할 필요가 없다(왜냐하면 회원가입 할 때마다 아이디 중복검사를 했으니까)
연습문제
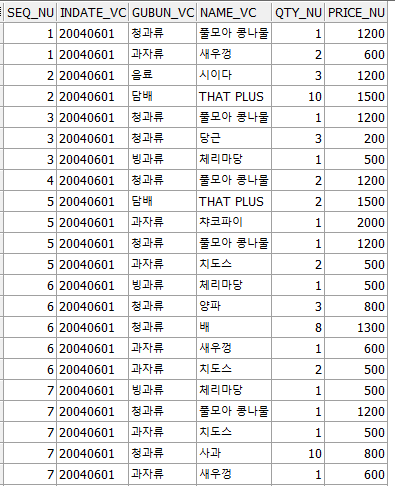
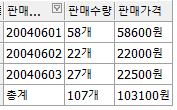
- 아래와 같이 구하시오
SELECT indate_vc FROM t_orderbasket
 GROUP BY indate_vc;

--이런 식으로 쓸 수 없다.
--GROUP BY에서 묶음처리가 된 것만 쓸 수 있다
SELECT indate_vc,qty_nu FROM t_orderbasket
 GROUP BY indate_vc;

--54건이 108건이 되었다
--54개는 날짜별 계산에 사용되지만 나머지 54개는 총계 하나로 묶는다
SELECT indate_vc
  FROM t_orderbasket,
      (SELECT rownum rno FROM dept WHERE rownum < 3);

SELECT decode(b.rno,1,indate_vc,2,'총계')
  FROM t_orderbasket,
      (SELECT rownum rno FROM dept WHERE rownum < 3)b;

SELECT decode(b.rno,1,indate_vc,2,'총계')
  FROM t_orderbasket,
      (SELECT rownum rno FROM dept WHERE rownum < 3)b
 GROUP BY decode(b.rno,1,indate_vc,2,'총계');

SELECT decode(b.rno,1,indate_vc,2,'총계')
       ,sum(qty_nu)||'개' as "판매수량",sum(price_nu)||'원' as "판매가격"
 FROM t_orderbasket,
(SELECT rownum rno FROM dept WHERE rownum < 3)b
 GROUP BY decode(b.rno,1,indate_vc,2,'총계');


SELECT decode(b.rno,1,indate_vc,2,'총계')as "판매날짜"
       ,sum(qty_nu)||'개' as "판매수량"
       ,sum(qty_nu*price_nu)||'원' as "판매가격"
  FROM t_orderbasket,
      (SELECT rownum rno FROM dept WHERE rownum < 3)b
 GROUP BY decode(b.rno,1,indate_vc,2,'총계')
ORDER BY decode(b.rno,1,indate_vc,2,'총계');- 아래와 같이 소계별, 총계를 구하시오
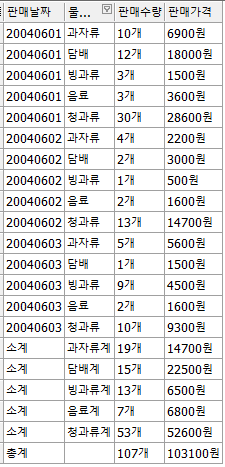
<참고>
--분석함수 ROLLUP을 사용한 문제풀이
SELECT NVL(INDATE_VC,'총계') AS 판매날짜,
       SUM(QTY_NU)||' 개' AS 판매개수,
       SUM(PRICE_NU) ||' 원' AS 판매가격
  FROM T_ORDERBASKET
 GROUP BY ROLLUP(INDATE_VC);
SELECT decode(b.rno,1,indate_vc,2,'총계',3,'소계')
FROM t_orderbasket,
(SELECT rownum rno FROM dept WHERE rownum < 4)b
GROUP BY decode(b.rno,1,indate_vc,2,'총계',3,'소계');
SELECT decode(b.rno,1,indate_vc,2,'총계',3,'소계')
,decode(b.rno,3,gubun_vc||'계',1,gubun_vc)
FROM t_orderbasket,
(SELECT rownum rno FROM dept WHERE rownum < 4)b
GROUP BY decode(b.rno,1,indate_vc,2,'총계',3,'소계')
,decode(b.rno,3,gubun_vc||'계',1,gubun_vc)
ORDER BY decode(b.rno,1,indate_vc,2,'총계',3,'소계');
<정답>
SELECT (decode(b.rno,1,indate_vc,2,'총계',3,'소계'))as"판매날짜"
,(decode(b.rno,3,gubun_vc||'계',1,gubun_vc))as"물품구분"
,sum(qty_nu)||'개' as "판매수량"
,sum(qty_nu*price_nu)||'원' as "판매가격"
FROM t_orderbasket,
(SELECT rownum rno FROM dept WHERE rownum < 4)b
GROUP BY decode(b.rno,1,indate_vc,2,'총계',3,'소계')
,decode(b.rno,3,gubun_vc||'계',1,gubun_vc)
ORDER BY decode(b.rno,1,indate_vc,2,'총계',3,'소계');조인
- 무조건 다 조인을 걸 수 있는 것이 아니라 1:1,1:n은 조인을 걸어도 되지만, n:n은 업무에 대한 정의가 덜 된 경우이므로 DBA 가서 확인해야 한다
- 학생과 과목 / 수강신청: 행위엔티티(교차엔티티)
- natural join / self join / outer join / non-equal join
쿼리문 리뷰
- 가능하다면 테이블은 한 번만 읽어서 처리한다
- 경우의 수를 줄인다(인라인 뷰 or GROUP BY)
- 조인을 하기 전에 미리 먼저 그룹핑을 한다
- 그룹핑을 하면서 그룹함수가 필요한 부분(sum(decode패턴))이 있다면 같이 해도 된다
- 어디서 쓰나? 대용량데이터베이스 키워드가 들어간 책
- 왜 조인을 했을까?: 부서번호가 아니라 부서명을 출력하는 것이 직관적이니까
- 더미집합 사용: 데이터복제하기(카타시안 곱)-2배수로 복제함
- 그룹핑을 하면서 14건이 3건으로 줄어드는 것
SELECT
      sum(decode(job,'CLERK',sal)) clerk_sal
     ,sum(decode(job,'SALESMAN',sal)) salesman_sal
     ,sum(decode(job, 'CLERK', null, 'SALESMAN', null, sal)) etc
  FROM scott.emp a, scott.dept b
 WHERE a.deptno = b.deptno;
----------------------------------------------

SELECT
      nvl(decode(b.no, '1', dname), '총계') dname
     ,sum(clerk) clerk
     ,sum(manager) manager
     ,sum(etc) etc
     ,sum(dept_sal) dept_sal
  FROM (
        SELECT bb.dname, clerk, manager, etc, dept_sal
          FROM (
                SELECT deptno
                      ,sum(decode(job, 'CLERK', sal)) clerk
                      ,sum(decode(job, 'MANAGER', sal)) manager
                      ,sum(decode(job, 'CLERK', null, 'MANAGER', null, sal)) etc
                      ,sum(sal) dept_sal
                 FROM emp a
                GROUP BY deptno
               )aa, dept bb
         WHERE aa.deptno = bb.deptno
       )a,
       (SELECT '1' no FROM dual
        union all
        SELECT '2' FROM dual
       )b
       GROUP BY decode(b.no, '1', dname)
ORDER BY dname; <1단계>
SELECT deptno
,sum(decode(job, 'CLERK', sal)) clerk
,sum(decode(job, 'MANAGER', sal)) manager
,sum(decode(job, 'CLERK', null, 'MANAGER', null, sal)) etc
,sum(sal) dept_sal
FROM emp a
GROUP BY deptno;- 총계를 넣고 싶은데 보니까 deptno: 타입이 number여서 총계를 넣을 수 없다. 타입이 다르니까
- 이럴 때 GROUP BY 하기 전에 join이 먼저다
- 총계 부분을 따로 계산해서 합집합으로 처리하면 같은 집합을 두 번 읽게 된다
<2단계-조인>
FROM (
        SELECT bb.dname, clerk, manager, etc, dept_sal
          FROM (
                SELECT deptno
                      ,sum(decode(job, 'CLERK', sal)) clerk
                      ,sum(decode(job, 'MANAGER', sal)) manager
                      ,sum(decode(job, 'CLERK', null, 'MANAGER', null, sal)) etc
                      ,sum(sal) dept_sal
                 FROM emp a
                GROUP BY deptno
               )aa, dept bb
WHERE aa.deptno = bb.deptno - 14건을 3건으로 부서명 얻기 위해 조인을 선택
SELECT
     sum(clerk) clerk
     ,sum(manager) manager
     ,sum(etc) etc
     ,sum(dept_sal) dept_sal
  FROM (
        SELECT bb.dname, clerk, manager, etc, dept_sal
          FROM (
                SELECT deptno
                      ,sum(decode(job, 'CLERK', sal)) clerk
                      ,sum(decode(job, 'MANAGER', sal)) manager
                      ,sum(decode(job, 'CLERK', null, 'MANAGER', null, sal)) etc
                      ,sum(sal) dept_sal
                 FROM emp a
                GROUP BY deptno
               )aa, dept bb
         WHERE aa.deptno = bb.deptno
       )a,
       (SELECT '1' no FROM dual
        union all
        SELECT '2' FROM dual
)b 